La misión de DataCamp es ayudar a personas y empresas, en cada paso de su camino, a desarrollar competencia en datos creando la plataforma de formación en ciencia de datos más inteligente que existe.
Este artículo quiere aportar más contexto sobre por qué empezamos DataCamp a nivel macro. En la primera sección hablaremos del mercado de la ciencia de datos (talento). La segunda parte cubre los pilares que sostienen nuestra visión del futuro de la formación en ciencia de datos. Por último, abordamos la importancia de la certificación.
El mercado
La oportunidad
Saber analizar datos permite a personas y empresas tomar mejores decisiones y crear servicios y productos mejores y nuevos. Creemos que el impacto del análisis de datos y la ciencia de datos en los próximos 20 años será tan grande como el que la ingeniería de software y la informática han tenido en los últimos 20. El software está devorando el mundo, pero la ciencia de datos y la IA van a tener a la ingeniería de software para la cena.
La brecha de talento
Aunque es apasionante, hay un problema: Harvard Business Review y un informe de McKinsey pusieron el foco por primera vez en la escasez de científicos de datos. Hoy, empresas de todos los sectores tienen dificultades para encontrar científicos de datos o personas con un nivel decente de competencia/fluidez en datos. Las cifras sobre la escasez (prevista) de científicos de datos van desde cientos de miles hasta millones en los informes más recientes sobre este tema.
Aunque se pueda debatir la precisión de estas predicciones, hay algo claro: las instituciones educativas tradicionales no pueden formar a suficientes personas en las próximas décadas para cerrar esta brecha. Además, gran parte del mundo no tiene acceso a formación de calidad en ciencia de datos en instituciones tradicionales porque suele ser (muy) cara.
En consecuencia, solo podremos aprovechar todo el potencial de la ciencia de datos si encontramos formas de recapacitar de forma asequible a la fuerza laboral actual. Por un lado, cabe esperar que muchas personas se formen por su cuenta para avanzar en su carrera (y, en menor medida, para cambiar de carrera); por otro, que las empresas reciclen a una parte significativa de sus plantillas. Fíjate también en que el grupo de personas que aprende para progresar en su carrera es mayor que el de quienes aprenden para cambiarla. No es nuevo: lynda.com y Pluralsight demostraron que centrarse en la formación continua es una estrategia ganadora en los ámbitos creativo y de desarrollo, respectivamente.
Por último, es importante entender que la brecha de competencias existe a varios niveles: desde personas que trabajan con datos cada semana y se topan con los límites de sus herramientas actuales (a menudo Microsoft Excel), hasta analistas y científicos de datos, pasando por directivos y consultores. Todos estos grupos tienen necesidades distintas, pero en todos ellos faltan personas con el nivel adecuado de competencia/fluidez en datos.
Por todo lo anterior, creemos que el mercado de la educación en competencia en datos es enorme y probablemente mayor que el mercado de la enseñanza de habilidades básicas de programación. Dos datos parecen confirmar esta hipótesis:
- Más del sesenta por ciento de nuestros 1,7 millones de estudiantes son profesionales en activo de áreas muy diversas (consultoría, finanzas, salud, investigación, marketing, …) y con funciones de todo tipo. Puedes leer sus historias en DataCamp.
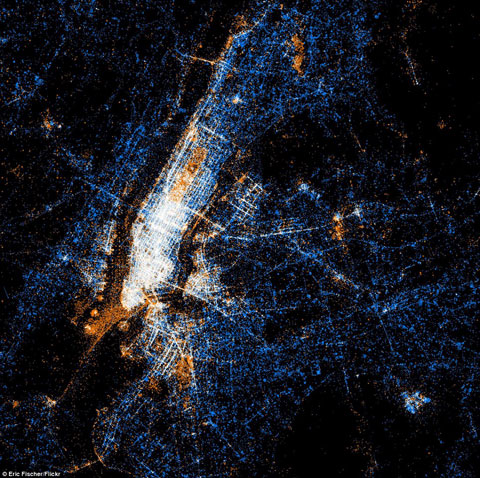
- Mucha gente asocia la ciencia de datos con el sector tecnológico y piensa que San Francisco es la Meca de la disciplina. Sin embargo, la ciencia de datos no es exclusiva de San Francisco en absoluto. Si ordenas el tráfico de aprendizaje de DataCamp por ciudad, San Francisco solo aparece en la posición 24, superada por 7 ciudades de India y 4 de Estados Unidos (Nueva York es la nº 1 en EE. UU.). La necesidad de ciencia de datos está en todas partes. ### Un giro hacia el open source El desarrollo de software open source transformó por completo la comunidad del desarrollo web y ahora está transformando la de estadística aplicada y ciencia de datos. Aunque SAS y SPSS dominaron el mundo de la estadística aplicada no hace tanto, tecnologías de código abierto como R y Python parecen haber tomado el relevo. Por cierto, DataCamp también ha liberado en open source algunos cursos y tecnología. Es difícil discutir el crecimiento del software open source como capa fundacional del futuro de la ciencia de datos. Esta es la razón principal por la que toda nuestra formación en ciencia de datos está centrada actualmente en open source. Además, por su propia naturaleza, facilita crear herramientas educativas interactivas sobre ellas. Apostar por el open source también nos permite devolver valor a esas comunidades: aportamos vías de ingresos escalables a contribuidores open source que crean cursos en DataCamp mediante nuestro modelo de royalties. Aunque el open source seguirá siendo una gran parte de nuestro programa de formación en los próximos años, nuestro objetivo final es ofrecer formación sobre todas las herramientas y metodologías relevantes. Espera ver también formación para herramientas propietarias en el futuro. ## El futuro de la formación en ciencia de datos Un enfoque vertical y la tecnología permiten la mejor experiencia de aprendizaje La Universidad de Bolonia (Italia) se fundó en 1088 y es la más antigua de Europa.
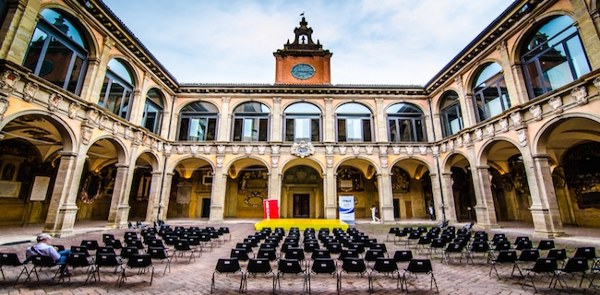
Históricamente, las instituciones educativas abarcaban una amplia gama de temas (llamémoslo enfoque horizontal). Por ejemplo, la universidad más antigua de Europa imparte materias que van desde historia, economía y psicología hasta estadística, etc. El enfoque horizontal tenía sentido entonces por (i) economías de escala (edificios, administración de estudiantes, atracción del mejor profesorado, valor de marca para certificar, etc.) y (ii) un alcance geográfico limitado por los altos costes de comunicación y transporte. El enfoque horizontal fue el modelo dominante durante siglos, por eso seguimos pensando en instituciones educativas con enfoque horizontal.
Los costes de transporte y comunicación, y los costes fijos de los modelos educativos han caído drásticamente en las últimas décadas gracias al avance tecnológico. Entonces, ¿cómo afecta eso al panorama educativo actual y futuro?
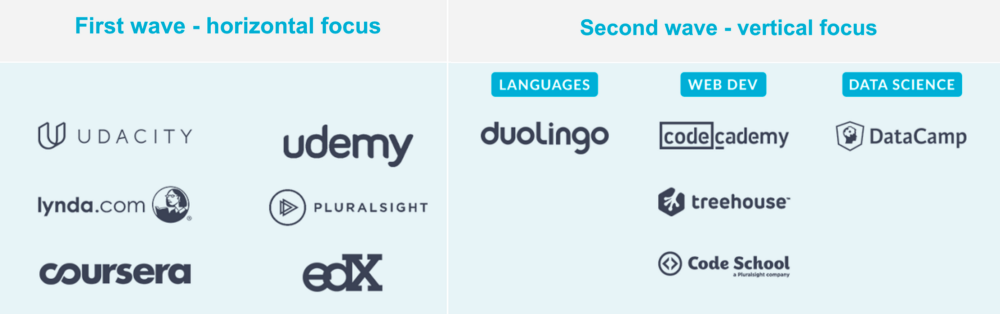
Si tomas perspectiva del mercado de la educación online en los últimos años, la primera ola de empresas copió en gran medida el enfoque horizontal del mundo físico, mientras que la segunda ola ha sido más tecnológica y vertical (centrada en un área concreta de competencias). El impacto positivo de la primera ola ha sido —sin duda— enorme, al lograr que la educación de calidad llegara a escala. Dicho esto, no avanzaron demasiado en aprovechar la tecnología para mejorar de verdad la experiencia de aprendizaje y, desde el punto de vista tecnológico, resultan poco emocionantes. Su enfoque horizontal hace que sea muy difícil superar el equilibrio tradicional entre personalización y escalabilidad en educación. ¿A qué me refiero?
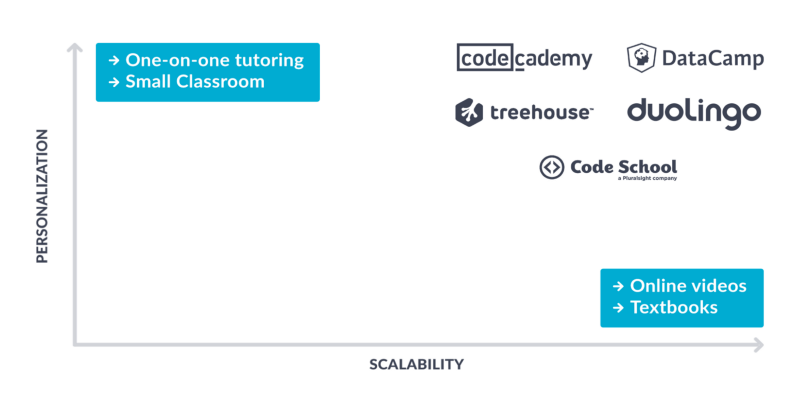
Las experiencias educativas más personalizadas solían ser muy difíciles de escalar. La tutoría uno a uno o las clases en grupos reducidos ofrecen una experiencia muy personalizada. Sin embargo, la falta de escalabilidad suele encarecer mucho estas opciones (y, por tanto, solo están al alcance de unos pocos). En el otro extremo, experiencias altamente escalables como la formación en vídeo o los libros de texto son asequibles, pero carecen de personalización. Esa falta de personalización a menudo reduce la eficacia y el compromiso. Las tasas de finalización relativamente bajas de los MOOC tradicionales son un buen ejemplo de cómo un menor compromiso impacta en el aprendizaje.
La tecnología y un enfoque vertical nos permiten ahora superar el compromiso clásico entre escalabilidad (y asequibilidad) y personalización, creando experiencias personalizadas a gran escala. Permite a los estudiantes aprender haciendo y acercar al máximo la formación —en nuestro caso— al trabajo en proyectos reales de ciencia de datos. Muchos de nuestros cursos superan el 50% de tasa de finalización, lo que indica que este enfoque mejora el compromiso.
Una red de instructores expertos ofrece la mejor experiencia educativa
La primera ola de educación online adolecía de falta de personalización, pero acertó en un ingrediente clave: aprovechó la experiencia y el conocimiento de algunas de las personas más brillantes en cada disciplina.
La segunda ola parece haber olvidado el poder de colaborar con socios externos para crear contenidos. En cambio, nosotros creemos firmemente en la importancia de construir una red de instructores externos tanto de la industria como del mundo académico. Para enseñar el uso de herramientas open source, puede ser el propio autor del paquete; para temas más teóricos, un profesor de reconocido prestigio; para contenidos más aplicados, una persona experta del sector. Las ventajas de este enfoque son:
- Colaborar con instructores externos nos permite ampliar la biblioteca de cursos más rápido, algo esencial en un campo tan dinámico como la ciencia de datos, donde nuestros estudiantes quieren aprender lo último desde ya.
- Contar con cursos creados por profesionales del sector garantiza que enseñamos competencias relevantes para el mercado laboral.
- Incluir cursos desarrollados por académicos permite a DataCamp apoyarse en investigaciones (recientes), su reputación y su experiencia docente.
- Un segmento de nuestros estudiantes se motiva más si el curso lo imparte una persona experta real o uno de sus referentes del open source.
Valoramos enormemente nuestras colaboraciones en creación de cursos con empresas como Anaconda. También creemos que lograremos la mejor colección de cursos en ciencia de datos aprovechando una red de instructores individuales además de estas alianzas. Quizá te preguntes: «¿por qué no asociarse con universidades para crear la biblioteca de cursos? ¿o con editoriales?» Hay muchas razones por las que pensamos que sería subóptimo. Primero, tratar con los departamentos legales de esas organizaciones sería más lento, y no nos gusta ir despacio. Segundo, creemos que el progreso tecnológico en las plataformas educativas puede y debe empoderar al creador individual de contenido. Ya ocurrió en la industria musical, en parte en el entretenimiento, y ahora está sucediendo en la educación. Para quien le interese: puedes encontrar aquí la lista completa de instructores de DataCamp.
La certificación del nivel de competencia como mecanismo de conexión
Para resolver la escasez de personas con competencias en datos no basta con formar a la gente de manera asequible y a escala. Hace falta un mecanismo de conexión eficiente que ayude a las personas a comunicar su nivel y a las organizaciones a encontrar a quienes tienen las competencias que necesitan (tanto dentro como fuera de la empresa).
Durante siglos, los títulos universitarios han sido la forma más común de señalar capacidad y competencias a posibles empleadores. Hay dos razones de peso para pensar que los títulos tradicionales no serán el principal mecanismo de señalización de la fluidez en datos:
- El número de personas que adquieran competencias en datos a través del sistema tradicional será relativamente pequeño respecto al total de quienes adquieran estas competencias en la próxima década. Nuestros datos confirman esta hipótesis: con diferencia, el grupo más grande de estudiantes tiene entre 25 y 35 años.
- La ciencia de datos aún está madurando como campo y las competencias relevantes cambian cada año. Por tanto, se necesita un mecanismo de señalización que evolucione con el campo y que se pueda actualizar de forma eficiente. Eso también exige aprendizaje a lo largo de la vida, algo que la mayoría de instituciones tradicionales no puede ofrecer. Hay tantas cosas posibles que aprender que es imposible «dominar» la ciencia de datos en la universidad, ni siquiera con un grado, un máster o un doctorado. Un máster no te convierte en maestro de la ciencia de datos ;-).
Surgen dos mecanismos de señalización como alternativas:
- Las certificaciones de finalización de cursos son comunes en la mayoría de plataformas online. Aportan valor como indicador de motivación. Sin embargo, son poco eficaces para comunicar nivel porque: (i) a menudo no están diseñadas para medir competencias de manera rigurosa, y (ii) muy pocos cursos tienen el volumen necesario para aspirar a un reconocimiento real en el mercado.
- Los mecanismos de certificación que miden el nivel de competencia han surgido en campos como la computación en la nube como una forma eficaz de comunicar nivel. La certificación es ya una vía habitual para que los profesionales de TI se diferencien, y no solo ahí. Duolingo lanzó recientemente su versión del examen TOEFL para evaluar idiomas, y el GMAT lleva mucho tiempo aceptándose en escuelas de negocios. En ciencia de datos, sin embargo, nadie ha creado todavía una forma de evaluar y certificar el nivel de una persona. Nos gustaría crear ese sistema de evaluación porque creemos que es una oportunidad enorme para ayudar a la gente a comunicar mejor su nivel y a las empresas a entender el de su plantilla y de sus candidaturas.
Conclusión
La ubicuidad de los datos crea oportunidades enormes para que personas y empresas tomen mejores decisiones y lleven la delantera. Sin embargo, la creciente brecha de talento limita el impacto positivo del análisis de datos en el mundo. Por un lado, las empresas no encuentran el talento que necesitan; por otro, hay mucha gente con acceso limitado a recursos educativos de calidad (por precio y disponibilidad).
Creemos en la educación online como vía para resolver este problema. En concreto, creemos en el valor de la personalización para crear una experiencia de aprendizaje atractiva y eficaz. Además, creemos en la fuerza de una red de instructores expertos para crear esa formación. Y, por último, creemos que al mercado le falta un mecanismo de conexión eficaz.
En un próximo artículo, profundizaremos en el plan de DataCamp.



