DataCamps Auftrag ist es, Einzelpersonen und Unternehmen auf jedem Schritt ihres Weges zur Datenkompetenz zu begleiten – mit der smartesten Plattform für Datenwissenschaft, die es gibt.
Dieser Beitrag liefert mehr Kontext dazu, warum wir DataCamp auf Makroebene gegründet haben. Zuerst betrachten wir den Markt für Datenwissenschaft und Talente. Im zweiten Teil geht es um die Säulen unserer Vision für die Zukunft der Datenbildung. Abschließend beleuchten wir die Rolle von Zertifizierungen.
Der Markt
Die Chance
Wer Daten auswerten kann, trifft bessere Entscheidungen und entwickelt neue, bessere Produkte und Services. Wir sind überzeugt, dass der Einfluss von Datenanalyse und Datenwissenschaft in den nächsten 20 Jahren so groß sein wird wie der von Softwareentwicklung und Informatik in den vergangenen 20 Jahren. Software erobert die Welt, aber Datenwissenschaft und KI setzen noch einen drauf.
Die Talentlücke
So spannend das ist, es gibt ein Problem: Harvard Business Review und ein McKinsey-Report haben früh auf den Mangel an Data Scientists hingewiesen. Heute kämpfen Unternehmen in allen Branchen damit, Data Scientists oder Menschen mit ausreichender Datenkompetenz zu finden. Schätzungen zur (künftigen) Knappheit reichen je nach aktueller Studie von Hunderttausenden bis zu Millionen fehlender Fachkräfte.
Über die Genauigkeit lässt sich streiten, aber eins ist klar: Traditionelle Bildungseinrichtungen können in den nächsten Jahrzehnten nicht genug Menschen ausbilden, um diese Lücke zu schließen. Zudem hat ein großer Teil der Welt keinen Zugang zu hochwertiger Datenbildung an klassischen Institutionen – oft schlicht aus Kostengründen.
Die Kraft der Datenwissenschaft können wir deshalb nur entfalten, wenn wir Wege finden, die bestehende Belegschaft kostengünstig weiterzubilden. Einerseits wird eine große Gruppe sich aus eigener Initiative weiterbilden, um in der Karriere voranzukommen (und in geringerem Maße auch, um umzusteigen). Andererseits werden Unternehmen erhebliche Teile ihrer Mitarbeitenden neu qualifizieren. Wichtig: Die Gruppe, die für den nächsten Karriereschritt lernt, ist größer als jene, die wegen eines kompletten Jobwechsels lernt. Das ist nicht neu. lynda.com und Pluralsight haben gezeigt, dass der Fokus auf berufsbegleitende Weiterbildung in Kreativ- bzw. Entwicklerberufen erfolgreich ist.
Außerdem gilt: Die Fähigkeitslücke existiert auf mehreren Ebenen – von Menschen, die wöchentlich mit Daten arbeiten und an die Grenzen ihrer aktuellen Tools (häufig Microsoft Excel) stoßen, über Data Analysts und Data Scientists bis hin zu Führungskräften und Beraterinnen. Alle haben unterschiedliche Bedürfnisse, doch überall fehlt es an der passenden Datenkompetenz.
Darum sind wir überzeugt, dass der Markt für Datenkompetenz riesig ist – vermutlich größer als der Markt für reine Programmier-Grundkurse. Zwei Datenpunkte stützen diese Annahme:
- Über sechzig Prozent unserer 1,7 Millionen Lernenden sind Berufstätige aus unterschiedlichsten Bereichen (Beratung, Finanzen, Gesundheitswesen, Forschung, Marketing, …) in verschiedensten Rollen. Einige von ihren Geschichten findest du auf DataCamp.
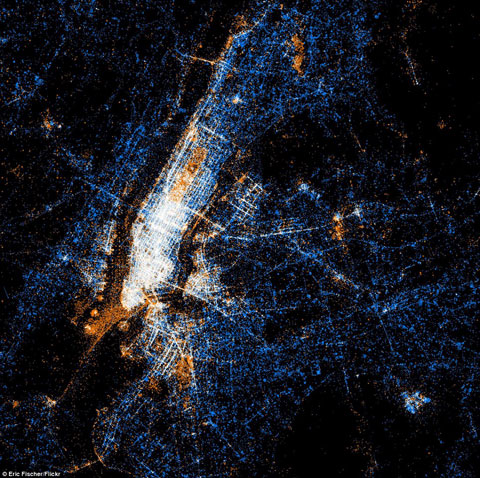
- Viele bringen Datenwissenschaft mit der Tech-Branche in Verbindung und denken deshalb, San Francisco sei das Mekka der Data Science. Tatsächlich ist Data Science keineswegs auf San Francisco beschränkt. Sortierst du DataCamps Lerntraffic nach Städten, landet San Francisco nur auf Platz 24 – übertroffen von sieben Städten in Indien und vier Städten in den USA (New York City liegt in den USA auf Platz 1). Der Bedarf an Datenkompetenz ist überall. ### Der Shift zu Open Source Open-Source-Software hat die Webentwicklung grundlegend verändert – und verändert nun auch Statistik und Datenwissenschaft. Während SAS und SPSS früher die angewandte Statistik dominierten, haben Open-Source-Technologien wie R und Python diese Rolle weitgehend übernommen. Übrigens hat DataCamp auch einige Kurse und Technologien als Open Source veröffentlicht. Dass Open Source die Basis der zukünftigen Datenwissenschaft ist, lässt sich kaum bestreiten. Deshalb liegt unser Trainingsfokus aktuell vollständig auf Open Source. Zudem erleichtert dessen Natur den Aufbau interaktiver Lernwerkzeuge. Der Fokus erlaubt es uns auch, den Open-Source-Communities etwas zurückzugeben: Über unser Tantiemenmodell bieten wir Open-Source-Mitwirkenden, die DataCamp-Kurse erstellen, skalierbare Einnahmen. Open Source bleibt ein großer Teil unseres Lernprogramms, dennoch wollen wir unseren Lernenden langfristig alle relevanten Tools und Methoden anbieten. Rechne also damit, dass wir künftig auch Trainings für proprietäre Tools entwickeln. ## Die Zukunft der Datenbildung Vertikaler Fokus und Technologie ermöglichen das beste Lernerlebnis Die Universität Bologna in Italien wurde 1088 gegründet und ist die älteste Europas.
Traditionell deckten Bildungseinrichtungen ein breites Themenspektrum ab (nennen wir das einen horizontalen Fokus). So lehrt die älteste Universität Europas Fächer von Geschichte über Wirtschaft, Psychologie, Statistik usw. Dieser horizontale Fokus ergab damals Sinn – dank (i) Skaleneffekten (Gebäude, Verwaltung, die klügsten Professoren, Markenwert von Abschlüssen …) und (ii) begrenzter geografischer Reichweite bei hohen Kommunikations- und Transportkosten. Dieses Modell dominierte über Jahrhunderte – daher denken wir bis heute oft in horizontal aufgestellten Bildungseinrichtungen.
Transport- und Kommunikationskosten sowie die Fixkosten der Bildungsmodelle sind dank technologischer Fortschritte stark gesunken. Was bedeutet das für die Bildungslandschaft heute und morgen?
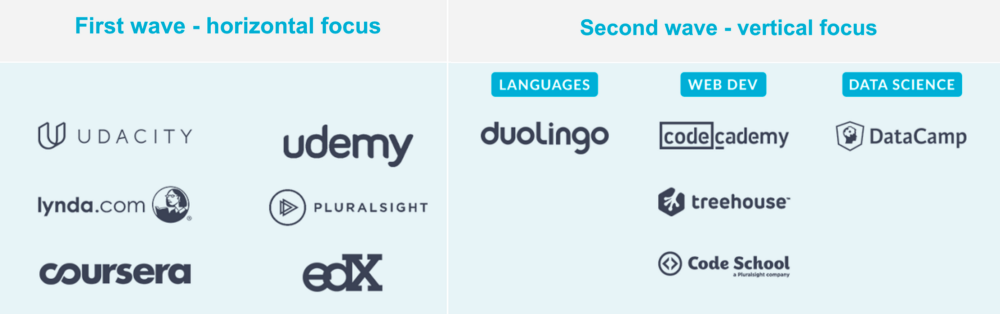
Aus der Vogelperspektive hat die erste Welle von Online-Bildungsunternehmen das horizontale Präsenzmodell weitgehend kopiert, während die zweite Welle technologischer und vertikal fokussierter ist (also auf ein Kompetenzfeld spezialisiert). Die erste Welle hat zweifellos Großes geleistet: hochwertige Bildung in die Breite zu bringen. Allerdings wurde Technologie selten genutzt, um das Lernen wirklich zu verbessern – aus Tech-Perspektive oft wenig aufregend. Ihr horizontaler Fokus macht es extrem schwer, den klassischen Zielkonflikt zwischen Personalisierung und Skalierung in der Bildung aufzulösen. Was heißt das konkret?
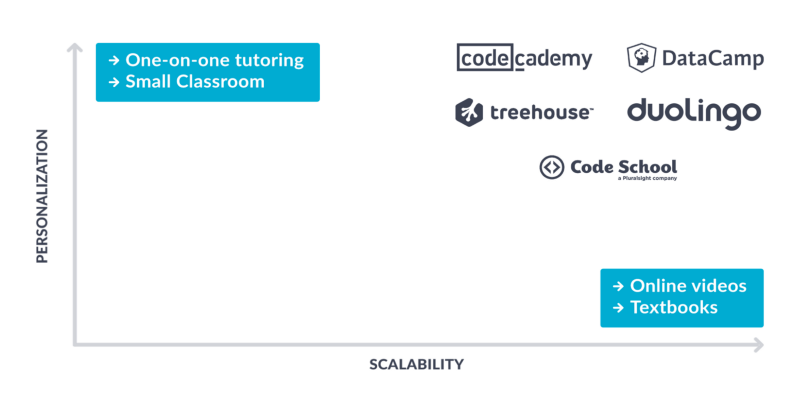
Hochgradig personalisierte Lernformate ließen sich früher kaum skalieren. Einzelcoaching, Kleingruppenunterricht etc. bieten ein hervorragendes, individuelles Lernerlebnis, sind aber mangels Skalierbarkeit teuer – und damit nur wenigen zugänglich. Umgekehrt sind skalierbare Formate wie Online-Videos oder Lehrbücher erschwinglich, aber unpersönlich. Fehlende Personalisierung schmälert Wirksamkeit und Motivation – niedrige Abschlussraten klassischer MOOCs belegen das.
Technologie und ein vertikaler Fokus erlauben heute, diesen Zielkonflikt zu überwinden: personalisierte Lernerlebnisse in großem Maßstab – bezahlbar und wirksam. Lernende können durch Praxis lernen und das Erlebnis – in unserem Fall – möglichst nah an echte Data-Science-Projekte heranführen. Viele unserer Kurse erreichen Abschlussraten über 50 %, was die höhere Lernmotivation unterstreicht.
Ein Netzwerk aus Fachexpertinnen und -experten liefert das beste Lernerlebnis
Die erste Welle litt unter mangelnder Personalisierung, setzte aber auf einen entscheidenden Faktor: Sie nutzte das Wissen einiger der klügsten Köpfe ihrer Fachgebiete.
Die zweite Welle scheint die Stärke externer Partner bei der Inhaltserstellung unterschätzt zu haben. Wir setzen bewusst auf ein Netzwerk externer Dozentinnen und Dozenten aus Industrie und Wissenschaft. Für Open-Source-Tools kann das die Paket-Autorin sein, für theoretische Themen eine anerkannte Professorin, für praxisnahe Inhalte ein Branchenprofi. Die Vorteile:
- Mit externen Instructoren bauen wir die Kursbibliothek schneller aus – entscheidend in einem sich rasant entwickelnden Feld, in dem Lernende am liebsten schon gestern die neuesten Kompetenzen hätten.
- Ein Teil der Kurse aus der Industrie stellt sicher, dass wir arbeitsmarktrelevante Kompetenzen vermitteln.
- Ein Teil aus der Wissenschaft ermöglicht es DataCamp, auf aktueller Forschung, Reputation und didaktischer Erfahrung aufzubauen.
- Einige Lernende sind motivierter, wenn echte Expertinnen oder ihre Open-Source-Vorbilder unterrichten.
Wir schätzen unsere Kurs-Partnerschaften mit Unternehmen wie Anaconda. Gleichzeitig glauben wir, dass die beste Kurssammlung entsteht, wenn wir zusätzlich ein Netzwerk individueller Instructoren einbinden. Warum nicht ausschließlich mit Universitäten oder Verlagen zusammenarbeiten? Aus mehreren Gründen wäre das suboptimal. Erstens verlangsamen lange Abstimmungen mit Rechtsabteilungen – und wir mögen es nicht langsam. Zweitens sollte technologischer Fortschritt bei Lernplattformen den individuellen Content-Creator stärken. Das sehen wir in der Musikbranche, teils in der Unterhaltung – und jetzt in der Bildung. Für Interessierte: hier findest du die komplette Liste der DataCamp-Instructoren.
Zertifizierung als Matching-Mechanismus
Um den Mangel an Datenkompetenz zu beheben, reicht es nicht, Menschen günstig und skalierbar weiterzubilden. Es braucht einen effizienten Matching-Mechanismus, damit Individuen ihr Kompetenzniveau belegen können und Organisationen die passenden Talente finden – intern wie extern.
Über Jahrhunderte dienten Uni-Abschlüsse als wichtigstes Signal an Arbeitgeber. Warum traditionelle Abschlüsse kaum die Hauptrolle für Datenkompetenz spielen werden, hat zwei Gründe:
- Der Anteil der Menschen, die Datenkompetenzen im klassischen Bildungssystem erwerben, wird in den nächsten zehn Jahren relativ klein sein. Unsere Daten bestätigen das: Die mit Abstand größte Lerngruppe ist 25 bis 35 Jahre alt.
- Datenwissenschaft ist als Feld noch jung, relevante Kompetenzen wandeln sich jährlich. Es braucht also ein Signal, das sich mitentwickelt und effizient aktualisieren lässt. Das setzt lebenslanges Lernen voraus – etwas, das die meisten traditionellen Institutionen nicht bieten können. Es gibt so viel zu lernen, dass man Data Science an der Uni nicht vollständig „meistern“ kann – auch nicht mit Bachelor, Master oder PhD. Ein Master macht dich nicht zum Master of Data Science ;-).
Zwei Alternativen zeichnen sich ab:
- Kursabschluss-Zertifikate bieten die meisten Plattformen an. Sie sind wertvoll, um Motivation zu signalisieren. Für die Einordnung des Kompetenzniveaus taugen sie jedoch wenig, weil (i) selten rigoros gemessen wird und (ii) nur wenige Kurse genug Reichweite für echte Marktakzeptanz haben.
- Zertifizierungen, die das Kompetenzniveau messen, haben sich etwa im Cloud-Computing als effizienter Standard etabliert. Für IT-Profis sind Zertifikate ein gängiger Weg, sich zu profilieren. Und es gibt mehr Beispiele: Duolingo hat eine Alternative zum TOEFL gelauncht, der GMAT ist an Business Schools seit Langem anerkannt. In der Datenwissenschaft fehlt jedoch noch ein System, das Kompetenzen verlässlich bewertet und zertifiziert. Genau das möchten wir aufbauen – als große Chance für Menschen, ihr Niveau sichtbar zu machen, und für Unternehmen, die Kompetenzen ihrer Belegschaft und Bewerbenden zu verstehen.
Fazit
Die Allgegenwärtigkeit von Daten eröffnet enorme Chancen, bessere Entscheidungen zu treffen und voranzukommen. Doch die wachsende Talentlücke bremst den positiven Effekt der Datenanalyse. Unternehmen finden die Fachkräfte nicht, die sie brauchen, und viele Menschen haben wegen Preis und Verfügbarkeit nur begrenzten Zugang zu hochwertigen Lernressourcen.
Wir setzen auf Online-Bildung, um das zu lösen – mit Personalisierung für ein motivierendes, wirksames Lernerlebnis. Außerdem glauben wir an die Stärke eines Netzwerks von Fachexpertinnen und -experten für die Erstellung der Trainings. Und wir sehen die Lücke eines wirksamen Matching-Mechanismus im Markt.
In einem Folgebeitrag tauchen wir tiefer ein in DataCamps Plan.



