La mission de DataCamp est d’accompagner les particuliers et les entreprises à chaque étape de leur parcours vers la culture des données en bâtissant la plateforme de formation en data science la plus intelligente.
Cet article vise à donner davantage de contexte sur pourquoi nous avons lancé DataCamp à un niveau macro. Dans une première partie, nous analysons le marché des talents en data science. La deuxième partie présente les piliers qui soutiennent notre vision de l’avenir de la formation en data science. Enfin, nous abordons l’importance de la certification.
Le marché
L’opportunité
Savoir analyser les données permet aux personnes et aux organisations de prendre de meilleures décisions, de créer des produits et services plus performants et d’en imaginer de nouveaux, etc. Nous sommes convaincus que l’impact de l’analyse de données et de la data science au cours des 20 prochaines années sera comparable à celui de l’ingénierie logicielle et de l’informatique au cours des 20 dernières. Le logiciel dévore le monde, mais la data science et l’IA s’invitent à la table de l’ingénierie logicielle pour le dîner !
La pénurie de talents
C’est enthousiasmant, mais il y a un problème : la Harvard Business Review et un rapport de McKinsey ont été parmi les premiers à mettre en lumière la pénurie de data scientists. Aujourd’hui, les entreprises de tous les secteurs peinent effectivement à recruter des data scientists ou des profils dotés d’un bon niveau de culture des données. Les estimations du déficit (attendu) de data scientists vont de plusieurs centaines de milliers à plusieurs millions selon les analyses les plus récentes sur le sujet.
On peut débattre de la précision de ces prévisions, mais une chose est claire : les établissements d’enseignement traditionnels ne pourront pas former suffisamment de personnes dans les décennies à venir pour combler cet écart. En outre, une grande partie du monde n’a pas accès, au sein des institutions classiques, à un enseignement de qualité en data science, souvent (très) onéreux.
Par conséquent, la puissance de la data science ne pourra se déployer que si nous trouvons des moyens de requalifier la main-d’œuvre existante à coût maîtrisé. D’un côté, beaucoup d’individus vont chercher à monter en compétences par eux-mêmes pour progresser dans leur carrière (et, dans une moindre mesure, se reconvertir) ; de l’autre, les entreprises vont former une part significative de leurs équipes. Notons aussi que le groupe des personnes qui apprennent pour évoluer professionnellement est plus large que celui de celles qui apprennent pour changer de carrière. Ce constat n’est pas nouveau. lynda.com et Pluralsight ont démontré qu’un positionnement sur la formation continue est gagnant, respectivement dans les domaines créatifs et du développement.
Enfin, il est essentiel de comprendre que le déficit de compétences existe à plusieurs niveaux : il concerne aussi bien les personnes qui travaillent avec des données chaque semaine et atteignent les limites de leurs outils actuels (souvent Microsoft Excel), que les analystes, les data scientists, les managers et les consultants. Tous ces publics ont des besoins différents, mais tous souffrent d’un manque de talents ayant le bon niveau de culture des données.
Pour toutes ces raisons, nous pensons que le marché de la culture des données est immense, sans doute plus vaste que celui de l’initiation au code. Deux éléments semblent conforter cette conviction :
- Plus de soixante pour cent de nos 1,7 million d’apprenants sont des professionnels en activité, issus d’un large éventail de secteurs (conseil, finance, santé, recherche, marketing, …) et exerçant une grande variété de métiers. Vous pouvez lire certaines de leurs histoires sur DataCamp.
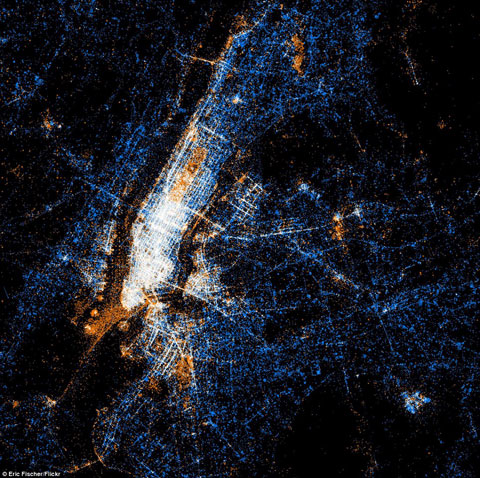
- Beaucoup associent la data science au secteur technologique et pensent donc que San Francisco en est la Mecque. Pourtant, la data science n’est pas du tout propre à San Francisco. Si l’on classe le trafic d’apprentissage de DataCamp par ville, San Francisco n’arrive qu’en 24e position, derrière 7 villes indiennes et 4 villes américaines (New York est la première aux États-Unis). Le besoin en data science est partout. ### Un virage vers l’open source Le développement open source a complètement transformé la communauté du web et transforme désormais les communautés des statistiques appliquées et de la data science. Alors que SAS et SPSS dominaient encore le monde des statistiques appliquées il n’y a pas si longtemps, des technologies open source comme R et Python semblent avoir largement pris le relais. D’ailleurs, DataCamp a aussi ouvert le code de certains cours et technologies. Difficile de contester la montée en puissance de l’open source comme socle de l’avenir de la data science. C’est la raison principale pour laquelle, aujourd’hui, toute notre formation en data science est axée sur l’open source. De plus, sa nature même facilite la création d’outils pédagogiques interactifs. Ce choix nous permet aussi de contribuer aux communautés open source en data science. Grâce à notre modèle de redevances, nous offrons des revenus récurrents et évolutifs aux contributeurs open source qui créent des cours DataCamp. Si l’open source restera une composante majeure de notre programme de formation dans les années à venir, notre ambition est, à terme, de proposer des formations sur tous les outils et méthodologies pertinents. Attendez-vous donc à nous voir créer aussi des formations sur des outils propriétaires. ## L’avenir de la formation en data science Un positionnement vertical et la technologie offrent la meilleure expérience d’apprentissage L’université de Bologne, en Italie, fondée en 1088, est la plus ancienne d’Europe.
Historiquement, les établissements d’enseignement couvraient un large éventail de disciplines (appelons cela un positionnement horizontal). Par exemple, la plus ancienne université d’Europe enseigne l’histoire, l’économie, la psychologie, les statistiques, etc. Ce positionnement horizontal se justifiait par (i) des économies d’échelle (bâtiments, administration des étudiants, attractivité des meilleurs professeurs, valeur de marque des diplômes, etc.) et (ii) une portée géographique limitée, du fait de coûts élevés de communication et de transport. Ce modèle horizontal a dominé pendant des siècles, ce qui explique pourquoi nous pensons encore souvent aux institutions éducatives comme étant horizontales.
Les coûts de transport et de communication, ainsi que les coûts fixes des modèles éducatifs, ont fortement chuté ces dernières décennies grâce aux progrès technologiques. Alors… quel impact sur le paysage éducatif, aujourd’hui et demain ?
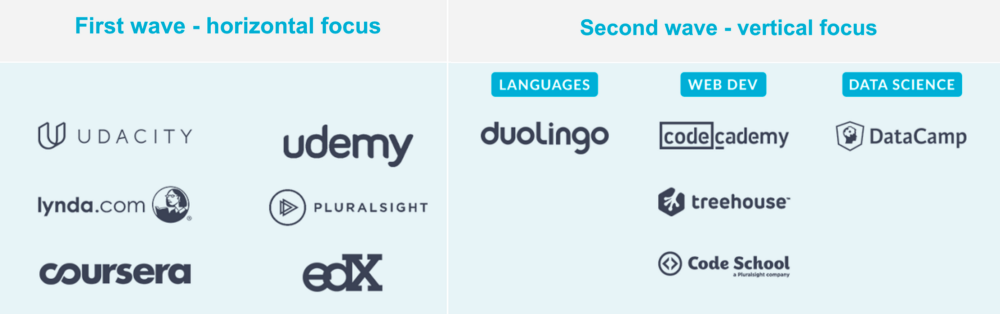
Avec du recul, sur les dernières années, la première vague d’acteurs de l’éducation en ligne a surtout reproduit l’approche horizontale des établissements physiques, tandis que la deuxième vague s’est montrée plus technologique et verticale (c’est-à-dire centrée sur un domaine de compétences précis). L’apport de la première vague a été — sans conteste — considérable, en rendant un enseignement de qualité accessible à grande échelle. Cela dit, ces acteurs ont peu exploité la technologie pour améliorer réellement l’expérience d’apprentissage et se révèlent même assez peu enthousiasmants d’un point de vue technologique. Leur approche horizontale rend très difficile le dépassement du compromis traditionnel entre personnalisation et passage à l’échelle dans l’éducation. Qu’entendons-nous par là ?
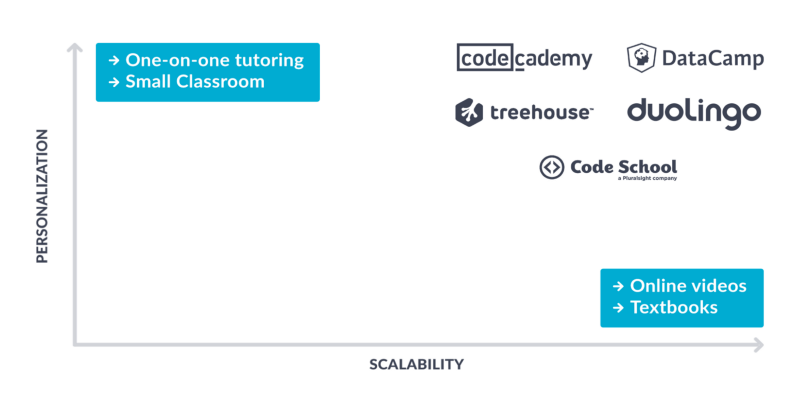
Les expériences pédagogiques les plus personnalisées étaient autrefois difficiles à déployer à grande échelle. Le tutorat individuel, les petites classes, etc. offrent une expérience très personnalisée, mais leur manque de scalabilité les rend généralement coûteux (et donc réservés à quelques privilégiés). À l’inverse, les formats très scalables comme la vidéo en ligne et les manuels sont souvent abordables, mais ils manquent de personnalisation. Cette absence de personnalisation réduit l’efficacité et l’engagement. Les taux d’achèvement relativement faibles des MOOC traditionnels en sont une bonne illustration.
La technologie et un positionnement vertical permettent désormais de dépasser le compromis entre scalabilité (et accessibilité) et personnalisation, en créant des expériences d’apprentissage personnalisées à grande échelle. Cela permet aux apprenants d’apprendre en pratiquant et de rapprocher l’expérience d’apprentissage — dans notre cas — des projets réels de data science. Beaucoup de nos cours affichent des taux d’achèvement supérieurs à 50 %, signe que l’engagement bénéficie de cette approche.
Un réseau d’instructeurs experts offre la meilleure expérience d’apprentissage
La première vague d’éducation en ligne souffre d’un manque de personnalisation, mais elle a eu le bon réflexe de s’appuyer sur l’expertise des meilleurs spécialistes de chaque domaine.
La deuxième vague semble avoir oublié la force des partenariats externes pour créer des contenus pédagogiques. À l’inverse, nous croyons fermement à l’importance de constituer un réseau d’instructeurs externes issus à la fois de l’industrie et du monde académique. Pour l’enseignement des outils open source, il peut s’agir de l’auteur du package ; pour les sujets plus théoriques, d’un professeur reconnu ; pour les sujets appliqués, d’un expert du terrain. Les bénéfices de cette approche sont les suivants :
- Collaborer avec des instructeurs externes nous permet d’enrichir plus vite notre catalogue, ce qui est essentiel dans un domaine en mouvement rapide, où nos apprenants veulent acquérir les dernières compétences sans attendre.
- Confier une partie des cours à des experts du secteur garantit l’adéquation avec les besoins du marché de l’emploi.
- Confier une partie des cours à des universitaires permet à DataCamp de s’appuyer sur des recherches (récentes), leur réputation et leur expérience pédagogique.
- Une partie de nos apprenants est plus motivée lorsque le cours est dispensé par un véritable expert ou par l’une de leurs références de l’open source.
Nous attachons une grande importance à nos partenariats de création de cours avec des entreprises comme Anaconda. Nous pensons aussi que la meilleure collection de cours en data science se construit en combinant ces partenariats avec un réseau d’instructeurs indépendants. Vous pourriez demander : « pourquoi ne pas s’associer à des universités pour créer le catalogue de cours ? ou à des éditeurs ? ». Pour de nombreuses raisons, cela nous semble sous-optimal. D’abord, traiter avec les services juridiques de ces organisations est plus lent, et nous n’aimons pas la lenteur. Ensuite, nous croyons que le progrès technologique des plateformes d’apprentissage peut et doit donner du pouvoir aux créateurs individuels de contenu. Cela s’est produit dans la musique, en partie dans le divertissement, et cela arrive désormais dans l’éducation. Pour les curieux : la liste complète des instructeurs de DataCamp est disponible ici.
La certification des compétences comme mécanisme d’appariement
Pour résoudre la pénurie de compétences data, il ne suffit pas de former à grande échelle et à coût raisonnable. Il faut un mécanisme d’appariement efficace pour aider chacun à communiquer son niveau de compétence et aider les organisations à identifier les profils dont elles ont besoin (en interne comme en externe).
Pendant des siècles, le diplôme universitaire a été le moyen le plus courant de signaler ses aptitudes et compétences aux employeurs. Il y a deux raisons majeures de douter que les diplômes traditionnels restent le principal mécanisme de signalement pour la culture des données :
- La part de personnes qui acquerront des compétences data via le système éducatif traditionnel restera relativement faible par rapport au volume total de celles qui les acquerront dans la prochaine décennie. Nos données le confirment : de loin, le plus gros segment d’apprenants a entre 25 et 35 ans.
- La data science est encore jeune comme discipline et les compétences pertinentes évoluent chaque année. Il faut donc un mécanisme de signalement qui évolue avec le domaine et se mette à jour efficacement. Cela implique aussi l’apprentissage tout au long de la vie, que la plupart des institutions traditionnelles ne sont pas en mesure d’offrir. Les possibilités d’apprentissage sont si nombreuses que la data science ne peut pas être « maîtrisée » à l’université, même après une licence, un master ou un doctorat. Un master ne vous fera pas « maîtriser » la data science ;-).
Deux mécanismes alternatifs émergent :
- Les attestations de fin de cours, proposées par la plupart des plateformes en ligne. Elles ont certes de la valeur pour attester de la motivation. Mais elles communiquent mal le niveau réel de compétence, car (i) elles ne sont pas toujours conçues pour mesurer rigoureusement ce niveau, et (ii) très peu de cours ont la notoriété suffisante pour être reconnus sur le marché.
- Les dispositifs de certification qui mesurent le niveau de compétence se sont imposés, par exemple dans le cloud, comme un moyen efficace de démontrer son niveau. La certification est aujourd’hui un usage courant chez les professionnels de l’IT, et pas seulement. Duolingo a récemment lancé sa version du test TOEFL pour évaluer les compétences linguistiques, et le GMAT est accepté de longue date par les écoles de commerce. En data science, pourtant, personne n’a encore proposé un référentiel fiable pour évaluer et certifier le niveau de compétence. Nous souhaitons bâtir ce système d’évaluation, car nous pensons qu’il représente une opportunité majeure d’aider les individus à mieux valoriser leurs compétences et les entreprises à comprendre le niveau de leurs équipes comme de leurs candidats.
Conclusion
L’omniprésence des données ouvre des perspectives immenses pour aider les personnes et les organisations à décider mieux et à prendre l’avantage. Mais la pénurie croissante de talents limite l’impact positif de l’analyse de données dans le monde. D’un côté, les entreprises ne trouvent pas les profils dont elles ont besoin ; de l’autre, un grand nombre de personnes ont un accès limité à des ressources pédagogiques de qualité (pour des raisons de prix et de disponibilité).
Nous croyons à l’éducation en ligne pour résoudre ce problème. Plus précisément, nous croyons à la valeur de la personnalisation pour créer une expérience d’apprentissage engageante et efficace. Nous sommes également convaincus de la force d’un réseau d’instructeurs experts pour concevoir ces formations. Enfin, nous pensons que le marché manque d’un mécanisme d’appariement réellement efficace.
Dans un prochain article, nous détaillerons le plan de DataCamp.