
De missie van DataCamp is om individuen en bedrijven in elke fase van hun reis te helpen om datavaardig te worden door het slimste data-science-onderwijsplatform te bouwen.
Deze post wil meer context geven over waarom we DataCamp op macroniveau zijn gestart. In het eerste deel bespreken we de markt voor data science (talent). Het tweede deel behandelt de kernpijlers die onze visie op de toekomst van data-onderwijs ondersteunen. Tot slot gaan we in op het belang van certificering.
De markt
De kans
Begrijpen hoe je data analyseert, stelt mensen en bedrijven in staat betere beslissingen te nemen en betere & nieuwe diensten en producten te creëren, enzovoort. Wij denken dat de impact van data-analyse en data science in de komende 20 jaar net zo groot zal zijn als de impact van software-engineering en informatica in de afgelopen 20 jaar. Software eet de wereld op, maar data science en AI gaan software-engineering als avondmaal nemen!
Het tekort aan talent
Hoe spannend dat ook is, er is een probleem: Harvard Business Review en een McKinsey-rapport wezen als eersten op het tekort aan data scientists. Vandaag de dag hebben bedrijven in elke sector moeite om data scientists te vinden of mensen met een behoorlijk niveau van data geletterdheid/-vloeiendheid. Cijfers over het (verwachte) tekort aan data scientists lopen in de meer recente onderzoeksrapporten uiteen van honderden duizenden tot miljoenen.
Je kunt de nauwkeurigheid van deze voorspellingen betwisten, maar één ding is duidelijk: traditionele onderwijsinstellingen kunnen de komende decennia niet genoeg mensen opleiden om dit gat te dichten. Bovendien heeft een groot deel van de wereld geen toegang tot hoogwaardig data-science-onderwijs aan traditionele instellingen, omdat het vaak (zeer) kostbaar is.
Daarom kan de kracht van data science alleen worden benut als we manieren vinden om de bestaande beroepsbevolking betaalbaar om te scholen. Enerzijds mag je verwachten dat een grote groep individuen zichzelf bijschoolt om hun carrière te versnellen (en in mindere mate om van carrière te wisselen), anderzijds mogen we verwachten dat bedrijven een aanzienlijk deel van hun personeel omscholen. Merk ook op dat de groep mensen die leert voor carrièreprogressie groter is dan de groep die leert omdat ze van carrière willen veranderen. Deze observatie is niet nieuw. lynda.com en Pluralsight hebben bewezen dat een focus op permanent leren respectievelijk in de creatieve en developerswereld een winnende strategie is.
Ten slotte is het belangrijk te beseffen dat de vaardigheidskloof op meerdere niveaus bestaat: van mensen die wekelijks met data werken en tegen de grenzen van hun huidige tools aanlopen (vaak Microsoft Excel), tot data-analisten en data scientists, tot managers en consultants. Al deze groepen hebben verschillende behoeften, maar voor al deze groepen is er een tekort aan mensen met het juiste niveau van data geletterdheid/-vloeiendheid.
Door het bovenstaande denken wij dat de onderwijsmarkt voor datageletterdheid enorm is en waarschijnlijk groter dan de markt voor het aanleren van basis-codeskills. Twee datapuntengeven lijken deze overtuiging te bevestigen:
- Meer dan zestig procent van onze 1,7 miljoen studenten zijn werkende professionals die actief zijn in uiteenlopende gebieden (consultancy, financiën, gezondheidszorg, onderzoek, marketing, …) en uiteenlopende rollen vervullen. Je kunt hun verhalen op DataCamp lezen.
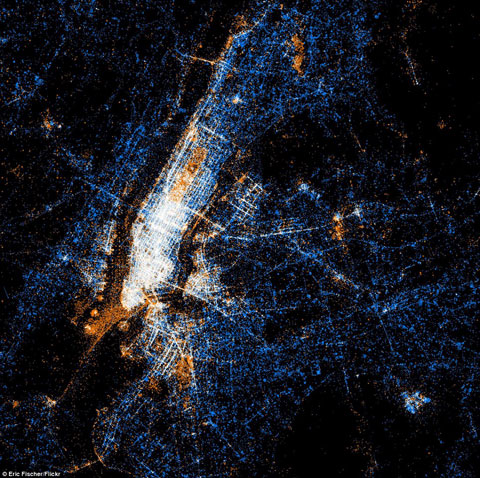
- Veel mensen associëren data science met de technologiesector en denken daarom dat San Francisco de Mekka van data science is. Data science is echter helemaal niet uniek voor San Francisco. Als je DataCamp’s leerverkeer per stad rangschikt, staat San Francisco pas op plaats 24, voorbijgestreefd door 7 steden in India en 4 steden in de VS (New York City is nummer 1 in de VS). De behoefte aan data science is overal. ### Een verschuiving naar open source Open-sourcesoftwareontwikkeling heeft de webontwikkelcommunity volledig getransformeerd en transformeert nu de community voor toegepaste statistiek en data science. Waar SAS en SPSS niet zo lang geleden de wereld van toegepaste statistiek domineerden, lijken open-sourcetechnologieën zoals R en Python het nu zo goed als te hebben overgenomen. Overigens heeft DataCamp ook sommige cursussen en technologie open-source gemaakt. Het is moeilijk te ontkennen dat de groei van open-sourcesoftware de fundamentele laag vormt onder de toekomst van data science. Dit is de belangrijkste reden dat al onze data-sciencetraining momenteel op open source is gericht. Bovendien maakt de aard ervan het eenvoudiger om er interactieve educatieve tools bovenop te bouwen. Een focus op open source stelt ons ook in staat om iets terug te geven aan de open-source data-sciencegemeenschappen. Via ons royaltymodel bieden we schaalbare inkomstenstromen aan open-sourcebijdragers die DataCamp-cursussen bouwen. Hoewel open source een groot deel van ons curriculum zal blijven in de komende jaren, willen we uiteindelijk training aanbieden over elk relevant hulpmiddel en elke relevante methodologie. Verwacht dat we in de toekomst ook training voor propriëtaire tools gaan bouwen. ## De toekomst van data-science-onderwijs Een verticale focus en technologie maken de beste leerervaring mogelijk De Universiteit van Bologna in Italië werd opgericht in 1088 en is de oudste van Europa.
Historisch gezien behandelden onderwijsinstellingen een breed scala aan onderwerpen (laten we dit een horizontale focus noemen). Zo geeft de oudste universiteit van Europa les in onderwerpen variërend van geschiedenis, economie, psychologie, statistiek, enzovoort. De horizontale focus was destijds logisch door de combinatie van (i) schaalvoordelen (rond gebouwen, studentenadministratie, het aantrekken van de slimste professoren, merkwaarde voor certificering, enz.) en (ii) een beperkte geografische reikwijdte door hoge communicatie- en transportkosten. Horizontale focus was eeuwenlang het dominante onderwijsmodel, waardoor we nog steeds geneigd zijn om onderwijsinstellingen als horizontaal georiënteerd te zien.
De kosten van vervoer & communicatie en de vaste kosten van de onderwijsmodellen zijn in de afgelopen decennia aanzienlijk gedaald dankzij technologische vooruitgang. Dus… wat betekent dat nu en in de toekomst voor het onderwijslandschap?
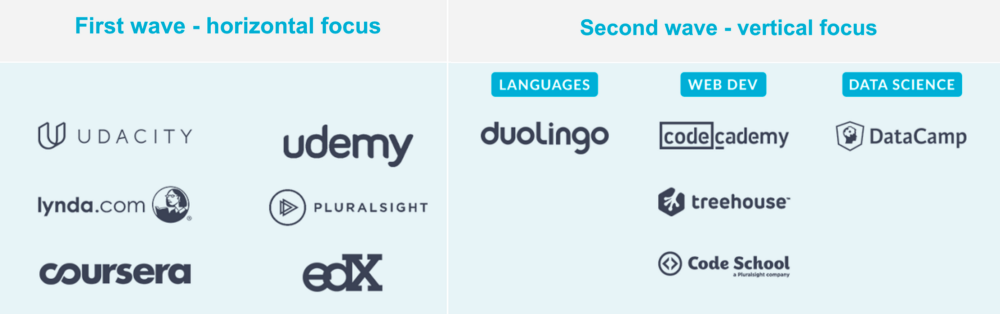
Als je met een helikopterblik naar de online onderwijsmarkt van de laatste tijd kijkt, dan heeft de eerste golf bedrijven vooral de horizontale aanpak van bakstenen en cement gekopieerd, terwijl de tweede golf technologischer en verticaal gefocust was (dus gericht op één vaardigheidsgebied). De positieve impact van de eerste golf in online onderwijs is — zonder twijfel — enorm geweest, omdat zij erin slaagden om onderwijs van hoge kwaliteit op schaal beschikbaar te maken. Dat gezegd hebbende, zijn ze niet erg ver gegaan in het benutten van technologie om de leerervaring echt te verbeteren, en vanuit technologisch oogpunt zijn ze zelfs wat onopwindend. Hun horizontale focus maakt het heel moeilijk om de traditionele afruil tussen personalisatie en schaalbaarheid in het onderwijs te doorbreken. Wat bedoel ik daarmee?
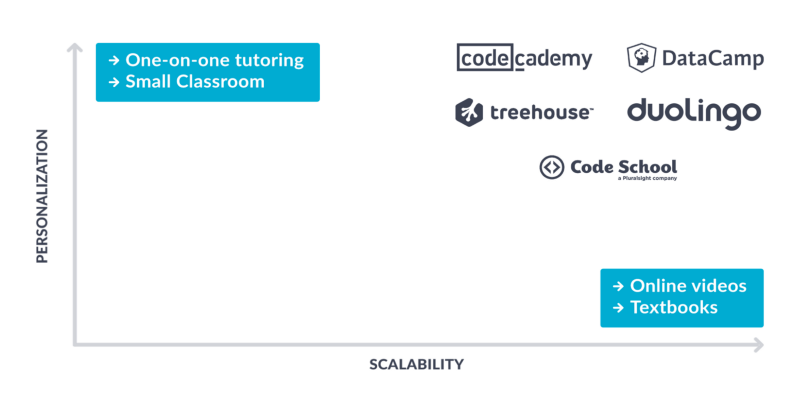
De meest gepersonaliseerde leerervaringen waren vroeger heel lastig op te schalen. Een-op-eenbegeleiding, trainingen in kleine klasjes, enz. kunnen een geweldige, sterk gepersonaliseerde leerervaring bieden. Door het gebrek aan schaalbaarheid zijn deze opties echter doorgaans erg duur (en dus alleen weggelegd voor een selecte groep). Aan de andere kant zijn zeer schaalbare leerervaringen zoals online videotraining en leerboeken vaak betaalbaar, maar ze missen personalisatie. Geen personalisatie maakt training vaak minder effectief en minder boeiend. De vrij lage slagingspercentages van traditionele MOOCs zijn een goed voorbeeld van hoe lagere betrokkenheid de leerresultaten beïnvloedt.
Technologie en een verticale focus stellen ons nu in staat om de typische afruil tussen schaalbaarheid (en betaalbaarheid) en personalisatie te doorbreken door gepersonaliseerde leerervaringen op schaal te bouwen. Het stelt studenten in staat om te leren door te doen en om de leerervaring zo dicht mogelijk te brengen bij — in ons geval — het werken aan echte data-scienceprojecten. Veel van onze cursussen hebben slagingspercentages van boven de 50%, wat erop wijst dat betrokkenheid baat heeft bij deze aanpak.
Een netwerk van expert-docenten levert de beste leerervaring op
De eerste golf in online onderwijs kampt met een gebrek aan personalisatie, maar had één essentieel ingrediënt goed: ze maakten gebruik van de ervaring en kennis van enkele van de slimste mensen in elk domein.
De tweede golf in online onderwijs lijkt de kracht te zijn vergeten van het benutten van externe partners om leermateriaal te ontwikkelen. Wij geloven daarentegen sterk in het belang van het opbouwen van een netwerk van externe docenten uit zowel het bedrijfsleven als de academische wereld. Voor het aanleren van open-sourcesoftwaretools kan dat heel goed de pakketontwikkelaar zelf zijn; voor meer theoretische onderwerpen kan het een gerespecteerde professor zijn; voor meer toegepaste onderwerpen moet het een industrie-expert zijn. De voordelen van deze aanpak zijn:
- Werken met externe docenten stelt ons in staat de bibliotheek met cursussen sneller uit te bouwen, wat essentieel is omdat data science een snel bewegend veld is en onze studenten het liefst gisteren nog de nieuwste skills willen leren.
- Als een deel van de cursusbibliotheek door industrie-experts wordt opgebouwd, borgen we dat we vaardigheden onderwijzen die relevant zijn voor de arbeidsmarkt.
- Als een deel van de cursusbibliotheek door academici wordt opgebouwd, kan DataCamp voortbouwen op (recent) onderzoek, hun reputatie en hun onderwijservaring.
- Een segment van onze studenten is extra gemotiveerd als de cursus wordt gegeven door een echte expert of door een van hun open-sourcehelden.
We hechten veel waarde aan onze samenwerkingen voor cursusontwikkeling met bedrijven zoals Anaconda. We geloven ook dat we de beste verzameling data-sciencecursussen kunnen bouwen door naast deze partnerships een netwerk van individuele docenten te benutten. Je zou kunnen vragen: “waarom niet met universiteiten samenwerken om de cursusbibliotheek te creëren? of met uitgevers?” Daar zijn veel redenen voor waarom dat suboptimaal zou zijn. Allereerst zou het werken met de juridische afdelingen van deze organisaties traag gaan, en wij houden niet van traag. Ten tweede geloven we uiteindelijk dat technologische vooruitgang in onderwijsplatforms de individuele contentmaker moet en kan versterken. Dit is in de muziekindustrie gebeurd, tot op zekere hoogte in de entertainmentindustrie en gebeurt nu in de onderwijssector. Voor wie geïnteresseerd is: een volledige lijst met DataCamp-docenten vind je hier.
Certificering van vaardigheidsniveau als matchingsmechanisme
Om het tekort aan mensen met datavaardigheden op te lossen, is het niet genoeg om mensen op een betaalbare en schaalbare manier op te leiden. Je hebt een efficiënt matchingsmechanisme nodig om individuen te helpen hun vaardigheidsniveau te communiceren en om organisaties te helpen mensen te vinden met de vaardigheden die ze nodig hebben (zowel binnen als buiten hun organisatie).
Eeuwenlang waren universitaire diploma’s de meest gebruikelijke manier om aan potentiële werkgevers vermogen en vaardigheden te signaleren. Er zijn twee belangrijke redenen waarom het moeilijk is te geloven dat traditionele diploma’s het belangrijkste signaalmechanisme zullen zijn voor datavloeiendheid:
- Het aantal mensen dat datavaardigheden via het traditionele onderwijssysteem verwerft, zal een relatief klein deel zijn van het totale aantal mensen dat deze vaardigheden in het komende decennium opdoet. Onze data bevestigen deze aanname; veruit de grootste groep lerenden is tussen de 25 en 35.
- Data science staat nog vroeg in zijn ontwikkeling als vakgebied en relevante vaardigheden veranderen nog elk jaar. Daarom heb je een signaleringsmechanisme nodig dat met het vakgebied meegroeit en efficiënt kan worden bijgewerkt. Dat vereist ook een leven lang leren, iets wat de meeste traditionele onderwijsinstellingen niet kunnen bieden. Er zijn zoveel mogelijke dingen te leren dat data science onmogelijk te beheersen is op de universiteit, zelfs niet na een bachelor, een master of zelfs een PhD. Masters zullen je geen meester maken in data science ;-).
Twee signaleringsmechanismen dienen zich aan als alternatief:
- Cursusvoltooiingscertificaten worden door de meeste online onderwijsplatforms aangeboden. Ze hebben zeker waarde als mechanisme om motivatie te signaleren. Cursusvoltooiingscertificaten zijn echter vrij ineffectief om vaardigheidsniveau te communiceren omdat: (i) ze vaak niet zo zijn ingericht dat ze het vaardigheidsniveau op een rigoureuze manier meten, en (ii) zeer weinig cursussen het volume hebben om zelfs maar kans te maken op erkenning in de markt.
- Certificeringsmechanismen die het vaardigheidsniveau meten zijn in vakgebieden zoals cloud computing ontstaan als een efficiënte en effectieve manier om vaardigheidsniveau te communiceren. Certificering is nu een gangbare manier voor IT-professionals om zich te onderscheiden, maar het blijft daar niet bij. Duolingo lanceerde onlangs hun versie van de TOEFL-test voor het beoordelen van taalvaardigheid, en de GMAT wordt al lange tijd breed geaccepteerd door business schools. In data science heeft echter nog niemand een manier gecreëerd om iemands vaardigheidsniveau te beoordelen en te certificeren. Wij willen dat beoordelingssysteem opzetten omdat we denken dat dit een enorme kans biedt om mensen te helpen hun vaardigheidsniveau beter te communiceren en voor bedrijven om het vaardigheidsniveau van hun bestaande personeel en sollicitanten beter te begrijpen.
Conclusie
De alomtegenwoordigheid van data creëert enorme kansen voor mensen en bedrijven om betere beslissingen te nemen en voorop te lopen. Het groeiende tekort aan talent beperkt echter de positieve impact die data-analyse op de wereld heeft. Aan de ene kant kunnen bedrijven het talent dat ze nodig hebben niet vinden, aan de andere kant is er een grote groep mensen met beperkte toegang tot hoogwaardige leermiddelen (vanwege prijs en beschikbaarheid).
Wij geloven in online onderwijs als manier om dit probleem op te lossen. Meer specifiek geloven we in de waarde van personalisatie om een boeiende en effectieve leerervaring te creëren. Daarnaast geloven we in de kracht van een netwerk van expert-docenten om die training te maken. Tot slot denken we dat de markt een effectief matchingsmechanisme mist.
In een vervolgartikel duiken we dieper in het plan van DataCamp.

