Last chance! 50% off DataCamp Premium
Sale ends in
Sembra che ogni volta che scorri LinkedIn, spunti un nuovo tool in un panorama dei dati già affollato. Man mano che i team dati continuano ad aggiungere componenti al loro “data stack”, hanno bisogno di un modo per gestire e collegare questi strumenti eterogenei.
L’orchestrazione dei dati è il processo di sviluppo, esecuzione e monitoraggio di processi che combinano, trasformano e organizzano i dati in tutto l’ecosistema informativo. Per farlo, i data engineer usano strumenti di orchestrazione dei dati. Qui esploreremo due dei tool di orchestrazione più popolari: Apache Airflow e Dagster. Iniziamo!
Airflow è lo standard di settore per creare, eseguire e monitorare pipeline di dati come codice. È stato sviluppato originariamente nel 2014 dal team di Data Engineering di Airbnb. Da allora, il progetto è stato adottato dalla Apache Software Foundation ed è diventato l’offerta più popolare sotto la loro licenza.
Ogni mese, Airflow viene scaricato più di trenta milioni di volte e ha una vivace community di contributori e utenti. In Airflow, le pipeline di dati sono chiamate DAG, ovvero grafi aciclici diretti.
Puoi saperne di più su Airflow nel nostro tutorial su come iniziare con Apache Airflow.
Come Airflow, Dagster è uno strumento di orchestrazione che consente di definire pipeline di dati come codice. È open source ed è stato lanciato originariamente nel 2019. Dagster usa Python per definire gli “asset”, i mattoni fondamentali di una pipeline di dati.
Dagster è emerso come competitor di Airflow in uno spazio relativamente poco affollato. Il progetto è mantenuto dalla sua community open source ed è supportato commercialmente da Dagster Labs.
Dunque, dove si inseriscono Airflow e Dagster in un modern data stack? Partiamo dallo schema architetturale qui sotto.
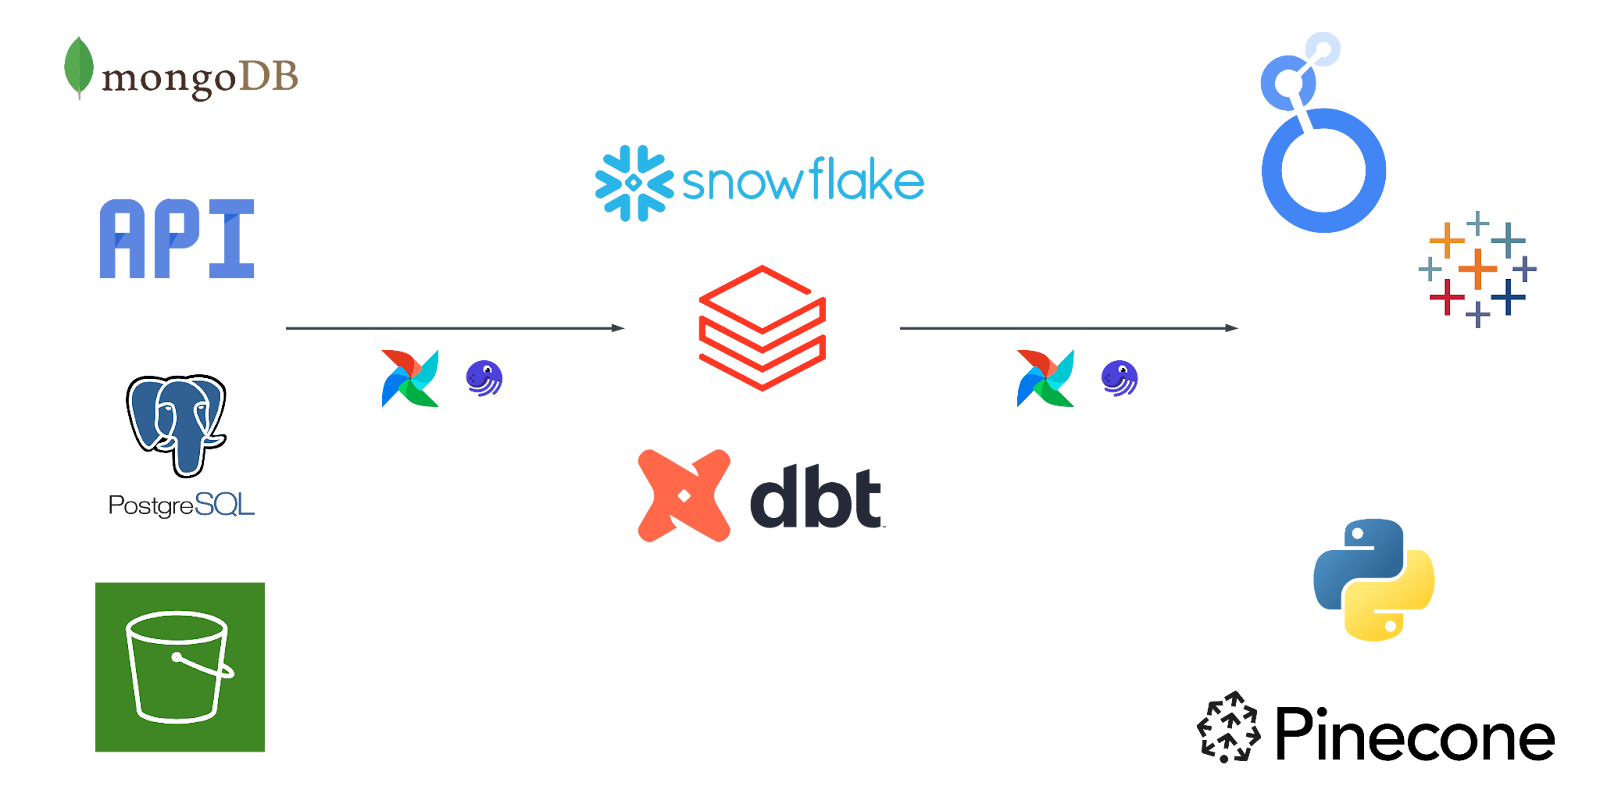
Uno schema architetturale con un campione di strumenti comuni usati nel modern data stack.
Questo schema architetturale mostra quello che molti considerano uno stack dati standard. È composto da sistemi sorgente, strumenti di data warehousing e trasformazione e “destinazioni” a valle come Tableau e Looker.
Qui, Airflow e Dagster sono le frecce che connettono questo ecosistema di dati. Senza uno strumento di orchestrazione, è difficile spostare i dati da un tool all’altro.
Gli strumenti di orchestrazione, come Airflow e Dagster, offrono anche un livello di osservabilità che rende facile capire dove, come e quando i dati vengono incanalati dalla sorgente alla destinazione e come vengono manipolati lungo il percorso.
Come avrai già intuito, Airflow e Dagster condividono diverse somiglianze nell’uso previsto e nel ruolo che ricoprono nel modern data stack. Tra queste:
Tuttavia, ciascuno offre un set unico di funzionalità che gli consente di distinguersi.
Iniziamo guardando alcune delle principali funzionalità di Airflow:
In Airflow, le pipeline di dati sono chiamate DAG, acronimo di directed-acyclic graphs. Pensa a un DAG come a una raccolta di task collegati in un ordine specifico. L’elemento base di un DAG è un task. Ad esempio, in una pipeline che esegue estrazione, trasformazione e caricamento (ETL), la fase di “transform” sarebbe un task a sé.
Questi task sono generalmente definiti usando gli operator di Airflow. Ma, come vedrai tra poco, c’è anche un altro modo per definire i task usando la TaskFlow API.
La schedulazione di una pipeline in Airflow è estremamente flessibile. Hai bisogno di eseguire una pipeline ogni giorno? Nessun problema. Vuoi che venga eseguita il primo venerdì di ogni mese? Anche questo è semplice. E se il tuo manager ti chiede di attivare un DAG quando un dataset viene aggiornato? Airflow gestisce anche questo.
Airflow offre molte opzioni di personalizzazione per schedulare i tuoi DAG. Con funzionalità come CRON, Timetables e data-aware scheduling, puoi far partire i DAG quando vuoi.
Per rendere la scrittura dei DAG più accessibile ai professionisti dei dati, la community di Airflow ha introdotto la TaskFlow API. Invece dell’approccio tradizionale basato sugli operator, la TaskFlow API ti permette di definire i task decorando semplicemente delle funzioni. Questo rende molto più semplice e intuitivo condividere dati tra i task e stabilire le dipendenze.
Inoltre, tool come l’Astro SDK sono stati costruiti sopra la TaskFlow API, estendendone ulteriormente le capacità.
Vediamo ora come si confronta Dagster:
Dagster adotta un approccio basato sugli asset unico per costruire pipeline di dati. In Dagster, qualsiasi oggetto dati archiviato in uno storage persistente—come un file o una tabella—è chiamato asset.
Questi asset sono definiti in codice tramite funzioni Python. Quando queste funzioni vengono eseguite, Dagster crea automaticamente le dipendenze e materializza l’asset. Questo metodo incentrato sugli asset rende facile tracciare come i dati vengono prodotti e consumati all’interno di una pipeline.
Un altro concetto chiave in Dagster sono gli “ops”, in parte simili ai task in Airflow. Gli ops rappresentano singoli passaggi in una pipeline di dati e ciascun op ha input e output che possono consistere in asset. Inoltre, questi input e output possono essere tipizzati per definire chiaramente i dati elaborati.
Quindi, qual è la relazione tra ops e asset? Gli ops sono essenzialmente i passaggi (come extract, transform, load) che operano sugli asset, cioè gli oggetti dati stessi.
Per dare chiarezza al flusso di dati in una pipeline, Dagster usa un solido sistema di tipi per validare gli input e gli output di ogni op. Sebbene Airflow supporti le definizioni di tipo di Python, Dagster ha reso la tipizzazione una parte centrale dell’esperienza di authoring delle pipeline.
Non solo puoi tipizzare gli ops, ma anche le definizioni degli asset possono essere tipizzate, assicurando che i dati prodotti da un asset siano corretti e validati.
Quando si sceglie uno strumento di orchestrazione, aspetti come densità di funzionalità, costo totale di proprietà e scalabilità possono far parte dei criteri di valutazione. Detto questo, è importante tenere a mente la developer experience. Un’esperienza di sviluppo intuitiva, efficiente e robusta consente iterazioni rapide e affronta in modo proattivo sfide come l’esecuzione di unit test e la gestione delle dipendenze.
Hai una domanda o un bug su Airflow che proprio non riesci a risolvere? Con ogni probabilità, è già stato affrontato. Airflow ha una delle community Slack più grandi tra i progetti Apache e vanta una community di oltre tremila contributori. Migliaia di blog, tutorial e corsi sono stati sviluppati attorno al progetto Airflow. Oltre a supportare gli utenti, la community si occupa di costruire e mantenere il progetto stesso.
Astronomer, lo sviluppatore commerciale dietro al progetto Apache Airflow, ha portato la developer experience di Airflow al livello successivo. La CLI astro fornisce un ulteriore livello di astrazione e funzionalità per le utility di Airflow. Astronomer offre anche il proprio registry e il chatbot “Ask Astro” per affrontare qualsiasi domanda su Airflow che uno sviluppatore possa avere.
Una caratteristica che rende Airflow così attraente per l’orchestrazione è la possibilità di sviluppare e testare in locale. Usando la CLI airflow, uno sviluppatore può avviare un’istanza di Airflow in pochi secondi. Poi, si possono apportare modifiche al codice in locale, prima di testare via UI o CLI. Questo consente iterazioni rapide e un ciclo di rilascio più breve, soprattutto per i team che usano molto Airflow.
Per un po’, l’unico modo per definire un DAG in Airflow era tramite gli operator tradizionali. La TaskFlow API ha cambiato rapidamente le cose, offrendo un’alternativa per la creazione dei DAG. Oggi, tool come dag-factory e gusty rendono più semplice che mai iniziare a scrivere ed eseguire DAG.
Gran parte dell’esperienza di sviluppo locale di Dagster ricalca quella di Airflow, inclusa la possibilità di sviluppare, testare ed eseguire pipeline in locale. Entrambi supportano pratiche SDLC di livello enterprise comuni, come la CI/CD.
Tuttavia, è difficile paragonare la pura grandezza della community di Airflow a quella di Dagster. Dove Airflow dispone di migliaia di risorse sviluppate dalla community, Dagster sta ancora cercando di colmare il divario. Durante lo sviluppo e il troubleshooting di pipeline con Dagster, i professionisti potrebbero faticare a trovare facilmente le risorse necessarie per implementare una soluzione.
L’approccio basato sugli asset di Dagster alla costruzione delle pipeline le rende piuttosto facili da testare. Anzi, il testing è uno dei pilastri della value proposition di Dagster. Insieme al sistema di tipi citato sopra, Dagster ha dato priorità a garantire che le pipeline di dati siano testate in modo simile a un prodotto software.
La documentazione di Dagster sottolinea la sfida della logica di business aggrovigliata in qualsiasi definizione di pipeline e le tecniche comuni per gestirla durante i test. Questo è un ambito in cui molti ritengono che l’esperienza di sviluppo con Airflow sia carente.
Stai iniziando a farti un’idea di cosa significhi usare Airflow e Dagster? Ora analizzeremo dove ciascuno strumento spicca sull’altro, oltre a una manciata di note criticità note.
Sembra un cliché, ma con Airflow il cielo è il limite. L’estendibilità del progetto è senza eguali. Gli sviluppatori possono costruire propri operator, sensori, executor e persino timetable. Per i team dati con casi d’uso unici, questo è molto allettante. Non vuoi creare integrazioni personalizzate?
Non preoccuparti, con ogni probabilità non dovrai. Ci sono oltre 1.600 integrazioni pronte all’uso dopo una semplice installazione con pip. Essere lo standard di settore per l’orchestrazione dei dati significa che Airflow beneficia di innovazione continua, creando una sorta di “ciclo di feedback positivo”.
Un prodotto davvero open source, esistono moltissimi modi per eseguire Airflow in produzione. Da cluster Kubernetes on-prem a servizi completamente gestiti, migliaia di aziende eseguono Airflow in ambienti di produzione.
Regolamenti governativi e di rendicontazione, impegni per privacy e sicurezza dei dati e una giungla di networking costringono i team dati a configurare gli strumenti in modi talvolta impensabili. Per team di questo tipo, serve tutta la flessibilità e personalizzazione possibile nell’esecuzione di un tool come Airflow in produzione. Altri team possono volere un servizio gestito che si occupi del lavoro pesante. Con Airflow, entrambi questi estremi (e ogni opzione intermedia) sono fattibili.
Airflow è estensibile e vanta migliaia di plugin. I DAG possono essere definiti con diverse tecniche, le pipeline attivate con data-aware scheduling e si può configurare un backend personalizzato per i secret.
Tutto ciò significa che sfruttare Airflow al massimo comporta una certa curva di apprendimento.
Per i Data Engineer che vogliono definire ed eseguire rapidamente pipeline di dati, Airflow presenta una barriera d’ingresso. Spesso, questo spinge i Data Engineer verso un’offerta più lineare, come Dagster.
Costruire pipeline di dati con Dagster è intuitivo. L’approccio basato sugli asset è attraente per i professionisti interessati a portare una pipeline in produzione con il minimo overhead possibile.
Dagster presenta una curva di apprendimento molto inferiore rispetto al lavoro con gli operator tradizionali di Airflow, soprattutto per chi è abituato a scrivere funzioni Python per costruire le proprie pipeline. Questo è uno dei maggiori punti di forza di Dagster e, spesso, una gran parte del motivo per cui un team dati sceglie di affidargli le proprie pipeline.
Competere con la community di Airflow è difficile, anche per Dagster. Dal contribuire al progetto open source al costruire connettori per le ultime novità del data stack, al rispondere alle domande e curare la documentazione, c’è poco che la community di Airflow non offra. Detto questo, la community di Dagster sta crescendo rapidamente. A livello enterprise, questa community nascente è sia un rischio, sia un’opportunità per influenzare il progetto Dagster.
Ora che abbiamo confrontato questi strumenti, qual è quello giusto per te? Nella tabella qui sotto abbiamo raccolto un confronto tra i due:
|
Funzionalità/Aspetto |
Airflow |
Dagster |
|
Concetto di pipeline |
Usa grafi aciclici diretti (DAG) per rappresentare le pipeline, con i task come unità di base. |
Usa un approccio basato sugli asset, dove qualsiasi oggetto dati archiviato è chiamato asset, con operazioni chiamate “ops”. |
|
Rappresentazione dei task |
I task sono definiti usando gli operator o con la TaskFlow API per una definizione basata su funzioni. |
Gli ops rappresentano i passaggi della pipeline, con input e output tipizzati per maggiore chiarezza. |
|
Schedulazione |
Schedulazione altamente flessibile con CRON, timetables e trigger data-aware. |
La schedulazione è meno enfatizzata ma legata agli asset e alle loro dipendenze. |
|
Sviluppo locale |
Supporta lo sviluppo locale tramite la CLI di Airflow per iterazioni e test rapidi. |
Supporta anche sviluppo e test locali, ma con meno risorse della community disponibili. |
|
Sistema di tipi |
Supporta i type hint di Python, ma non è una funzionalità centrale. |
Sistema di tipi forte per validare input e output a ogni passaggio, centrale nel design della pipeline. |
|
Estendibilità |
Altamente estensibile con oltre 1.600 integrazioni, operator, sensori e altro personalizzabili. |
Estendibilità più limitata ma intuitivo per chi usa funzioni Python. |
|
Supporto della community |
Community ampia e matura con migliaia di contributori e risorse estese (es. blog, tutorial). |
Community più piccola ma in rapida crescita, che offre opportunità di influenza e contributo. |
|
Facilità di apprendimento |
Curva di apprendimento più ripida a causa dell’estendibilità e delle funzionalità personalizzate. |
Curva di apprendimento più bassa grazie all’authoring intuitivo e all’approccio basato sugli asset. |
|
Testing |
Il testing è possibile ma non è un focus centrale. |
Forte enfasi sul testing, con un approccio basato sugli asset che rende le pipeline più facili da testare. |
|
Deployment in produzione |
Può essere eseguito in vari ambienti, da Kubernetes on-prem a servizi completamente gestiti. |
Meno maturo in termini di opzioni di produzione ma comunque flessibile per casi d’uso enterprise. |
|
Integrazioni personalizzate |
Estendibilità pressoché infinita con migliaia di integrazioni e possibilità di creare componenti personalizzati. |
Limitate rispetto ad Airflow, ma in crescita con l’espansione della community. |
|
Esperienza sviluppatore |
La TaskFlow API e tool come dag-factory migliorano l’esperienza dello sviluppatore. |
Più intuitivo con enfasi su semplicità e deployment rapido, ma con meno tool disponibili. |
Nel grafico qui sotto sono riassunte le principali somiglianze e differenze nelle funzionalità di Airflow e Dagster.
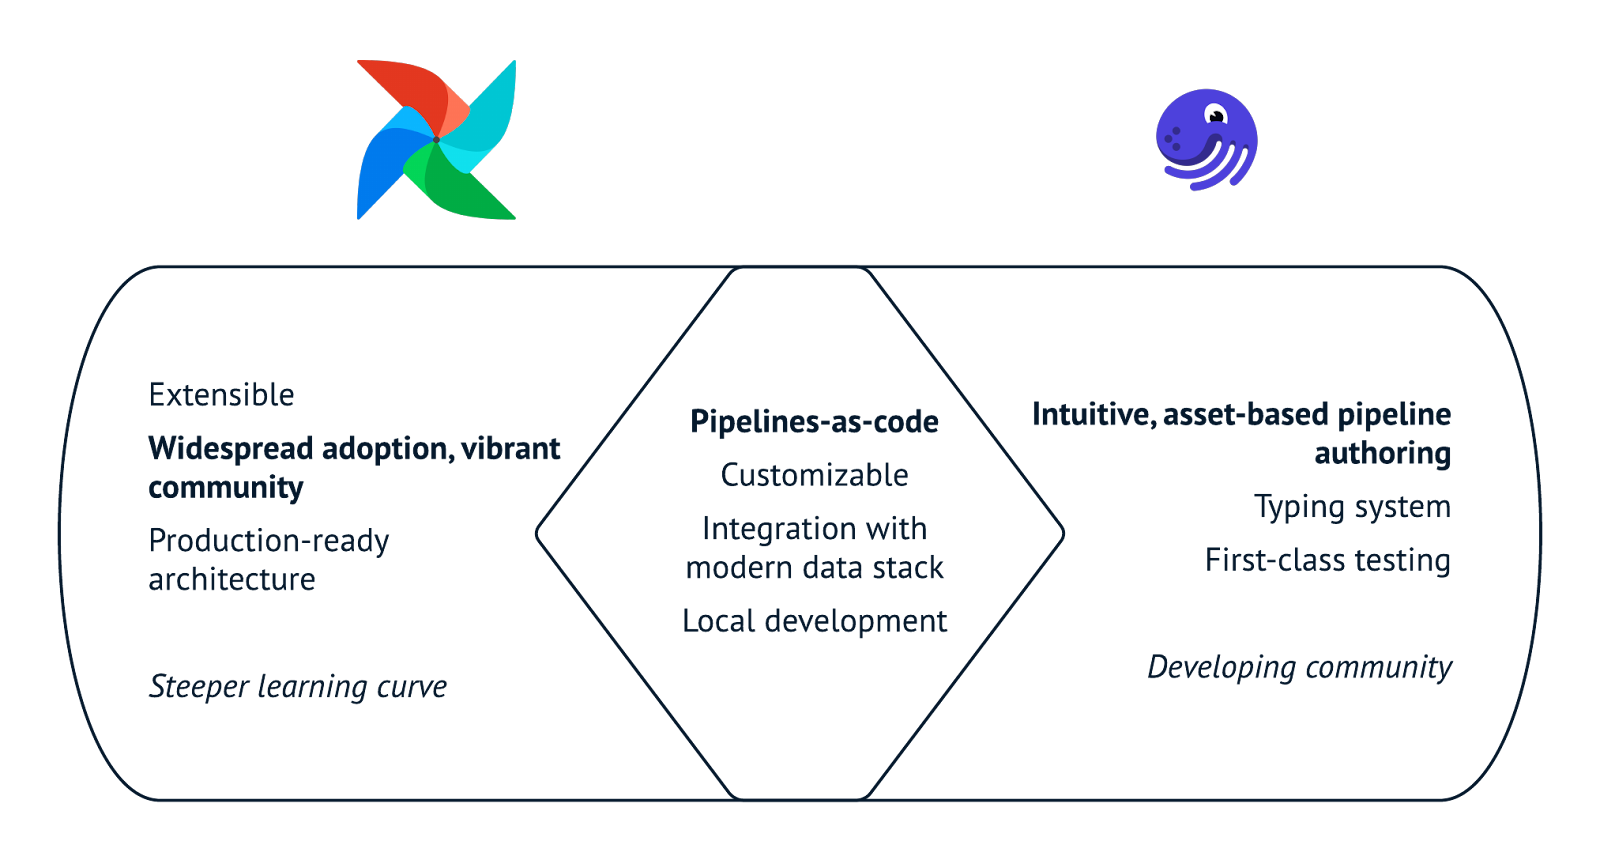
Somiglianze tra Airflow e Dagster.
Ora, la domanda da un milione di dollari: quale strumento di orchestrazione dovresti scegliere per il lavoro?
Semplice: Airflow è lo standard de facto per scrivere ed eseguire pipeline di dati in produzione. Sì, alcuni pattern di progettazione di Dagster possono essere tecnicamente superiori. Ma l’estendibilità di Airflow e la community che lo supporta lo rendono una scelta ovvia per i team dati consolidati. Airflow offre il meglio di entrambi i mondi: un’enorme libreria di tool esistenti più la possibilità di creare qualsiasi operator, sensore o hook tu possa immaginare. Airflow ha trovato la sua nicchia, e non scomparirà tanto presto.
Per piccoli team dati abituati a scrivere pipeline artigianali, Dagster potrebbe essere lo strumento giusto. Pur non vantando tutti i “fronzoli” supportati da Airflow, offre un percorso rapido dall’idea alla produzione. Dagster fornisce un supporto eccellente per ciò che conta (pensa a sviluppo locale, unit test robusti e un framework modulare), insieme a una pletora di integrazioni. Con la maturazione del progetto e la crescita della community, Dagster continua a colmare il gap di funzionalità con Airflow mantenendo una bassa barriera d’ingresso.
Confrontare tool è sempre impegnativo. È difficile dire che uno sia “migliore” di un altro, o forzare un determinato strumento in un certo ambito d’uso. A dirla tutta, l’architettura di base di Airflow e Dagster è sorprendentemente simile. I professionisti migliori non scelgono in base alle feature. Piuttosto, si concentrano su come lo strumento che integrano nel loro ecosistema impatta il processo.
Airflow consente ai miei team di iterare più rapidamente? Uno strumento come Dagster aiuterà gli ingegneri a testare meglio il codice prima di mandarlo in produzione? Questo strumento di orchestrazione si inserisce nella visione più ampia della piattaforma dati? Domande come queste aiutano a creare valore per i team dati e gli stakeholder che servono.
Se sei pronto per iniziare con Apache Airflow, dai un’occhiata al corso Introduction to Airflow in Python di DataCamp. Imparerai le basi dell’uso dei task, dei sensori e tutto ciò che serve per costruire i tuoi primi DAG di Airflow.
I migliori corsi DataCamp
Corso
Programma
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min