Curso
Introdução ao Apache Airflow em Python
4 h
65K
Parece que, a cada vez que você rola o feed no LinkedIn, surge uma nova ferramenta em um cenário de dados que já está lotado. À medida que os times de dados seguem adicionando peças ao seu “data stack”, surge a necessidade de gerenciar e conectar essas ferramentas diversas.
Orquestração de dados é o processo de desenvolver, executar e monitorar fluxos que combinam, transformam e organizam dados em todo o ecossistema. Para isso, engenheiros de dados usam ferramentas de orquestração de dados. Aqui, vamos explorar duas das mais populares: Apache Airflow e Dagster. Vamos lá!
O Airflow é o padrão do mercado para criar, executar e monitorar pipelines de dados como código. Ele foi desenvolvido originalmente em 2014 pelo time de Data Engineering do Airbnb. Desde então, o projeto foi adotado pela Apache Software Foundation e se tornou a oferta mais popular sob a licença deles.
Todos os meses, o Airflow é baixado mais de trinta milhões de vezes e conta com uma comunidade vibrante de contribuidores e usuários. No Airflow, os pipelines de dados são chamados de DAGs, ou grafos acíclicos direcionados.
Você pode saber mais sobre o Airflow no nosso tutorial de primeiros passos com Apache Airflow.
Assim como o Airflow, o Dagster é uma ferramenta de orquestração que permite criar pipelines de dados como código. É open source e foi lançado originalmente em 2019. O Dagster usa Python para definir “assets”, que são os blocos de construção de um pipeline de dados.
O Dagster surgiu como concorrente do Airflow em um espaço relativamente pouco competitivo. O projeto é mantido por sua comunidade open source e tem apoio comercial da Dagster Labs.
Então, onde Airflow e Dagster se encaixam em um data stack moderno? Vamos começar com o diagrama de arquitetura abaixo.
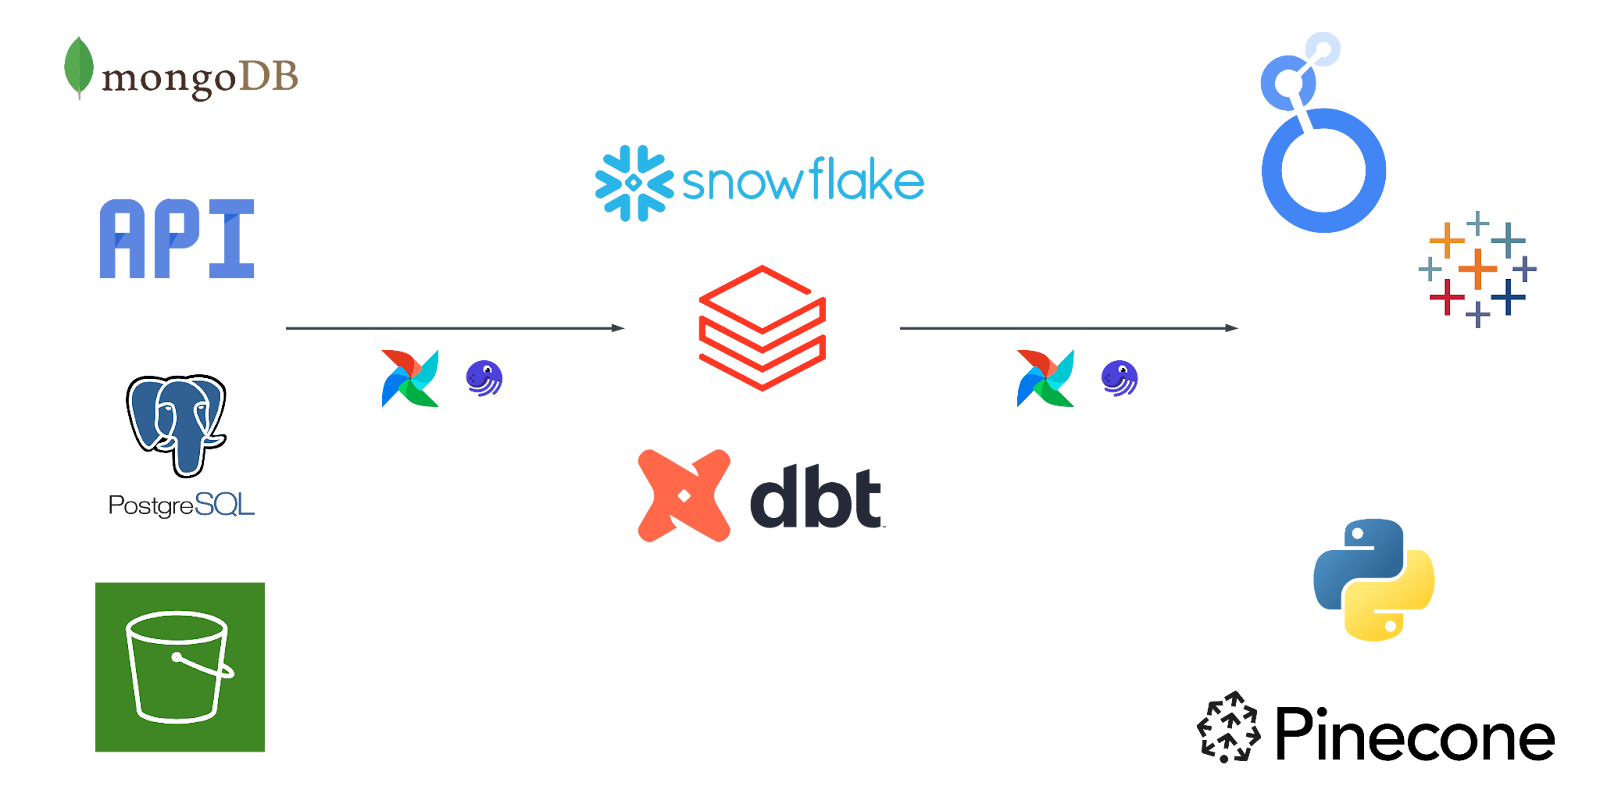
Um diagrama de arquitetura com uma amostra de ferramentas comuns usadas no data stack moderno.
Esse diagrama mostra o que muitos consideram um stack de dados padrão. Ele é composto por sistemas de origem, ferramentas de data warehousing e transformação e “destinos” a jusante como Tableau e Looker.
Aqui, Airflow e Dagster são as setas que conectam esse ecossistema de dados. Sem uma ferramenta de orquestração, é difícil mover dados de uma ferramenta para outra.
Ferramentas de orquestração, como Airflow e Dagster, também fornecem uma camada de observabilidade que facilita entender onde, como e quando os dados fluem da origem ao destino, e como são manipulados ao longo do caminho.
Como você já deve ter imaginado, Airflow e Dagster compartilham várias semelhanças no objetivo de uso e no papel que desempenham no data stack moderno. Entre elas:
Ainda assim, cada um tem um conjunto único de recursos e funcionalidades que o fazem se destacar por conta própria.
Começando por alguns dos principais recursos do Airflow:
No Airflow, pipelines de dados são chamados de DAGs — sigla de directed-acyclic graphs. Pense em um DAG como um conjunto de tarefas conectadas em uma ordem específica. O bloco mais básico de um DAG é a tarefa. Por exemplo, em um pipeline que realiza extração, transformação e carga (ETL), a etapa de “transform” seria uma tarefa própria.
Essas tarefas geralmente são definidas usando operadores do Airflow. Mas, como você vai ver, também há outra forma de defini-las usando a TaskFlow API.
Agendar um pipeline no Airflow é extremamente flexível. Precisa rodar um pipeline diariamente? Sem problema. Quer executá-lo na primeira sexta-feira de todo mês? Também é fácil. E se o seu gestor pedir para disparar um DAG quando um dataset for atualizado? O Airflow também dá conta.
O Airflow oferece muitas opções de personalização para o agendamento dos seus DAGs. Com recursos como CRON, timetables e agendamento sensível a dados, você pode configurar os DAGs para rodar quando precisar.
Para tornar a escrita de DAGs mais acessível a profissionais de dados, a comunidade do Airflow introduziu a TaskFlow API. Em vez de usar apenas operadores, a TaskFlow API permite definir tarefas simplesmente decorando funções. Isso facilita muito o compartilhamento de dados entre tarefas e o estabelecimento de dependências.
Além disso, ferramentas como o Astro SDK foram construídas sobre a TaskFlow API, ampliando ainda mais suas capacidades.
Veja como o Dagster se compara:
O Dagster adota uma abordagem baseada em assets para construir pipelines de dados. No Dagster, qualquer objeto de dados armazenado de forma persistente — como um arquivo ou uma tabela — é chamado de asset.
Esses assets são definidos em código usando funções Python. Quando essas funções são executadas, o Dagster cria automaticamente as dependências e materializa o asset. Esse método centrado no asset torna fácil rastrear como os dados são produzidos e consumidos dentro do pipeline.
Outro conceito importante no Dagster são os “ops”, que lembram as tasks no Airflow. Ops representam etapas individuais de um pipeline de dados, e cada op tem entradas e saídas que podem ser compostas por assets. Além disso, essas entradas e saídas podem ser tipadas para definir com clareza os dados processados.
Qual é a relação entre ops e assets? Ops são essencialmente as etapas (como extrair, transformar, carregar) que operam sobre os assets, que são os próprios objetos de dados.
Para dar clareza ao fluxo de dados no pipeline, o Dagster usa um sistema de tipagem robusto para validar entradas e saídas de cada op. Embora o Airflow suporte type hints em Python, o Dagster tornou a tipagem parte central da experiência de criação de pipelines.
Você pode tipar não só os ops, mas também as definições de assets, garantindo que os dados produzidos por um asset estejam corretos e validados.
Ao escolher uma ferramenta de orquestração, itens como densidade de recursos, custo total de propriedade e escalabilidade costumam entrar nos critérios. Dito isso, é importante ter em mente a experiência do desenvolvedor. Uma experiência intuitiva, eficiente e robusta acelera a iteração e ajuda a antecipar desafios como execução de testes unitários e gestão de dependências.
Tem uma dúvida ou bug no Airflow que você não consegue resolver? A chance é grande de alguém já ter passado por isso. O Airflow tem uma das maiores comunidades no Slack entre os projetos Apache e conta com mais de três mil contribuidores. Milhares de blogs, tutoriais e cursos foram criados ao redor do projeto. Além de apoiar usuários, a comunidade é responsável por construir e manter o Airflow.
A Astronomer, desenvolvedora comercial por trás do Apache Airflow, levou a experiência do desenvolvedor a outro nível. A CLI astro adiciona uma camada extra de abstração e funcionalidades às utilidades do Airflow. A Astronomer também oferece seu registry e o chatbot “Ask Astro” para responder a qualquer dúvida que um desenvolvedor possa ter sobre Airflow.
Um recurso que torna o Airflow tão atraente é a capacidade de desenvolver e testar localmente. Usando a CLI airflow, um desenvolvedor consegue subir uma instância do Airflow em questão de segundos. Depois, dá para ajustar o código localmente e testar pela UI ou pela CLI. Isso permite iterar rápido e encurtar o ciclo de release, especialmente em times que usam Airflow intensamente.
Por muito tempo, a única forma de definir um DAG no Airflow era usando operadores tradicionais. A TaskFlow API mudou esse jogo e trouxe uma alternativa. Hoje, ferramentas como dag-factory e gusty tornam mais fácil do que nunca começar a escrever e executar DAGs.
Grande parte da experiência de desenvolvimento local do Dagster é semelhante à do Airflow, incluindo a possibilidade de desenvolver, testar e executar pipelines localmente. Ambos oferecem suporte a práticas de SDLC em nível corporativo, como CI/CD.
No entanto, é difícil comparar a magnitude da comunidade do Airflow com a do Dagster. Enquanto o Airflow tem milhares de recursos criados pela comunidade, o Dagster ainda está correndo atrás. Ao desenvolver e solucionar problemas de pipelines com o Dagster, profissionais podem ter mais dificuldade para encontrar rapidamente os recursos necessários para implementar uma solução.
A abordagem baseada em assets do Dagster torna os pipelines bem fáceis de testar. Na verdade, testes são um dos pilares da proposta de valor do Dagster. Junto com o sistema de tipos citado acima, o Dagster prioriza garantir que pipelines de dados sejam testados de forma semelhante a um produto de software.
A documentação do Dagster enfatiza o desafio da lógica de negócio muito acoplada em qualquer definição de pipeline e técnicas comuns para lidar com isso em testes. Esse é um ponto em que muitos sentem que a experiência de desenvolvimento no Airflow deixa a desejar.
Deu para ter uma noção de como é usar Airflow e Dagster? Agora, vamos detalhar onde cada ferramenta se destaca em relação à outra e algumas limitações conhecidas.
Clichê, mas com o Airflow, o céu é o limite. A extensibilidade do projeto é incomparável. Desenvolvedores podem criar seus próprios operators, sensors, executors e até timetables. Para times com casos de uso únicos, isso é muito atraente. Não quer desenvolver integrações próprias?
Fique tranquilo, é bem provável que não precise. Existem mais de 1.600 integrações prontas para uso após um simples pip install. Por ser o padrão do setor em orquestração de dados, o Airflow se beneficia de inovação contínua, criando um verdadeiro “ciclo virtuoso”.
Um produto realmente open source, há inúmeras formas de rodar o Airflow em produção. De clusters Kubernetes on-premises a serviços totalmente gerenciados, milhares de empresas executam o Airflow em ambientes produtivos.
Regulações governamentais e de reporte, compromissos com privacidade e segurança e um emaranhado de redes forçam times de dados a configurar ferramentas de maneiras, por vezes, inimagináveis. Para esses times, é essencial ter toda a flexibilidade e capacidade de customização ao rodar o Airflow em produção. Outros já preferem um serviço gerenciado que faça o trabalho pesado. Com o Airflow, ambos os extremos (e tudo entre eles) são viáveis.
O Airflow é extensível e tem milhares de plugins. DAGs podem ser definidos com várias técnicas, pipelines podem ser disparados com agendamento sensível a dados e é possível configurar um backend de segredos customizado.
Tudo isso significa que aproveitar o Airflow ao máximo traz uma certa curva de aprendizado.
Para engenheiros de dados que querem criar e executar pipelines rapidamente, o Airflow impõe uma barreira de entrada. Muitas vezes, isso acaba direcionando esses profissionais para uma solução mais direta, como o Dagster.
Construir pipelines de dados com o Dagster é intuitivo. A abordagem baseada em assets é atraente para quem quer colocar um pipeline em produção com o mínimo de overhead possível.
O Dagster impõe uma curva de aprendizado muito menor do que trabalhar com operadores tradicionais do Airflow, especialmente para usuários acostumados a escrever funções Python para construir pipelines. Esse é um dos maiores pontos fortes do Dagster e, muitas vezes, um fator decisivo para um time de dados optar por ele para alimentar seus pipelines.
Concorrer com a comunidade do Airflow é difícil, até para o Dagster. De contribuições ao projeto open source à criação de conectores para as novidades do data stack, passando por tirar dúvidas e curar documentação, quase não há nada que a comunidade do Airflow não ofereça. Dito isso, a comunidade do Dagster está crescendo — e rápido. Em nível corporativo, essa comunidade em formação representa tanto um risco quanto uma oportunidade de influenciar o projeto.
Então, depois de comparar as duas ferramentas, qual é a certa para você? Na tabela abaixo, reunimos uma comparação entre elas:
|
Recurso/aspecto |
Airflow |
Dagster |
|
Conceito de pipeline |
Usa grafos acíclicos direcionados (DAGs) para representar pipelines, com tarefas como unidades básicas. |
Usa uma abordagem baseada em assets, em que qualquer objeto de dados armazenado é um asset, e as operações são chamadas de “ops”. |
|
Representação de tarefas |
As tarefas são definidas usando operadores ou, com a TaskFlow API, por funções decoradas. |
Ops representam as etapas do pipeline, com entradas e saídas tipadas para maior clareza. |
|
Agendamento |
Agendamento altamente flexível com CRON, timetables e gatilhos sensíveis a dados. |
O agendamento é menos enfatizado e está atrelado aos assets e suas dependências. |
|
Desenvolvimento local |
Suporta desenvolvimento local via Airflow CLI para iteração e testes rápidos. |
Também suporta desenvolvimento e testes locais, mas com menos recursos comunitários disponíveis. |
|
Sistema de tipos |
Suporta type hints em Python, mas não é um recurso central. |
Sistema de tipagem forte para validar entradas e saídas em cada etapa, central no design do pipeline. |
|
Extensibilidade |
Altamente extensível, com 1.600+ integrações, operators, sensors e mais, todos customizáveis. |
Extensibilidade mais limitada, porém intuitivo para quem usa funções Python. |
|
Suporte da comunidade |
Comunidade grande e madura, com milhares de contribuidores e muitos recursos (blogs, tutoriais). |
Comunidade menor, mas crescendo rapidamente, abrindo espaço para influência e contribuição. |
|
Facilidade de aprendizado |
Curva de aprendizado mais íngreme devido à extensibilidade e recursos customizados. |
Curva de aprendizado menor graças à criação intuitiva e à abordagem baseada em assets. |
|
Testes |
Testes são possíveis, mas não são foco central. |
Forte ênfase em testes; a abordagem por assets facilita testar os pipelines. |
|
Implantação em produção |
Pode rodar em vários ambientes, de Kubernetes on-premises a serviços gerenciados. |
Menos maduro em opções de produção, mas ainda flexível para casos corporativos. |
|
Integrações personalizadas |
Extensibilidade praticamente ilimitada, com milhares de integrações e possibilidade de criar componentes customizados. |
Mais limitado que o Airflow, porém evoluindo com o crescimento da comunidade. |
|
Experiência do desenvolvedor |
A TaskFlow API e ferramentas como o dag-factory elevam a experiência do desenvolvedor. |
Mais intuitivo, com foco em simplicidade e agilidade, mas com menos ferramentas disponíveis. |
No gráfico abaixo, você encontra um resumo das principais semelhanças e diferenças de recursos e funcionalidades entre Airflow e Dagster.
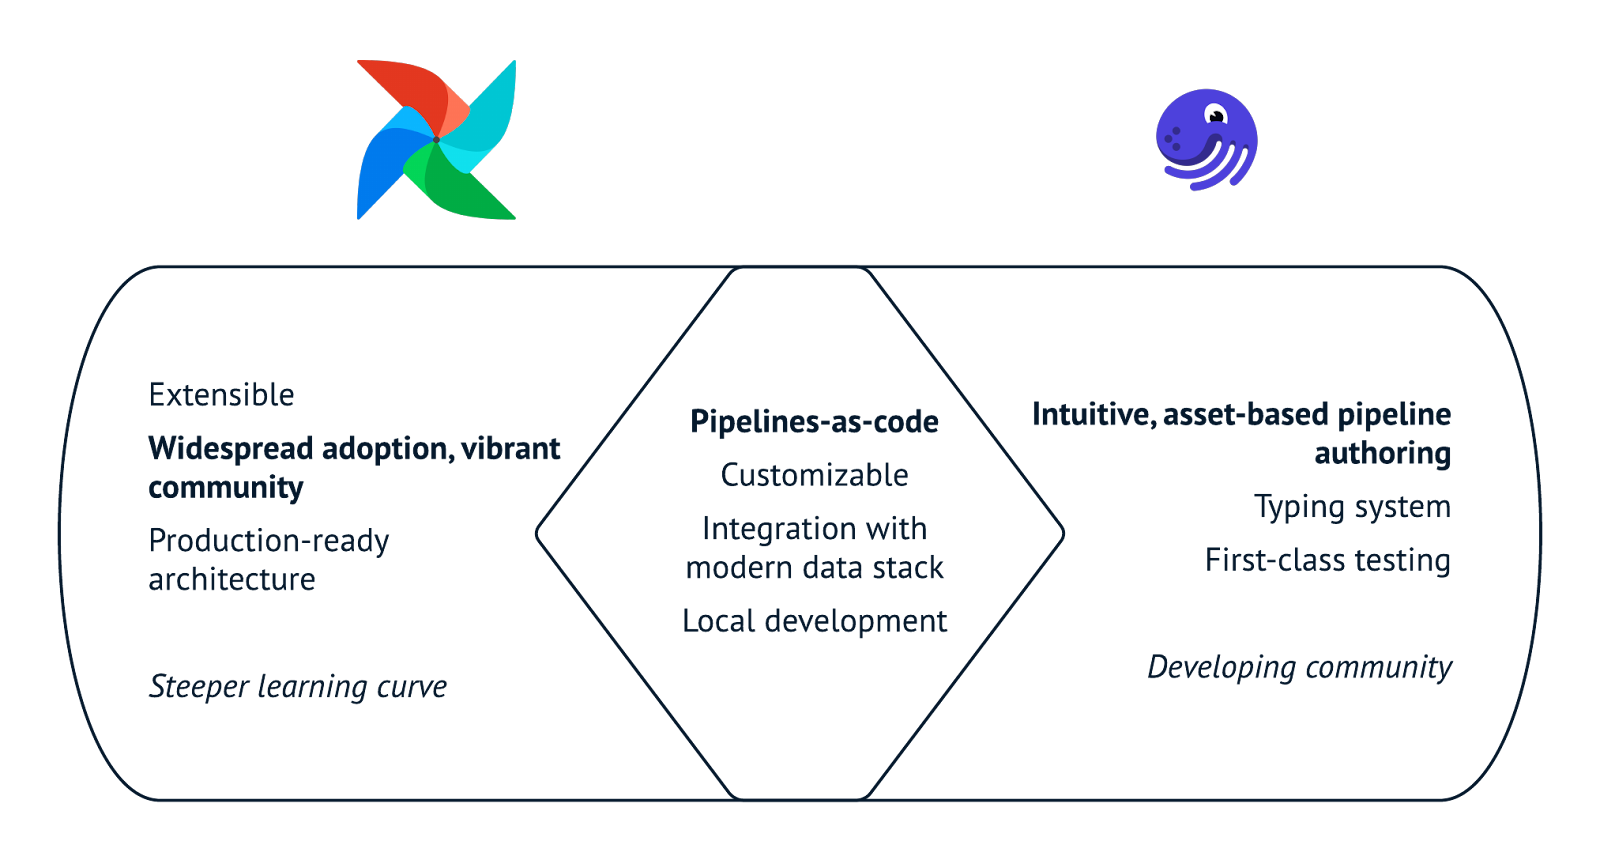
Semelhanças entre Airflow e Dagster.
Agora, a pergunta de um milhão de dólares: qual ferramenta de orquestração você deve escolher para o seu caso?
Simples e direto: o Airflow é o padrão de fato para escrever e executar pipelines de dados em produção. É verdade que há componentes nos padrões do Dagster que podem ser tecnicamente superiores. Mas a extensibilidade do Airflow e a comunidade que cresceu em torno do projeto fazem dele uma escolha fácil para times de dados estabelecidos. O Airflow oferece o melhor dos dois mundos: uma biblioteca massiva de ferramentas existentes mais a capacidade de criar qualquer operator, sensor ou hook que você imaginar. O Airflow encontrou seu espaço — e não vai a lugar nenhum tão cedo.
Para times de dados pequenos, acostumados a escrever pipelines caseiros, o Dagster pode ser a ferramenta certa. Embora não tenha todos os “apetrechos” que o Airflow suporta, ele oferece um caminho rápido da ideia à produção. O Dagster dá suporte de primeira ao que importa (pense em desenvolvimento local, testes unitários robustos e um framework modular), além de uma boa quantidade de integrações. À medida que o projeto amadurece e a comunidade cresce, o Dagster segue reduzindo a distância de recursos em relação ao Airflow, mantendo uma baixa barreira de entrada.
Comparar ferramentas nunca é simples. É difícil dizer que uma é “melhor” que a outra, ou forçar uma ferramenta a um uso específico. A verdade é que a base conceitual por trás de Airflow e Dagster é surpreendentemente semelhante. Os melhores profissionais não escolhem por lista de features; eles avaliam como a ferramenta, ao ser integrada ao ecossistema, impacta o processo.
O Airflow permite que meus times iterem mais rápido? Uma ferramenta como o Dagster ajuda os engenheiros a testar melhor o código antes de ir para produção? Essa ferramenta de orquestração se encaixa na visão maior da plataforma de dados? Perguntas assim ajudam a gerar valor para os times de dados e para as áreas que eles atendem.
Se você está pronto para começar com o Apache Airflow, confira o curso Introduction to Airflow in Python da DataCamp. Nele, você vai aprender o básico de tasks, sensors e tudo o que precisa para construir seus primeiros DAGs no Airflow.
Principais cursos da DataCamp
Curso
Programa
Programa
blog
Abid Ali Awan
9 min
blog
Tim Lu
11 min
blog
DataCamp Team
12 min
blog
Javier Canales Luna
13 min
blog
Javier Canales Luna
12 min
blog
Austin Chia
9 min