Cours
Introduction à Apache Airflow en Python
4 h
65.4K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleÀ chaque scroll sur LinkedIn, on dirait qu’un nouvel outil apparaît dans un paysage de la donnée déjà bien encombré. À mesure que les équipes data empilent les briques de leur « data stack », elles ont besoin d’un moyen de piloter et de relier ces outils disparates.
L’orchestration de données désigne le fait de concevoir, exécuter et superviser des processus qui combinent, transforment et organisent les données à l’échelle de tout l’écosystème. Pour cela, les data engineers s’appuient sur des outils d’orchestration des données. Ici, nous passons en revue deux des solutions les plus populaires : Apache Airflow et Dagster. C’est parti !
Airflow est la référence du marché pour construire, exécuter et superviser des pipelines de données en tant que code. Initialement développé en 2014 par l’équipe Data Engineering d’Airbnb, le projet a depuis été adopté par la fondation Apache Software Foundation et est devenu l’offre la plus populaire sous leur licence.
Chaque mois, Airflow est téléchargé plus de trente millions de fois et bénéficie d’une communauté d’utilisateurs et de contributeurs très active. Dans Airflow, les pipelines de données sont appelés DAGs, pour directed acyclic graphs (graphes acycliques dirigés).
Pour en savoir plus, consultez notre tutoriel bien démarrer avec Apache Airflow.
Comme Airflow, Dagster est un outil d’orchestration qui permet de définir des pipelines de données en tant que code. Open source, il a été lancé en 2019. Dagster utilise Python pour définir des « assets », les briques de base d’un pipeline de données.
Dagster s’est imposé comme un concurrent d’Airflow dans un espace relativement peu encombré. Le projet est maintenu par sa communauté open source et bénéficie d’un soutien commercial de Dagster Labs.
Alors, où Airflow et Dagster s’inscrivent-ils dans une data stack moderne ? Partons du schéma d’architecture ci-dessous.
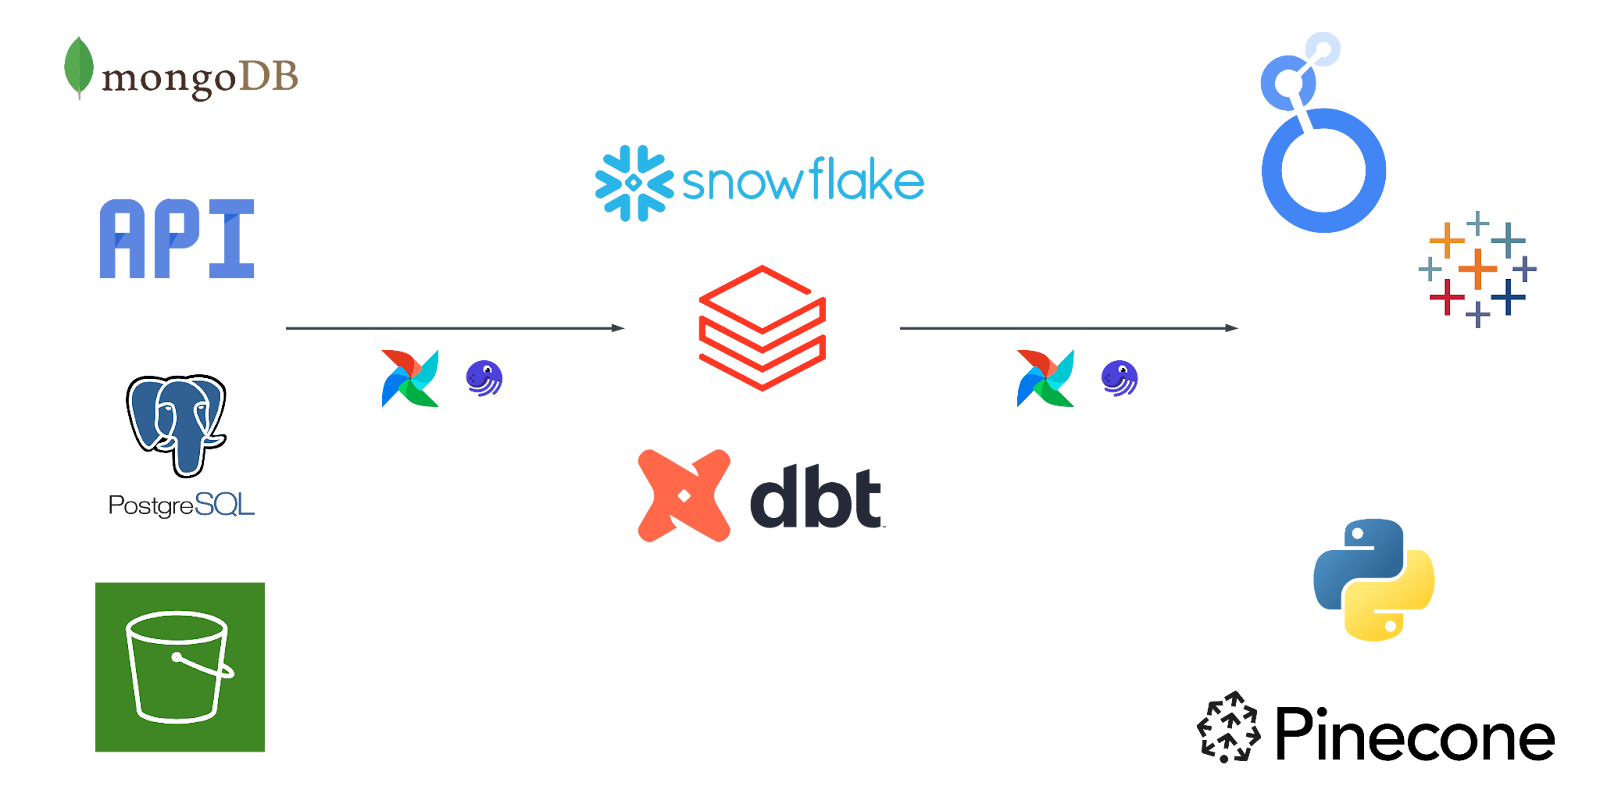
Schéma d’architecture présentant un échantillon d’outils courants dans une data stack moderne.
Ce schéma illustre ce que beaucoup considèrent comme une data stack standard. Elle se compose de systèmes sources, d’outils d’entrepôt et de transformation de données, ainsi que de « destinations » en aval comme Tableau et Looker.
Ici, Airflow et Dagster sont les flèches qui relient cet écosystème de données. Sans outil d’orchestration, il est difficile de faire circuler la donnée d’un outil à l’autre.
Des outils comme Airflow et Dagster ajoutent aussi une couche d’observabilité, pour comprendre facilement où, comment et quand les données sont acheminées de la source à la destination, et comment elles sont transformées au passage.
Vous l’aurez deviné, Airflow et Dagster partagent de nombreux points communs dans leur usage et leur rôle dans une data stack moderne. Parmi lesquels :
Chacun dispose toutefois d’atouts et de fonctionnalités qui lui sont propres.
Commençons par les principales fonctionnalités d’Airflow :
Dans Airflow, les pipelines de données sont appelés DAGs — pour graphes acycliques dirigés. Imaginez un DAG comme un ensemble de tâches reliées dans un ordre précis. Le composant le plus élémentaire d’un DAG est la tâche. Par exemple, dans un pipeline d’extraction, transformation, chargement (ETL), l’étape « transform » est une tâche à part entière.
Ces tâches sont généralement définies via des operators Airflow. Mais, comme vous allez le voir, il existe une autre façon de définir des tâches grâce à la TaskFlow API.
La planification d’un pipeline dans Airflow est d’une flexibilité redoutable. Besoin de l’exécuter chaque jour ? Aucun problème. Le premier vendredi de chaque mois ? Facile aussi. Et si votre manager vous demande de déclencher un DAG à la mise à jour d’un jeu de données ? Airflow sait le faire également.
Airflow offre de nombreuses options de personnalisation pour la planification des DAGs. Avec CRON, les Timetables et le data-aware scheduling, vous pouvez exécuter vos DAGs quand vous en avez besoin.
Pour rendre l’écriture de DAGs plus accessible aux professionnels de la donnée, la communauté Airflow a introduit la TaskFlow API. Plutôt que d’utiliser uniquement des operators, la TaskFlow API permet de définir des tâches en décorant simplement des fonctions. Cela facilite grandement le partage de données entre tâches et la définition des dépendances.
De plus, des outils comme l’Astro SDK se sont bâtis au-dessus de la TaskFlow API, élargissant encore ses possibilités.
Voyons maintenant comment Dagster se positionne :
Dagster adopte une approche fondée sur les assets pour construire des pipelines. Dans Dagster, tout objet de données stocké de manière persistante — fichier, table, etc. — est un asset.
Ces assets sont définis en code via des fonctions Python. Lors de leur exécution, Dagster crée automatiquement les dépendances et matérialise l’asset. Cette approche centrée asset rend le suivi de la production et de la consommation des données au sein d’un pipeline particulièrement simple.
Autre concept clé dans Dagster : les « ops », assez proches des tâches dans Airflow. Les ops représentent des étapes individuelles d’un pipeline, avec des entrées et sorties qui peuvent être des assets. Mieux encore, ces entrées et sorties peuvent être typées pour préciser clairement les données traitées.
Quelle relation entre ops et assets ? Les ops correspondent aux étapes (extract, transform, load) qui opèrent sur les assets, c’est-à-dire les objets de données eux-mêmes.
Pour clarifier les flux de données d’un pipeline, Dagster s’appuie sur un système de typage robuste afin de valider les entrées et sorties de chaque op. Airflow prend en charge les types Python, mais Dagster en a fait un pilier de l’écriture des pipelines.
Vous pouvez typer non seulement les ops, mais aussi les définitions d’assets, afin de garantir que les données produites par un asset sont correctes et validées.
Pour choisir un outil d’orchestration, on évalue souvent la richesse fonctionnelle, le coût total de possession et la scalabilité. Cela dit, il est crucial de considérer l’expérience développeur. Une expérience intuitive, efficace et robuste favorise l’itération rapide et anticipe des enjeux comme les tests unitaires et la gestion des dépendances.
Une question ou un bug Airflow que vous n’arrivez pas à résoudre ? Il y a de fortes chances que la réponse existe déjà. Airflow possède l’une des plus grandes communautés Slack parmi les projets Apache et compte plus de trois mille contributeurs. Des milliers de blogs, tutoriels et cours ont été consacrés à Airflow. En plus d’aider les utilisateurs, la communauté construit et maintient le projet lui-même.
Astronomer, l’éditeur commercial derrière Apache Airflow, a hissé l’expérience développeur à un autre niveau. La CLI astro ajoute une couche d’abstraction et de fonctionnalités aux utilitaires Airflow. Astronomer propose aussi sa registry et le chatbot « Ask Astro » pour répondre à toutes les questions Airflow qu’un développeur pourrait avoir.
L’un des atouts majeurs d’Airflow est la possibilité de développer et tester en local. Avec la CLI airflow, un développeur peut lancer une instance en quelques secondes. Il modifie ensuite le code en local et teste via l’UI ou la CLI. Résultat : une itération rapide et des cycles de livraison raccourcis, notamment pour les équipes très Airflow.
Pendant un temps, la seule manière de définir un DAG Airflow passait par les operators traditionnels. La TaskFlow API a changé la donne en proposant une alternative. Désormais, des outils comme dag-factory et gusty facilitent plus que jamais l’écriture et l’exécution de DAGs.
L’expérience de développement local de Dagster ressemble beaucoup à celle d’Airflow, avec la possibilité de développer, tester et exécuter des pipelines en local. Les deux outils prennent en charge les pratiques SDLC d’entreprise courantes, comme le CI/CD.
Cependant, il est difficile de comparer l’ampleur de la communauté Airflow à celle de Dagster. Là où Airflow dispose de milliers de ressources issues de la communauté, Dagster doit encore combler l’écart. Lors du développement et du dépannage de pipelines avec Dagster, les praticiens peuvent peiner à trouver rapidement les ressources nécessaires pour implémenter une solution.
L’approche basée sur les assets rend les pipelines Dagster très faciles à tester. D’ailleurs, les tests font partie intégrante de la proposition de valeur de Dagster. Avec le système de typage mentionné plus haut, Dagster a fait de la mise à l’épreuve des pipelines une priorité, à la manière d’un produit logiciel.
La documentation de Dagster insiste sur la difficulté de logiques métiers intriquées dans la définition des pipelines et présente des techniques courantes pour les gérer lors des tests. Beaucoup estiment que c’est un point faible de l’expérience développeur côté Airflow.
Vous commencez à percevoir les différences d’usage entre Airflow et Dagster ? Voyons maintenant où chaque outil se démarque, ainsi que quelques limites connues.
Cliché, mais avec Airflow, le ciel est la limite. L’extensibilité du projet est sans égale. Les développeurs peuvent créer leurs propres operators, sensors, executors et même timetables. Pour des équipes data aux cas d’usage spécifiques, c’est très attractif. Vous ne voulez pas développer vos intégrations sur mesure ?
Pas d’inquiétude, vous n’en aurez probablement pas besoin. Plus de 1 600 intégrations existent déjà et sont prêtes à l’emploi après un simple pip install. Être la référence du marché alimente une innovation continue, créant une forme de « cercle vertueux ».
Véritable produit open source, Airflow peut être exécuté en production de multiples manières. De clusters Kubernetes on-premises à des services entièrement managés, des milliers d’entreprises font tourner Airflow en prod.
Entre contraintes réglementaires, exigences de confidentialité et de sécurité, et réseaux complexes, les équipes data doivent parfois configurer leurs outils de manière inattendue. Elles ont alors besoin d’un maximum de flexibilité et de personnalisation pour exécuter Airflow en production. D’autres préféreront un service managé pour s’épargner l’opérationnel. Avec Airflow, ces deux extrêmes (et toutes les options intermédiaires) sont possibles.
Airflow est extensible et propose des milliers de plugins. Les DAGs peuvent être définis de plusieurs façons, les pipelines déclenchés via un scheduling sensible aux données, et un backend de secrets personnalisé peut être configuré.
Tout cela implique qu’exploiter Airflow à plein régime nécessite une vraie courbe d’apprentissage.
Pour des Data Engineers qui veulent définir et exécuter rapidement des pipelines, le seuil d’entrée peut être dissuasif. Beaucoup se tourneront alors vers une solution plus directe, comme Dagster.
Concevoir des pipelines avec Dagster est intuitif. L’approche par assets séduit les praticiens qui veulent passer en production avec un minimum d’infrastructure à gérer.
Dagster impose une courbe d’apprentissage bien moindre que les operators Airflow traditionnels, surtout pour ceux qui ont l’habitude d’écrire des fonctions Python pour leurs pipelines. C’est l’une de ses grandes forces et, souvent, la raison principale qui pousse une équipe data à miser sur Dagster.
Rivaliser avec la communauté Airflow est difficile, même pour Dagster. Contributions open source, connecteurs pour les derniers outils de la stack, entraide et documentation : la communauté Airflow est très complète. Cela dit, la communauté Dagster grandit vite. Au niveau entreprise, cette dynamique représente à la fois un risque et une opportunité d’influencer le projet.
Alors, après cette comparaison, lequel est fait pour vous ? Le tableau ci-dessous récapitule les points clés de chacun :
|
Fonctionnalité / aspect |
Airflow |
Dagster |
|
Concept de pipeline |
Utilise des DAGs (graphes acycliques dirigés) pour représenter les pipelines, les tâches en étant les unités de base. |
Adopte une approche centrée sur les assets : tout objet de données stocké est un asset, les opérations étant appelées « ops ». |
|
Représentation des tâches |
Les tâches sont définies avec des operators, ou via la TaskFlow API pour une définition basée sur des fonctions. |
Les ops représentent les étapes du pipeline, avec des entrées et sorties typées pour plus de clarté. |
|
Planification |
Planification très flexible avec CRON, timetables et déclencheurs sensibles aux données. |
Planification moins mise en avant, mais liée aux assets et à leurs dépendances. |
|
Développement local |
Prise en charge du développement local via la CLI Airflow pour itérer et tester rapidement. |
Prise en charge également du développement et des tests locaux, mais avec moins de ressources communautaires. |
|
Système de typage |
Prend en charge les hints de type Python, sans en faire une fonctionnalité centrale. |
Système de typage fort pour valider entrées et sorties à chaque étape, au cœur de la conception. |
|
Extensibilité |
Très grande extensibilité avec 1 600+ intégrations, des operators, sensors, etc. personnalisables. |
Extensibilité plus limitée mais intuitif pour les utilisateurs de fonctions Python. |
|
Support communautaire |
Grande communauté mature avec des milliers de contributeurs et d’importantes ressources (blogs, tutoriels...). |
Communauté plus petite mais en forte croissance, offrant des opportunités de contribution et d’influence. |
|
Facilité d’apprentissage |
Courbe d’apprentissage plus raide en raison de l’extensibilité et des fonctionnalités sur mesure. |
Courbe d’apprentissage plus douce grâce à une écriture intuitive et à l’approche par assets. |
|
Tests |
Tests possibles mais ce n’est pas un axe central. |
Forte emphase sur les tests, l’approche par assets facilitant la mise à l’épreuve des pipelines. |
|
Déploiement en production |
Peut être exécuté dans divers environnements, de Kubernetes on-prem à des services managés. |
Moins mature côté options de prod, mais tout de même flexible pour des cas d’usage entreprise. |
|
Intégrations sur mesure |
Extensibilité quasi infinie avec des milliers d’intégrations et la possibilité de créer des composants custom. |
Plus limité que Airflow, mais en progression avec l’essor de la communauté. |
|
Expérience développeur |
La TaskFlow API et des outils comme dag-factory améliorent l’expérience développeur. |
Plus intuitif, axé sur la simplicité et le déploiement rapide, mais moins d’outils disponibles. |
Le visuel ci-dessous synthétise les principales similitudes et différences en matière de fonctionnalités entre Airflow et Dagster.
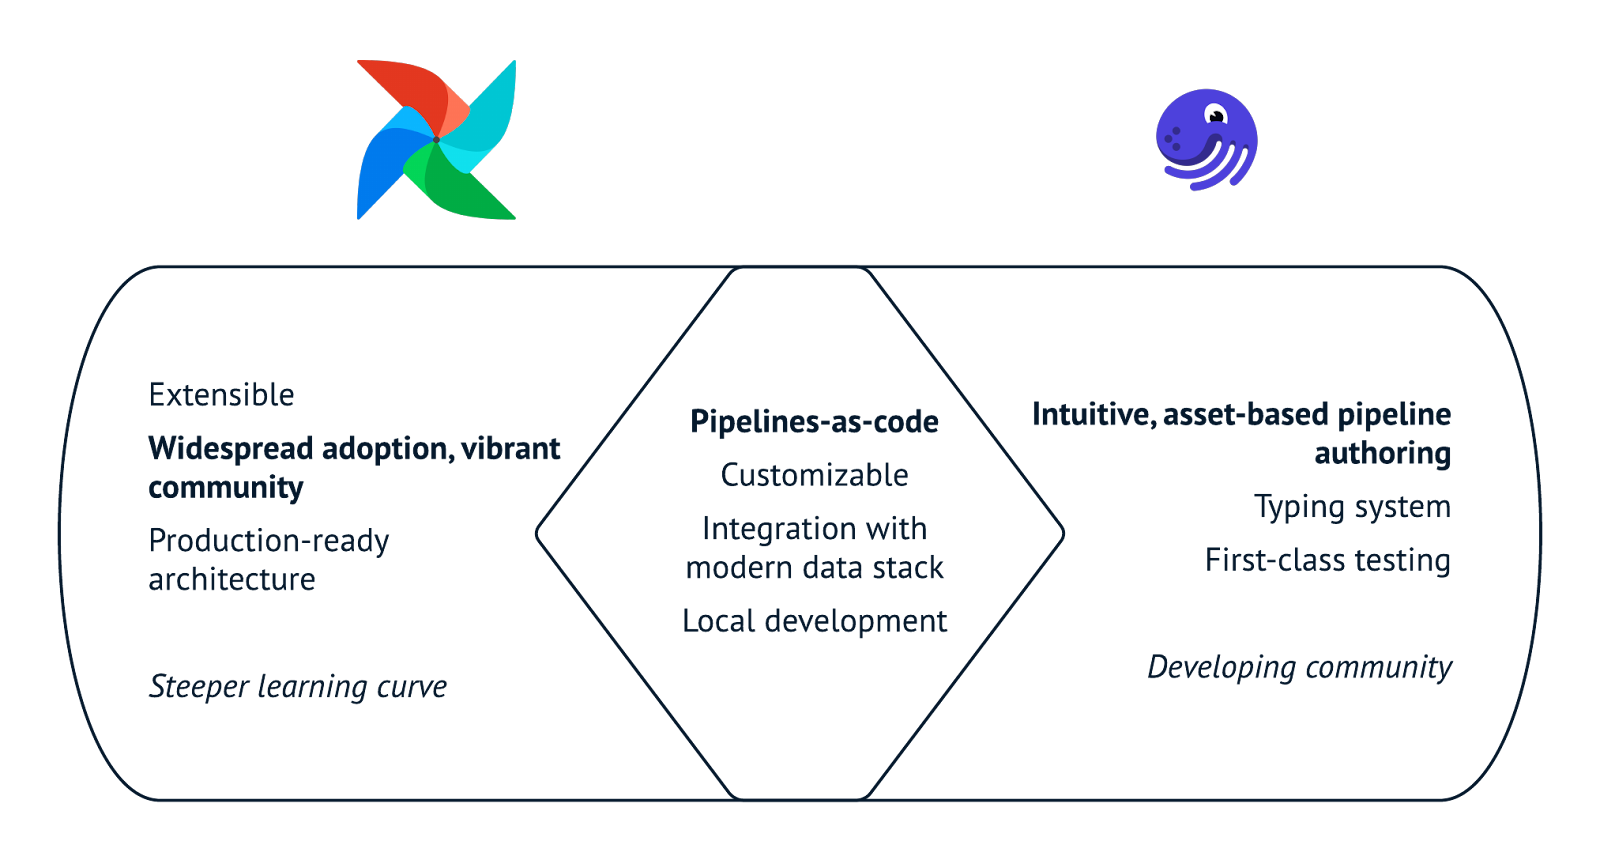
Similitudes entre Airflow et Dagster.
Reste la question à un million : quel outil d’orchestration choisir pour votre contexte ?
Clairement, Airflow est le standard de facto pour écrire et exécuter des pipelines de données en production. Oui, certains aspects de conception de Dagster peuvent être techniquement supérieurs. Mais l’extensibilité d’Airflow et la communauté qui le soutient en font un choix évident pour des équipes data établies. Airflow réunit le meilleur des deux mondes : une immense bibliothèque d’outils existants plus la possibilité de créer n’importe quel operator, sensor ou hook imaginable. Airflow a trouvé sa place — et n’est pas près de la quitter.
Pour de petites équipes habituées à écrire leurs propres pipelines, Dagster peut être l’outil idéal. Même s’il n’a pas toutes les « cloches et sifflets » d’Airflow, il offre un passage rapide de l’idée à la production. Dagster apporte l’essentiel là où ça compte (développement local, tests unitaires robustes, cadre modulaire), ainsi qu’une pléthore d’intégrations. À mesure que le projet mûrit et que la communauté grandit, Dagster réduit l’écart fonctionnel avec Airflow tout en conservant une barrière d’entrée basse.
Comparer des outils n’est jamais simple. Difficile d’affirmer qu’un outil est « meilleur » qu’un autre ou de le forcer dans un cas d’usage particulier. En réalité, les fondations d’Airflow et de Dagster sont étonnamment proches. Les meilleurs praticiens ne se fient pas à la liste de fonctionnalités, mais à l’impact de l’outil sur leurs processus.
Airflow permet-il à vos équipes d’itérer plus vite ? Un outil comme Dagster aide-t-il les ingénieurs à mieux tester leur code avant la mise en production ? Cet outil d’orchestration s’inscrit-il dans la vision globale de votre plateforme data ? Ce sont ces questions qui créent de la valeur pour les équipes et leurs parties prenantes.
Prêt à vous lancer avec Apache Airflow ? Découvrez le cours de DataCamp Introduction to Airflow in Python. Vous y apprendrez les bases des tasks, sensors et tout ce qu’il faut pour construire vos premiers DAGs Airflow.
Les meilleurs cours DataCamp
Cours
Cursus
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
15 min
blog
Nisha Arya Ahmed
15 min
blog
Zoumana Keita
15 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Matt Crabtree
5 min