Programma
Ingegnere dei dati in Python
40 ore
Pratica and corso your progress.
Continua Con GoogleIniziare con il data engineering non è semplice. In aula, e perfino nei corsi online, impari le basi della scrittura in Python e SQL. Potresti persino conoscere un po’ di framework e strumenti come Airflow, Databricks e Snowflake.
Scrivere codice che funziona è una cosa. Scrivere test per quel codice e portarlo in produzione, dove girerà in un contesto enterprise, è un’altra. Per fortuna, l’ingegneria del software ha già risolto il problema, e il data engineering sta recuperando terreno.
Come ci riesce, ti chiederai? Con il CI/CD. Come facciamo a sapere che il codice girerà “allo stato brado”? Come facciamo a sapere che non è rotto? Come spediamo il codice finale in produzione una volta approvato? In questo articolo esploriamo il CI/CD nel data engineering. Abbiamo anche una guida separata sul CI/CD nel machine learning.
CI/CD sta per continuous integration e continuous delivery/deployment. Per ora potrebbe non dirti molto; vediamo meglio di cosa si tratta.
La continuous integration è il processo di unire regolarmente le modifiche al codice in un repository centrale. Per esempio, poniamo che tu abbia modificato con successo una funzione Python nel codebase della pipeline dati del tuo team di ingegneria. La continuous integration prevede che quel codice venga riportato nel repository centrale.
Ma c’è di più. Questo codice dovrebbe essere tracciato con uno strumento di controllo versione (come git) e testato con unit test e integration test ogni volta che viene apportata una nuova modifica. Questo permette due cose: primo, assicurare che le modifiche più recenti al codebase siano disponibili a tutti gli altri utenti; secondo, validare che la modifica al codice funzioni davvero come previsto.
Una volta che hai effettuato il merge del tuo codice nel codebase centrale e l’hai testato, come arriva in produzione? Qui entra in gioco la CD. CD sta per continuous delivery/deployment (useremo continuous delivery) ed è la pratica di distribuire in modo automatico le modifiche apportate al codice.
Alcuni potrebbero sostenere che unit e integration testing facciano parte della continuous deployment, ma in ogni caso, solo il codice validato verrà spedito in produzione
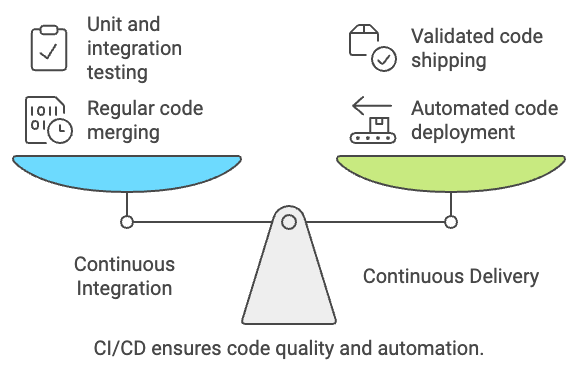
Creato con Napkin.AI
Mettendo tutto insieme, il CI/CD è il processo end-to-end che assicura che il codice funzioni (continuous integration) prima di spedirlo in produzione (continuous delivery) in modo automatizzato. Per implementare il CI/CD, useremo pipeline CI/CD, che vedremo più da vicino tra poco.
Le best practice del data engineering si stanno avvicinando ai punti di riferimento fissati dall’ingegneria del software. Attività come sviluppare ed eseguire unit test e mantenere un ambiente dedicato di testing/QA non sono più prerogativa dei nostri colleghi del software engineering. Questo include il CI/CD.
Non serve cercare a lungo per trovare casi d’uso nello stack di data engineering per il CI/CD. Eccone alcuni tra i più comuni:
Aggiungere il CI/CD al ciclo di sviluppo “data engineering” ha molti vantaggi, tra cui la governance sulla qualità del codice spedito in produzione e la riduzione dello sforzo manuale per rilasciare queste modifiche.
Il CI/CD offre anche un livello di visibilità sui passaggi di ogni rilascio e può limitare l’accesso a determinate azioni a un set specifico di persone.
Per eseguire il CI/CD, ti servirà una pipeline CI/CD. Una pipeline CI/CD è una serie di passaggi eseguiti per testare (CI) e distribuire (CD) il codice in produzione dopo che è stato riportato nel repository centrale. Ecco uno sguardo rapido a come potrebbe apparire una pipeline CI/CD.
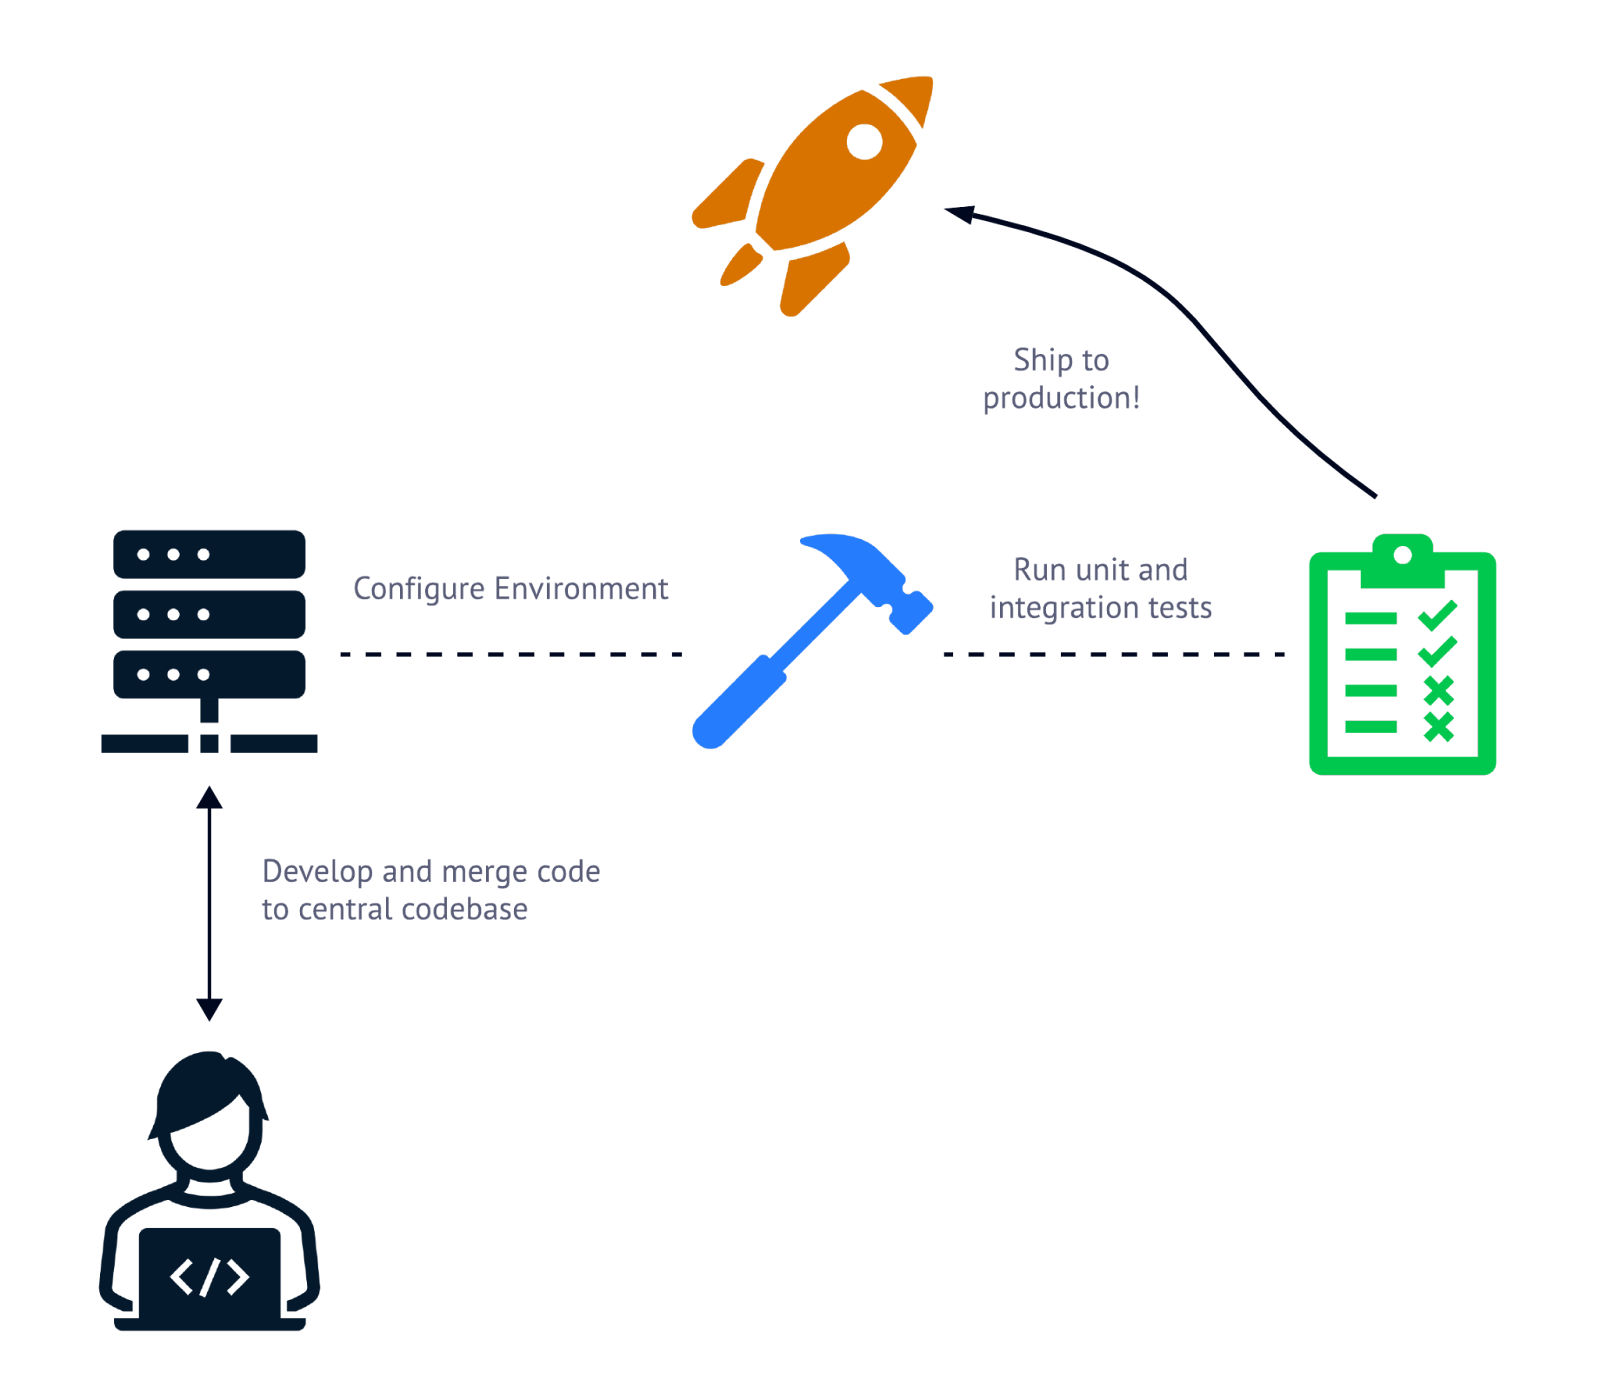
Le pipeline CI/CD in genere sono composte da tre passaggi: configurare l’ambiente di build/distribuzione, eseguire i test e spedire il codice in produzione.
Di solito, in una pipeline CI/CD ci sono tre tipi di operazioni. Per prima cosa, va configurato l’ambiente necessario per testare e distribuire il codice dove gira la pipeline. Questo può includere attività come installare una CLI, recuperare i secret e, soprattutto, scaricare il codebase appena aggiornato.
Dopo aver configurato l’ambiente, il codice da rilasciare deve essere testato. Qui si eseguono unit e integration test contro il codebase appena aggiornato. Dopo aver superato ciascun caso di test, il codice aggiornato può essere distribuito in produzione.
Cerchi uno strumento per eseguire le tue pipeline CI/CD? Per fortuna ce ne sono tantissimi! Dalle soluzioni open source ai servizi completamente gestiti, non manca la scelta per orchestrare i tuoi processi CI/CD. Eccone alcuni tra i più popolari.
Quando pensi al controllo versione, è probabile che ti venga in mente GitHub. GitHub è uno dei luoghi più popolari dove archiviare il codice e, per questo, uno dei più attraenti per gestire le pipeline CI/CD.
GitHub Actions è un’offerta CI/CD completamente gestita che consente agli utenti GitHub di sviluppare, eseguire e gestire le proprie pipeline CI/CD. Le pipeline sono definite tramite file YAML, in genere attivati da un’azione come un push su un certo branch o il merge di una pull request. Usare GitHub Actions permette un’esperienza di sviluppo unificata e una dashboard centrale per controllo versione e gestione dei rilasci.
All’estremo opposto c’è Jenkins. Jenkins è una soluzione CI/CD open source che facilita la creazione e la manutenzione di pipeline personalizzate ed è spesso considerata lo standard di settore per il CI/CD.
Jenkins offre un ulteriore livello di estensibilità, con plugin predefiniti e supporto per un’architettura distribuita. Con Jenkins, se puoi immaginarlo, probabilmente puoi costruirlo. Ma questa personalizzazione porta con sé responsabilità, inclusa una certa dose di gestione della piattaforma Jenkins stessa.
Diversamente da GitHub Actions, Jenkins è un programma che deve essere ospitato e gestito dagli stessi utenti. Per farlo, un team di data engineering deve configurare e gestire elementi come il server Jenkins, i build agent, l’accesso di sicurezza, le integrazioni con un client di controllo versione e un runtime Java. Ciò significa un notevole overhead e potrebbe non avere senso per realtà più piccole.
Per i team di data engineering presenti sul cloud, usare una soluzione CI/CD del proprio provider cloud è spesso molto allettante. AWS offre strumenti come CodeBuild e CodePipeline. Azure supporta DevOps e Pipelines, e GCP mette a disposizione Cloud Build.
Di solito, le applicazioni in un ambiente cloud esistente non devono passare per la procurement e non richiedono spesa impegnata. Questi strumenti sono spesso intuitivi per i data engineer abituati a lavorare nel cloud e sono facili da iniziare a usare.
Quando configuri il tuo workflow CI/CD, ci sono alcune best practice che aiutano a rendere l’esperienza fluida. Per prima cosa, il controllo versione.
Tracciare il tuo codice con il controllo versione è il primo passo per costruire una piattaforma dati robusta. Gli strumenti di controllo versione (come git) non solo permettono di tracciare il codice, ma anche di mantenere una versione di produzione del codice. I client di controllo versione (pensa a GitHub) possono poi essere usati per attivare una pipeline CI/CD al verificarsi di un certo evento.
Ecco un workflow di esempio: sei un data engineer incaricato di creare un nuovo workflow ETL. Per farlo, apri un branch feature e apporti le modifiche su quel branch. Quando sei pronto per portare queste modifiche in produzione, effettuerai il merge del branch feature nel branch main, che attiverà una pipeline CI/CD, distribuendo il tuo codice in produzione.
Non è sempre possibile aggiungere visibilità a una pipeline CI/CD, ma quando lo è, è importante farlo. A seconda dello strumento CI/CD che usi, puoi suddividere ogni passaggio della pipeline in un singolo task. Così, se uno di questi task fallisce, è facile identificarlo e iniziare la remediation. Se usi GitHub Actions per eseguire le tue pipeline CI/CD, prova a separare configurazione dell’ambiente, test e passaggi di deployment in tre task diversi.
Importante quanto la visibilità sull’esecuzione della pipeline è la documentazione. Aggiungere note su come viene attivata una pipeline, quali test vengono eseguiti sul codebase e quale sia il target di deployment aiuta ad avviare il processo di troubleshooting
È probabile che tu debba usare qualche password o chiave per distribuire il tuo codebase una volta testato. È importante non archiviare mai queste informazioni sensibili direttamente nella configurazione della pipeline CI/CD (farlo è un modo sicuro per far impazzire il team di sicurezza). Sfrutta invece le funzionalità del tuo strumento CI/CD per salvare e referenziare questi secret come variabili. Con uno strumento come AWS CodeBuild, i valori sensibili possono essere conservati fuori dalla definizione della pipeline usando variabili d’ambiente e poi referenziati in modo sicuro.
Finora abbiamo parlato solo dell’uso di una pipeline CI/CD per spingere il codice in produzione. Tuttavia, i processi di sviluppo di livello enterprise sono un po’ diversi. Invece di andare direttamente in produzione quando si fa una modifica al codice, i data engineer in genere spingono il codice in un ambiente di test dedicato.
Questo consente loro di testare manualmente la soluzione, assicurandosi che produca i risultati attesi. Per farlo, con il controllo versione si manterranno sia un branch test sia il branch main, ognuno dei quali attiverà un job CI/CD leggermente diverso al verificarsi di determinati eventi.
Sì, il CI/CD può essere complesso. E sì, potrebbe richiedere un po’ di tempo per essere configurato inizialmente. Ma il CI/CD è un investimento per abilitare rilasci di codice governati ed efficienti in un ambiente di produzione. Investire tempo in anticipo per sviluppare una pipeline CI/CD aiuta a ridurre il tempo speso manualmente per testare le modifiche al codice e impacchettarlo per la produzione.
Capire e implementare il CI/CD è uno dei modi più rapidi per far crescere la tua carriera; se sai costruire un progetto in Python o SQL, hai sviluppato competenze fondamentali solide come data engineer. Ma se sai costruire un workflow CI/CD con casi di test che si eseguono a ogni modifica e automatizzare il push in produzione, dimostri di essere pronto a creare soluzioni di livello enterprise.
Inizia oggi il tuo percorso per diventare data engineer con il career track Data Engineer in Python di DataCamp e la certificazione Data Engineer Career.
I migliori corsi DataCamp
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



