강의
Python에서 statsmodels로 살펴보는 회귀 소개
4시간
62.6K
예측 변수가 20개인 회귀 데이터셋을 보고, 어떤 변수를 모델에 넣어야 할지 고민해 본 적이 있으신가요?
전부 넣으면 신호뿐 아니라 잡음까지 함께 적합될 가능성이 큽니다. 수작업으로 고르면, 두 분석가가 같은 데이터를 보고도 서로 다른 모델을 만들 수 있습니다. 게다가 예측 변수가 20개뿐이라 해도 비교 가능한 부분집합은 100만 개가 넘습니다.
단계별 회귀는 p-값이나 AIC 같은 통계적 기준에 따라 예측 변수를 한 번에 하나씩 추가하거나 제거하는 방식으로 이 탐색을 자동화합니다. 널리 가르치고 사용되지만 통계적 한계도 있으므로 기본 특성 선택 방법으로 취급해서는 안 됩니다.
이 글에서는 세 가지 주요 접근법—전진 선택, 후진 제거, 양방향 단계별 선택—을 차례로 살펴보겠습니다.
더 많은 특성 선택 기법을 찾고 계신가요? 초보자도 이해하기 쉬운 소개 글인 Python 특성 선택 튜토리얼을 읽어 보세요.
단계별 회귀는 어떤 예측 변수를 회귀 모델에 포함할지 자동으로 선택하는 절차입니다.
단 하나의 모델을 적합하는 것이 아니라 일련의 후보 모델을 적합하고, 각 단계마다 선택 기준에 따라 예측 변수를 추가하거나 제거합니다. 더 이상 기준이 개선되지 않는 시점에서 탐색이 종료됩니다.
예를 들어 고객의 연간 지출액을 예측한다고 가정해 봅시다. 다섯 가지 후보 예측 변수가 있습니다:
income
age
education
location
years_experience
단계별 회귀는 income으로 시작해, 이어서 age가 모델을 개선하는지, 그다음 education은 어떤지 순차적으로 검사할 수 있습니다. 최종 모델은 다른 세 변수가 기준을 충분히 개선하지 못하면 income과 education만 유지할 수 있습니다.
중요한 점은 단계별 회귀가 별도의 회귀 모델 유형이 아니라는 것입니다.
이는 보통 선형 회귀 같은 익숙한 모델 위에서 실행하는 변수 선택 절차입니다. 출력은 여전히 일반적인 회귀 모델이며, 단계별 절차는 모델에 들어갈 예측 변수를 결정할 뿐입니다.
모든 단계별 절차는 다음과 같은 루프를 거칩니다:
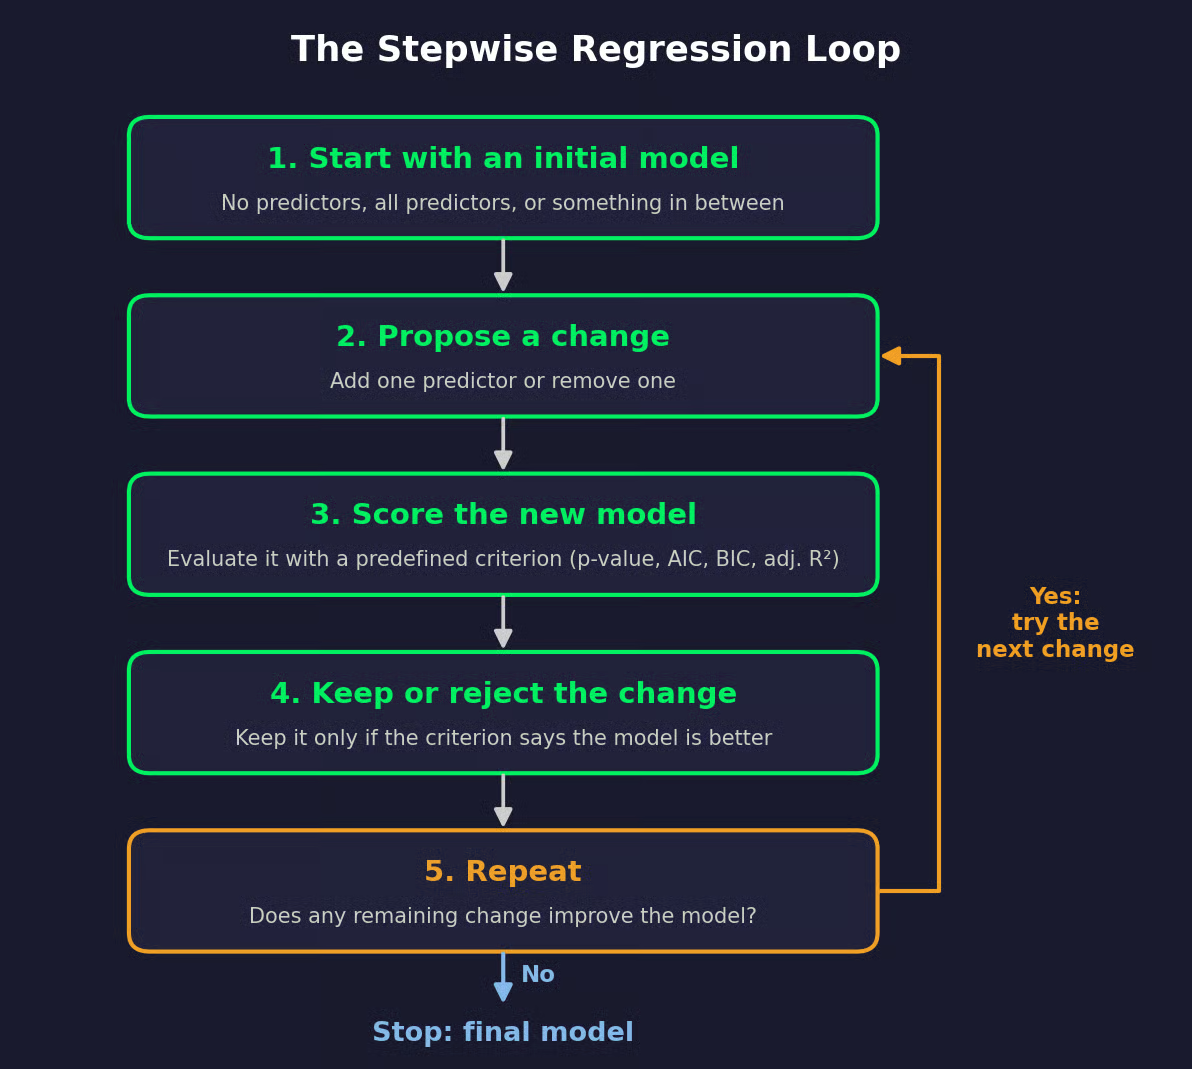
단계별 회귀 루프
알고리즘은 한 단계보다 더 앞을 내다보지 않습니다. 다음의 단일 변경이 도움이 되는지만 판단합니다.
무엇이 “더 낫다”인지의 기준은 선택 기준이 결정합니다. 다음 네 가지가 가장 흔합니다:
정확한 절차는 탐색 방향과 기준에 따라 달라집니다. 전진 선택은 추가만, 후진 제거는 제거만, 양방향 선택은 둘 다 수행합니다. 또한 같은 데이터셋이라도 선택 기준에 따라 최종 모델이 달라질 수 있습니다.
따라서 누군가 단계별 회귀를 돌렸다라고 말하면, 가장 먼저 물어야 할 두 가지는 방향과 기준입니다.
단계별 회귀에는 세 가지가 있으며, 검색 방향에서만 차이가 납니다.
전진 선택은 작은 모델에서 시작해 점차 키워 갑니다.
절편만 있는 모델로 시작하거나, 어떤 경우에도 포함하고 싶은 몇몇 변수를 넣고 시작합니다. 그런 다음 남은 각 예측 변수마다 그 하나를 추가한 후보 모델을 적합합니다. 기준을 가장 크게 개선하는 변수가 모델에 들어옵니다.
그다음 더 큰 모델을 새 기준으로 루프를 반복합니다. 예를 들어 더 이상 AIC가 낮아지지 않을 때, 남은 어떤 변수도 선택 규칙을 충족하지 못하면 멈춥니다.
전진 선택은 전체 모델을 적합할 필요가 없으므로 후보 예측 변수가 관측치보다 많아도 시작할 수 있습니다. 단점은 한 번 들어온 변수는 이후에 중복이 되어도 다시 검토하지 않고 계속 남는다는 점입니다.
후진 제거는 반대 방향으로 진행합니다.
모든 후보 변수를 포함한 전체 모델에서 시작합니다. 알고리즘은 변수를 하나씩 제거해 보며, 제거 시 기준이 가장 개선되는 변수를 떨어내고 더 작은 모델을 다시 적합합니다. 제거해도 개선되지 않으면 탐색을 멈춥니다.
이 접근법은 전체 모델이 추정 가능해야 함을 의미합니다. 매개변수 수보다 관측치가 많아야 하고, 어느 변수도 다른 변수들의 정확한 선형결합이면 안 됩니다. 예측 변수가 50개이고 행이 40개라면, 후진 제거는 시작조차 못 합니다.
또 전진 선택의 반대 문제도 있습니다. 한 번 빠진 변수는 다시 들어오지 않습니다.
양방향 선택은 둘을 결합합니다. 변수를 추가할 때마다, 이미 들어와 있는 변수 중 제거해야 할 것이 있는지도 확인합니다.
이는 예측 변수의 가치가 모델에 무엇이 들어 있느냐에 따라 달라지기 때문입니다. 예를 들어 bedrooms가 주택 규모와 상관되어 먼저 들어왔다고 합시다. 이후 square_feet가 추가되면 bedrooms가 더해주는 정보는 거의 없을 수 있습니다. 양방향 선택은 그 시점에 이를 제거할 수 있지만, 전진 선택은 계속 유지합니다.
대신 단계마다 적합해야 하는 모델 수가 더 많아집니다. 양방향 선택은 빈 모델이나 전체 모델 어느 쪽에서든 시작할 수 있습니다.
세 가지를 비교하면 다음과 같습니다:
| 전진 선택 | 후진 제거 | 양방향 선택 | |
|---|---|---|---|
| 시작 모델 | 절편만 포함 또는 작은 기본 집합 | 모든 후보를 포함한 전체 모델 | 빈 모델 또는 전체 모델 |
| 허용 연산 | 추가만 | 제거만 | 추가 또는 제거 |
| 고려 사항 | 예측 변수가 관측치보다 많아도 시작 가능하나, 초기 추가는 재검토하지 않음 | 추정 가능한 전체 모델이 필요하며, 제거된 변수는 돌아오지 않음 | 단계당 모델 적합이 더 많지만, 이전 결정을 되돌릴 수 있음 |
단계별 회귀 유형
좀 더 구체적으로 살펴보겠습니다.
200채의 주택으로 구성된 합성 데이터를 생성했고, 다섯 개의 후보 예측 변수로 price를 예측하려 합니다:
square_feet
bedrooms
age_years
distance_km (도심까지의 거리)
lot_size_sqft
AIC를 기준으로 하는 전진 선택을 사용하겠습니다. AIC는 낮을수록 좋습니다. 동일 데이터를 Python 섹션에서도 다시 보게 됩니다.
절편만 있는 모델의 AIC는 5057.0입니다. 각 단계는 다음과 같습니다. 각 셀은 해당 변수를 현재 모델에 추가했을 때의 AIC를 나타냅니다:
| Candidate | Step 1 | Step 2 | Step 3 | Step 4 | Step 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| Current model AIC | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
AIC 비교
각 단계에서 일어나는 일은 다음과 같습니다:
1단계: square_feet가 AIC를 약 102점 낮추며 먼저 들어옵니다. bedrooms는 주택 규모와 상관되어 2순위입니다
2단계: distance_km이 가장 큰 감소를 가져옵니다. 이제 bedrooms는 거의 도움이 되지 않습니다. 이미 square_feet가 대부분의 정보를 담고 있기 때문입니다
3단계: age_years가 들어옵니다
4단계: lot_size_sqft가 AIC를 1.6점만 낮추지만, 낮은 쪽이 더 좋으므로 들어옵니다
5단계: bedrooms를 추가하면 AIC가 4840.8로 올라가므로 탐색을 중단합니다
최종 모델은 square_feet, distance_km, age_years, lot_size_sqft를 사용합니다.
합리적인 결과입니다. 데이터는 bedrooms가 가격에 직접적인 영향을 주지 않도록 생성했으며, 절차도 이를 배제했습니다.
같은 데이터에 후진 제거를 적용하면, 4840.8의 전체 모델에서 시작해 bedrooms를 제거하고 동일한 네 변수를 유지한 채 멈춥니다. 전진과 후진이 항상 일치하는 것은 아니지만, 여기서는 같습니다.
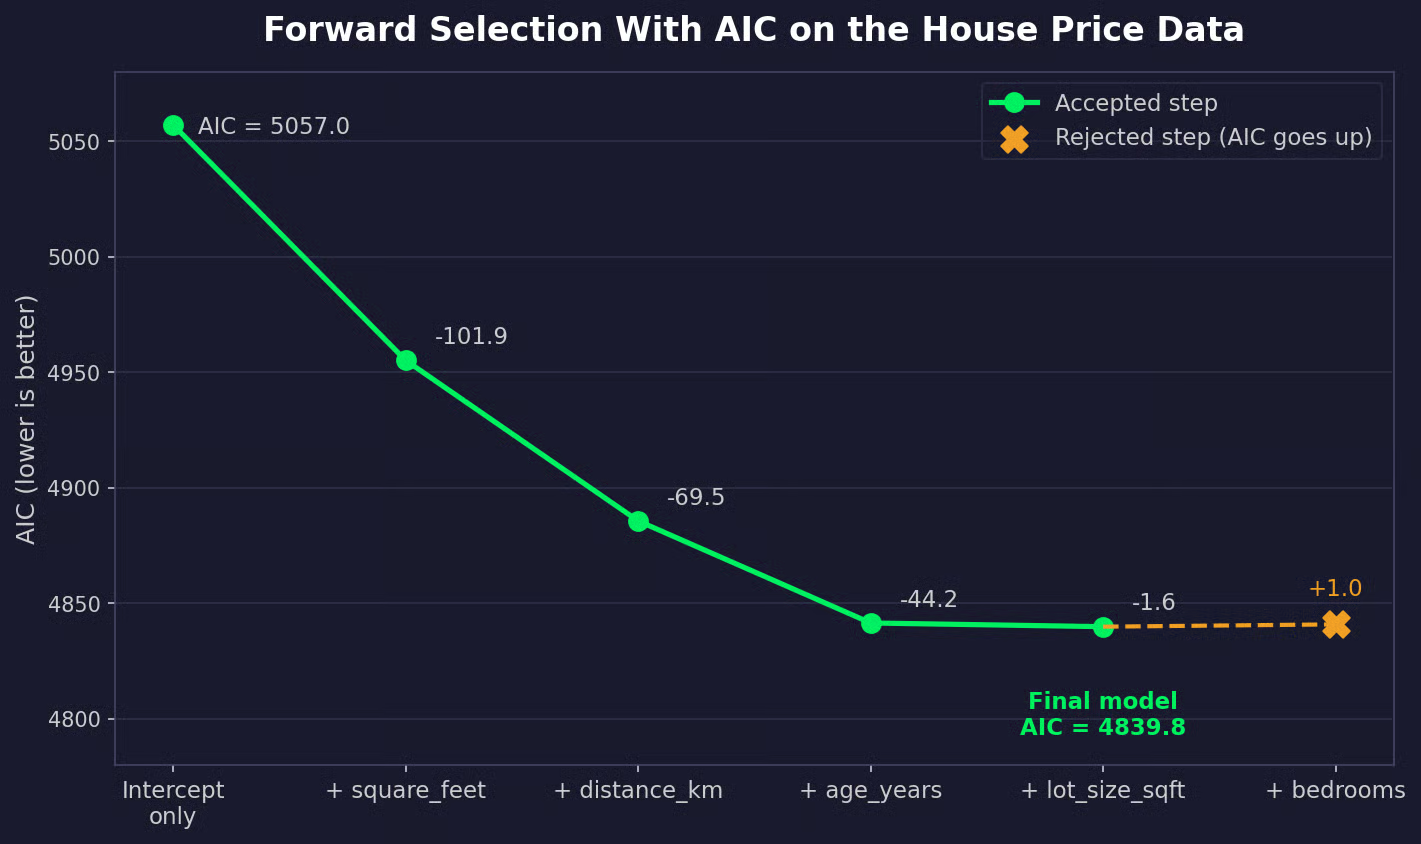
각 전진 선택 단계 후 현재 모델의 AIC
탐색 방향은 알고리즘의 동작 방식을, 기준은 중단 시점을 결정합니다.
가장 오래된 접근법으로, 두 가지 임계값을 사용합니다:
제거 임계값은 보통 진입 임계값보다 높게 설정하여, 매 단계마다 변수가 들어갔다가 바로 나오는 상황을 막습니다. 두 값 모두 규범일 뿐 규칙은 아닙니다.
각 p-값은 사전에 계획한 단일 검정을 가정합니다. 단계별 절차는 매 단계에서 여러 검정을 실행하고 가장 작은 p-값을 유지합니다. 효과가 전혀 없는 예측 변수에 대해 0.05 수준의 독립 검정 20개를 실행하면, 적어도 하나가 유의해 보일 확률은 1 − 0.95^20으로 약 64%입니다. 선택된 변수들은 실제보다 더 강해 보일 것이며, 그 이유는 문제점 섹션에서 다룹니다.
주택 가격 예시에서, 4단계의 lot_size_sqft p-값은 약 0.063입니다. 진입 임계값이 0.05라면, 전진 선택은 세 변수에서 멈춥니다.
Akaike 정보 기준은 적합도와 복잡도의 균형을 맞춥니다:
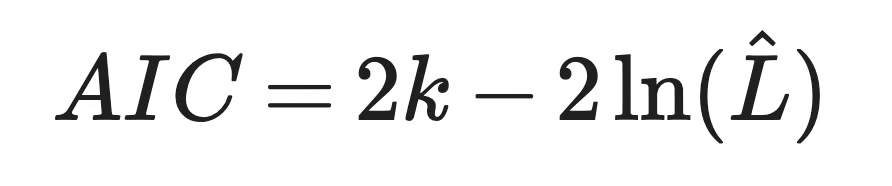
AIC 공식
여기서 k는 추정된 매개변수 개수, L̂는 최대화된 우도입니다. 두 번째 항은 적합을 보상하고, 첫 번째 항은 매개변수마다 2점을 부과합니다.
새 예측 변수를 추가하면 우도는 낮아지지 않으므로 적합 항은 개선될 뿐입니다. 관건은 그 개선 폭이 2점 페널티를 초과하느냐입니다. 단일 매개변수를 추가할 때 이는 p-값 약 0.157의 우도비 검정과 같습니다.
그래서 lot_size_sqft는 AIC에서는 포함되고 0.05 p-값 규칙에서는 제외되었습니다. AIC는 더 관대하며, 예측에 도움이 되는 약한 변수도 유지하는 경향이 있습니다.
베이지안 정보 기준은 구조는 같지만 페널티가 다릅니다:
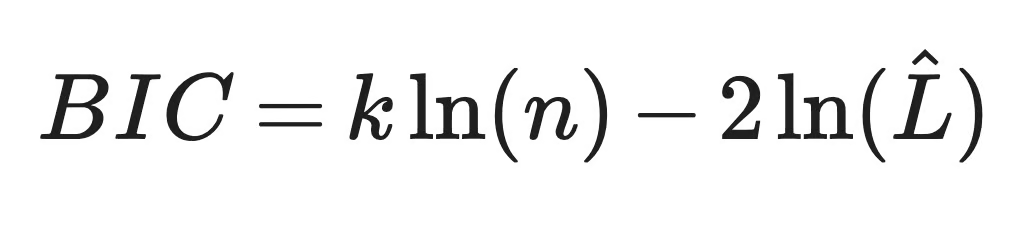
BIC 공식
이 식에서 n은 관측치 수입니다. 매개변수당 페널티가 2 대신 ln(n)이므로, 관측치가 8개 이상이면 BIC가 AIC보다 복잡도를 더 강하게 벌합니다. 표본 크기가 커질수록 격차도 커집니다.
주택 200채에서는 ln(200)이 약 5.3으로, 단일 매개변수 추가에 대한 암묵적 p-값 임계는 약 0.021입니다. 이 데이터에서 BIC 전진 선택은 세 변수에서 멈추며 lot_size_sqft는 제외됩니다.
일반 결정계수는 선택 기준으로 부적절합니다.
선형 회귀 모델에 예측 변수를 추가하면 무작위 잡음 열이라도 값이 결코 감소하지 않습니다. 결정계수로 선택하면 전체 모델이 항상 최선입니다.
수정된 결정계수는 예측 변수 개수에 대한 페널티를 추가합니다:
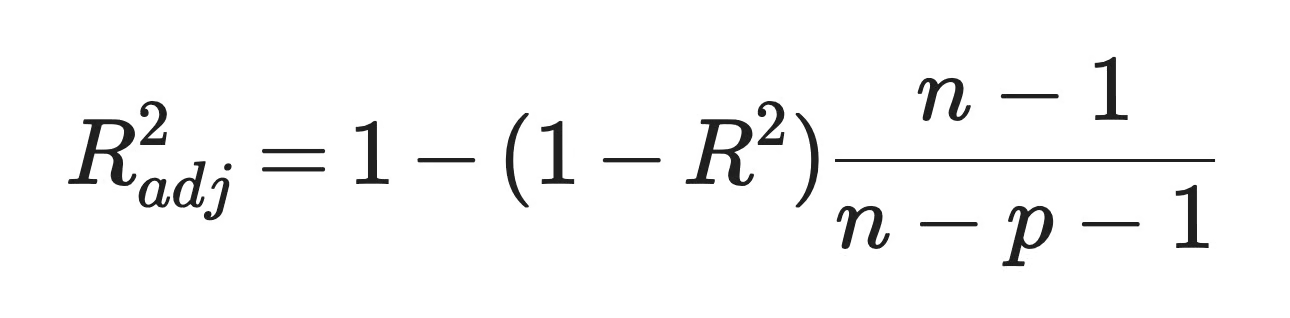
수정된 결정계수 공식
여기서 p는 예측 변수 개수이며, 값이 클수록 좋습니다. 페널티는 약한 편입니다. 새 예측 변수의 t-통계량 절대값이 1을 초과하면 수정된 결정계수가 상승하므로, 네 가지 기준 중 가장 관대합니다.
이 주택 데이터에서 수정된 결정계수는 lot_size_sqft를 유지하고 bedrooms를 소수 다섯째 자리 차이로 제외합니다.
같은 데이터, 같은 전진 탐색이지만 답은 다릅니다:
| 기준 | 최종 모델 |
|---|---|
| P-값 (0.05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| 수정된 결정계수 | square_feet, distance_km, age_years, lot_size_sqft |
기준별 변수 선택 결과
두 언어 모두 단계별 회귀를 수행할 수 있지만 방식이 다릅니다. 위 예시의 주택 가격 데이터를 그대로 사용하겠습니다.
Python에는 표준 단계별 회귀 함수가 없습니다.
statsmodels나 scikit-learn에는 R의 step()처럼 AIC나 p-값으로 예측 변수를 선택하는 함수가 없습니다. 따라서 가장 투명한 방법은 statsmodels 위에 직접 루프를 작성하는 것입니다. 약 25줄 정도이며, 모든 결정을 직접 확인할 수 있습니다.
명확히 하자면, 아래의 forward_selection() 함수는 제 개인용 헬퍼이며 statsmodels의 기능이 아닙니다. statsmodels는 모델을 적합하고 .aic와 .bic 속성을 보고할 뿐입니다.
먼저 데이터를 생성해 저장합니다. R 섹션에서도 같은 행을 사용하기 위함입니다:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
다음은 선택 루프입니다. 절편만 있는 모델에서 시작해, 남은 각 후보마다 하나씩 모델을 적합하고, 기준값이 가장 낮아지는 추가를 유지합니다:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")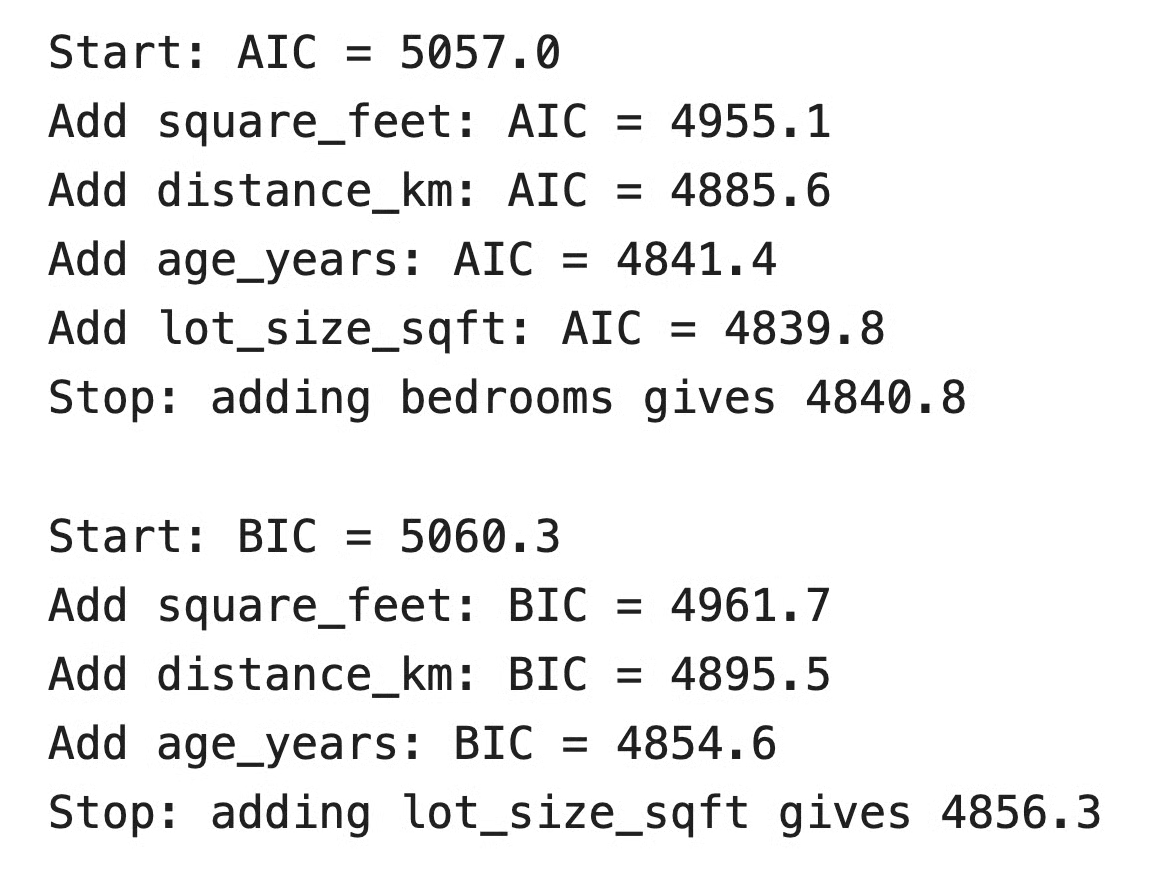
Python에서의 전진 선택
표의 AIC 값과 동일합니다. AIC는 네 변수를 선택하고, BIC는 lot_size_sqft가 더 큰 페널티를 넘지 못해 세 변수에서 멈춥니다.
패키지를 쓰고 싶다면 scikit-learn의 SequentialFeatureSelector가 있습니다. 전진 또는 후진 선택을 수행하지만, AIC나 p-값 대신 교차 검증으로 각 후보를 점수화합니다:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Python에서 선택된 특성
n_features_to_select="auto"를 사용하면, 교차 검증된 결정계수가 tol보다 덜 개선될 때 탐색을 멈춥니다. 이 데이터에서는 AIC와 동일한 네 변수를 선택합니다.
R에는 단계별 회귀가 기본 제공됩니다.
step() 함수는 기본 R의 stats 패키지에 포함되어 있어 설치가 필요 없습니다. 시작 모델, 고려할 최대 모델을 정의하는 scope, 그리고 방향을 지정해 사용합니다:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)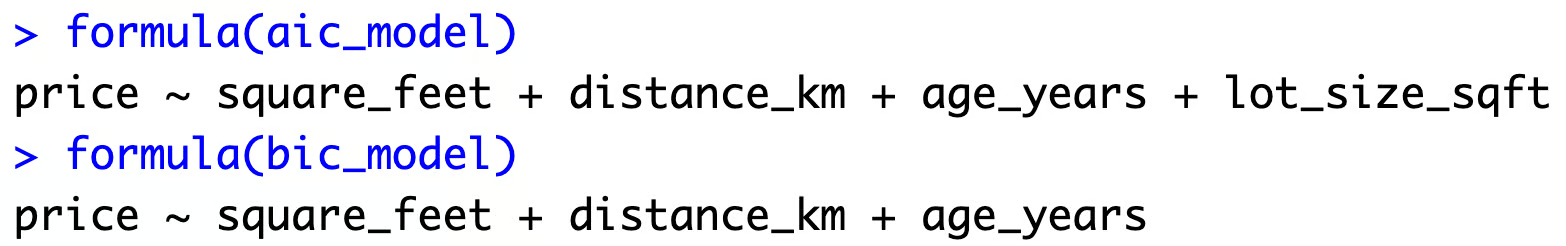
R에서의 AIC와 BIC 공식
step()이 최소화하는 기준은 하나의 인자—k—로 제어됩니다.
-2 log-likelihood + k * edf를 계산하며, edf는 추정된 계수의 개수입니다. 기본값 k = 2는 AIC에 해당합니다. k = log(n)으로 설정하면 BIC가 되지만, 출력 추적에는 여전히 값이 "AIC"로 표시되니 혼동하지 마세요.
후진 제거는 전체 모델에서 시작합니다:
backward_model <- step(full_model, direction = "backward")이 데이터에서는 bedrooms를 제거하고 전진 AIC와 동일한 네 변수에서 멈춥니다. scope를 전달하고 direction을 생략하면, step()은 기본적으로 양방향 선택을 수행합니다.
단계별 회귀만이 예측 변수를 고르는 유일한 방법은 아닙니다. 세 가지 대안과 비교해 보겠습니다.
단계별 회귀는 탐욕적 탐색입니다. 각 단계에서 최선의 단일 움직임을 선택하며(양방향이 아니면) 뒤돌아보지 않습니다.
최적 부분집합 선택은 가능한 모든 예측 변수 조합을 적합하고 기준값이 가장 좋은 조합을 유지합니다. 예측 변수가 5개면 32개 모델이지만, 20개면 100만 개가 넘고 40개면 1조 개를 넘습니다. R의 leaps 패키지의 branch-and-bound 같은 알고리즘이 많은 작업을 건너뛸 수 있지만, 비용은 여전히 변수 수에 따라 빠르게 증가합니다.
이 주택 데이터에서는 AIC 기준의 최적 부분집합 선택이 전진 선택과 동일한 네 변수를 선택했습니다. 항상 그렇지는 않다는 점을 기억하세요.
단계별 회귀는 예/아니오 결정을 내립니다. 예측 변수는 완전한 최소제곱 계수로 모델에 포함되거나, 0으로 제외됩니다.
라쏘 회귀는 모든 예측 변수를 한꺼번에 적합하고, 계수 절댓값의 합에 페널티를 부여합니다. 이 페널티는 모든 계수를 0 쪽으로 수축시키고, 가장 약한 것들을 0까지 밀어 붙여 선택과 추정을 한 번에 수행합니다.
데이터의 작은 변화는 라쏘의 계수를 조금 움직이지만, 단계별에서는 포함/제외 결정이 뒤바뀔 수 있습니다. 페널티 강도는 scikit-learn의 LassoCV나 R의 cv.glmnet() 같은 교차 검증으로 선택합니다.
수축된 계수는 의도적으로 0 방향으로 편향됩니다. 더 안정적인 추정과 더 나은 샘플 외 예측을 위한 교환입니다.
재귀적 특성 제거(RFE)은 후진 제거와 비슷해 보입니다. 모든 특성으로 모델을 적합하고, 가장 약한 것들을 제거하고, 다시 적합하고, 반복합니다.
차이는 “가장 약한”의 정의입니다. 후진 제거는 AIC나 p-값 같은 통계적 기준을 사용합니다. RFE는 계수 크기나 트리 기반 특성 중요도처럼 모델 고유의 중요도를 사용합니다.
즉 RFE는 머신러닝 도구에 가깝습니다. 랜덤 포레스트, 서포트 벡터 머신 등 특성 중요도를 가진 어떤 모델과도 동작하며, 보통 scikit-learn의 RFECV로 교차 검증과 함께 사용합니다. 우도 기반 기준이나 p-값은 제공하지 않지만, 예측 성능이 좋은 특성 집합을 얻을 수 있습니다.
단계별 회귀는 실행과 설명이 쉽습니다. 바로 그 이유로 문제를 놓치기 쉽습니다.
통계학자들은 수십 년간 이 방법을 비판해 왔습니다. Frank Harrell의 Regression Modeling Strategies와 Whittingham 외(2006)의 Journal of Animal Ecology 논문이 잘 알려진 예입니다. 2018년 Journal of Big Data의 Gary Smith는, 잠재 설명 변수가 많을수록 단계별 회귀의 효과가 떨어지므로 예측 변수가 너무 많은 문제를 해결해 주지 않는다고 주장합니다.
데이터의 작은 변화가 선택된 예측 변수를 바꿀 수 있습니다.
몇 행을 제거하거나 같은 모집단에서 새 표본을 수집하면, 단계별 절차는 다른 모델을 반환할 수 있습니다. 선택 임계 근처의 예측 변수가 가장 취약합니다. 실제로는 작은 효과를 가진 변수(lot_size_sqft처럼)는 어떤 표본에서는 들어오고, 다음 표본에서는 빠질 수 있습니다. 효과가 전혀 없는 변수(bedrooms처럼)는 표본이 우연히 유리할 때 슬그머니 들어올 수 있습니다.
이는 우리가 오직 하나의 표본만 보게 된다는 점에서 중요합니다. 단계별이 주는 모델은 가능한 모델들의 범위 중 하나이며, 출력은 그 범위가 얼마나 넓은지 알려주지 않습니다.
단계별은 예측 변수 선택과 계수 추정을 같은 데이터로 수행합니다.
약한 예측 변수는, 그 효과가 실제보다 강해 보이는 표본에서만 모델에 포함되는 경향이 있습니다. 약해 보이는 표본에서는 제외됩니다. 따라서 선택 이후의 계수는 평균적으로 과대 추정됩니다.
쉽게 말해, 단계별 회귀는 승자만 보고하며, 승자는 실제보다 좋아 보입니다.
회귀 요약의 p-값은 데이터를 보기 전에 모델을 선택했다고 가정합니다.
단계별은 그 반대를 합니다. 여러 검정을 실행하고, 통과한 예측 변수를 유지한 뒤, 마치 그 예측 변수들만 검정한 것처럼 p-값을 보고합니다. 그래서 p-값은 과소추정되고 신뢰구간은 과도하게 좁습니다.
많은 후보가 실제로는 효과가 없을수록 문제가 더 심합니다. David Freedman은 1983년 The American Statistician 논문에서 이를 보였습니다. 순수한 잡음 변수들을 선별해 모델을 다시 적합했을 때, 찾을 것이 없는데도 결과가 통계적으로 유의해 보였습니다. Smith 역시 같은 점을 지적합니다. 잡음 변수는 우연히 유의해 보일 수 있고, 진짜 변수는 임계를 넘지 못할 수 있습니다.
그런 p-값을 근거로 보고하면, 잡음을 보고할 위험이 있습니다.
과적합은 같은 문제의 예측 측면입니다.
후보 예측 변수가 늘어날수록, 단계별은 표본에만 존재하는 패턴을 적합할 기회를 더 많이 갖습니다. 선택된 모델은 학습 데이터에서는 좋아 보이지만, 그 패턴은 새 데이터에서 재현되지 않습니다. 결과적으로 모델은 내부 적합은 좋아도 외부 예측 성능은 나쁠 수 있습니다.
그리고 후보 예측 변수가 많을수록, 실제로 존재하지 않는 패턴을 찾을 기회도 더 많아집니다.
두 변수가 유사한 정보를 담고 있으면, 단계별은 그중 하나를 골라야 하며, 표본의 작은 차이가 선택을 좌우합니다.
square_feet와 bedrooms는 완만한 사례입니다. square_feet가 모델에 들어가면 bedrooms는 거의 아무것도 더하지 못합니다. 상관이 더 강하면 선택은 거의 무작위가 됩니다. 어떤 표본은 변수 A를, 다음 표본은 변수 B를 유지하며, 각각의 모델은 결과를 좌우하는 요인에 대해 서로 다른 이야기를 합니다.
둘 중 어느 쪽도 신뢰할 수 없습니다. 단계별은 두 변수가 상호 대체 가능하다는 사실을 알려주지 못해, 그중 하나를 임의로 고를 뿐입니다.
단계별은 한 번에 하나의 결정을 내리며, 각 결정은 이전 결정에 의존합니다.
즉 최적 모델을 놓칠 수 있습니다. 두 변수가 단독으로는 쓸모없지만 함께 있을 때 강력한 경우를 생각해 보세요. 서로의 잡음을 보정할 때 발생합니다. 전진 선택은 어느 것도 한 번에 모델을 개선하지 못하므로 둘 다 절대 추가하지 않습니다.
후진 제거와 양방향 선택은 이 위험을 줄이지만 없애지는 못합니다. 세 방법 모두 모든 조합을 확인하지 않으므로, 선택 기준상 최적 모델을 보장할 수 없습니다.
단계별 회귀는 역할이 좁은 도구입니다.
다음과 같은 경우에 적합합니다:
확증적 추론과 인과 분석에는 부적절합니다.
어떤 예측 변수가 효과가 있는지 검정하는 것이 목표라면, 단계별 선택 이후의 p-값은 그 질문에 답하지 못합니다. 목표가 인과라면, 올바른 변수 집합은 AIC를 얼마나 낮추는지가 아니라 데이터 생성 과정에서 나옵니다. 단계별은 어떤 변수가 무엇을 야기하는지 전혀 알지 못합니다.
예측 목적이라면 더 나은 선택지가 있습니다. 정규화 방법인 라쏘와 엘라스틱넷은 더 안정적이며, 교차 검증 기반 특성 선택은 보지 않은 데이터로 모델을 평가합니다.
단계별 회귀를 사용하기로 했다면, 다음 단계를 통해 결과의 정직성을 높일 수 있습니다:
단계별 회귀는 예측 변수 선택을 자동화합니다. 변수를 한 번에 하나씩 추가하거나 제거하고, 선택한 기준으로 더 이상 개선되지 않으면 멈춥니다.
전진 선택은 비어 있는 상태에서 시작해 추가만 합니다. 후진 제거는 전체 모델에서 시작해 제거만 합니다. 양방향 선택은 둘 다 수행하여, 이전 결정을 되돌릴 수 있습니다.
하지만 단순함에는 대가가 따릅니다. 선택된 예측 변수는 표본마다 달라질 수 있고, 모델은 잡음을 적합할 수 있으며, 선택 이후의 p-값과 신뢰구간은 신뢰하기 어렵습니다. 이를 항상 염두에 두세요. 단계별 회귀를 여러 모델 선택 기법 중 하나로 다루되, 회귀 모델을 만드는 기본 방식으로 삼지는 마세요.
더 알아보고 싶다면, 일반적인 특성 선택, AIC와 BIC의 모델 비교, 그리고 라쏘 회귀를 시작으로 한 정규화를 살펴보세요.
DataCamp로 배우기
강의
강의
강의