
Kursus
Pengantar Regresi dengan statsmodels di Python
4 jam
62.7K
Pernahkah Anda melihat sebuah dataset regresi dengan 20 prediktor dan bertanya-tanya mana yang harus dimasukkan ke model?
Jika Anda memasukkan semuanya, model kemungkinan akan menyesuaikan derau selain sinyal. Jika memilih secara manual, dua analis bisa melihat data yang sama dan menghasilkan dua model berbeda. Dan tak perlu dikatakan lagi, bahkan dengan hanya 20 prediktor, ada lebih dari satu juta subset yang mungkin untuk dibandingkan.
Regresi stepwise mengotomatiskan pencarian ini, karena ia menambah atau menghapus satu prediktor pada satu waktu berdasarkan kriteria statistik seperti p-value atau AIC. Metode ini banyak diajarkan dan digunakan, tetapi juga memiliki beberapa keterbatasan statistik, sehingga Anda tidak boleh memperlakukannya sebagai metode seleksi fitur bawaan.
Dalam artikel ini, saya akan memandu Anda melalui tiga pendekatan utama: forward selection, backward elimination, dan bidirectional stepwise selection.
Mencari teknik seleksi fitur lainnya? Baca Tutorial Seleksi Fitur Python kami untuk pengantar yang ramah pemula.
Regresi stepwise adalah prosedur otomatis untuk memilih prediktor mana yang masuk ke dalam model regresi.
Metode ini tidak menyesuaikan satu model saja, melainkan menyesuaikan rangkaian model kandidat, dan di setiap langkah menambah atau menghapus prediktor berdasarkan kriteria seleksi. Pencarian berakhir ketika tidak ada perubahan lebih lanjut yang meningkatkan model menurut kriteria tersebut.
Bayangkan Anda ingin memprediksi berapa banyak pelanggan membelanjakan per tahun. Anda memiliki lima prediktor kandidat:
income
age
education
location
years_experience
Regresi stepwise bisa mulai dengan income, lalu menguji apakah age memperbaiki model, kemudian education, dan seterusnya. Model akhir mungkin hanya mempertahankan income dan education jika tiga lainnya tidak cukup meningkatkan kriteria.
Satu pembedaan penting untuk diingat adalah bahwa regresi stepwise bukan tipe model regresi yang terpisah.
Ini adalah prosedur seleksi variabel yang dijalankan di atas model yang sudah Anda kenal, biasanya regresi linear. Keluaran akhirnya tetap model regresi biasa; stepwise hanya memutuskan prediktor mana yang digunakan.
Setiap prosedur stepwise melalui loop yang sama:
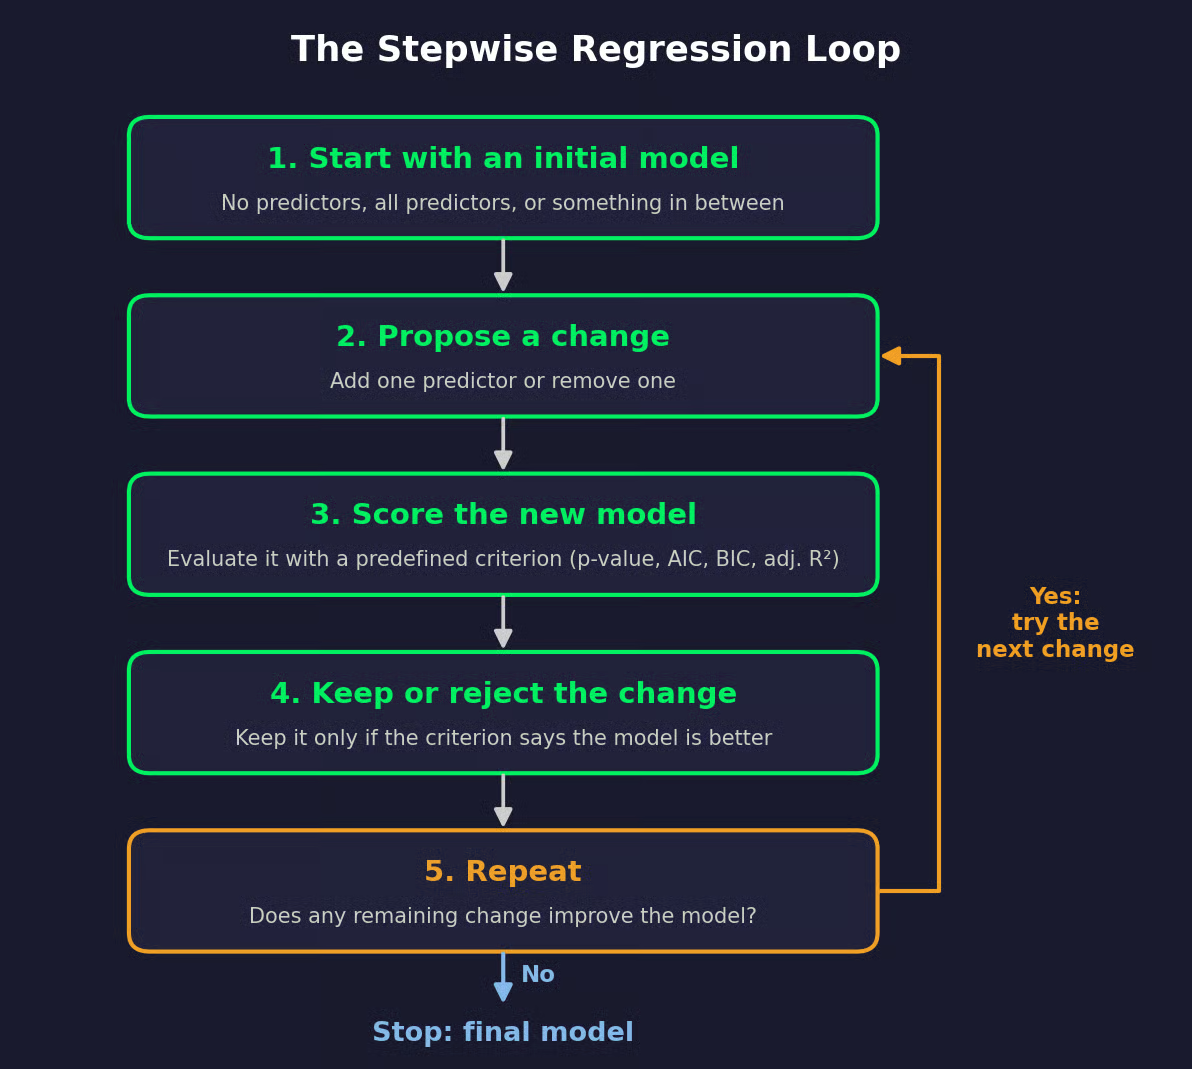
Loop regresi stepwise
Algoritme tidak pernah melihat lebih dari satu langkah ke depan. Ia hanya menanyakan apakah satu perubahan berikutnya membantu.
Kriteria menentukan apa arti "lebih baik". Empat kriteria yang paling sering Anda temui:
Prosedur tepatnya bergantung pada arah pencarian dan kriterianya. Forward selection hanya menambah prediktor, backward elimination hanya menghapus, dan bidirectional selection melakukan keduanya. Dataset yang sama bisa menghasilkan model akhir yang berbeda tergantung kriteria yang dipilih.
Jadi ketika seseorang mengatakan mereka menjalankan regresi stepwise, dua pertanyaan pertama yang perlu ditanyakan adalah arah mana dan kriteria mana.
Ada tiga jenis regresi stepwise, dan bedanya hanya satu hal - arah pencarian.
Forward selection mulai dari yang kecil dan membangun dari sana.
Anda mulai dengan model hanya intersep, atau dengan beberapa prediktor yang Anda inginkan ada di model apa pun yang terjadi. Algoritme kemudian menyesuaikan satu model kandidat per prediktor yang tersisa, masing-masing dengan penambahan satu prediktor itu. Prediktor yang paling meningkatkan kriteria masuk ke model.
Loop lalu berjalan lagi, dengan model yang lebih besar sebagai basis baru. Berhenti ketika tidak ada prediktor tersisa yang memenuhi aturan seleksi, misalnya saat tidak ada penambahan yang menurunkan AIC.
Forward selection dapat dimulai bahkan ketika jumlah prediktor kandidat melebihi jumlah observasi, karena tidak pernah perlu menyesuaikan model penuh. Konsekuensinya, setelah prediktor masuk, ia tetap di dalam, bahkan jika penambahan selanjutnya membuatnya menjadi berlebih.
Backward elimination bergerak ke arah sebaliknya.
Anda mulai dengan model penuh, yang mencakup setiap prediktor kandidat. Algoritme mencoba menghapus setiap prediktor satu per satu dan menghapus yang penghapusannya paling meningkatkan kriteria. Lalu ia menyesuaikan ulang model yang lebih kecil dan mengulang. Pencarian berhenti saat tidak ada penghapusan yang meningkatkan kriteria.
Pendekatan ini berarti model penuh harus dapat diestimasi. Anda memerlukan observasi lebih banyak daripada parameter, dan tidak ada prediktor yang merupakan kombinasi linear tepat dari yang lain. Jika Anda memiliki 50 prediktor dan 40 baris, backward elimination bahkan tidak bisa mulai.
Dan ia memiliki masalah bayangan dari forward selection, artinya setelah prediktor keluar, ia tetap di luar.
Bidirectional selection menggabungkan keduanya. Setelah setiap penambahan, algoritme memeriksa apakah ada prediktor yang sudah di model kini harus dikeluarkan.
Ini penting karena nilai sebuah prediktor bergantung pada apa yang sudah ada di model. Misalnya bedrooms masuk terlebih dahulu karena berkorelasi dengan ukuran rumah. Ketika square_feet masuk belakangan, bedrooms mungkin hampir tidak menambah apa-apa lagi. Bidirectional selection dapat menghapusnya pada titik itu, sementara forward selection akan tetap mempertahankannya.
Konsekuensinya adalah lebih banyak penyesuaian model per langkah. Anda bisa memulai bidirectional selection dari model kosong atau penuh.
Berikut perbandingan ketiganya:
| Forward selection | Backward elimination | Bidirectional selection | |
|---|---|---|---|
| Model awal | Hanya intersep atau himpunan dasar kecil | Model penuh dengan semua kandidat | Model kosong atau penuh |
| Operasi yang diizinkan | Hanya menambah | Hanya menghapus | Menambah atau menghapus |
| Pertimbangan | Dapat dimulai saat jumlah prediktor melebihi observasi, tetapi penambahan awal tidak pernah ditinjau ulang | Memerlukan model penuh yang dapat diestimasi, dan prediktor yang dihapus tidak kembali lagi | Lebih banyak penyesuaian model per langkah, tetapi dapat membatalkan keputusan sebelumnya |
Jenis regresi stepwise
Mari kita buat ini lebih nyata.
Saya membuat dataset sintetis berisi 200 rumah dan ingin memprediksi price dari lima prediktor kandidat:
square_feet
bedrooms
age_years
distance_km (jarak dari pusat kota)
lot_size_sqft
Saya akan menggunakan forward selection dengan AIC sebagai kriteria, di mana AIC yang lebih rendah lebih baik. Anda akan melihat data yang sama lagi di bagian Python.
Model hanya intersep memiliki AIC 5057.0. Berikut tampilan setiap langkah — setiap sel menunjukkan AIC yang Anda dapatkan dengan menambahkan prediktor tersebut ke model saat ini:
| Kandidat | Langkah 1 | Langkah 2 | Langkah 3 | Langkah 4 | Langkah 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| AIC model saat ini | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
Perbandingan AIC
Inilah yang terjadi di setiap langkah:
Langkah 1: square_feet menurunkan AIC sekitar 102 poin, jadi masuk pertama. bedrooms berada di posisi kedua karena berkorelasi dengan ukuran rumah
Langkah 2: distance_km memberi penurunan terbesar. bedrooms kini nyaris tidak membantu, karena square_feet sudah memuat sebagian besar informasinya
Langkah 3: age_years masuk
Langkah 4: lot_size_sqft menurunkan AIC hanya 1,6 poin, tetapi lebih rendah tetap lebih rendah, jadi masuk
Langkah 5: Menambahkan bedrooms akan menaikkan AIC menjadi 4840.8, jadi pencarian berhenti
Model akhir menggunakan square_feet, distance_km, age_years, dan lot_size_sqft.
Itu hasil yang masuk akal. Saya menghasilkan data sedemikian rupa sehingga bedrooms tidak memiliki efek langsung pada harga, dan prosedurnya mengabaikannya.
Jika Anda menjalankan backward elimination pada data yang sama, ia mulai dari model penuh di 4840.8, menghapus bedrooms, dan berhenti pada empat prediktor yang sama. Forward dan backward tidak selalu sependapat, tetapi di sini keduanya sama.
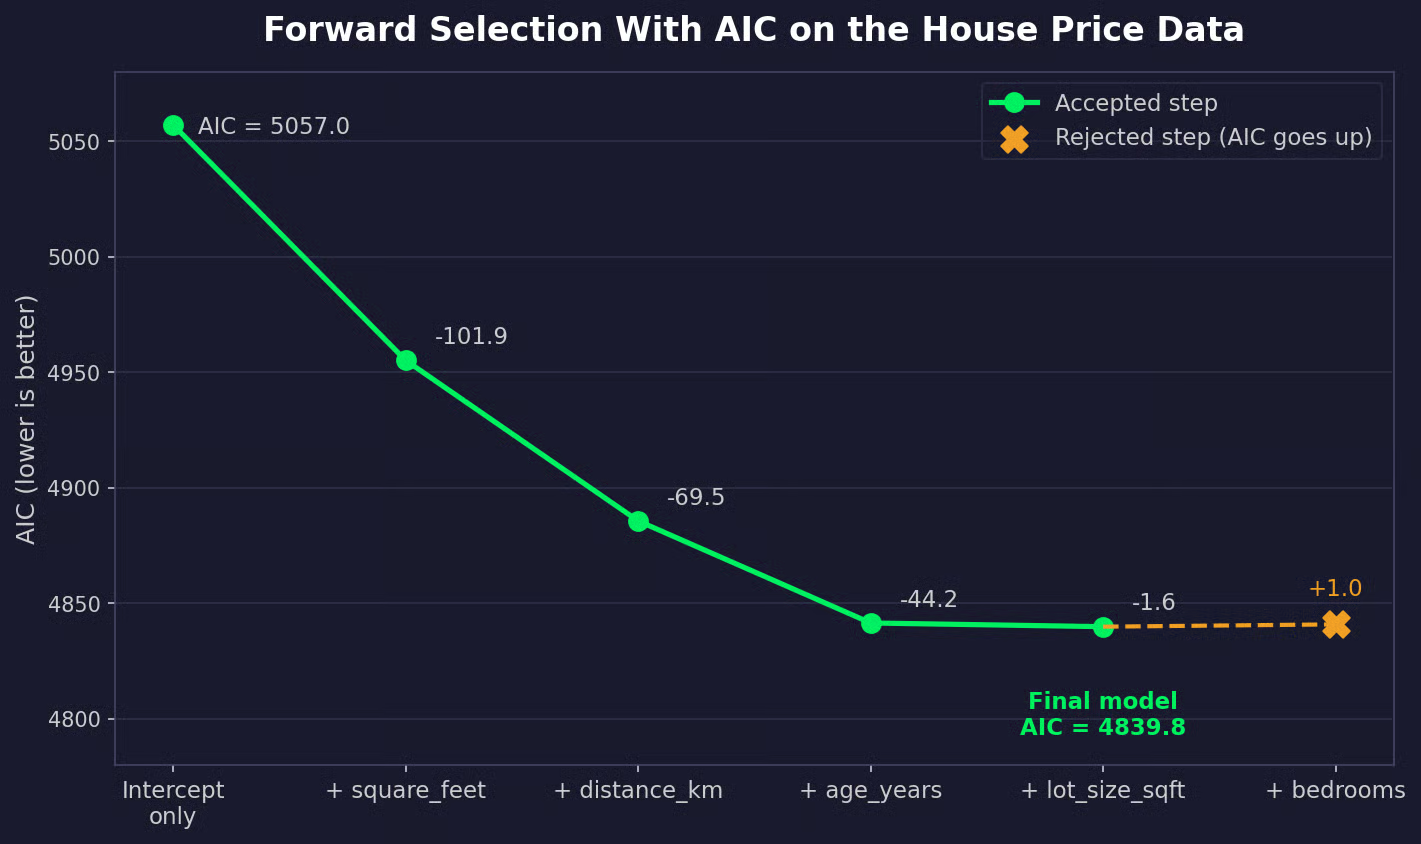
AIC model saat ini setelah setiap langkah forward selection
Arah pencarian menentukan perilaku algoritme. Kriteria menentukan kapan ia berhenti.
Ini adalah pendekatan tertua, dan menggunakan dua ambang:
Ambang keluaran biasanya ditetapkan lebih tinggi daripada ambang masuk, sehingga prediktor tidak masuk dan keluar model di setiap langkah. Kedua nilai tersebut adalah konvensi, bukan aturan.
Setiap p-value mengasumsikan Anda menjalankan satu uji yang direncanakan sebelumnya. Stepwise menjalankan serangkaian uji di setiap langkah dan mempertahankan p-value terkecil. Jika Anda menjalankan 20 uji independen pada 0,05 untuk prediktor tanpa efek sama sekali, peluang setidaknya satu tampak signifikan adalah 1 − 0.95^20, yaitu sekitar 64%. Prediktor terpilih akan tampak lebih kuat daripada sebenarnya, dan saya akan bahas alasannya di bagian masalah.
Dalam contoh harga rumah, lot_size_sqft memiliki p-value sekitar 0,063 pada langkah 4. Dengan ambang masuk 0,05, forward selection berhenti pada tiga prediktor.
Akaike information criterion menyeimbangkan kesesuaian model dengan kompleksitas:
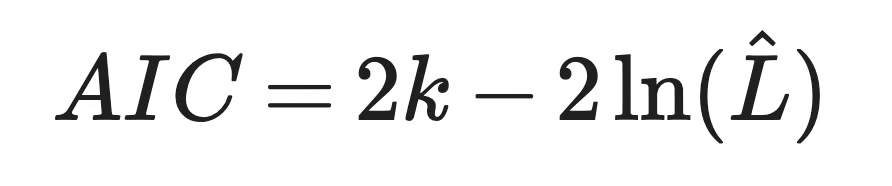
Rumus AIC
Di sini, k adalah jumlah parameter yang diestimasi dan L̂ adalah likelihood termaksimum dari model. Suku kedua menghargai kesesuaian, dan suku pertama memberi biaya 2 poin untuk setiap parameter.
Prediktor baru tidak pernah menurunkan likelihood, jadi suku kesesuaian hanya bisa membaik. Pertanyaannya apakah ia membaik lebih dari biaya 2 poin. Untuk satu parameter yang ditambahkan, ini setara dengan uji rasio likelihood pada ambang p-value sekitar 0,157.
Itulah mengapa lot_size_sqft lolos menurut AIC tetapi tidak menurut aturan p-value 0,05. AIC lebih longgar, dan cenderung mempertahankan prediktor yang lebih lemah yang membantu prediksi.
Bayesian information criterion memiliki struktur yang sama, dengan penalti berbeda:
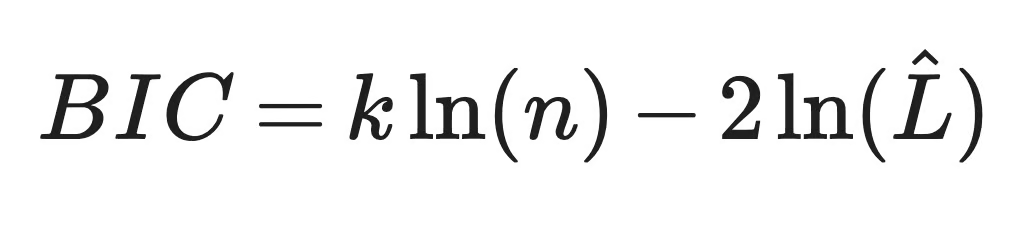
Rumus BIC
Dalam rumus ini, n adalah jumlah observasi. Setiap parameter kini berbiaya ln(n) poin alih-alih 2, jadi BIC memberi penalti kompleksitas lebih besar daripada AIC ketika Anda memiliki 8 atau lebih observasi. Dan kesenjangannya tumbuh seiring ukuran sampel.
Dengan 200 rumah, ln(200) sekitar 5,3, yang setara dengan ambang p-value implisit sekitar 0,021 untuk satu parameter yang ditambahkan. Forward selection dengan BIC pada data rumah berhenti pada tiga prediktor dan mengabaikan lot_size_sqft.
R-kuadrat biasa tidak berguna sebagai kriteria seleksi.
Nilainya tidak pernah turun saat Anda menambah prediktor ke model regresi linear, bahkan jika itu kolom derau acak. Jika Anda memilih berdasarkan R-kuadrat, model penuh selalu terbaik.
R-kuadrat tersesuaikan menambahkan penalti untuk jumlah prediktor:
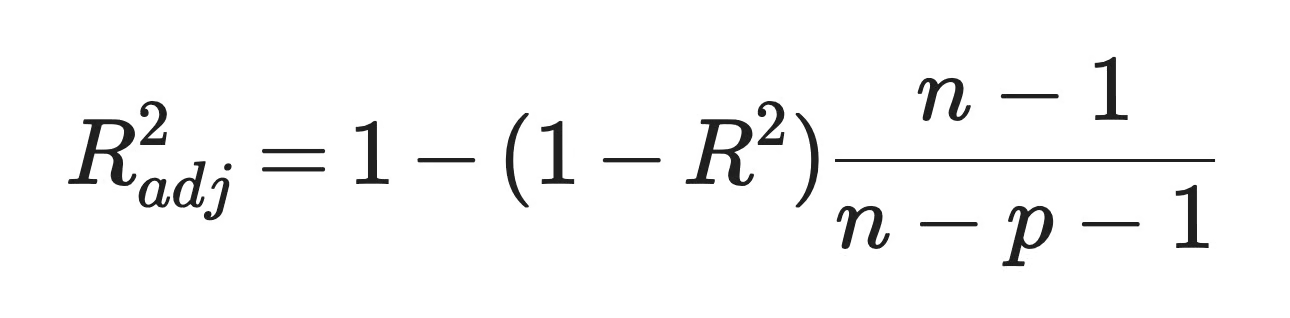
Rumus R-kuadrat tersesuaikan
Di sini, p adalah jumlah prediktor, dan nilai yang lebih tinggi lebih baik. Penalti ini ringan. Prediktor baru menaikkan R-kuadrat tersesuaikan kapan pun nilai absolut t-statistiknya di atas 1, sehingga ini adalah yang paling longgar dari keempat kriteria.
Pada data rumah, R-kuadrat tersesuaikan mempertahankan lot_size_sqft dan menolak bedrooms dengan selisih di angka desimal kelima.
Data yang sama, pencarian maju yang sama, jawaban berbeda:
| Kriteria | Model akhir |
|---|---|
| P-value (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| R-kuadrat tersesuaikan | square_feet, distance_km, age_years, lot_size_sqft |
Seleksi variabel berdasarkan kriteria berbeda
Kedua bahasa dapat menjalankan regresi stepwise, tetapi caranya berbeda. Saya akan menggunakan data harga rumah yang sama dari contoh di atas pada keduanya.
Python tidak memiliki fungsi regresi stepwise standar.
Baik statsmodels maupun scikit-learn tidak memiliki padanan step() di R yang memilih prediktor berdasarkan AIC atau p-value. Jadi opsi paling transparan adalah menulis loop sendiri di atas statsmodels. Kodenya sekitar 25 baris, dan Anda dapat melihat setiap keputusan yang dibuat.
Perlu diperjelas, fungsi forward_selection() di bawah adalah pembantu buatan saya sendiri, bukan fitur statsmodels. statsmodels hanya menyesuaikan model dan melaporkan atribut .aic dan .bic.
Pertama, buat dataset dan simpan, sehingga bagian R dapat menggunakan baris yang persis sama:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Berikutnya, loop seleksi. Dimulai dari model hanya intersep, menyesuaikan satu model per kandidat yang tersisa, dan mempertahankan penambahan dengan nilai kriteria terendah:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")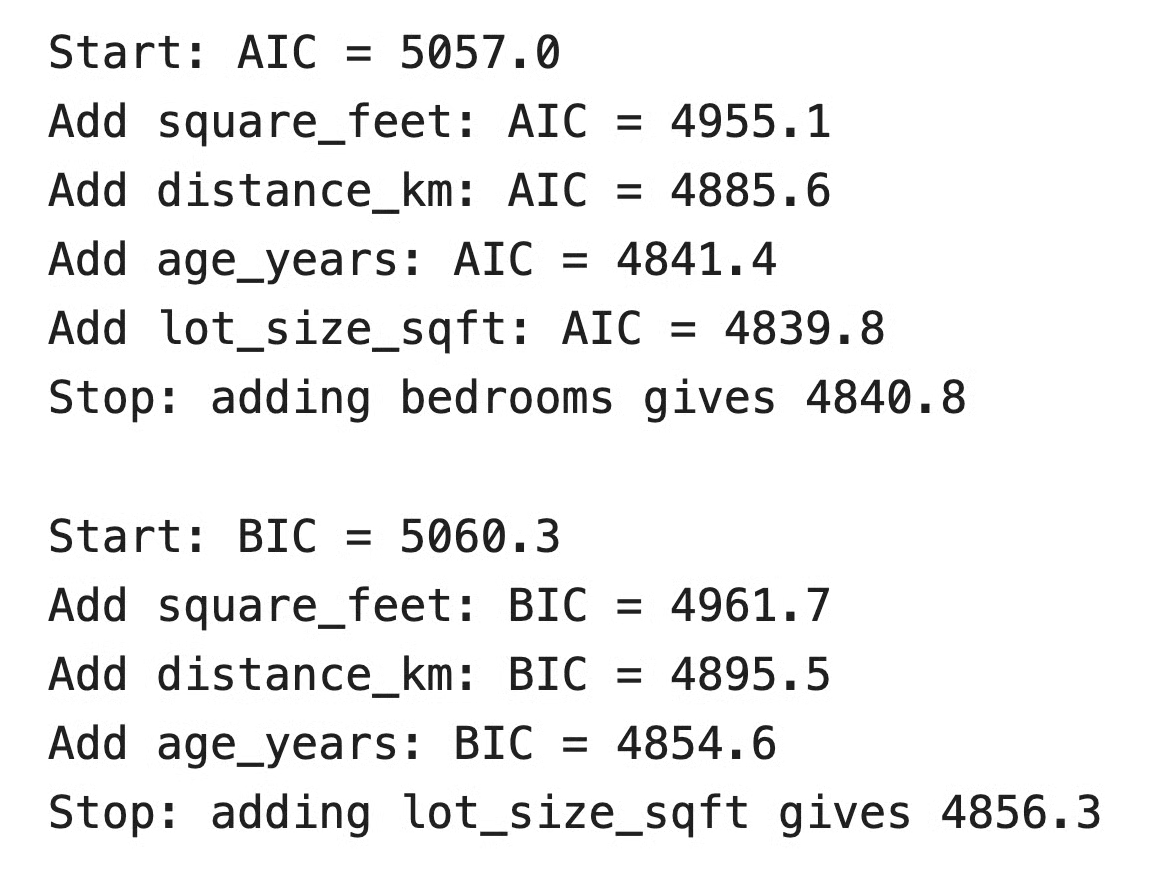
Forward selection di Python
Ini adalah nilai AIC yang sama dari tabel contoh. AIC berakhir dengan empat prediktor, dan BIC berhenti pada tiga karena lot_size_sqft tidak lolos penalti yang lebih besar.
Jika Anda lebih suka menggunakan paket, scikit-learn memiliki SequentialFeatureSelector. Ia menjalankan forward atau backward selection, tetapi menilai setiap kandidat dengan cross-validation alih-alih AIC atau p-value:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Fitur terpilih di Python
Dengan n_features_to_select="auto", pencarian berhenti saat R-kuadrat tervalidasi-silang meningkat kurang dari tol. Pada data ini, hasilnya berakhir dengan empat prediktor yang sama seperti AIC.
R memiliki regresi stepwise bawaan.
Fungsi step() tersedia di paket stats bawaan R, jadi tidak perlu menginstal apa pun. Anda memberinya model awal, scope yang mendefinisikan model terbesar yang boleh dipertimbangkan, dan arah:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)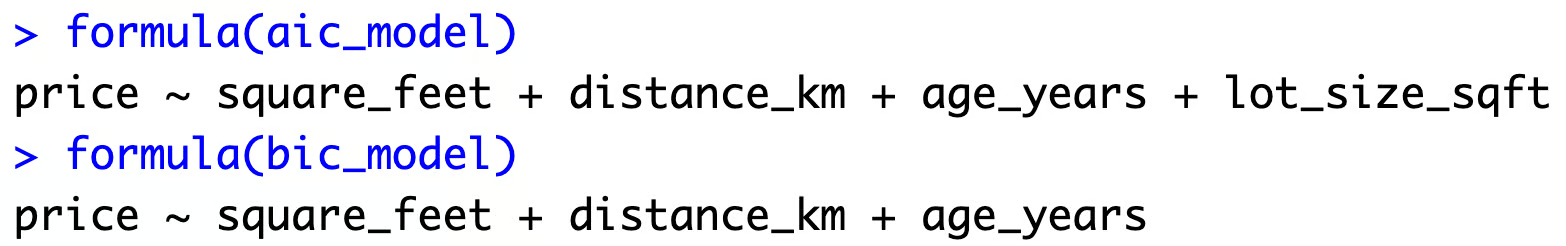
Rumus AIC dan BIC di R
Kriteria yang diminimalkan step() dikendalikan oleh satu argumen - k.
Fungsi ini menghitung -2 log-likelihood + k * edf, di mana edf adalah jumlah koefisien yang diestimasi. Nilai default k = 2 memberi Anda AIC. Jika Anda menetapkan k = log(n), Anda mendapatkan BIC, tetapi jejak keluaran yang dicetak masih memberi label nilai sebagai "AIC", jadi jangan sampai bingung.
Untuk backward elimination, mulai dari model penuh:
backward_model <- step(full_model, direction = "backward")Pada data ini, fungsi tersebut menghapus bedrooms dan berhenti dengan empat prediktor yang sama seperti forward AIC. Jika Anda memberikan scope dan tidak menyertakan direction, step() akan default ke bidirectional selection.
Regresi stepwise bukan satu-satunya cara memilih prediktor. Berikut perbandingannya dengan tiga alternatif populer.
Regresi stepwise adalah pencarian rakus (greedy). Di setiap langkah, ia membuat langkah tunggal terbaik dan tidak menoleh ke belakang, kecuali Anda menjalankannya di kedua arah.
Best subset selection menyesuaikan setiap kemungkinan kombinasi prediktor dan mempertahankan yang memiliki nilai kriteria terbaik. Dengan 5 prediktor, itu 32 model. Dengan 20, lebih dari satu juta, dan dengan 40, lebih dari satu triliun. Algoritme seperti branch-and-bound di paket R leaps bisa melewati banyak pekerjaan itu, tetapi biayanya tetap meningkat cepat seiring jumlah prediktor.
Pada data harga rumah, best subset selection dengan AIC memilih empat prediktor yang sama seperti forward selection. Itu tidak selalu terjadi, jadi ingatlah hal ini.
Regresi stepwise membuat keputusan ya-atau-tidak. Sebuah prediktor ada di model dengan koefisien kuadrat terkecil penuh, atau tidak ada dengan koefisien nol.
Regresi Lasso menyesuaikan semua prediktor sekaligus dan menambahkan penalti pada jumlah nilai absolut koefisien. Penalti itu mengecilkan setiap koefisien menuju nol dan mendorong yang paling lemah hingga nol, sehingga seleksi dan estimasi terjadi dalam satu langkah.
Perubahan kecil pada data sedikit menggeser koefisien Lasso, sementara itu bisa membalik keputusan stepwise dari masuk menjadi keluar. Anda memilih kekuatan penalti dengan cross-validation, misalnya dengan LassoCV di scikit-learn atau cv.glmnet() di R.
Koefisien yang menyusut bias ke arah nol secara sengaja. Ini adalah pertukaran untuk estimasi yang lebih stabil dan prediksi out-of-sample yang lebih baik.
Recursive feature elimination, atau RFE, terlihat seperti backward elimination. Anda menyesuaikan model pada semua fitur, menghapus yang terlemah, menyesuaikan ulang, dan mengulang.
Perbedaannya adalah apa arti "terlemah". Backward elimination menggunakan kriteria statistik seperti AIC atau p-value. RFE menggunakan skor kepentingan model itu sendiri, seperti besaran koefisien atau feature importance berbasis pohon.
Itu membuat RFE menjadi alat machine learning terlebih dahulu. Ia bekerja dengan model apa pun yang memiliki feature importance, termasuk random forest dan support vector machine, dan biasanya Anda memasangkannya dengan cross-validation melalui RFECV di scikit-learn. Anda mendapatkan himpunan fitur yang memprediksi dengan baik, tetapi tanpa kriteria berbasis likelihood dan tanpa p-value.
Regresi stepwise mudah dijalankan dan dijelaskan. Itulah tepatnya mengapa masalahnya mudah terlewat.
Ahli statistik telah mengkritik metode ini selama beberapa dekade — Frank Harrell dalam Regression Modeling Strategies dan Whittingham dkk. (2006) di Journal of Animal Ecology adalah dua contoh terkenal. Dalam makalah 2018 di Journal of Big Data, Gary Smith berargumen bahwa regresi stepwise semakin tidak efektif seiring bertambahnya jumlah variabel penjelas potensial, sehingga tidak menyelesaikan masalah terlalu banyak prediktor.
Perubahan kecil pada data dapat mengubah prediktor yang Anda dapatkan.
Jika Anda menghapus beberapa baris atau mengumpulkan sampel baru dari populasi yang sama, stepwise bisa mengembalikan model berbeda. Prediktor yang dekat dengan ambang seleksi adalah yang paling rapuh. Prediktor dengan efek nyata tetapi kecil, seperti lot_size_sqft pada contoh harga rumah, bisa masuk pada satu sampel dan tetap di luar pada sampel berikutnya. Prediktor tanpa efek, seperti bedrooms, bisa lolos ketika sampel kebetulan menguntungkannya.
Ini penting karena Anda hanya pernah melihat satu sampel. Model yang diberikan stepwise kepada Anda adalah salah satu dari rentang model yang mungkin, dan keluaran tidak memberi tahu seberapa lebar rentang itu.
Stepwise menggunakan data yang sama untuk memilih prediktor dan memperkirakan koefisiennya.
Prediktor lemah masuk ke model terutama pada sampel di mana efeknya kebetulan tampak lebih kuat dari sebenarnya. Pada sampel di mana tampak lebih lemah, ia dikeluarkan. Jadi koefisien yang Anda lihat setelah seleksi terlalu besar rata-rata.
Secara sederhana, regresi stepwise melaporkan para pemenang, dan pemenang tampak lebih baik daripada kenyataannya.
P-value dalam ringkasan regresi mengasumsikan Anda memilih model sebelum melihat data.
Stepwise melakukan kebalikannya. Ia menjalankan serangkaian uji, mempertahankan prediktor yang lolos, lalu melaporkan p-value seolah-olah prediktor itu satu-satunya yang pernah Anda uji. Jadi p-value keluar terlalu kecil dan interval kepercayaan terlalu sempit.
Masalahnya lebih buruk saat banyak kandidat tidak memiliki efek. David Freedman menunjukkan ini dalam makalah 1983 di The American Statistician — saat ia menyaring prediktor derau murni dan menyesuaikan ulang model, hasilnya tampak signifikan secara statistik meski tidak ada apa pun untuk ditemukan. Smith menyampaikan poin yang sama: variabel pengganggu mungkin kebetulan signifikan, sementara yang nyata bisa tidak lolos ambang.
Jika Anda melaporkan p-value tersebut sebagai bukti, Anda mungkin melaporkan derau.
Overfitting adalah sisi prediksi dari masalah yang sama.
Setiap prediktor kandidat memberi stepwise kesempatan lain untuk menyesuaikan pola yang hanya ada dalam sampel Anda. Model terpilih tampak bagus pada data tempat ia dibuat, tetapi pola tersebut tidak terulang pada data baru. Akibatnya, model mungkin sesuai dengan baik pada data in-sample, tetapi buruk pada out-of-sample.
Dan semakin banyak prediktor kandidat yang Anda berikan, semakin banyak kesempatan yang dimilikinya untuk menemukan pola yang sebenarnya tidak ada.
Ketika dua prediktor memiliki informasi serupa, stepwise harus memilih di antara keduanya, dan perbedaan kecil dalam sampel menentukan pilihannya.
square_feet dan bedrooms pada data rumah adalah contoh ringan — setelah square_feet masuk model, bedrooms hampir tidak menambah apa pun. Dengan korelasi yang lebih kuat, pilihan menjadi nyaris acak. Satu sampel mempertahankan variabel A, sampel berikutnya mempertahankan variabel B, dan masing-masing model menceritakan kisah berbeda tentang apa yang mendorong hasil.
Tak satu pun dari kisah itu dapat diandalkan. Stepwise tidak bisa memberi tahu Anda bahwa dua prediktor saling dapat dipertukarkan, jadi ia hanya memilih salah satunya.
Stepwise membuat satu keputusan pada satu waktu, dan setiap keputusan bergantung pada keputusan sebelumnya.
Itu berarti ia dapat melewatkan model terbaik. Misalnya dua prediktor tidak berguna sendiri-sendiri tetapi kuat jika digabung, yang bisa terjadi saat masing-masing mengoreksi derau pada yang lain. Forward selection tidak akan pernah menambahkan keduanya, karena tidak ada yang memperbaiki model dalam satu langkah.
Backward elimination dan bidirectional selection mengurangi risiko ini, tetapi tidak menghapusnya. Tidak satu pun dari ketiganya memeriksa semua kombinasi, jadi tidak ada yang bisa menjanjikan model terbaik untuk kriteria yang dipilih.
Regresi stepwise adalah alat dengan tugas yang sempit.
Ini pilihan yang baik untuk:
Ini pilihan yang salah untuk inferensi konfirmatori dan analisis kausal.
Jika tujuan Anda menguji apakah suatu prediktor memiliki efek, p-value setelah seleksi stepwise tidak dapat menjawabnya. Dan jika tujuan Anda adalah kausal, himpunan variabel yang tepat berasal dari bagaimana data dihasilkan, bukan dari variabel mana yang menurunkan AIC. Stepwise tidak tahu variabel mana menyebabkan yang mana.
Untuk prediksi, Anda punya opsi yang lebih baik. Regularisasi seperti Lasso dan elastic net lebih stabil, dan seleksi fitur tervalidasi-silang menilai model pada data yang tidak mereka lihat.
Jika Anda memutuskan menggunakan regresi stepwise, langkah-langkah ini dapat membuat hasil lebih jujur:
Regresi stepwise mengotomatiskan seleksi prediktor. Ia menambah atau menghapus satu variabel pada satu waktu dan berhenti ketika tidak ada perubahan yang meningkatkan model menurut kriteria pilihan Anda.
Forward selection mulai dari kosong dan hanya menambah. Backward elimination mulai dari model penuh dan hanya menghapus. Bidirectional selection melakukan keduanya, sehingga dapat membatalkan keputusan sebelumnya.
Namun kesederhanaannya berarti prediktor terpilih dapat berubah dari sampel ke sampel, model dapat menyesuaikan derau, dan p-value serta interval kepercayaan setelah seleksi tidak andal. Itu sesuatu yang perlu diingat. Jadi perlakukan regresi stepwise sebagai salah satu teknik seleksi model — bukan cara baku untuk membangun model regresi.
Jika Anda ingin melangkah lebih jauh, pelajari lebih lanjut tentang seleksi fitur secara umum, lihat bagaimana AIC dan BIC membandingkan model, dan coba regresi Lasso sebagai langkah pertama menuju regularisasi.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



