Cours
Introduction à la régression avec statsmodels en Python
4 h
62.5K
Vous est-il déjà arrivé d’examiner un jeu de données de régression avec 20 variables explicatives et de vous demander lesquelles inclure dans le modèle ?
Si vous les ajoutez toutes, le modèle risque d’ajuster le bruit autant que le signal. Si vous choisissez à la main, deux analystes peuvent proposer deux modèles différents à partir des mêmes données. Et inutile de préciser qu’avec seulement 20 variables, il existe déjà plus d’un million de sous-ensembles possibles à comparer.
La régression pas à pas automatise cette recherche : elle ajoute ou retire une variable à la fois selon un critère statistique comme une p-valeur ou l’AIC. Elle est largement enseignée et utilisée, mais présente des limites statistiques. Il ne faut donc pas la considérer comme la méthode par défaut de sélection de variables.
Dans cet article, je vous présente les trois approches principales : la sélection avant, l’élimination arrière et la sélection pas à pas bidirectionnelle.
Vous cherchez d’autres techniques de sélection de variables ? Consultez notre tutoriel Python sur la sélection de variables, une introduction accessible au sujet.
La régression pas à pas est une procédure automatisée pour choisir quelles variables explicatives inclure dans un modèle de régression.
Elle ne se contente pas d’ajuster un seul modèle : elle ajuste une suite de modèles candidats et, à chaque étape, ajoute ou retire une variable selon un critère de sélection. La recherche s’arrête lorsqu’aucune modification supplémentaire n’améliore le modèle selon ce critère.
Imaginez que vous vouliez prédire la dépense annuelle d’un client. Vous disposez de cinq variables candidates :
income
age
education
location
years_experience
La régression pas à pas pourrait commencer par income, puis tester si age améliore le modèle, puis education, et ainsi de suite. Le modèle final pourrait ne conserver que income et education si les trois autres n’améliorent pas suffisamment le critère.
Point essentiel : la régression pas à pas n’est pas un type de modèle de régression à part entière.
C’est une procédure de sélection de variables appliquée à un modèle que vous connaissez déjà, généralement une régression linéaire. Le résultat reste un modèle de régression ordinaire : la procédure décide seulement des variables retenues.
Toute procédure pas à pas suit la même boucle :
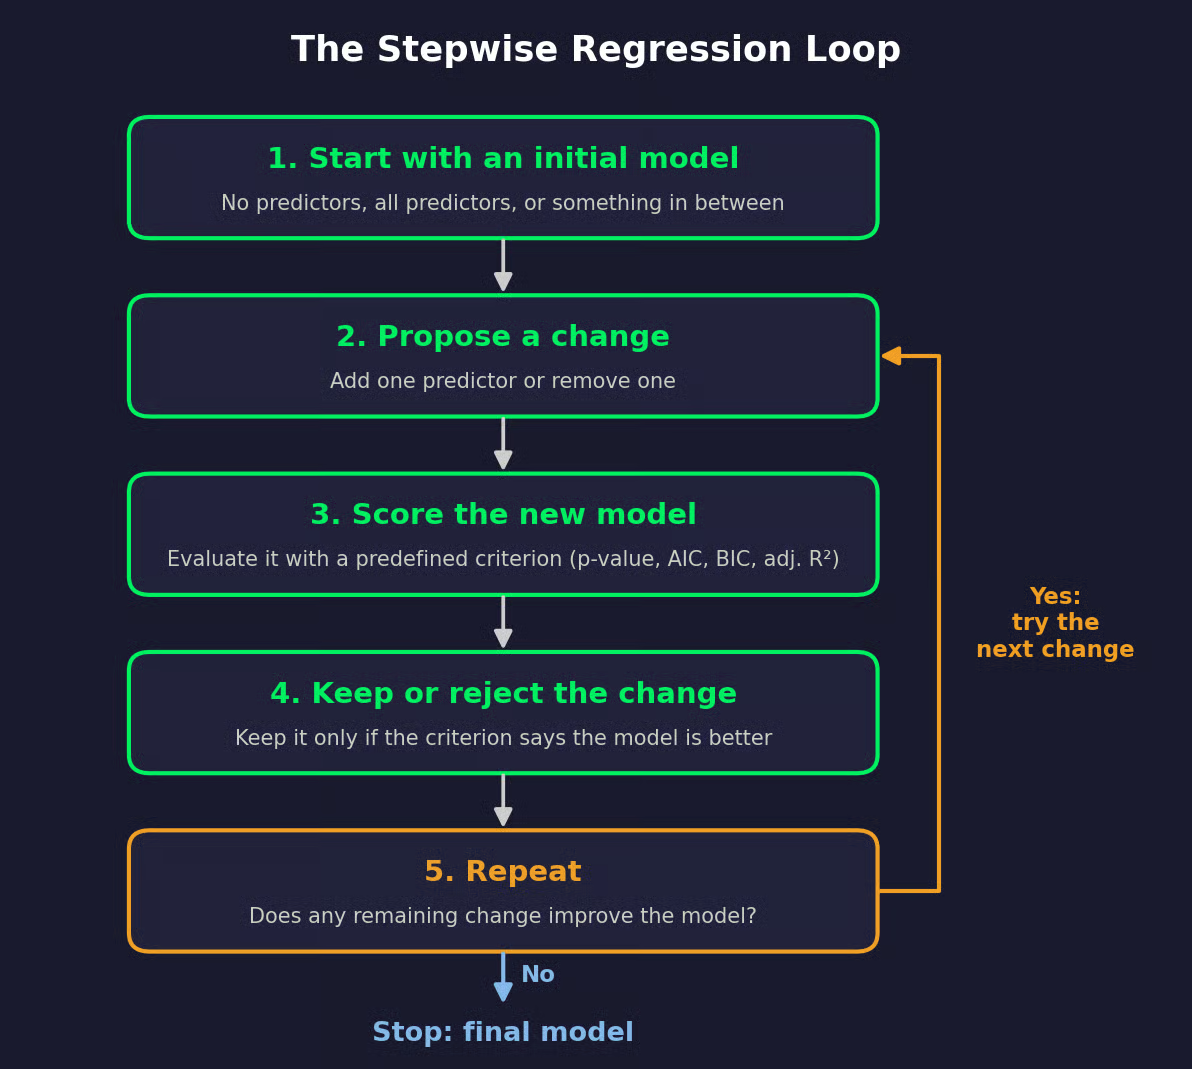
Boucle de régression pas à pas
L’algorithme ne regarde jamais à plus d’une étape d’avance. Il se contente de vérifier si le prochain changement unitaire aide.
Le critère définit ce que « meilleur » signifie. Voici les quatre plus courants :
La procédure exacte dépend du sens de la recherche et du critère. La sélection avant n’ajoute que des variables, l’élimination arrière n’en retire que, et la sélection bidirectionnelle fait les deux. Le même jeu de données peut produire des modèles finaux différents selon le critère choisi.
Ainsi, lorsque quelqu’un dit avoir appliqué une régression pas à pas, demandez-lui d’abord dans quel sens et selon quel critère.
Il existe trois types de régression pas à pas, qui diffèrent par une chose : le sens de la recherche.
La sélection avant part petit et construit progressivement.
Vous commencez avec un modèle à intercept seul, ou avec quelques variables que vous souhaitez inclure quoi qu’il arrive. L’algorithme ajuste ensuite un modèle candidat par variable restante, chacun avec l’ajout de cette seule variable. La variable qui améliore le plus le critère entre dans le modèle.
La boucle repart alors avec ce modèle élargi comme nouvelle base. Elle s’arrête lorsque plus aucune variable restante ne satisfait la règle de sélection, par exemple quand aucun ajout ne réduit l’AIC.
La sélection avant peut démarrer même si vous avez plus de variables candidates que d’observations, car elle n’a jamais besoin d’ajuster le modèle complet. En contrepartie, une fois qu’une variable est entrée, elle n’est jamais réévaluée, même si des ajouts ultérieurs la rendent redondante.
L’élimination arrière prend le chemin inverse.
Vous partez du modèle complet, qui inclut toutes les variables candidates. L’algorithme tente de retirer chaque variable une par une et supprime celle dont le retrait améliore le plus le critère. Puis il réajuste le modèle réduit et recommence. La recherche s’arrête lorsqu’aucune suppression n’améliore le critère.
Cette approche exige que le modèle complet soit estimable. Il faut plus d’observations que de paramètres, et aucune variable ne doit être une combinaison linéaire exacte des autres. Avec 50 variables et 40 lignes, l’élimination arrière ne peut même pas commencer.
Et elle a le problème miroir de la sélection avant : une fois qu’une variable sort, elle ne revient plus.
La sélection bidirectionnelle combine les deux. Après chaque ajout, l’algorithme vérifie si une variable déjà présente doit désormais sortir.
C’est important car la valeur d’une variable dépend de ce qui est déjà dans le modèle. Supposons que bedrooms entre en premier car elle est corrélée à la taille du logement. Quand square_feet entre ensuite, bedrooms peut n’apporter quasiment plus rien. La sélection bidirectionnelle peut alors la retirer, là où la sélection avant l’aurait conservée.
Le prix à payer est un plus grand nombre d’ajustements de modèles par étape. Vous pouvez démarrer d’un modèle vide ou complet.
Voici une comparaison des trois :
| Sélection avant | Élimination arrière | Sélection bidirectionnelle | |
|---|---|---|---|
| Modèle de départ | Intercept seul ou petit socle | Modèle complet avec tous les candidats | Modèle vide ou complet |
| Opérations possibles | Ajouter uniquement | Retirer uniquement | Ajouter ou retirer |
| Points d’attention | Peut commencer quand les variables sont plus nombreuses que les observations, mais les premiers ajouts ne sont jamais réexaminés | Nécessite un modèle complet estimable, et les variables retirées ne reviennent pas | Plus d’ajustements par étape, mais peut annuler des décisions antérieures |
Types de régression pas à pas
Passons au concret.
J’ai généré un jeu de données synthétiques de 200 logements et je veux prédire price à partir de cinq variables candidates :
square_feet
bedrooms
age_years
distance_km (distance du centre-ville)
lot_size_sqft
J’utiliserai la sélection avant avec l’AIC comme critère, où plus bas est mieux. Vous retrouverez les mêmes données dans la section Python.
Le modèle à intercept seul a une AIC de 5057,0. Voici à quoi ressemble chaque étape : chaque cellule montre l’AIC obtenue en ajoutant cette variable au modèle courant :
| Candidat | Étape 1 | Étape 2 | Étape 3 | Étape 4 | Étape 5 |
|---|---|---|---|---|---|
square_feet |
4955,1 | dans le modèle | dans le modèle | dans le modèle | dans le modèle |
distance_km |
5020,3 | 4855,6 | dans le modèle | dans le modèle | dans le modèle |
age_years |
5050,2 | 4926,4 | 4841,4 | dans le modèle | dans le modèle |
lot_size_sqft |
5057,9 | 4955,1 | 4844,4 | 4839,8 | dans le modèle |
bedrooms |
4993,4 | 4950,0 | 4885,1 | 4842,0 | 4840,8 |
| AIC du modèle courant | 5057,0 | 4955,1 | 4885,6 | 4841,4 | 4839,8 |
Comparaison des AIC
Voici ce qui se passe à chaque étape :
Étape 1 : square_feet réduit l’AIC d’environ 102 points, elle entre donc en premier. bedrooms arrive deuxième car corrélée à la taille du logement
Étape 2 : distance_km apporte la plus forte baisse. bedrooms n’aide presque plus, puisque square_feet capte déjà l’essentiel de son information
Étape 3 : age_years entre
Étape 4 : lot_size_sqft ne réduit l’AIC que de 1,6 point, mais plus bas reste plus bas, elle entre donc aussi
Étape 5 : Ajouter bedrooms ferait remonter l’AIC à 4840,8 ; la recherche s’arrête donc
Le modèle final retient square_feet, distance_km, age_years et lot_size_sqft.
C’est un résultat raisonnable. J’ai généré les données de sorte que bedrooms n’ait aucun effet direct sur le prix, et la procédure l’a écartée.
Si vous appliquez l’élimination arrière sur les mêmes données, elle part du modèle complet à 4840,8, retire bedrooms, et s’arrête sur les mêmes quatre variables. Avant et arrière ne s’accordent pas toujours, mais ici oui.
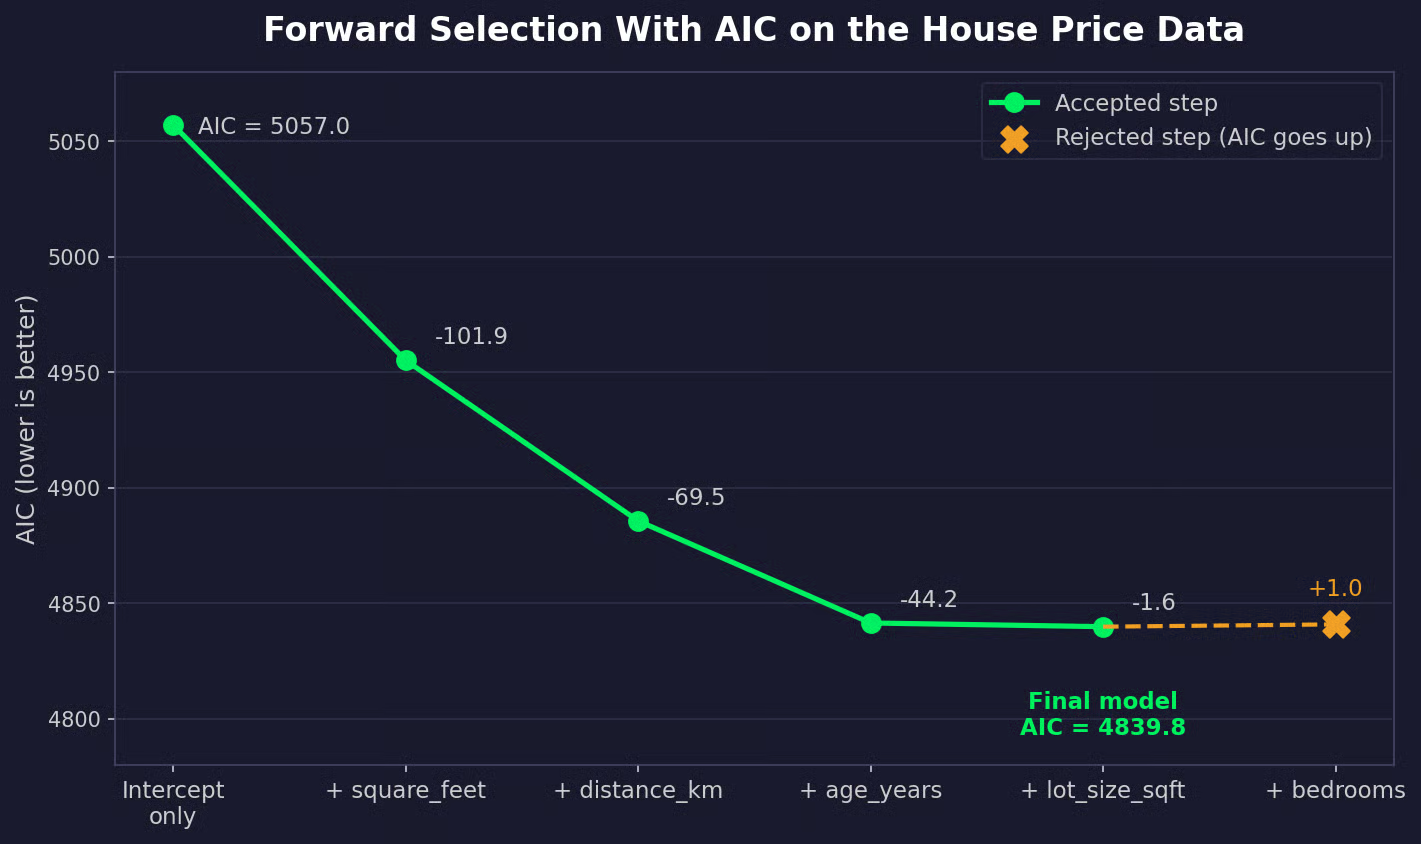
AIC du modèle courant après chaque étape de sélection avant
Le sens de la recherche détermine le comportement de l’algorithme. Le critère détermine quand il s’arrête.
C’est l’approche la plus ancienne, et elle utilise deux seuils :
Le seuil de sortie est généralement plus élevé que le seuil d’entrée pour éviter des allers-retours à chaque étape. Ces valeurs relèvent de conventions, pas de règles strictes.
Chaque p-valeur suppose que vous avez réalisé un test planifié à l’avance. La procédure pas à pas effectue une série de tests à chaque étape et retient la plus petite p-valeur. Si vous exécutez 20 tests indépendants à 0,05 sur des variables sans effet, la probabilité qu’au moins un paraisse significatif est 1 − 0.95^20, soit environ 64 %. Les variables sélectionnées paraîtront plus fortes qu’elles ne le sont vraiment ; nous verrons pourquoi dans la section sur les problèmes.
Dans l’exemple des prix immobiliers, lot_size_sqft a une p-valeur d’environ 0,063 à l’étape 4. Avec un seuil d’entrée de 0,05, la sélection avant s’arrête à trois variables.
L’Akaike information criterion équilibre ajustement et complexité :
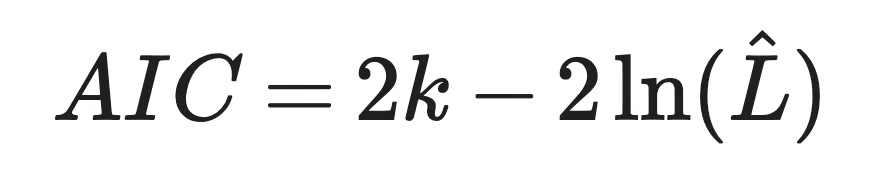
Formule de l’AIC
Ici, k est le nombre de paramètres estimés et L̂ la vraisemblance maximisée du modèle. Le second terme récompense le bon ajustement, et le premier facture 2 points par paramètre.
L’ajout d’une variable n’abaisse jamais la vraisemblance, donc la composante d’ajustement ne peut qu’améliorer. La question est : s’améliore-t-elle de plus que la pénalité de 2 points ? Pour un seul paramètre ajouté, c’est équivalent à un test du rapport de vraisemblance à un seuil de p-valeur d’environ 0,157.
C’est pourquoi lot_size_sqft passe avec l’AIC mais pas avec la règle de p-valeur à 0,05. L’AIC est plus tolérant, et a tendance à conserver des variables plus faibles qui aident la prédiction.
Le Bayesian information criterion a la même structure, avec une pénalité différente :
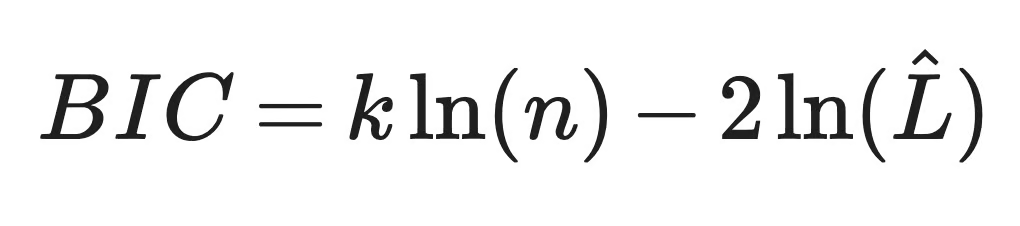
Formule du BIC
Dans cette formule, n est le nombre d’observations. Chaque paramètre coûte désormais ln(n) points au lieu de 2, de sorte que le BIC pénalise davantage la complexité dès que vous avez 8 observations ou plus. Et l’écart grandit avec la taille d’échantillon.
Avec 200 logements, ln(200) vaut environ 5,3, ce qui revient à un seuil de p-valeur implicite d’environ 0,021 pour un paramètre ajouté. La sélection avant avec BIC sur ces données s’arrête à trois variables et laisse lot_size_sqft de côté.
Le R-carré ordinaire est inutile comme critère de sélection.
Il n’augmente jamais quand on ajoute une variable dans une régression linéaire, même s’il s’agit d’une colonne de bruit aléatoire. Si vous sélectionnez au R-carré, le modèle complet gagne toujours.
Le R-carré ajusté ajoute une pénalité liée au nombre de variables :
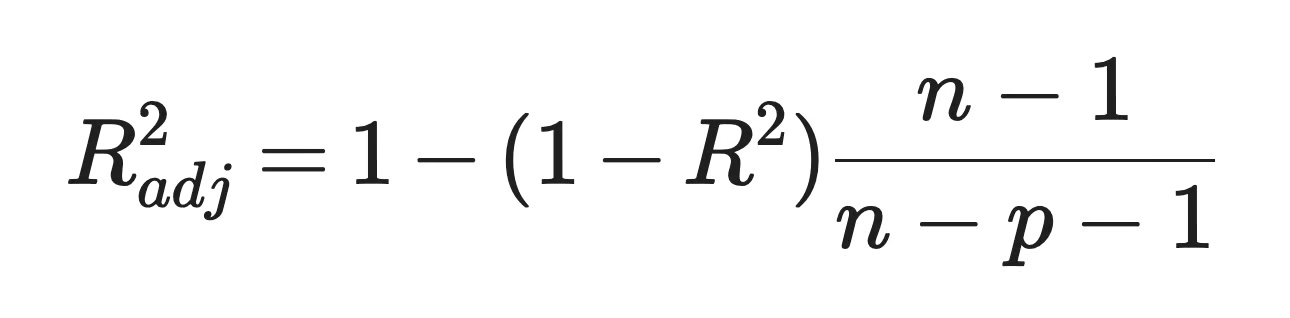
Formule du R-carré ajusté
Ici, p est le nombre de variables, et plus c’est élevé, mieux c’est. La pénalité est légère. Une nouvelle variable augmente le R-carré ajusté dès que la valeur absolue de sa statistique t dépasse 1 : c’est donc le critère le plus permissif des quatre.
Sur nos données, le R-carré ajusté conserve lot_size_sqft et rejette bedrooms à la cinquième décimale près.
Mêmes données, même recherche avant, réponses différentes :
| Critère | Modèle final |
|---|---|
| P-valeur (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| R-carré ajusté | square_feet, distance_km, age_years, lot_size_sqft |
Sélection des variables selon différents critères
Les deux langages permettent la régression pas à pas, mais différemment. J’utilise dans les deux le même jeu de données immobilières que dans l’exemple.
Python n’a pas de fonction standard de régression pas à pas.
Ni statsmodels ni scikit-learn ne proposent l’équivalent du step() de R qui sélectionne des variables via l’AIC ou des p-valeurs. L’option la plus transparente est donc d’écrire vous-même la boucle par-dessus statsmodels. Environ 25 lignes, et vous voyez chaque décision prise.
Pour être clair, la fonction forward_selection() ci-dessous est un utilitaire maison, pas une fonctionnalité de statsmodels. statsmodels se limite à ajuster les modèles et à exposer leurs attributs .aic et .bic.
Commencez par générer le jeu de données et l’enregistrer, afin que la section R utilise exactement les mêmes lignes :
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Ensuite, la boucle de sélection. Elle part du modèle à intercept seul, ajuste un modèle par candidate restante, et conserve l’ajout qui minimise le critère :
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")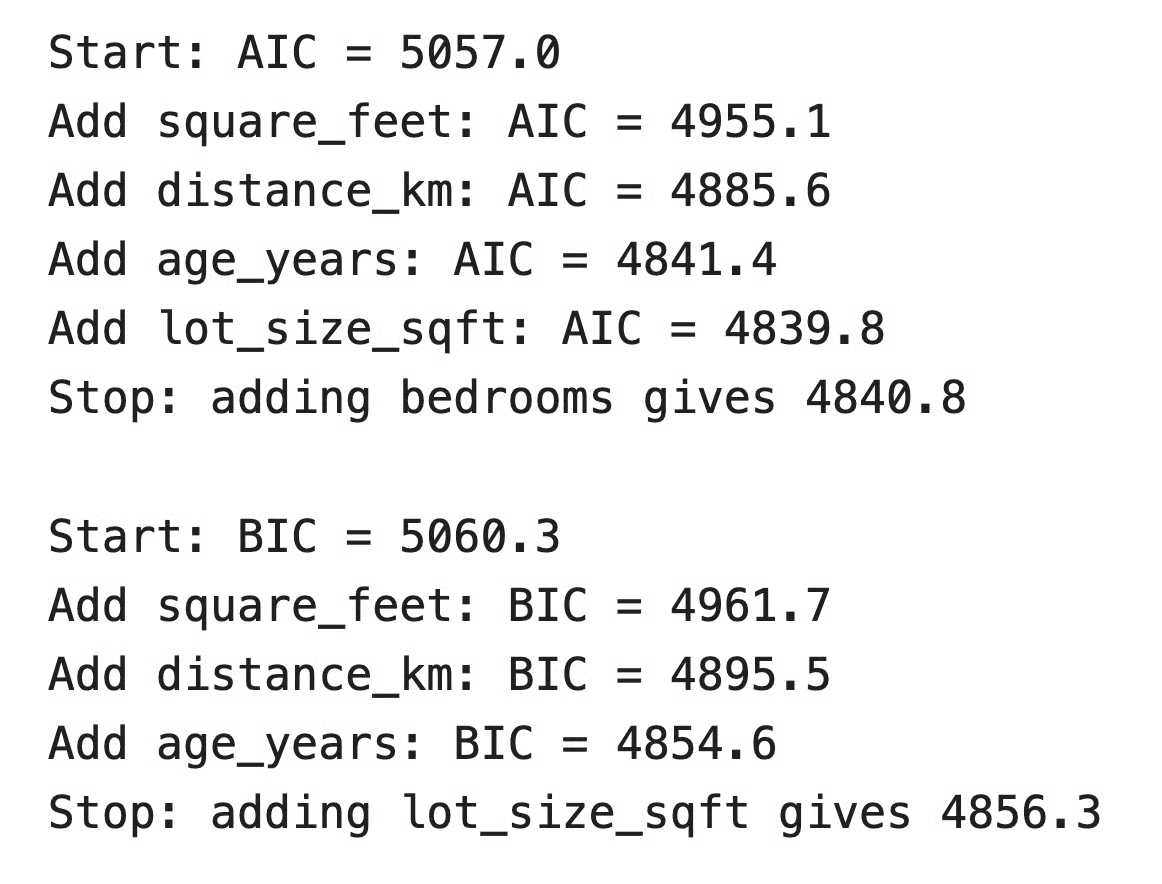
Sélection avant en Python
On retrouve les mêmes valeurs d’AIC que dans le tableau d’exemple. L’AIC retient quatre variables, et le BIC s’arrête à trois car lot_size_sqft ne franchit pas sa pénalité plus forte.
Si vous préférez un package, scikit-learn propose SequentialFeatureSelector. Il exécute une sélection avant ou arrière, mais évalue chaque candidate par validation croisée, et non via l’AIC ou des p-valeurs :
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Variables sélectionnées en Python
Avec n_features_to_select="auto", la recherche s’arrête quand le R-carré validé croisé s’améliore de moins que tol. Sur ces données, elle aboutit aux mêmes quatre variables que l’AIC.
R intègre nativement la régression pas à pas.
La fonction step() est fournie par le package stats de base, sans installation supplémentaire. Vous lui indiquez un modèle de départ, un périmètre (scope) qui définit le modèle maximal envisageable, et un sens :
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)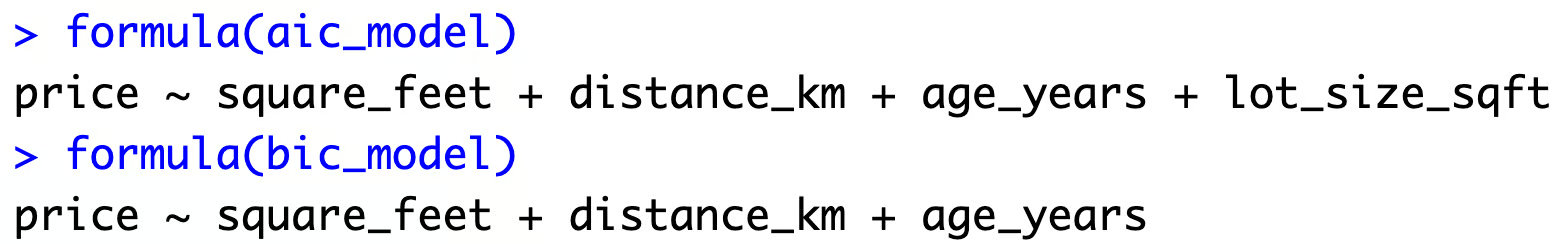
Formules AIC et BIC dans R
Le critère que step() minimise est contrôlé par un seul argument : k.
Il calcule -2 log-vraisemblance + k * edf, où edf est le nombre de coefficients estimés. Par défaut, k = 2 donne l’AIC. Si vous fixez k = log(n), vous obtenez le BIC, mais la trace affichée continue d’étiqueter les valeurs « AIC », ne vous laissez pas tromper.
Pour l’élimination arrière, partez du modèle complet :
backward_model <- step(full_model, direction = "backward")Sur ces données, il retire bedrooms et s’arrête sur les mêmes quatre variables que la sélection avant avec AIC. Si vous fournissez un scope et omettez direction, step() applique par défaut la sélection bidirectionnelle.
La régression pas à pas n’est pas la seule manière de choisir des variables. Voici sa comparaison avec trois alternatives populaires.
La régression pas à pas est une recherche gloutonne : à chaque étape, elle fait le meilleur mouvement unitaire et ne revient pas en arrière, sauf en mode bidirectionnel.
La meilleure sous-sélection ajuste toutes les combinaisons possibles et retient celle qui optimise le critère. Avec 5 variables, cela fait 32 modèles. Avec 20, plus d’un million, et avec 40, plus d’un billion. Des algorithmes comme branch-and-bound dans le package R leaps permettent d’en éviter une partie, mais le coût croît tout de même très vite avec le nombre de variables.
Sur notre jeu de données, la meilleure sous-sélection avec l’AIC retient les mêmes quatre variables que la sélection avant. Ce ne sera pas toujours le cas, gardez-le en tête.
La régression pas à pas prend des décisions oui/non. Une variable est soit dans le modèle avec son coefficient moindres carrés complet, soit dehors avec un coefficient nul.
La régression Lasso ajuste toutes les variables à la fois et ajoute une pénalité sur la somme des valeurs absolues des coefficients. Cette pénalité contracte tous les coefficients vers zéro et pousse les plus faibles à zéro, de sorte que sélection et estimation se font en une seule étape.
Une petite variation des données fait peu bouger les coefficients Lasso, alors qu’elle peut faire basculer une décision pas à pas de « dedans » à « dehors ». Vous choisissez la force de la pénalité par validation croisée, par exemple avec LassoCV dans scikit-learn ou cv.glmnet() dans R.
Ces coefficients contractés sont volontairement biaisés vers zéro. C’est un compromis pour des estimations plus stables et de meilleures prédictions hors échantillon.
L’élimination récursive de variables (RFE) ressemble à l’élimination arrière : on ajuste un modèle sur toutes les variables, on retire les plus faibles, on réajuste, et on répète.
La différence tient à la définition des « plus faibles ». L’élimination arrière utilise un critère statistique comme l’AIC ou une p-valeur. Le RFE utilise les scores d’importance propres au modèle, comme la magnitude des coefficients ou l’importance des variables dans les arbres.
RFE est donc avant tout un outil de machine learning. Il fonctionne avec tout modèle doté d’une importance de variables, y compris les forêts aléatoires et les SVM, et on l’associe généralement à la validation croisée via RFECV dans scikit-learn. Vous obtenez un ensemble de variables prédictives, mais pas de critère fondé sur la vraisemblance ni de p-valeurs.
La régression pas à pas est facile à exécuter et à expliquer. C’est précisément pourquoi ses écueils passent facilement inaperçus.
Les statisticiens la critiquent depuis des décennies : Regression Modeling Strategies de Frank Harrell et Whittingham et al. (2006) dans le Journal of Animal Ecology sont deux références. Dans un article de 2018 du Journal of Big Data, Gary Smith avance que la régression pas à pas devient moins efficace à mesure que le nombre de variables explicatives potentielles augmente : elle ne résout donc pas le problème du trop grand nombre de variables.
De petits changements dans les données peuvent modifier les variables retenues.
Si vous retirez quelques lignes ou échantillonnez à nouveau la même population, la procédure peut renvoyer un autre modèle. Les variables proches du seuil de sélection sont les plus fragiles. Une variable avec un effet réel mais faible, comme lot_size_sqft dans notre exemple, peut entrer dans un échantillon et rester dehors dans le suivant. Une variable sans effet, comme bedrooms, peut se glisser dans le modèle quand l’échantillon lui est favorable par hasard.
Problème : vous ne voyez qu’un seul échantillon. Le modèle renvoyé est un parmi une plage possible, sans indication sur l’ampleur de cette variabilité.
La procédure utilise les mêmes données pour choisir les variables et estimer leurs coefficients.
Une variable faible n’entre dans le modèle que dans les échantillons où son effet paraît, par hasard, plus fort qu’il ne l’est. Dans les échantillons où il paraît plus faible, elle reste dehors. Les coefficients observés après sélection sont donc trop grands en moyenne.
En clair, la régression pas à pas met en avant les « gagnants », et les gagnants paraissent meilleurs qu’ils ne le sont.
Les p-valeurs d’un résumé de régression supposent que vous avez choisi le modèle avant d’examiner les données.
La procédure pas à pas fait l’inverse : elle lance une série de tests, retient les variables qui passent, puis rapporte des p-valeurs comme si ces variables étaient les seules testées. Résultat : p-valeurs trop petites et intervalles de confiance trop étroits.
Le problème s’aggrave quand beaucoup de candidates n’ont aucun effet. David Freedman l’a montré en 1983 dans The American Statistician : en sélectionnant des variables purement bruitées puis en réajustant, le résultat semblait statistiquement significatif alors qu’il n’y avait rien à trouver. Smith fait le même constat : des variables parasites peuvent paraître significatives par coïncidence, tandis que des variables réelles peuvent rater le seuil.
Si vous présentez ces p-valeurs comme des preuves, vous risquez de rapporter du bruit.
Le surapprentissage est la version prédictive du même problème.
Chaque variable candidate offre une occasion supplémentaire d’ajuster un motif propre à votre échantillon. Le modèle retenu paraît bon sur les données d’entraînement, mais ces motifs ne se retrouvent pas sur de nouvelles données. Il peut donc bien s’ajuster en échantillon et mal prédire hors échantillon.
Et plus vous fournissez de variables candidates, plus l’algorithme a de chances de « trouver » des motifs inexistants.
Quand deux variables portent une information similaire, la procédure doit trancher, et de petites différences d’échantillon orientent le choix.
square_feet et bedrooms illustrent ce point modestement : une fois square_feet inclus, bedrooms n’apporte presque plus rien. Avec une corrélation plus forte, le choix devient quasi aléatoire. Un échantillon garde A, le suivant garde B, et chaque modèle raconte une histoire différente sur les facteurs explicatifs.
Aucune des deux histoires n’est fiable. La procédure ne sait pas vous dire que deux variables sont interchangeables ; elle en choisit simplement une.
La procédure prend une décision à la fois, chaque décision dépendant de la précédente.
Elle peut donc rater le meilleur modèle. Imaginons deux variables inutiles isolément mais puissantes ensemble, par exemple parce que chacune corrige le bruit de l’autre. La sélection avant ne retiendra jamais l’une ni l’autre, car aucune n’améliore seule le modèle en une étape.
L’élimination arrière et la bidirectionnelle réduisent ce risque sans l’éliminer. Aucune des trois n’explore toutes les combinaisons, aucune ne peut garantir le meilleur modèle pour le critère choisi.
La régression pas à pas est un outil pour une tâche précise.
Elle est indiquée pour :
Elle est inadaptée à l’inférence confirmatoire et à l’analyse causale.
Si votre objectif est de tester l’effet d’une variable, les p-valeurs après sélection pas à pas ne répondent pas à la question. Et si votre but est causal, l’ensemble de variables pertinent vient de la manière dont les données sont générées, pas de celles qui diminuent l’AIC. La procédure n’a aucune notion de causalité.
Pour la prédiction, il existe mieux. Les méthodes de régularisation comme Lasso et l’elastic net sont plus stables, et la sélection de variables validée par croisement évalue les modèles sur des données non vues.
Si vous décidez d’utiliser la régression pas à pas, ces étapes rendent les résultats plus honnêtes :
La régression pas à pas automatise la sélection de variables : elle ajoute ou retire une variable à la fois et s’arrête quand aucune modification n’améliore plus le modèle selon le critère choisi.
La sélection avant part d’un modèle vide et n’ajoute que. L’élimination arrière part du complet et ne retire que. La bidirectionnelle fait les deux et peut revenir sur une décision antérieure.
Mais cette simplicité a un coût : variables retenues qui changent selon l’échantillon, risque d’ajuster le bruit, p-valeurs et intervalles de confiance peu fiables après sélection. À garder à l’esprit. Traitez la régression pas à pas comme une technique parmi d’autres, pas comme votre réflexe par défaut pour construire un modèle.
Pour aller plus loin, découvrez la sélection de variables en général, voyez comment AIC et BIC comparent des modèles, et essayez la régression Lasso pour un premier pas vers la régularisation.
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
Tutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Aditya Sharma
5 min
Tutoriel
Matt Crabtree
5 min