コース
Pythonで学ぶstatsmodelsによる回帰入門
4時間
62.6K
20個の予測変数がある回帰データセットを見て、どれをモデルに入れるべきか迷ったことはありませんか?
全部入れると、シグナルだけでなくノイズにも当てはまってしまうかもしれません。手作業で選べば、同じデータを見ても分析者によって違うモデルになることがあります。言うまでもなく、予測変数が20個でも比較すべき部分集合は100万通り以上あります。
ステップワイズ回帰は、この探索を自動化します。p値やAICといった統計的基準にもとづき、予測変数を一度に1つずつ加えたり外したりします。広く教えられ使われていますが、統計的な限界もあるため、標準の特徴選択法として無条件に使うべきではありません。
この記事では、前進選択、後退消去、双方向ステップワイズ選択という3つの主要なアプローチを順に説明します。
ほかの特徴選択手法もお探しですか?初心者向けの入門記事としてPythonによる特徴選択チュートリアルをご覧ください。
ステップワイズ回帰は、回帰モデルに入れる予測変数を自動で選ぶ手続きです。
単一のモデルを当てはめるのではなく、一連の候補モデルを当てはめ、各ステップで基準にもとづいて予測変数を追加または削除します。その基準でモデルが改善しなくなったところで探索が終了します。
たとえば、顧客の年間支出額を予測したいとします。候補の予測変数が5つあります。
income
age
education
location
years_experience
ステップワイズ回帰はまずincomeから始め、つぎにageがモデルを改善するかを試し、その後にeducation……と続けます。最終的なモデルは、他の3つが基準の改善に十分寄与しなければ、incomeとeducationだけを残すかもしれません。
重要な点として、ステップワイズ回帰は独立した回帰モデルの種類ではないことを覚えておきましょう。
これは、通常は線形回帰など既知のモデルに対して実行する変数選択の手続きです。出力はあくまで通常の回帰モデルであり、ステップワイズが決めるのはそのモデルに入る予測変数だけです。
すべてのステップワイズ手続きは、同じループを辿ります。
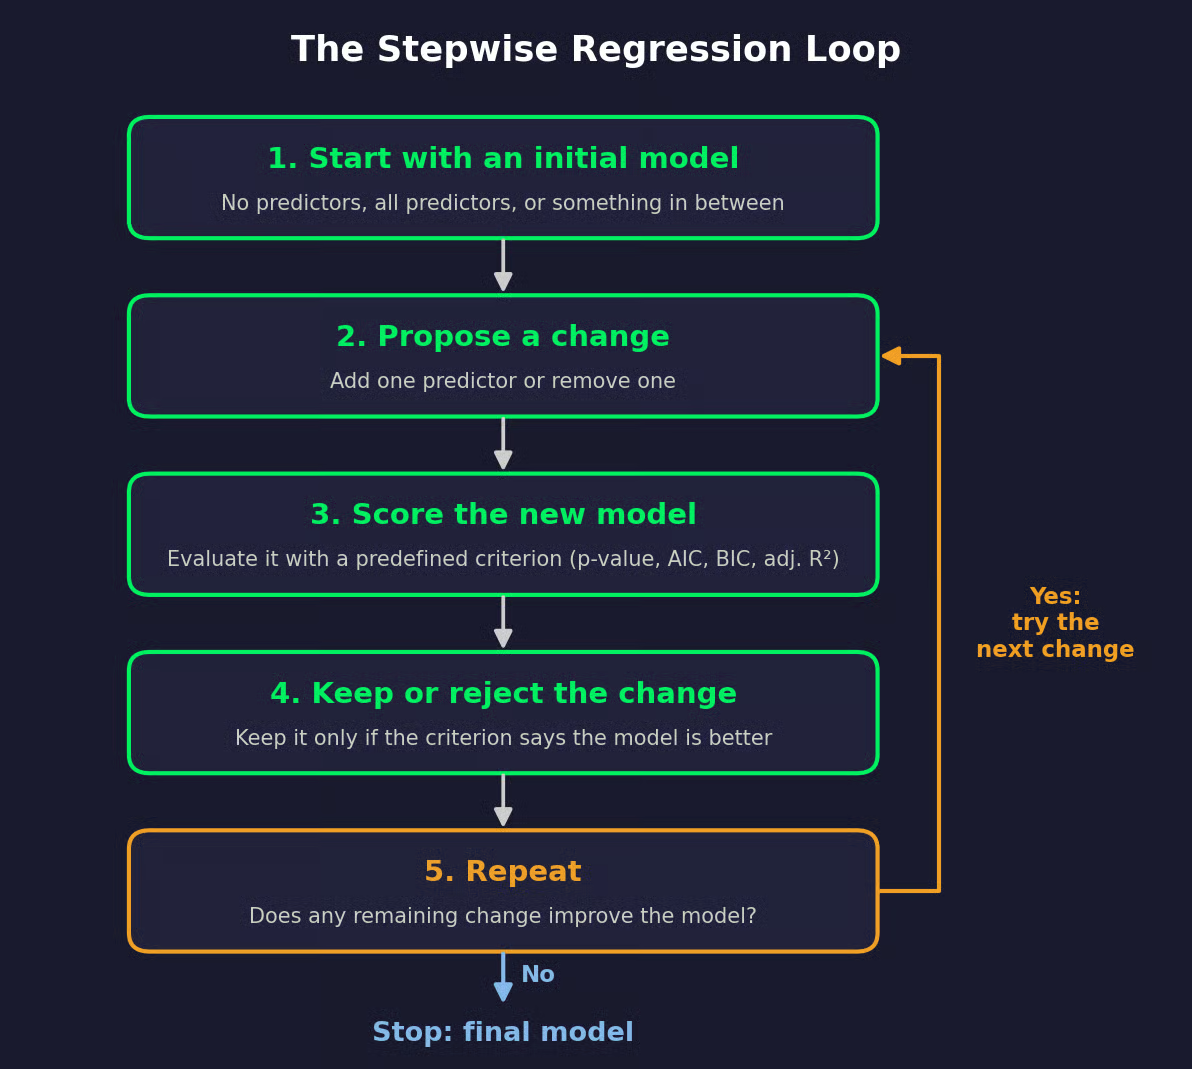
ステップワイズ回帰のループ
アルゴリズムは1手先以上を見ません。次の単一の変更が役立つかどうかだけを判断します。
どちらが「より良い」かは基準が決めます。よく使われるのは次の4つです。
具体的な手順は探索方向と基準に依存します。前進選択は追加のみ、後退消去は削除のみ、双方向選択は両方を行います。同じデータでも、選んだ基準によって最終モデルが異なることがあります。
誰かがステップワイズ回帰を実行したと言ったら、まずは方向と基準を確認しましょう。
ステップワイズ回帰には3種類あり、違いは探索の方向だけです。
前進選択は小さく始めて積み上げていきます。
切片のみのモデル、または必ず入れたい予測変数を少数含むモデルから始めます。アルゴリズムは残りの各予測変数について1つずつ候補モデルを当てはめ、それを追加したときに最も基準が改善される予測変数を採用します。
その後は、拡張されたモデルを基準に同じループを繰り返します。たとえばAICが下がらなくなった時点で停止します。
前進選択は、候補の予測変数の数が観測数を上回っていても開始できます。というのも、フルモデルを当てはめる必要がないからです。ただし、一度入った予測変数は、その後の追加で冗長になっても残り続けるのが難点です。
後退消去は逆方向に進みます。
すべての候補予測変数を含むフルモデルから始め、予測変数を1つずつ外してみて、基準を最も改善するものを落とします。その後、小さくなったモデルを当てはめ直して繰り返します。削除で基準が改善しなくなったら停止です。
この方法ではフルモデルが推定可能である必要があります。パラメータ数より多い観測が必要であり、どの予測変数も他の線形結合と厳密に一致してはなりません。予測変数が50、行が40なら、後退消去は開始すらできません。
また、前進選択の鏡像の問題もあります。いったん外れた予測変数は戻ってきません。
双方向選択は両方を組み合わせます。予測変数を追加するたびに、すでに入っている予測変数の中で外すべきものがないかを確認します。
これは、予測変数の価値がモデル内の他の変数に依存するため重要です。たとえば、bedroomsが家の広さと相関しているため先に入ったとします。その後でsquare_feetが入ると、bedroomsはほとんど情報を追加しなくなるかもしれません。双方向選択ならその時点で外せますが、前進選択だと残り続けます。
代償は、1ステップあたりのモデル当てはめ回数が増えることです。ステップは空のモデルからでもフルモデルからでも開始できます。
3つの手法の比較は次のとおりです。
| 前進選択 | 後退消去 | 双方向選択 | |
|---|---|---|---|
| 開始モデル | 切片のみ、または小さな基礎セット | 全候補を含むフルモデル | 空またはフルモデルのいずれか |
| 可能な操作 | 追加のみ | 削除のみ | 追加または削除 |
| 考慮点 | 予測変数が観測数を上回っても開始可能だが、初期の追加は再検討されない | 推定可能なフルモデルが必要で、外した変数は戻らない | 1ステップあたりの当てはめが増えるが、以前の決定を取り消せる |
ステップワイズ回帰の種類
もう少し具体的に見てみましょう。
200軒の家からなる合成データセットを作成し、priceを5つの候補予測変数から予測します。
square_feet
bedrooms
age_years
distance_km(中心部からの距離)
lot_size_sqft
基準にはAICを用いた前進選択を使います。AICは小さいほど良いという前提です。同じデータをPythonの節でも使用します。
切片のみのモデルのAICは5057.0です。各ステップでどうなるかを示します——各セルは、現在のモデルにその予測変数を追加したときのAICです。
| 候補 | ステップ1 | ステップ2 | ステップ3 | ステップ4 | ステップ5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| 現在のモデルのAIC | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
AICの比較
各ステップでの動きは次のとおりです。
ステップ1: square_feetの追加でAICが約102ポイント下がるため、最初に入ります。bedroomsは家の広さと相関しているため2番手です
ステップ2: distance_kmが最も大きく下げます。 bedroomsは、square_feetがすでに大半の情報を持っているため、ほとんど役に立たなくなりました
ステップ3: age_yearsが入ります
ステップ4: lot_size_sqftはAICを1.6ポイントしか下げませんが、下がることは下がるので採用されます
ステップ5: bedroomsを追加するとAICが4840.8に上がるため、探索は停止します
最終モデルはsquare_feet、distance_km、age_years、lot_size_sqftを使用します。
妥当な結果です。データ生成の際、bedroomsは価格に直接の効果がないようにしており、手続きはそれを外しました。
同じデータで後退消去を実行すると、4840.8のフルモデルから始まり、bedroomsを落として、同じ4つの予測変数で止まります。前進と後退が常に一致するわけではありませんが、今回は一致しました。
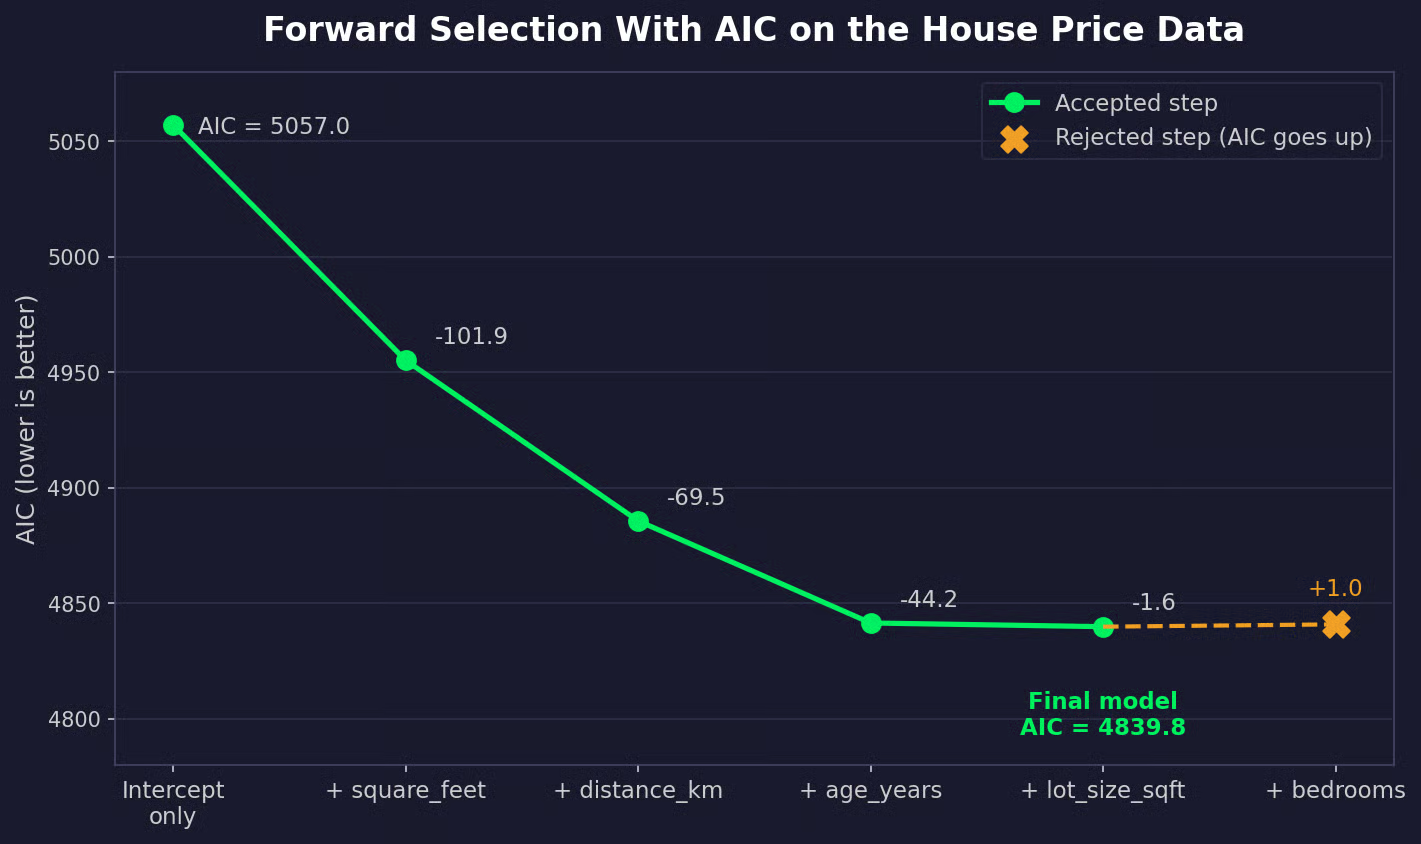
各前進選択ステップ後の現在のモデルのAIC
探索の方向がアルゴリズムの挙動を、基準が停止条件を決めます。
最も古い手法で、2つの閾値を使います。
除去閾値は通常、投入閾値より高く設定します。そうしないと、毎ステップで出たり入ったりを繰り返すからです。どちらの値も慣習であり、絶対的な規則ではありません。
各p値は、事前に計画した1つの検定を行ったことを前提にしています。ステップワイズでは毎ステップで複数の検定を行い、最小のp値を採用します。効果がまったくない予測変数で独立な検定を20回、閾値0.05で行うと、少なくとも1つが有意に見える確率は1 − 0.95^20、つまり約64%です。選ばれた予測変数は実際より強く見えます。この理由は後述の問題点で触れます。
家の価格の例では、lot_size_sqftのp値はステップ4で約0.063です。投入閾値が0.05なら、前進選択は3つの予測変数で止まります。
赤池情報量規準は、モデルの当てはまりと複雑さのバランスを取ります。
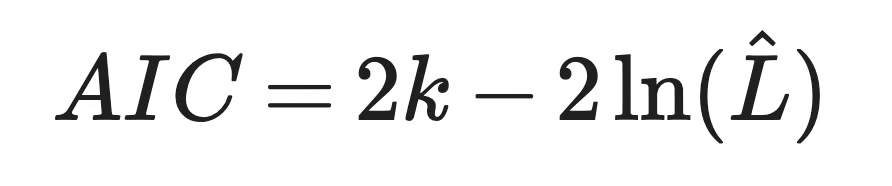
AICの式
ここでkは推定パラメータ数、L̂はモデルの最大化尤度です。第2項は当てはまりを評価し、第1項はパラメータ1つにつき2ポイントの罰則を課します。
新しい予測変数は尤度を下げないため、当てはまりは必ず良くなります。問題は、その改善が2ポイントの罰則を上回るかどうかです。1パラメータの追加では、これはp値約0.157の尤度比検定に相当します。
そのため、lot_size_sqftはAICでは採用され、p値0.05の規則では採用されません。AICはより寛容で、予測に役立つ弱い予測変数を残しがちです。
ベイズ情報量規準は、同じ構造で罰則が異なります。
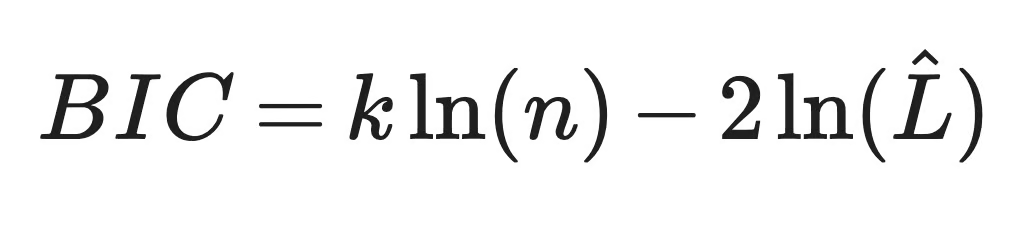
BICの式
この式ではnが観測数です。各パラメータのコストは2の代わりにln(n)となるため、観測が8以上ならBICはAICよりも複雑さを厳しく罰します。その差はサンプルサイズとともに拡大します。
200軒なら、ln(200)は約5.3で、1パラメータ追加に対する暗黙のp値閾値は約0.021に相当します。家のデータでの前進選択(BIC)では3つで止まり、lot_size_sqftは外れます。
通常の決定係数は選択基準としては役に立ちません。
線形回帰モデルに予測変数を追加しても、たとえランダムノイズの列でも、決定係数は下がりません。決定係数で選ぶと、常にフルモデルが最良になります。
調整済み決定係数は予測変数の数に対する罰則を加えます。
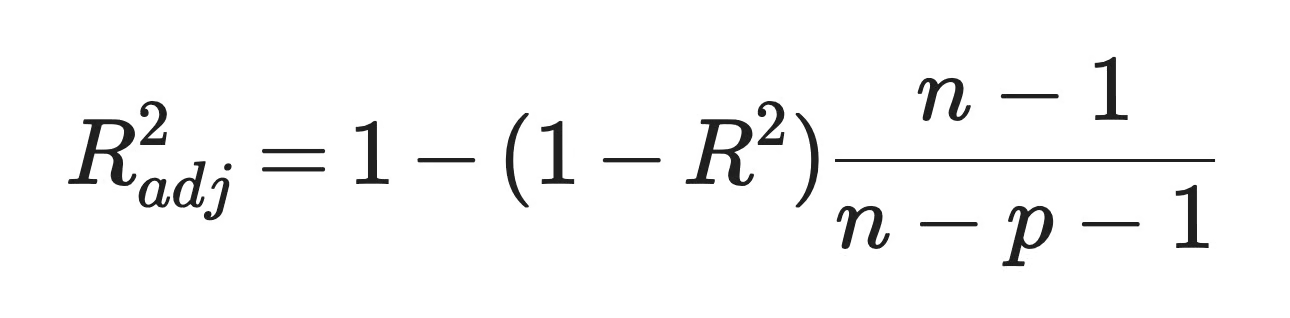
調整済み決定係数の式
ここでpは予測変数の数で、値が大きいほど良いという点は同じです。罰則は穏やかで、追加した予測変数のt統計量の絶対値が1を超えると調整済み決定係数は上がります。4つの基準の中で最も寛容です。
家のデータでは、調整済み決定係数はlot_size_sqftを採用し、bedroomsを採用しません。その差は小数第5位の僅差です。
同じデータ、同じ前進探索でも、基準が違えば答えは変わります。
| 基準 | 最終モデル |
|---|---|
| p値(0.05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| 調整済み決定係数 | square_feet, distance_km, age_years, lot_size_sqft |
異なる基準にもとづく変数選択
どちらの言語でもステップワイズ回帰は実行できますが、方法が異なります。上の例と同じ家の価格データを両方で使います。
Pythonには標準のステップワイズ回帰関数はありません。
statsmodelsにもscikit-learnにも、Rのstep()のようにAICやp値で予測変数を選ぶ機能はありません。最も分かりやすい選択肢は、statsmodelsの上に自分でループを書くことです。25行程度で書け、各判断がすべて見えます。
念のため明確にしておくと、以下のforward_selection()は筆者の補助関数であり、statsmodelsの機能ではありません。statsmodelsはモデルを当てはめ、その.aicや.bic属性を返すだけです。
まずデータセットを生成して保存し、Rの節でも全く同じ行を使えるようにします。
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
次に選択のループです。切片のみのモデルから始め、残りの各候補について1つずつモデルを当てはめ、基準値が最も低くなる追加を採用します。
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.UPPER()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")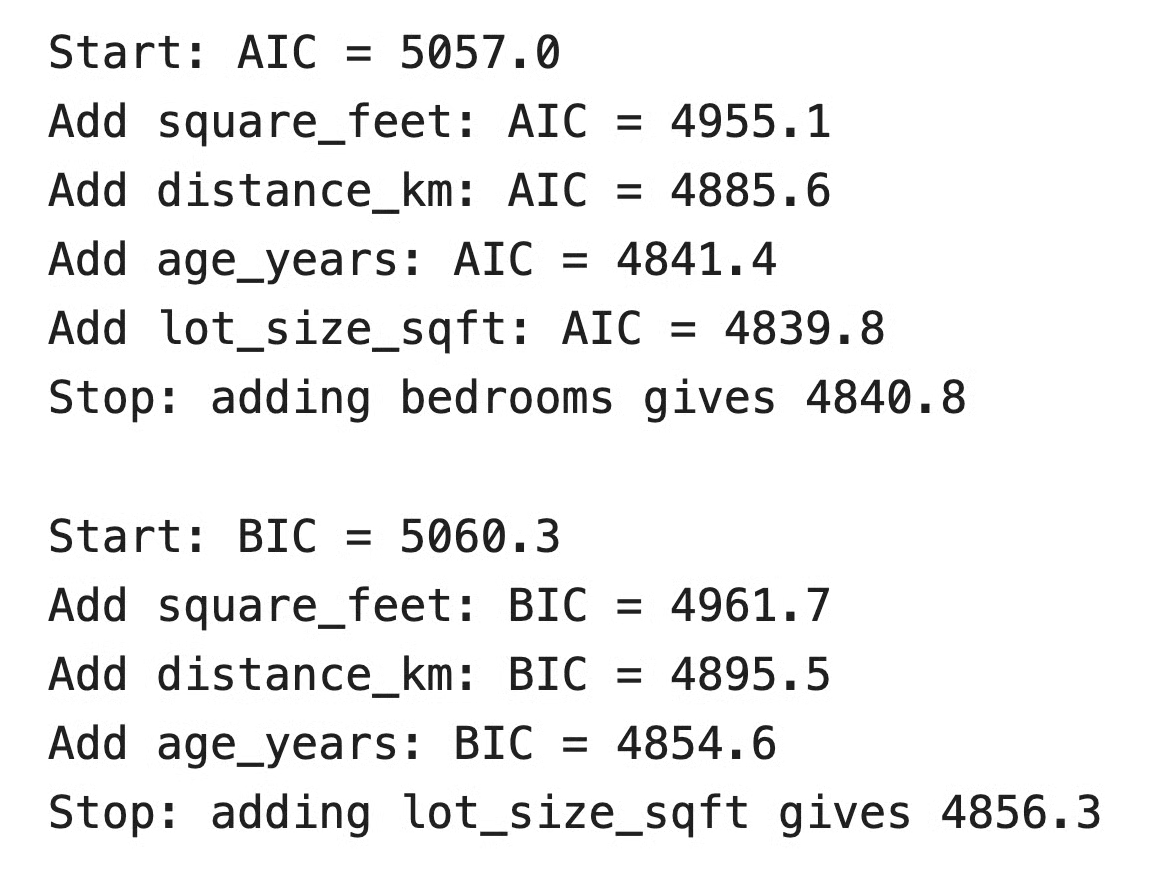
Pythonでの前進選択
このAICの値は、前述の表と同じです。AICでは4つで終了し、BICでは罰則が大きいためlot_size_sqftが採用されず、3つで止まります。
パッケージを使いたい場合は、scikit-learnのSequentialFeatureSelectorがあります。前進または後退の探索を行いますが、AICやp値ではなく、交差検証で各候補を評価します。
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Pythonで選ばれた特徴量
n_features_to_select="auto"では、交差検証の決定係数がtol未満しか改善しなくなった時点で停止します。このデータでは、AICと同じ4つで終わります。
Rにはステップワイズ回帰が標準で搭載されています。
step()関数はbase Rのstatsパッケージに含まれており、追加インストールは不要です。開始モデル、最大モデルの範囲(scope)、探索の方向を指定します。
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)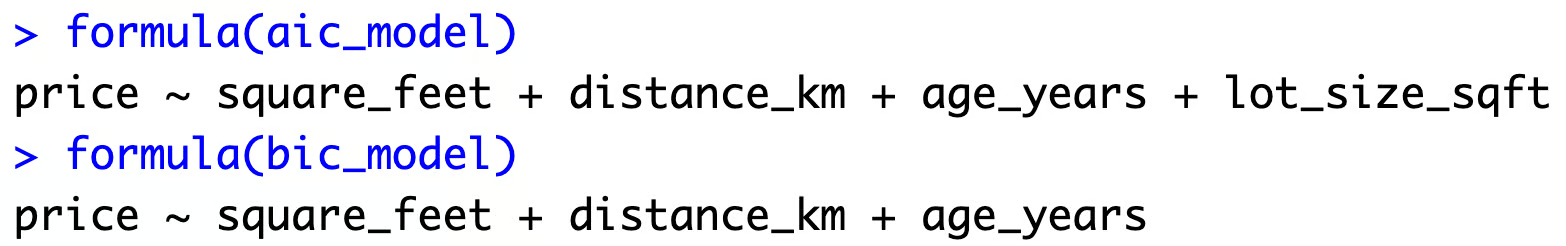
RにおけるAICとBICの式
step()が最小化する基準はkという1つの引数で制御します。
計算式は-2 log-likelihood + k * edfで、edfは推定係数の数です。デフォルトのk = 2はAICに相当します。k = log(n)にするとBICになりますが、出力のトレースではラベルが引き続き「AIC」と表示されるので混乱しないでください。
後退消去を行うには、フルモデルから始めます。
backward_model <- step(full_model, direction = "backward")このデータではbedroomsを削除し、前進AICと同じ4つで止まります。scopeを指定してdirectionを省略すると、step()は双方向選択がデフォルトになります。
予測変数の選び方はステップワイズ回帰だけではありません。ここでは3つの代表的な手法と比較します。
ステップワイズ回帰は貪欲探索です。各ステップで最善の一手を打ち、(双方向でない限り)振り返りません。
ベストサブセット選択は予測変数のすべての組み合わせを当てはめ、基準が最良のものを選びます。予測変数が5つなら32モデル、20なら100万超、40なら1兆超です。Rのleapsパッケージのbranch-and-boundのようなアルゴリズムで多くをスキップできますが、予測変数の数とともに計算量は急増します。
家の価格データでは、AICでのベストサブセット選択は前進選択と同じ4つを選びました。いつも一致するわけではないことに注意してください。
ステップワイズ回帰は二者択一の判断を行います。予測変数は、最小二乗の係数のままモデルに入るか、ゼロ係数で外れるかのどちらかです。
Lasso回帰はすべての予測変数を同時に当てはめ、絶対値和に対する罰則を加えます。この罰則により、すべての係数はゼロに向かって縮小され、最も弱いものはゼロに押し込まれます。つまり選択と推定が1ステップで行われます。
データの小さな変化はLassoの係数を少し動かすだけですが、ステップワイズでは「入る/外れる」が反転することがあります。罰則の強さは交差検証で選びます(scikit-learnのLassoCVやRのcv.glmnet()など)。
縮小された係数は、意図的にゼロ方向へバイアスされています。これは、より安定した推定や汎化性能のために受け入れるトレードオフです。
再帰的特徴量削減(RFE)は、見た目は後退消去に似ています。全特徴でモデルを当てはめ、弱いものを外し、当て直して繰り返します。
違いは「弱い」の定義です。後退消去はAICやp値などの統計的基準を使います。RFEはモデル固有の重要度(係数の大きさや木ベースの特徴重要度など)を使います。
そのため、RFEはまず機械学習の道具です。ランダムフォレストやSVMなど、特徴重要度を持つ任意のモデルで機能し、通常はscikit-learnのRFECVと組み合わせて交差検証します。尤度にもとづく基準やp値は得られませんが、予測性能の高い特徴集合を得られます。
ステップワイズ回帰は手軽に実行でき、説明もしやすい——まさにそれゆえに、問題点が見過ごされがちです。
この手法は何十年も前から統計学者の批判を受けてきました。Frank HarrellのRegression Modeling Strategiesや、Journal of Animal Ecology(2006年)のWhittinghamらが代表例です。2018年のJournal of Big Dataでは、Gary Smithが、説明変数候補が多いほどステップワイズ回帰は効果が下がると主張しており、「予測変数が多すぎる」という問題の解決にはならないと述べています。
データの小さな変化で、選ばれる予測変数が変わることがあります。
数行を削除したり、同じ母集団から新たな標本を集めたりすると、ステップワイズが返すモデルが変わることがあります。選択の閾値付近の予測変数が最も脆弱です。たとえば、家の価格例のlot_size_sqftのように、効果が小さいが実在する変数は、ある標本では入り、次の標本では入らないことがあります。bedroomsのように効果がない変数が、標本の偶然で紛れ込むこともあります。
問題は、見られる標本は常に1つだけだという点です。ステップワイズが与えるモデルは取りうるモデルの一つにすぎず、その幅は出力からはわかりません。
ステップワイズは、同じデータで予測変数の選択と係数の推定を行います。
弱い予測変数がモデルに入るのは、多くの場合、その効果が実際より強く見えた標本においてです。弱く見える標本では外れます。そのため、選択後に得られる係数は平均的に大きく出がちです。
平たく言えば、ステップワイズ回帰は勝者だけを報告し、勝者は実際より良く見えるのです。
回帰のサマリーに出るp値は、データを見る前にモデルを選んだという前提にもとづいています。
ステップワイズはその逆です。多数の検定を走らせ、通過した予測変数を残してから、あたかもそれらだけを検定したかのようにp値を報告します。そのためp値は小さく出過ぎ、信頼区間は狭く出過ぎます。
候補の多くが無効な場合、この問題はさらに悪化します。David Freedmanは1983年のThe American Statisticianでこれを示しました。純粋なノイズの予測変数をスクリーニングしてモデルを当て直すと、何もないのに統計的に有意に見えるのです。Smithも同様に、雑音変数が偶然有意になり、実在の変数が閾値を逃す可能性を指摘しています。
そうしたp値を証拠として報告すると、ノイズを報告してしまう恐れがあります。
過学習は同じ問題の予測面での現れです。
候補の予測変数が増えるたび、ステップワイズには標本内にしか存在しないパターンに適合する機会が増えます。選ばれたモデルは構築に使ったデータ上では良く見えますが、そのパターンは新しいデータでは繰り返されません。その結果、標本内では良く当てはまっても、標本外では性能が下がる可能性があります。
そして、候補が多いほど、存在しないパターンを見つける機会は増えます。
似た情報を持つ予測変数が2つあると、ステップワイズはどちらかを選ばねばならず、標本の些細な違いが選択を左右します。
square_feetとbedroomsは軽い例です。square_feetが入るとbedroomsはほとんど情報を追加しません。相関が強い場合、選択はほぼランダムになります。ある標本では変数A、次の標本では変数Bが残り、結果としてアウトカムの要因に関する物語が標本ごとに変わります。
どちらの物語も信頼できません。ステップワイズは、2つの予測変数が代替可能だと教えてはくれないので、どちらか一方を選ぶだけです。
ステップワイズは一度に1つの決定を行い、その都度、前の決定に依存します。
そのため、最良のモデルを見逃すことがあります。たとえば、単独では役に立たないが組み合わせると強力な2つの予測変数がある場合(互いのノイズを打ち消すようなケース)、前進選択はどちらも追加しません。どちらも単一ステップでは改善しないからです。
後退消去や双方向選択はこのリスクを減らしますが、なくしはしません。いずれも全組み合わせをチェックしないため、選んだ基準に対して最良のモデルを保証できません。
ステップワイズ回帰は、用途が限定された道具です。
次のような用途には適しています。
確証的な推論や因果分析には不向きです。
予測変数に効果があるか検定するのが目的なら、選択後のp値はその問いに答えられません。因果が目的なら、適切な変数集合はデータ生成過程から決まるのであって、AICを下げる変数から決まるのではありません。ステップワイズはどの変数がどれを原因するかを知りません。
予測が目的なら、より良い選択肢があります。正則化(LassoやElastic Netなど)はより安定で、交差検証を用いた特徴選択は未見データでモデルを評価します。
ステップワイズ回帰を使うなら、次の手順で結果の誠実さを高めましょう。
ステップワイズ回帰は予測変数の選択を自動化します。変数を一度に1つずつ追加・削除し、選んだ基準で改善が止まるまで続けます。
前進選択は空から始めて追加のみ。後退消去はフルモデルから始めて削除のみ。双方向選択はその両方を行い、過去の決定を取り消すこともできます。
しかし、その単純さゆえに、選ばれる予測変数は標本ごとに変わり、ノイズに当てはまる恐れがあり、選択後のp値や信頼区間は信頼できません。これを念頭に置きつつ、ステップワイズ回帰は数あるモデル選択手法の一つとして扱いましょう。回帰モデル構築のデフォルトではありません。
さらに学ぶなら、特徴選択全般を確認し、AICとBICのモデル比較を理解し、Lasso回帰から正則化に踏み出してみてください。
DataCampで学ぶ
コース
コース
コース