
Cursus
Introductie tot regressie met statsmodels in Python
4 uur
62.6K
Heb je ooit naar een regressiedataset met 20 voorspellers gekeken en je afgevraagd welke je in het model moet opnemen?
Als je ze allemaal toevoegt, past het model waarschijnlijk ook ruis in plaats van alleen het signaal. Kies je op gevoel, dan kunnen twee analisten naar dezelfde data kijken en met twee verschillende modellen komen. En het spreekt voor zich: zelfs met slechts 20 voorspellers zijn er al meer dan een miljoen mogelijke subsets om te vergelijken.
Stapsgewijze regressie automatiseert deze zoektocht door elke keer één voorspeller toe te voegen of te verwijderen op basis van een statistisch criterium, zoals een p-waarde of AIC. Het wordt veel onderwezen en gebruikt, maar kent ook statistische beperkingen, dus je moet het niet als standaardmethode voor featureselectie behandelen.
In dit artikel neem ik je mee langs de drie hoofdbenaderingen: forward selection, backward elimination en bidirectionele stapsgewijze selectie.
Op zoek naar meer technieken voor featureselectie? Lees onze Python Feature Selection Tutorial voor een toegankelijke introductie.
Stapsgewijze regressie is een geautomatiseerde procedure om te kiezen welke voorspellers in een regressiemodel komen.
Je past niet één model, maar een reeks kandidaatmodellen. Bij elke stap wordt een voorspeller toegevoegd of verwijderd op basis van een selectiecriterium. De zoektocht stopt wanneer geen enkele wijziging het model volgens dat criterium nog verbetert.
Stel dat je wilt voorspellen hoeveel een klant per jaar uitgeeft. Je hebt vijf kandidaat-voorspellers:
income
age
education
location
years_experience
Stapsgewijze regressie kan beginnen met income, vervolgens testen of age het model verbetert, dan education, enzovoort. Het uiteindelijke model kan alleen income en education behouden als de andere drie het criterium niet genoeg verbeteren.
Een belangrijk onderscheid: stapsgewijze regressie is geen apart type regressiemodel.
Het is een variabelenselectieprocedure bovenop een model dat je al kent, meestal lineaire regressie. De output is nog steeds een gewoon regressiemodel; stapsgewijs bepaalt alleen welke voorspellers erin komen.
Elke stapsgewijze procedure doorloopt dezelfde lus:
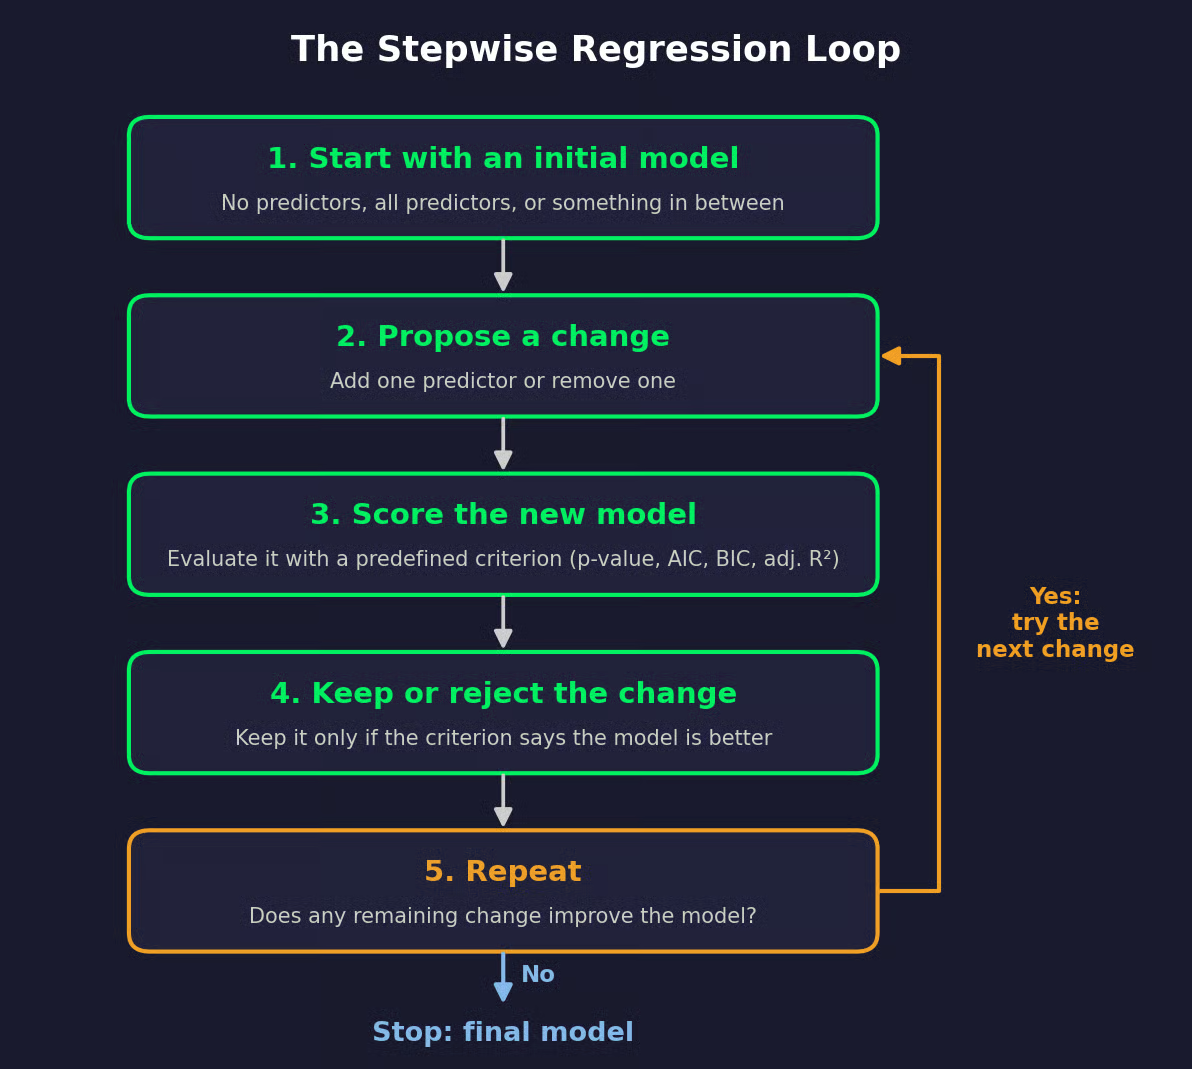
Stapsgewijze regressielus
Het algoritme kijkt nooit meer dan één stap vooruit. Het vraagt alleen of de volgende enkele wijziging helpt.
Het criterium bepaalt wat "beter" betekent. Dit zijn de vier die je het vaakst ziet:
De exacte procedure hangt af van de zoekrichting en het criterium. Forward selection voegt alleen voorspellers toe, backward elimination verwijdert ze alleen, en bidirectionele selectie doet beide. En dezelfde dataset kan verschillende eindmodellen opleveren, afhankelijk van het gekozen criterium.
Dus als iemand zegt dat hij stapsgewijze regressie heeft gedraaid, zijn de eerste twee vragen: in welke richting en met welk criterium.
Er zijn drie soorten stapsgewijze regressie, en ze verschillen in één ding: de richting van de zoektocht.
Forward selection begint klein en bouwt daarop voort.
Je start met een model met alleen een intercept, of met een paar voorspellers die je sowieso wilt opnemen. Het algoritme past vervolgens één kandidaatmodel per overgebleven voorspeller, telkens met die ene voorspeller toegevoegd. De voorspeller die het criterium het meest verbetert, komt in het model.
Daarna draait de lus opnieuw, met het grotere model als nieuwe basis. Hij stopt wanneer geen enkele overgebleven voorspeller aan de selectieregel voldoet, bijvoorbeeld wanneer geen toevoeging de AIC verlaagt.
Forward selection kan starten zelfs als je meer kandidaat-voorspellers dan observaties hebt, omdat het volledige model nooit hoeft te worden gepast. Het nadeel is dat zodra een voorspeller binnen is, hij blijft, ook als latere toevoegingen hem overbodig maken.
Backward elimination gaat de andere kant op.
Je begint met het volledige model, waarin elke kandidaat-voorspeller is opgenomen. Het algoritme probeert elke voorspeller afzonderlijk te verwijderen en laat degene vallen waarvan de verwijdering het criterium het meest verbetert. Vervolgens past het het kleinere model opnieuw en herhaalt. De zoektocht stopt wanneer geen enkele verwijdering het criterium verbetert.
Deze aanpak betekent dat het volledige model schatbaar moet zijn. Je hebt meer observaties dan parameters nodig, en geen voorspeller mag een exacte lineaire combinatie van de andere zijn. Als je 50 voorspellers en 40 rijen hebt, kan backward elimination niet eens starten.
En het heeft het spiegelbeeldige probleem van forward selection: zodra een voorspeller eruit is, blijft hij eruit.
Bidirectionele selectie combineert beide. Na elke toevoeging controleert het algoritme of een voorspeller die al in het model zit er nu uit moet.
Dat is belangrijk, omdat de waarde van een voorspeller afhangt van wat er nog meer in het model zit. Stel dat bedrooms eerst binnenkomt omdat het gecorreleerd is met de grootte van het huis. Wanneer square_feet later binnenkomt, kan bedrooms daar bijna niets meer aan toevoegen. Bidirectionele selectie kan het dan verwijderen, terwijl forward selection het zou behouden.
De prijs is meer modelaanpassingen per stap. Je kunt bidirectionele selectie starten vanuit een leeg model of een volledig model.
Zo verhouden de drie zich:
| Forward selection | Backward elimination | Bidirectional selection | |
|---|---|---|---|
| Startmodel | Alleen intercept of een kleine basisset | Volledig model met alle kandidaten | Een leeg of een volledig model |
| Toegestane bewerkingen | Alleen toevoegen | Alleen verwijderen | Toevoegen of verwijderen |
| Overwegingen | Kan starten wanneer voorspellers talrijker zijn dan observaties, maar vroege toevoegingen worden nooit herzien | Vereist een schatbaar volledig model, en verwijderde voorspellers komen niet terug | Meer modelaanpassingen per stap, maar kan eerdere beslissingen terugdraaien |
Types stapsgewijze regressies
Laten we dit tastbaarder maken.
Ik heb een synthetische dataset van 200 huizen gegenereerd en wil price voorspellen op basis van vijf kandidaat-voorspellers:
square_feet
bedrooms
age_years
distance_km (afstand tot het stadscentrum)
lot_size_sqft
Ik gebruik forward selection met AIC als criterium, waarbij een lagere AIC beter is. Je ziet dezelfde data terug in de Python-sectie.
Het model met alleen intercept heeft een AIC van 5057,0. Zo ziet elke stap eruit — elke cel toont de AIC die je krijgt door die voorspeller toe te voegen aan het huidige model:
| Kandidaat | Stap 1 | Stap 2 | Stap 3 | Stap 4 | Stap 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| Huidige model-AIC | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
AIC-vergelijking
Dit gebeurt er bij elke stap:
Stap 1: square_feet verlaagt AIC met zo'n 102 punten, dus die komt eerst binnen. bedrooms eindigt tweede omdat het gecorreleerd is met huisgrootte
Stap 2: distance_km geeft de grootste daling. bedrooms helpt nu amper, omdat square_feet het meeste van zijn informatie al bevat
Stap 3: age_years komt binnen
Stap 4: lot_size_sqft verlaagt AIC met slechts 1,6 punt, maar lager is lager, dus het komt binnen
Stap 5: bedrooms toevoegen zou AIC verhogen naar 4840,8, dus de zoektocht stopt
Het eindmodel gebruikt square_feet, distance_km, age_years en lot_size_sqft.
Dat is een redelijk resultaat. Ik heb de data zo gegenereerd dat bedrooms geen direct effect op prijs heeft, en de procedure liet het weg.
Als je op dezelfde data backward elimination draait, begint die bij het volledige model op 4840,8, laat bedrooms vallen, en eindigt bij dezelfde vier voorspellers. Forward en backward komen niet altijd overeen, maar hier wel.
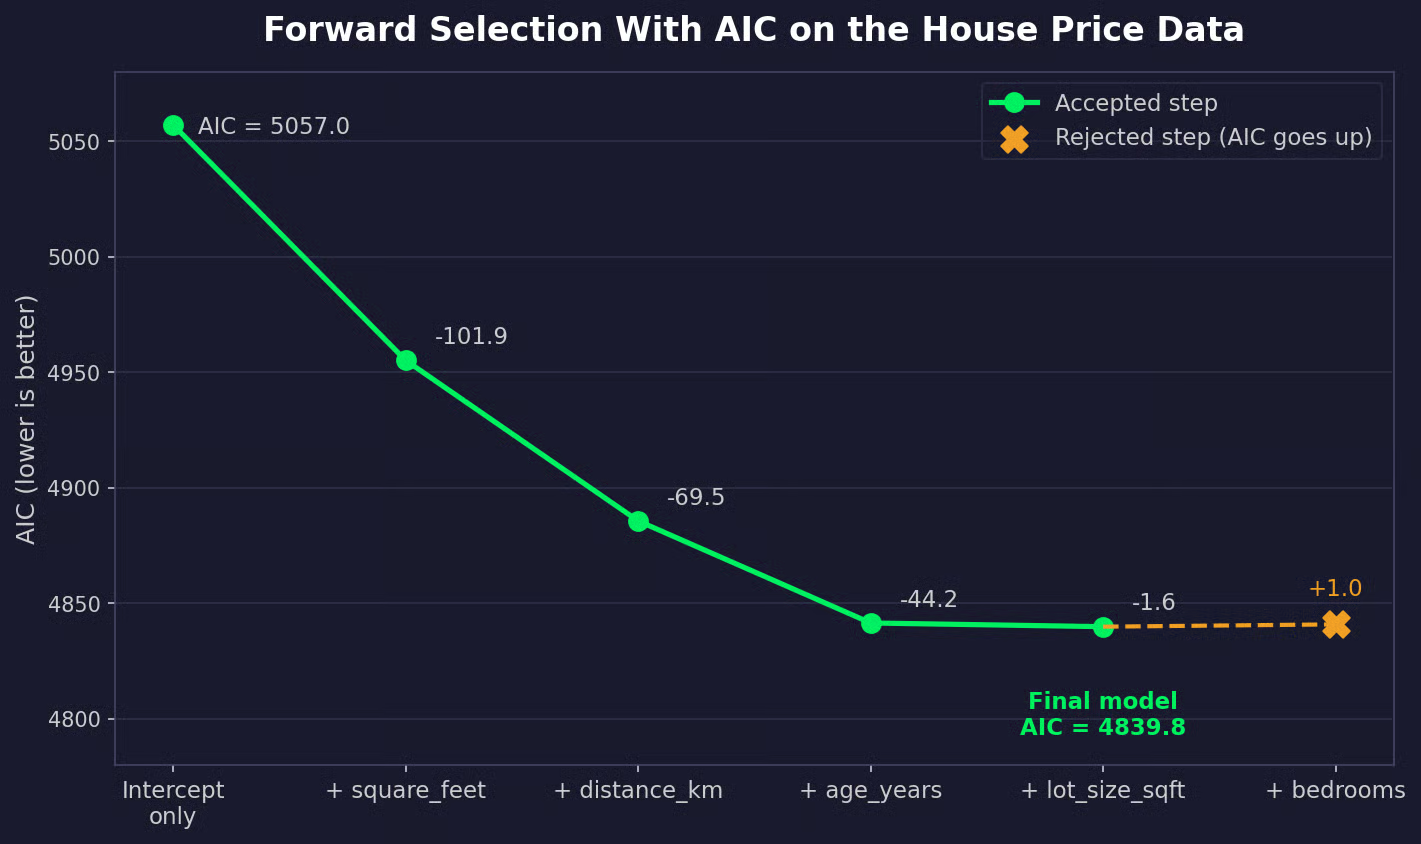
AIC van het huidige model na elke forward-stap
De zoekrichting bepaalt hoe het algoritme zich gedraagt. Het criterium bepaalt wanneer het stopt.
Dit is de oudste aanpak en gebruikt twee drempels:
De verwijderingsdrempel ligt meestal hoger dan de toetredingsdrempel, zodat een voorspeller niet bij elke stap in en uit het model gaat. Beide waarden zijn conventies, geen regels.
Elke p-waarde gaat ervan uit dat je één test uitvoerde die je van tevoren plande. Stapsgewijs voert bij elke stap een reeks tests uit en houdt de kleinste p-waarde over. Als je 20 onafhankelijke tests op 0,05 draait op voorspellers zonder effect, is de kans dat er minstens één significant lijkt 1 − 0.95^20, ongeveer 64%. De geselecteerde voorspellers lijken sterker dan ze zijn, en waarom dat zo is, behandel ik in de probleemsectie.
In het voorbeeld met huizenprijzen heeft lot_size_sqft een p-waarde van ongeveer 0,063 bij stap 4. Met een toetredingsdrempel van 0,05 stopt forward selection bij drie voorspellers.
Het Akaike-informatiecriterium balanceert model fit tegen complexiteit:
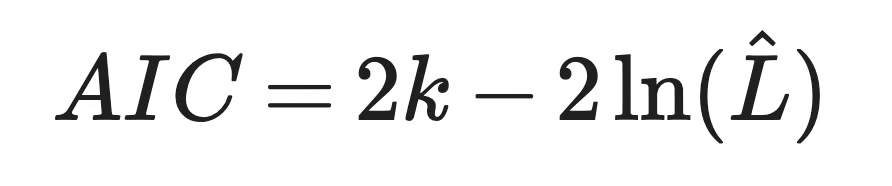
AIC-formule
Hier is k het aantal geschatte parameters en is L̂ de gemaximaliseerde likelihood van het model. De tweede term beloont fit, en de eerste term rekent 2 punten voor elke parameter.
Een nieuwe voorspeller verlaagt de likelihood nooit, dus de fit-term kan alleen verbeteren. De vraag is of die met meer dan de 2-puntenstraf verbetert. Voor één extra parameter is dat gelijk aan een likelihood-ratiotoets met een p-waardedrempel van ongeveer 0,157.
Daarom kwam lot_size_sqft er wel door bij AIC maar niet onder de 0,05 p-waarderegel. AIC is soepeler en houdt vaak zwakkere voorspellers die de voorspelling helpen.
Het Bayesiaanse informatiecriterium heeft dezelfde structuur, met een andere straf:
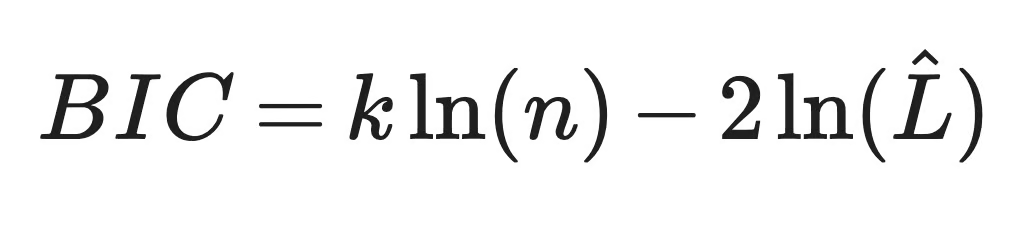
BIC-formule
In deze formule is n het aantal observaties. Elke parameter kost nu ln(n) punten in plaats van 2, dus BIC straft complexiteit meer dan AIC zodra je 8 of meer observaties hebt. En het verschil groeit met de steekproefgrootte.
Met 200 huizen is ln(200) ongeveer 5,3, wat neerkomt op een impliciete p-waardedrempel van circa 0,021 voor één toegevoegde parameter. Forward selection met BIC op de huizendata stopt bij drie voorspellers en laat lot_size_sqft buiten beschouwing.
Gewone R-kwadraat is waardeloos als selectiecriterium.
Die daalt nooit wanneer je een voorspeller toevoegt aan een lineair regressiemodel, zelfs niet een kolom pure ruis. Kies je op R-kwadraat, dan is het volledige model altijd het beste.
Aangepaste R-kwadraat voegt een straf toe voor het aantal voorspellers:
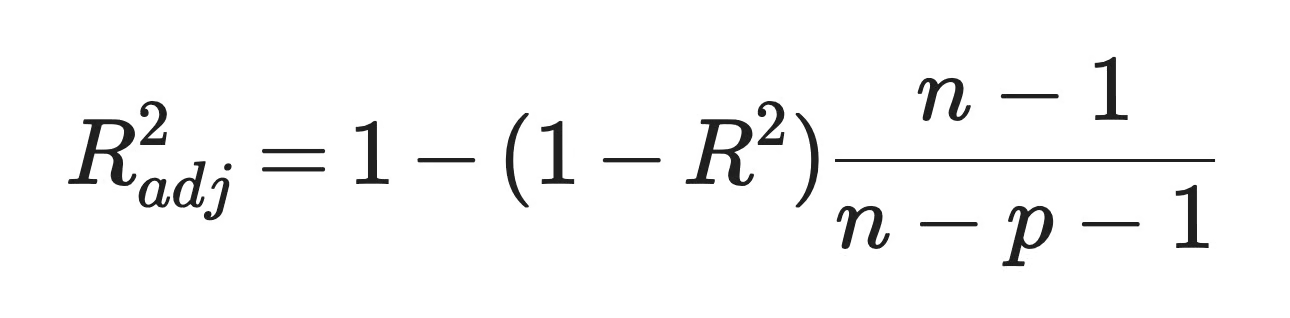
Formule voor aangepaste R-kwadraat
Hier is p het aantal voorspellers, en hogere waarden zijn beter. De straf is mild. Een nieuwe voorspeller verhoogt aangepaste R-kwadraat zodra de absolute waarde van zijn t-statistiek boven 1 komt, dus dit is het soepelste van de vier criteria.
Op de huizendata behoudt aangepaste R-kwadraat lot_size_sqft en wijst bedrooms af met een marge op de vijfde decimaal.
Dezelfde data, dezelfde forward-zoektocht, verschillende antwoorden:
| Criterium | Eindmodel |
|---|---|
| P-waarde (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| Aangepaste R-kwadraat | square_feet, distance_km, age_years, lot_size_sqft |
Variabelenselectie op basis van verschillende criteria
Beide talen kunnen stapsgewijze regressie uitvoeren, maar doen dat op verschillende manieren. Ik gebruik in beide dezelfde huizenprijsdata uit het bovenstaande voorbeeld.
Python heeft geen standaardfunctie voor stapsgewijze regressie.
Zowel statsmodels als scikit-learn hebben geen equivalent van R's step() die voorspellers selecteert op basis van AIC of p-waarden. De meest transparante optie is dus om de lus zelf te schrijven bovenop statsmodels. Het is zo'n 25 regels, en je ziet elke beslissing die wordt genomen.
Om duidelijk te zijn: de functie forward_selection() hieronder is mijn eigen helper, geen statsmodels-functie. statsmodels past alleen de modellen en rapporteert hun .aic- en .bic-attributen.
Genereer eerst de dataset en sla die op, zodat de R-sectie exact dezelfde rijen kan gebruiken:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Vervolgens de selectielus. Die start bij het model met alleen intercept, past één model per overgebleven kandidaat, en behoudt de toevoeging met de laagste criteriumwaarde:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")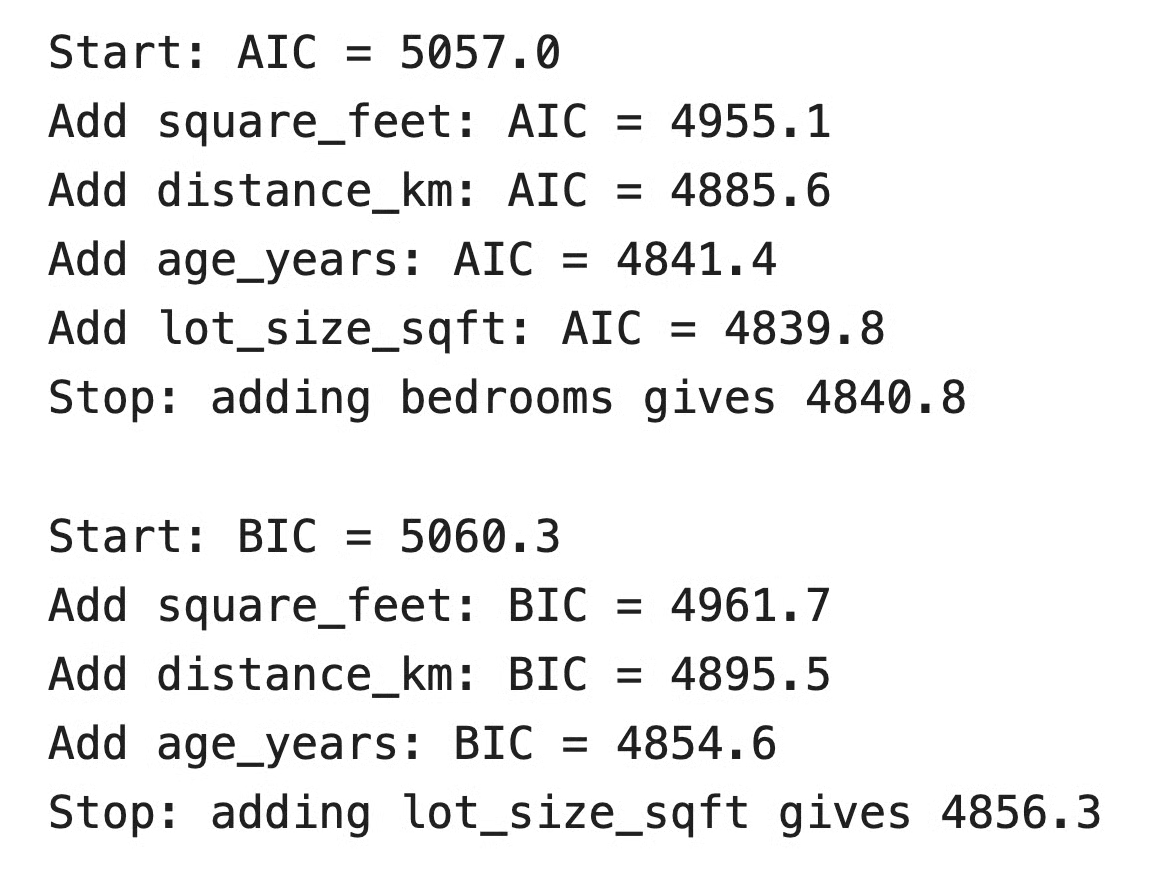
Forward selection in Python
Dit zijn dezelfde AIC-waarden als in de voorbeeldtabel. AIC eindigt met vier voorspellers, en BIC stopt bij drie omdat lot_size_sqft zijn grotere straf niet haalt.
Als je liever een pakket gebruikt, heeft scikit-learn SequentialFeatureSelector. Die voert forward of backward selection uit, maar scoort elke kandidaat met cross-validatie in plaats van AIC of p-waarden:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Geselecteerde features in Python
Met n_features_to_select="auto" stopt de zoektocht wanneer de cross-gevalideerde R-kwadraat met minder dan tol verbetert. Op deze data eindigt het met dezelfde vier voorspellers als AIC.
R heeft stapsgewijze regressie ingebouwd.
De functie step() zit in base R's stats-pakket, dus je hoeft niets te installeren. Je geeft een startmodel, een scope die het grootste model definieert dat het mag overwegen, en een richting:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)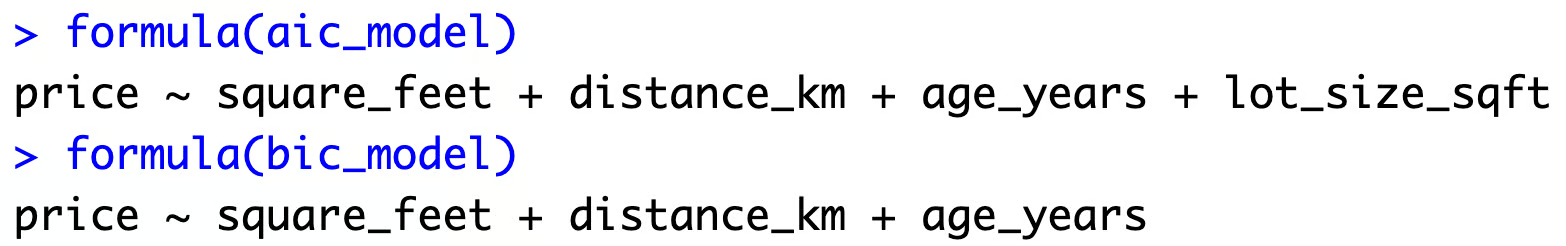
AIC- en BIC-formules in R
Het criterium dat step() minimaliseert, wordt door één argument bepaald: k.
Het berekent -2 log-likelihood + k * edf, waarbij edf het aantal geschatte coëfficiënten is. De standaard k = 2 geeft je AIC. Stel je k = log(n) in, dan krijg je BIC, maar de afdruktrace labelt de waarden nog steeds als "AIC" — laat je daar niet door verwarren.
Voor backward elimination begin je bij het volledige model:
backward_model <- step(full_model, direction = "backward")Op deze data verwijdert het bedrooms en eindigt met dezelfde vier voorspellers als forward AIC. Als je een scope meegeeft en direction weglaat, gebruikt step() standaard bidirectionele selectie.
Stapsgewijze regressie is niet de enige manier om voorspellers te kiezen. Zo verhoudt het zich tot drie populaire alternatieven.
Stapsgewijze regressie is een gulzige zoekstrategie. Bij elke stap maakt het de best ogende enkele zet en kijkt niet terug, tenzij je in beide richtingen zoekt.
Best subset selection past elke mogelijke combinatie van voorspellers en houdt degene met de beste criteriumwaarde. Met 5 voorspellers zijn dat 32 modellen. Met 20 meer dan een miljoen, en met 40 meer dan een biljoen. Algoritmen zoals branch-and-bound in R's leaps-pakket kunnen een groot deel van dat werk overslaan, maar de kosten groeien nog steeds snel met het aantal voorspellers.
Op de huizenprijsdata kiest best subset selection met AIC dezelfde vier voorspellers als forward selection. Dat is niet altijd zo, dus houd dat in gedachten.
Stapsgewijze regressie maakt ja-of-nee-beslissingen. Een voorspeller zit óf in het model met zijn volledige kleinste-kwadratencoëfficiënt, óf buiten met coëfficiënt nul.
Lasso-regressie past alle voorspellers tegelijk en voegt een straf toe op de som van absolute coëfficiëntwaarden. Die straf krimpt elke coëfficiënt richting nul en duwt de zwakste helemaal naar nul, waardoor selectie en schatting in één stap gebeuren.
Een kleine dataverandering verschuift Lasso-coëfficiënten een beetje, terwijl het een stapsgewijze beslissing van in naar uit kan doen omslaan. Je kiest de strafsterkte met cross-validatie, bijvoorbeeld met LassoCV in scikit-learn of cv.glmnet() in R.
De gekrompen coëfficiënten zijn bewust naar nul vertekend. Het is een ruil voor stabielere schattingen en betere out-of-sample voorspellingen.
Recursive feature elimination, of RFE, lijkt op backward elimination. Je past een model op alle features, verwijdert de zwakste, past opnieuw, en herhaalt.
Het verschil is wat "zwakste" betekent. Backward elimination gebruikt een statistisch criterium zoals AIC of een p-waarde. RFE gebruikt de eigen belangrijkheidsscores van het model, zoals coëfficiëntgroottes of boomgebaseerde feature-importances.
Daardoor is RFE in de eerste plaats een machinelearningtool. Het werkt met elk model dat feature importance heeft, inclusief random forests en support-vector machines, en je combineert het meestal met cross-validatie via RFECV in scikit-learn. Je krijgt een featureset die goed voorspelt, maar geen likelihood-gebaseerd criterium en geen p-waarden.
Stapsgewijze regressie is makkelijk uit te voeren en uit te leggen. Juist daarom zijn de problemen makkelijk te missen.
Statistici bekritiseren de methode al decennia — Frank Harrells Regression Modeling Strategies en Whittingham et al. (2006) in het Journal of Animal Ecology zijn twee bekende voorbeelden. In een paper uit 2018 in het Journal of Big Data betoogt Gary Smith dat stapsgewijze regressie minder effectief is naarmate het aantal potentiële verklarende variabelen groter is, dus dat het het probleem van te veel voorspellers niet oplost.
Kleine veranderingen in de data kunnen veranderen welke voorspellers je krijgt.
Als je een paar rijen verwijdert of een nieuwe steekproef uit dezelfde populatie neemt, kan stapsgewijs een ander model opleveren. Voorspellers dicht bij de selectiedrempel zijn het meest fragiel. Een voorspeller met een echt maar klein effect, zoals lot_size_sqft in het huizenvoorbeeld, kan in de ene steekproef binnenkomen en in de volgende buiten blijven. Een voorspeller zonder effect, zoals bedrooms, kan binnensluipen wanneer de steekproef toevallig in zijn voordeel uitvalt.
Dat is belangrijk, want je ziet maar één steekproef. Het model dat stapsgewijs je geeft, is één van een reeks mogelijke modellen, en de output vertelt niet hoe breed die reeks is.
Stapsgewijs gebruikt dezelfde data om voorspellers te kiezen én om hun coëfficiënten te schatten.
Een zwakke voorspeller komt vooral in het model in steekproeven waar zijn effect toevallig sterker lijkt dan het is. In steekproeven waar het zwakker lijkt, blijft het buiten. Dus de coëfficiënten die je na selectie ziet, zijn gemiddeld te groot.
Simpel gezegd: stapsgewijze regressie rapporteert de winnaars, en winnaars zien er beter uit dan ze zijn.
De p-waarden in een regressiesamenvatting gaan ervan uit dat je het model koos vóórdat je naar de data keek.
Stapsgewijs doet het omgekeerde. Het voert een reeks tests uit, houdt de voorspellers die slagen, en rapporteert daarna p-waarden alsof dat de enige waren die je ooit hebt getest. Daardoor komen de p-waarden te klein uit en de betrouwbaarheidsintervallen te smal.
Het probleem is groter wanneer veel kandidaten geen effect hebben. David Freedman liet dit zien in een paper uit 1983 in The American Statistician — toen hij pure ruisvoorspellers screenede en het model opnieuw paste, leek het resultaat statistisch significant, terwijl er niets te vinden was. Smith maakt hetzelfde punt: storingsvariabelen kunnen toevallig significant zijn, terwijl echte de drempel kunnen missen.
Als je die p-waarden als bewijs rapporteert, rapporteer je mogelijk ruis.
Overfitting is de voorspellingskant van hetzelfde probleem.
Elke kandidaat-voorspeller geeft stapsgewijs een nieuwe kans om een patroon te passen dat alleen in jouw steekproef bestaat. Het geselecteerde model ziet er goed uit op de data waarop het is opgebouwd, maar die patronen herhalen zich niet in nieuwe data. Daardoor kan het model in-sample goed passen, maar out-of-sample slecht presteren.
En hoe meer kandidaat-voorspellers je het geeft, hoe meer kansen het krijgt om niet-bestaande patronen te vinden.
Als twee voorspellers vergelijkbare informatie hebben, moet stapsgewijs ertussen kiezen, en kleine verschillen in de steekproef bepalen de keuze.
square_feet en bedrooms in de huizendata zijn een mild voorbeeld — zodra square_feet in het model zit, voegt bedrooms bijna niets meer toe. Bij sterkere correlatie wordt de keuze bijna willekeurig. De ene steekproef houdt variabele A, de volgende variabele B, en elk model vertelt een ander verhaal over wat de uitkomst drijft.
Geen van beide verhalen is betrouwbaar. Stapsgewijs kan je niet vertellen dat twee voorspellers inwisselbaar zijn, dus kiest het er gewoon één.
Stapsgewijs neemt één beslissing per keer, en elke beslissing hangt af van de voorgaande.
Dat betekent dat het het beste model kan missen. Stel dat twee voorspellers op zichzelf nutteloos zijn maar samen sterk, wat kan gebeuren als elke de ruis in de ander corrigeert. Forward selection zal geen van beide ooit toevoegen, omdat geen van beide het model in één stap verbetert.
Backward elimination en bidirectionele selectie verkleinen dit risico, maar nemen het niet weg. Geen van de drie controleert alle combinaties, dus geen ervan kan het beste model voor het gekozen criterium beloven.
Stapsgewijze regressie is een tool met een smalle taak.
Het is een goede keuze voor:
Het is de verkeerde keuze voor bevestigende inferentie en causale analyse.
Als je doel is te testen of een voorspeller effect heeft, kunnen de p-waarden na stapsgewijze selectie die vraag niet beantwoorden. En als je doel causaal is, komt de juiste set variabelen voort uit hoe de data is gegenereerd, niet uit welke variabelen AIC verlagen. Stapsgewijs weet niet welke variabele welke veroorzaakt.
Voor voorspelling heb je betere opties. Regularisatie-methoden zoals Lasso en elastic net zijn stabieler, en cross-gevalideerde featureselectie beoordeelt modellen op data die ze niet zagen.
Als je besluit stapsgewijze regressie te gebruiken, kunnen deze stappen de resultaten eerlijker maken:
Stapsgewijze regressie automatiseert de selectie van voorspellers. Het voegt of verwijdert één variabele per keer en stopt wanneer geen wijziging het model nog verbetert volgens je gekozen criterium.
Forward selection start leeg en voegt alleen toe. Backward elimination start met het volledige model en verwijdert alleen. Bidirectionele selectie doet beide en kan dus een eerdere beslissing terugdraaien.
Maar de eenvoud betekent dat de geselecteerde voorspellers per steekproef kunnen verschillen, dat het model ruis kan passen, en dat de p-waarden en betrouwbaarheidsintervallen na selectie niet betrouwbaar zijn. Houd dat in gedachten. Behandel stapsgewijze regressie als één techniek voor modelselectie. Het is niet de standaardmanier om een regressiemodel te bouwen.
Wil je verder gaan, lees dan meer over featureselectie in het algemeen, bekijk hoe AIC en BIC modellen vergelijken, en probeer Lasso-regressie als eerste stap richting regularisatie.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

