Curso
Introducción a la regresión con statsmodels en Python
4 h
62.5K
¿Alguna vez has visto un conjunto de datos de regresión con 20 predictores y te has preguntado cuáles incluir en el modelo?
Si los metes todos, el modelo probablemente ajustará ruido junto con la señal. Si eliges a mano, dos analistas pueden mirar los mismos datos y proponer dos modelos distintos. Y, por si fuera poco, incluso con solo 20 predictores hay más de un millón de posibles subconjuntos que comparar.
La regresión por pasos automatiza esa búsqueda: añade o elimina un predictor cada vez según un criterio estadístico como un valor p o el AIC. Se enseña y usa ampliamente, pero también tiene limitaciones estadísticas, así que no deberías tratarla como el método por defecto para la selección de variables.
En este artículo te explico los tres enfoques principales: selección hacia delante, eliminación hacia atrás y selección bidireccional por pasos.
¿Buscas más técnicas de selección de variables? Lee nuestro tutorial de selección de variables en Python, una introducción para principiantes al tema.
La regresión por pasos es un procedimiento automatizado para decidir qué predictores entran en un modelo de regresión.
No ajusta un único modelo, sino una secuencia de modelos candidatos y, en cada paso, añade o elimina un predictor basándose en un criterio de selección. La búsqueda termina cuando ningún cambio adicional mejora el modelo según ese criterio.
Imagina que quieres predecir cuánto gasta un cliente al año. Tienes cinco predictores candidatos:
income
age
education
location
years_experience
La regresión por pasos podría empezar con income, luego probar si age mejora el modelo, después education, y así sucesivamente. El modelo final podría quedarse solo con income y education si los otros tres no mejoran lo suficiente el criterio.
Una distinción clave: la regresión por pasos no es un tipo de modelo de regresión aparte.
Es un procedimiento de selección de variables que ejecutas sobre un modelo que ya conoces, normalmente una regresión lineal. La salida sigue siendo un modelo de regresión convencional; lo único que decide el método por pasos es qué predictores incluye.
Todo procedimiento por pasos recorre el mismo bucle:
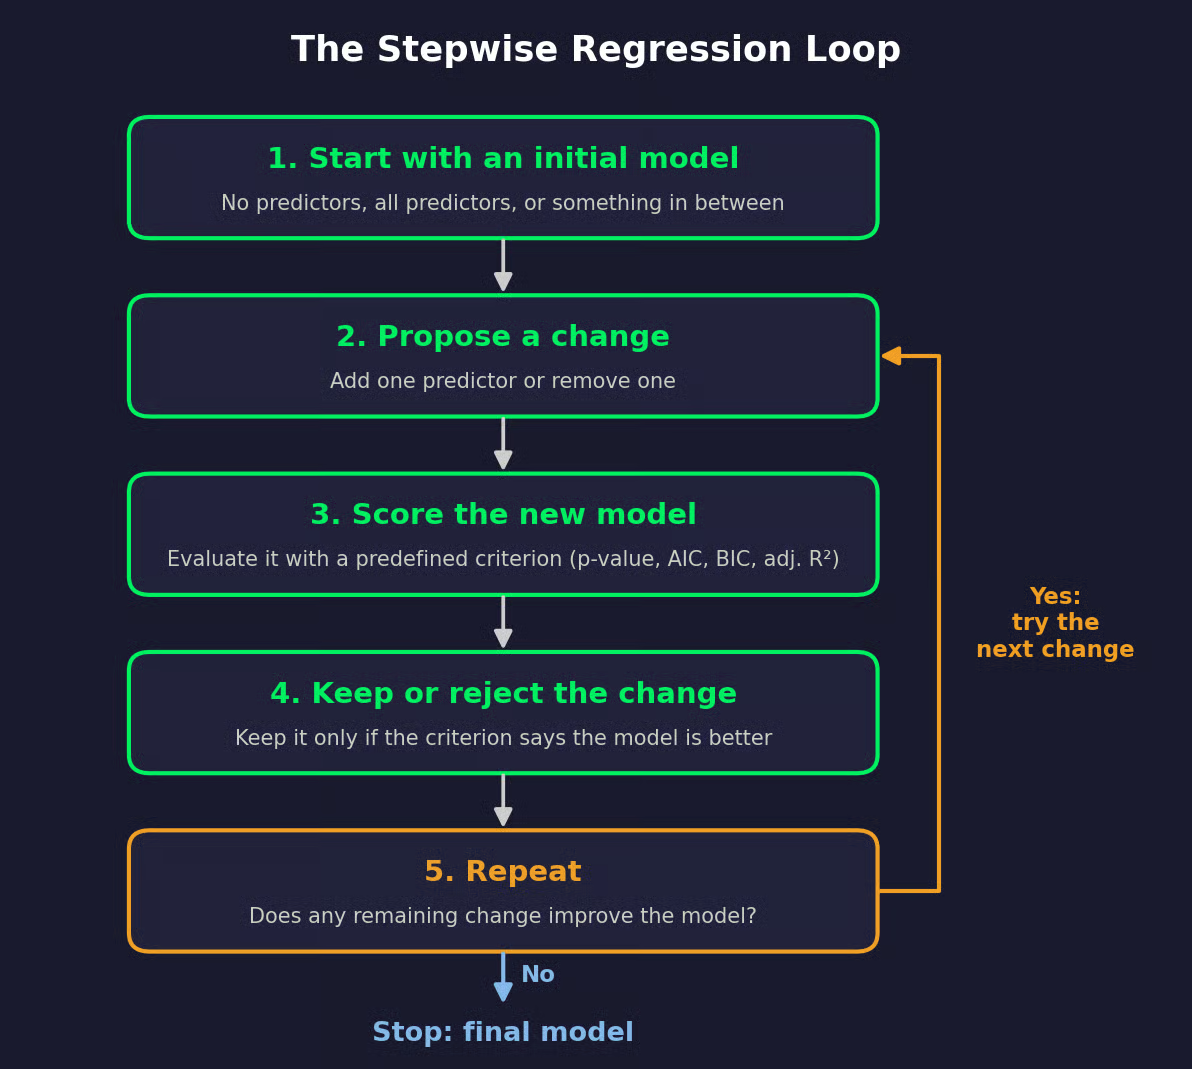
Bucle de la regresión por pasos
El algoritmo nunca mira más de un paso por delante. Solo se pregunta si el siguiente cambio individual ayuda.
El criterio decide qué significa "mejor". Estos son los cuatro más habituales:
El procedimiento exacto depende de la dirección de búsqueda y del criterio. La selección hacia delante solo añade predictores; la eliminación hacia atrás solo los elimina; y la selección bidireccional hace ambas cosas. El mismo conjunto de datos puede producir modelos finales distintos según el criterio que elijas.
Así que, cuando alguien diga que ha ejecutado una regresión por pasos, las dos primeras preguntas son: en qué dirección y con qué criterio.
Hay tres tipos de regresión por pasos y difieren en una cosa: la dirección de la búsqueda.
La selección hacia delante empieza en pequeño y va construyendo desde ahí.
Comienzas con un modelo solo con intercepto, o con un par de predictores que quieras incluir sí o sí. El algoritmo ajusta un modelo candidato por cada predictor restante, cada uno añadiendo ese único predictor. Entra en el modelo el predictor que más mejora el criterio.
Luego vuelve a ejecutar el bucle, con el modelo ampliado como nueva base. Se detiene cuando ningún predictor pendiente cumple la regla de selección, por ejemplo, cuando ninguna adición reduce el AIC.
La selección hacia delante puede empezar incluso si tienes más predictores candidatos que observaciones, porque nunca necesita ajustar el modelo completo. La pega es que, una vez que un predictor entra, se queda, aunque adiciones posteriores lo dejen redundante.
La eliminación hacia atrás va en sentido contrario.
Empiezas con el modelo completo, que incluye todos los predictores candidatos. El algoritmo intenta quitar cada predictor de uno en uno y elimina aquel cuya retirada más mejora el criterio. Después reajusta el modelo reducido y repite. La búsqueda se detiene cuando ninguna eliminación mejora el criterio.
Este enfoque exige que el modelo completo sea estimable. Necesitas más observaciones que parámetros y que ningún predictor sea combinación lineal exacta de otros. Si tienes 50 predictores y 40 filas, la eliminación hacia atrás ni siquiera puede empezar.
Y tiene el problema simétrico de la selección hacia delante: una vez que un predictor sale, no vuelve.
La selección bidireccional combina ambas. Tras cada adición, el algoritmo comprueba si algún predictor ya incluido debería salir ahora.
Esto importa porque el valor de un predictor depende de qué más hay en el modelo. Supongamos que bedrooms entra primero porque está correlacionado con el tamaño de la vivienda. Cuando más tarde entra square_feet, es posible que bedrooms aporte ya muy poco. La selección bidireccional puede eliminarlo en ese punto, mientras que la selección hacia delante lo mantendría.
El precio a pagar es realizar más ajustes de modelos por paso. Puedes iniciar la selección bidireccional desde un modelo vacío o uno completo.
Así se comparan las tres:
| Selección hacia delante | Eliminación hacia atrás | Selección bidireccional | |
|---|---|---|---|
| Modelo inicial | Solo intercepto o un conjunto base pequeño | Modelo completo con todos los candidatos | Modelo vacío o modelo completo |
| Operaciones permitidas | Solo añadir | Solo eliminar | Añadir o eliminar |
| Consideraciones | Puede empezar cuando hay más predictores que observaciones, pero no reevalúa adiciones tempranas | Requiere que el modelo completo sea estimable, y los predictores eliminados no vuelven | Más ajustes de modelos por paso, pero puede deshacer decisiones previas |
Tipos de regresión por pasos
Vamos a hacerlo más tangible.
Generé un conjunto de datos sintético de 200 viviendas y quiero predecir price a partir de cinco predictores candidatos:
square_feet
bedrooms
age_years
distance_km (distancia al centro)
lot_size_sqft
Usaré selección hacia delante con AIC como criterio, donde un AIC más bajo es mejor. Verás los mismos datos de nuevo en la sección de Python.
El modelo solo con intercepto tiene un AIC de 5057.0. Así es cada paso: cada celda muestra el AIC que obtendrías al añadir ese predictor al modelo actual:
| Candidato | Paso 1 | Paso 2 | Paso 3 | Paso 4 | Paso 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| AIC del modelo actual | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
Comparativa de AIC
Esto es lo que pasa en cada paso:
Paso 1: square_feet reduce el AIC en unos 102 puntos, así que entra primero. bedrooms queda en segundo lugar porque está correlacionado con el tamaño
Paso 2: distance_km da la mayor caída. bedrooms ahora aporta muy poco, ya que square_feet ya cubre la mayor parte de su información
Paso 3: age_years entra
Paso 4: lot_size_sqft baja el AIC solo 1,6 puntos, pero más bajo es más bajo, así que entra
Paso 5: Añadir bedrooms elevaría el AIC a 4840.8, así que la búsqueda se detiene
El modelo final usa square_feet, distance_km, age_years y lot_size_sqft.
Es un resultado razonable. Generé los datos de forma que bedrooms no tenga efecto directo en el precio, y el procedimiento lo dejó fuera.
Si ejecutas eliminación hacia atrás sobre los mismos datos, comienza en el modelo completo con 4840.8, elimina bedrooms y se queda en los mismos cuatro predictores. Hacia delante y hacia atrás no siempre coinciden, pero aquí sí.
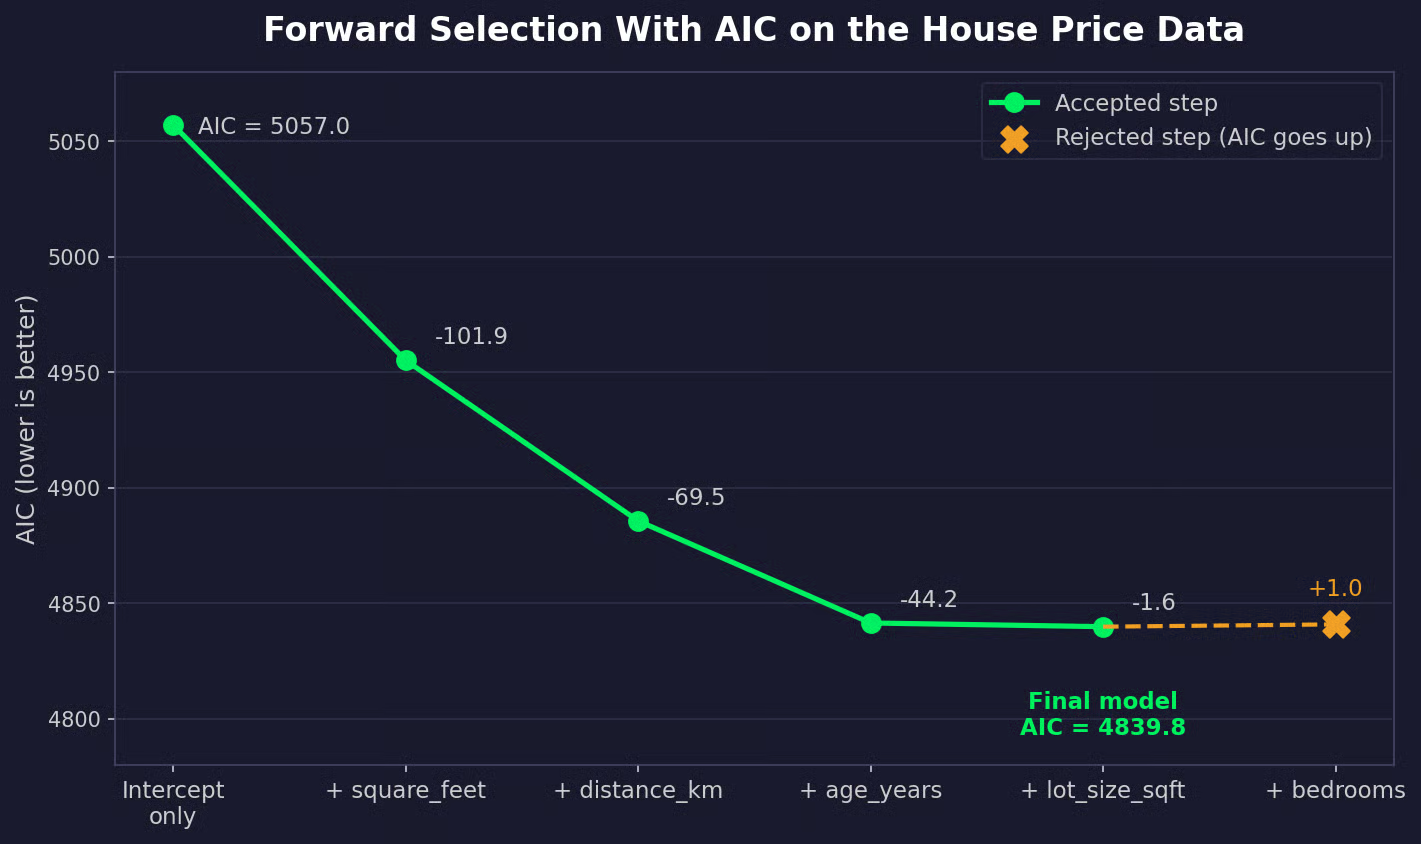
AIC del modelo actual tras cada paso de selección hacia delante
La dirección de búsqueda determina el comportamiento del algoritmo. El criterio decide cuándo se detiene.
Es el enfoque más antiguo y usa dos umbrales:
El umbral de salida suele fijarse por encima del de entrada, para que un predictor no esté entrando y saliendo en cada paso. Ambos valores son convenciones, no reglas.
Cada valor p asume que realizaste una prueba planificada de antemano. El método por pasos ejecuta un lote de pruebas en cada paso y se queda con el valor p más pequeño. Si ejecutas 20 pruebas independientes al 0,05 sobre predictores sin efecto, la probabilidad de que al menos una parezca significativa es 1 − 0.95^20, alrededor del 64%. Los predictores seleccionados parecerán más fuertes de lo que son, y más adelante explicaré por qué.
En el ejemplo de precios de vivienda, lot_size_sqft tiene un valor p de aproximadamente 0,063 en el paso 4. Con un umbral de entrada de 0,05, la selección hacia delante se detiene en tres predictores.
El criterio de información de Akaike equilibra ajuste y complejidad:
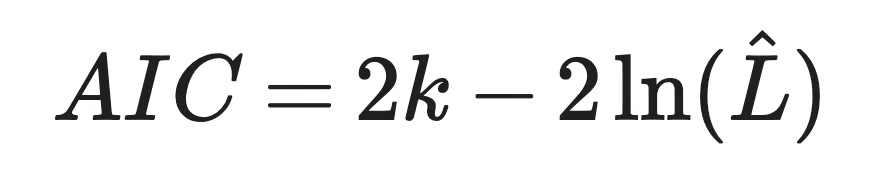
Fórmula del AIC
Aquí, k es el número de parámetros estimados y L̂ es la verosimilitud maximizada del modelo. El segundo término recompensa el ajuste y el primero cobra 2 puntos por cada parámetro.
Un nuevo predictor nunca reduce la verosimilitud, así que el término de ajuste solo puede mejorar. La cuestión es si mejora más que el cargo de 2 puntos. Para un único parámetro añadido, es equivalente a una prueba de razón de verosimilitudes con un umbral de valor p de ~0,157.
Por eso lot_size_sqft entró con AIC pero no con la regla de valor p 0,05. AIC es más laxo y tiende a mantener predictores débiles que ayudan a predecir.
El criterio de información bayesiano tiene la misma estructura, con otra penalización:
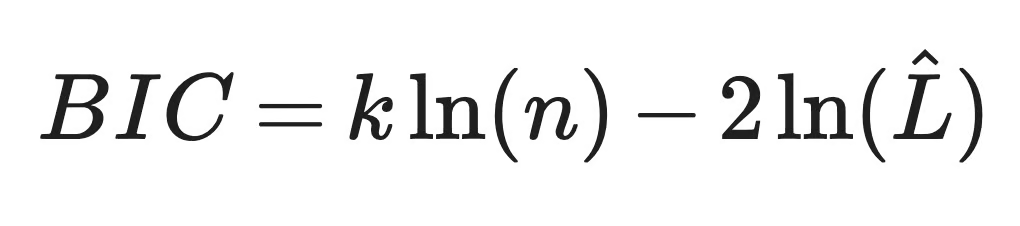
Fórmula del BIC
En esta fórmula, n es el número de observaciones. Cada parámetro ahora cuesta ln(n) puntos en vez de 2, así que BIC penaliza más la complejidad que AIC cuando tienes 8 o más observaciones. Y la diferencia crece con el tamaño de la muestra.
Con 200 viviendas, ln(200) es ~5,3, lo que equivale a un umbral de valor p implícito de ~0,021 para un parámetro añadido. La selección hacia delante con BIC en estos datos se detiene en tres predictores y deja fuera lot_size_sqft.
El R-cuadrado ordinario no sirve como criterio de selección.
Nunca disminuye al añadir un predictor a un modelo lineal, incluso si es una columna de ruido aleatorio. Si seleccionas por R-cuadrado, el modelo completo siempre es el mejor.
El R-cuadrado ajustado añade una penalización por número de predictores:
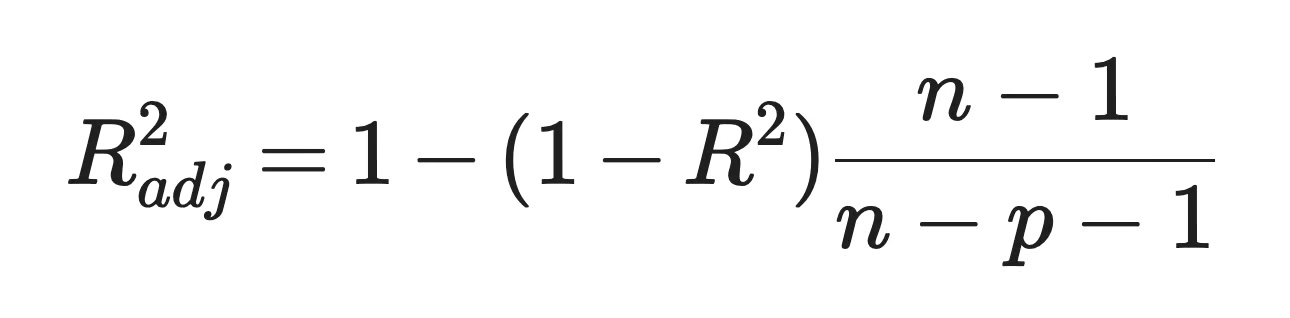
Fórmula del R-cuadrado ajustado
Aquí, p es el número de predictores, y cuanto más alto, mejor. La penalización es leve. Un nuevo predictor eleva el R-cuadrado ajustado siempre que el valor absoluto de su estadístico t sea superior a 1, por lo que es el más laxo de los cuatro criterios.
En los datos de vivienda, el R-cuadrado ajustado mantiene lot_size_sqft y rechaza bedrooms por un margen en el quinto decimal.
Mismos datos, misma búsqueda hacia delante, respuestas distintas:
| Criterio | Modelo final |
|---|---|
| Valor p (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| R-cuadrado ajustado | square_feet, distance_km, age_years, lot_size_sqft |
Selección de variables según distintos criterios
Ambos lenguajes pueden ejecutar regresión por pasos, pero lo hacen de forma distinta. Usaré en ambos los mismos datos de precios de vivienda del ejemplo anterior.
Python no tiene una función estándar de regresión por pasos.
Ni statsmodels ni scikit-learn tienen un equivalente de step() de R que seleccione predictores por AIC o valores p. Así que la opción más transparente es escribir tú mismo el bucle sobre statsmodels. Son unas 25 líneas y puedes ver cada decisión que toma.
Para que quede claro, la función forward_selection() de abajo es un ayudante propio, no una característica de statsmodels. statsmodels solo ajusta los modelos y expone sus atributos .aic y .bic.
Primero, genera el conjunto de datos y guárdalo, para que la sección de R use exactamente las mismas filas:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Después, el bucle de selección. Empieza con el modelo solo con intercepto, ajusta un modelo por cada candidato pendiente y conserva la adición con el valor del criterio más bajo:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")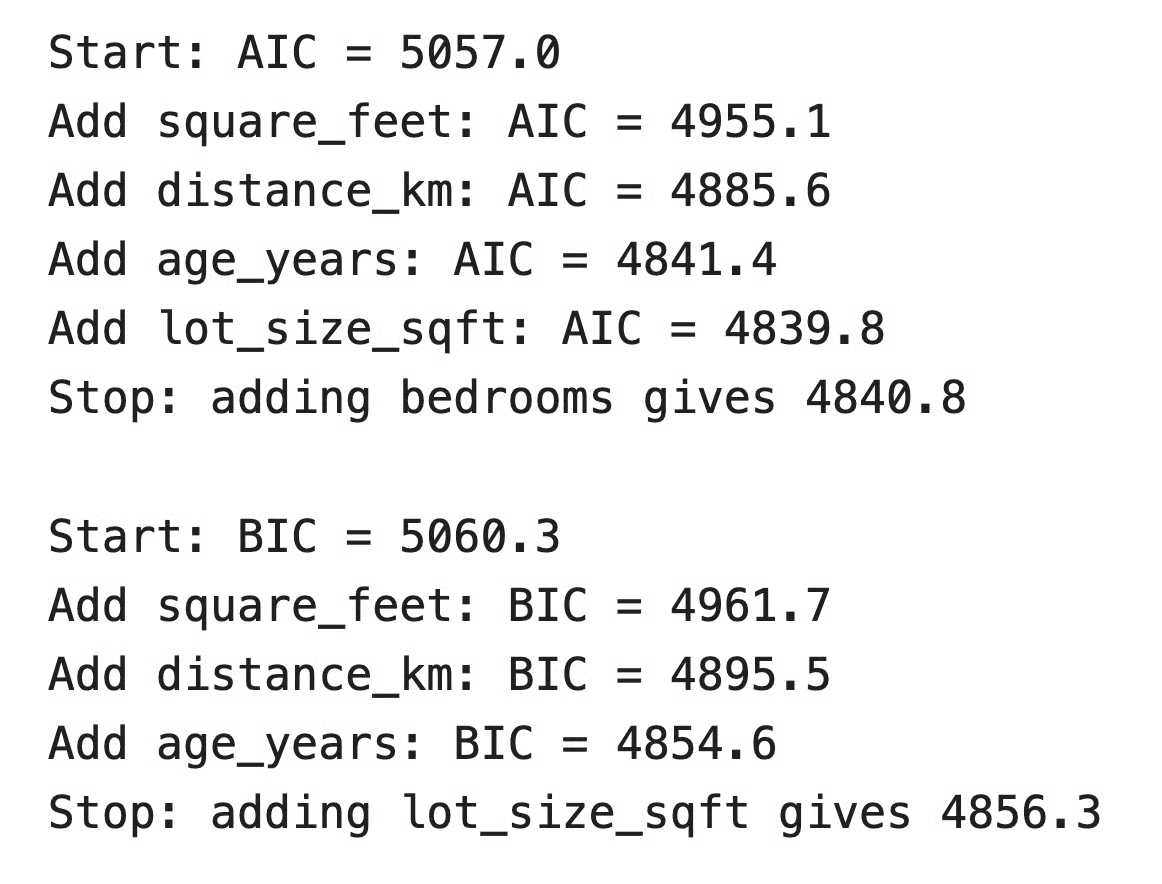
Selección hacia delante en Python
Son los mismos valores de AIC de la tabla del ejemplo. AIC termina con cuatro predictores, y BIC se detiene en tres porque lot_size_sqft no supera su penalización mayor.
Si prefieres usar un paquete, scikit-learn tiene SequentialFeatureSelector. Ejecuta selección hacia delante o hacia atrás, pero puntúa cada candidato con validación cruzada en lugar de AIC o valores p:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Características seleccionadas en Python
Con n_features_to_select="auto", la búsqueda se detiene cuando el R-cuadrado con validación cruzada mejora menos que tol. En estos datos, termina con los mismos cuatro predictores que AIC.
R incluye la regresión por pasos de serie.
La función step() viene con el paquete stats de base R, así que no hay que instalar nada. Le pasas un modelo inicial, un scope que define el mayor modelo que puede considerar y una dirección:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)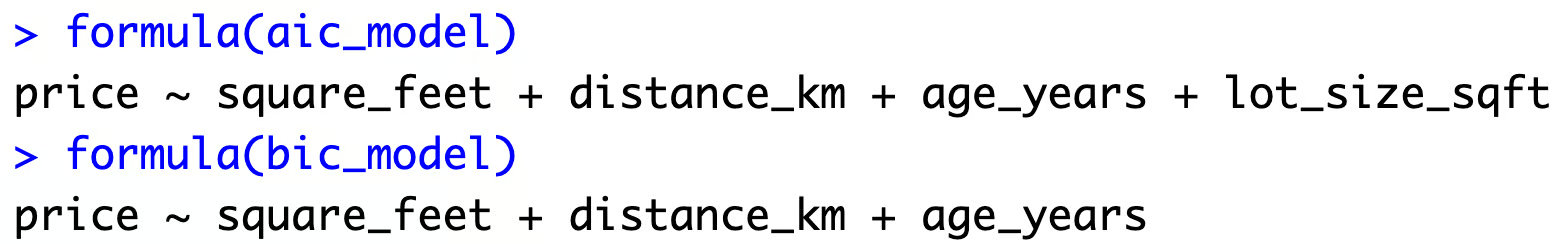
Fórmulas de AIC y BIC en R
El criterio que step() minimiza se controla con un único argumento: k.
Calcula -2 log-likelihood + k * edf, donde edf es el número de coeficientes estimados. El valor por defecto k = 2 te da AIC. Si fijas k = log(n), obtienes BIC, pero el rastro impreso sigue etiquetando los valores como "AIC", así que no te confundas.
Para la eliminación hacia atrás, empieza desde el modelo completo:
backward_model <- step(full_model, direction = "backward")Con estos datos, elimina bedrooms y termina con los mismos cuatro predictores que la selección hacia delante con AIC. Si pasas un scope y omites direction, step() hace selección bidireccional por defecto.
La regresión por pasos no es la única forma de elegir predictores. Así se compara con tres alternativas populares.
La regresión por pasos es una búsqueda codiciosa (greedy). En cada paso toma el mejor movimiento individual y no mira atrás, salvo que ejecutes la versión bidireccional.
La selección del mejor subconjunto ajusta todas las combinaciones posibles de predictores y se queda con la que tenga el mejor valor del criterio. Con 5 predictores, son 32 modelos. Con 20, más de un millón; y con 40, más de un billón. Algoritmos como branch-and-bound en el paquete leaps de R pueden saltarse gran parte del trabajo, pero el coste sigue creciendo rápido con el número de predictores.
En los datos de vivienda, la selección del mejor subconjunto con AIC elige los mismos cuatro predictores que la selección hacia delante. No siempre será así, tenlo en cuenta.
La regresión por pasos toma decisiones de sí o no. Un predictor está en el modelo con su coeficiente de mínimos cuadrados completo, o fuera con coeficiente cero.
La regresión Lasso ajusta todos los predictores a la vez y añade una penalización sobre la suma de los valores absolutos de los coeficientes. Esa penalización encoge todos los coeficientes hacia cero y empuja los más débiles exactamente a cero, así que la selección y la estimación ocurren en un solo paso.
Un pequeño cambio en los datos mueve un poco los coeficientes de Lasso, mientras que puede voltear una decisión por pasos de dentro a fuera. Eliges la fuerza de la penalización con validación cruzada, por ejemplo con LassoCV en scikit-learn o cv.glmnet() en R.
Los coeficientes encogidos están sesgados hacia cero a propósito. Es el intercambio que haces para lograr estimaciones más estables y mejores predicciones fuera de muestra.
La eliminación recursiva de características, o RFE, se parece a la eliminación hacia atrás. Ajustas un modelo con todas las variables, eliminas las más débiles, vuelves a ajustar y repites.
La diferencia es qué significa "más débiles". La eliminación hacia atrás usa un criterio estadístico como AIC o un valor p. RFE usa las puntuaciones de importancia del propio modelo, como magnitudes de coeficientes o importancias en árboles.
Eso hace que RFE sea ante todo una herramienta de machine learning. Funciona con cualquier modelo que tenga importancia de características, incluidos random forests y máquinas de vectores de soporte, y normalmente lo combinas con validación cruzada mediante RFECV en scikit-learn. Obtienes un conjunto de variables que predicen bien, pero sin criterios basados en verosimilitud ni valores p.
La regresión por pasos es fácil de ejecutar y explicar. Precisamente por eso es fácil pasar por alto sus problemas.
Estadísticos la han criticado durante décadas: Regression Modeling Strategies de Frank Harrell y Whittingham et al. (2006) en el Journal of Animal Ecology son dos ejemplos conocidos. En un artículo de 2018 en el Journal of Big Data, Gary Smith sostiene que la regresión por pasos es menos efectiva cuanto mayor es el número de variables explicativas potenciales, por lo que no resuelve el problema de tener demasiados predictores.
Pequeños cambios en los datos pueden cambiar los predictores que obtienes.
Si eliminas un par de filas o recoges una nueva muestra de la misma población, el método por pasos puede devolver un modelo distinto. Los predictores cerca del umbral de selección son los más frágiles. Un predictor con un efecto real pero pequeño, como lot_size_sqft en el ejemplo, puede entrar en una muestra y quedarse fuera en la siguiente. Un predictor sin efecto, como bedrooms, puede colarse cuando la muestra le favorece por casualidad.
Esto importa porque solo ves una muestra. El modelo que te devuelve el método por pasos es uno de un abanico de posibles modelos, y la salida no te dice cuán ancho es ese abanico.
El método por pasos usa los mismos datos para elegir predictores y para estimar sus coeficientes.
Un predictor débil entra en el modelo sobre todo en las muestras donde su efecto parece más fuerte de lo que es. En las muestras donde parece más débil, se queda fuera. Así que, en promedio, los coeficientes que ves tras la selección son demasiado grandes.
En resumen, la regresión por pasos reporta a los ganadores, y los ganadores parecen mejores de lo que son.
Los valores p en un resumen de regresión asumen que elegiste el modelo antes de mirar los datos.
El método por pasos hace lo contrario. Ejecuta un lote de pruebas, se queda con los predictores que pasan y luego informa valores p como si esos predictores fuesen los únicos que probaste. Por eso los valores p salen demasiado pequeños y los intervalos de confianza, demasiado estrechos.
El problema es peor cuando muchos candidatos no tienen efecto. David Freedman lo mostró en 1983 en The American Statistician: cuando cribó predictores de puro ruido y volvió a ajustar el modelo, el resultado parecía significativo estadísticamente aunque no había nada que encontrar. Smith hace el mismo apunte: variables de molestia pueden resultar significativas por casualidad, mientras que las reales pueden no alcanzar el umbral.
Si reportas esos valores p como evidencia, puede que estés reportando ruido.
El sobreajuste es la cara predictiva del mismo problema.
Cada predictor candidato le da al método por pasos otra oportunidad de ajustar un patrón que solo existe en tu muestra. El modelo seleccionado luce bien en los datos con los que se construyó, pero esos patrones no se repiten en datos nuevos. Como resultado, puede ajustar muy bien en muestra pero rendir mal fuera de muestra.
Y cuanto más candidatos le des, más oportunidades tendrá de encontrar patrones que no existen.
Cuando dos predictores contienen información similar, el método por pasos tiene que elegir entre ellos, y pequeñas diferencias en la muestra deciden la elección.
square_feet y bedrooms son un ejemplo suave: una vez que square_feet está en el modelo, bedrooms aporta casi nada. Con una correlación más fuerte, la elección roza lo aleatorio. Una muestra mantiene la variable A, la siguiente mantiene la B, y cada modelo cuenta una historia distinta sobre qué impulsa el resultado.
Ninguna historia es fiable. El método por pasos no puede decirte que dos predictores son intercambiables, así que simplemente elige uno.
El método por pasos toma una decisión cada vez, y cada decisión depende de las anteriores.
Eso significa que puede pasar por alto el mejor modelo. Imagina que dos predictores son inútiles por separado pero potentes juntos, algo que puede ocurrir si cada uno corrige el ruido del otro. La selección hacia delante nunca añadirá ninguno, porque ninguno mejora el modelo en un único paso.
La eliminación hacia atrás y la selección bidireccional reducen este riesgo, pero no lo eliminan. Ninguna de las tres explora todas las combinaciones, así que ninguna puede prometer el mejor modelo para el criterio elegido.
La regresión por pasos es una herramienta con un cometido concreto.
Es una buena opción para:
Es la opción equivocada para inferencia confirmatoria y análisis causal.
Si tu objetivo es probar si un predictor tiene efecto, los valores p tras la selección por pasos no pueden responder a esa pregunta. Y si tu objetivo es causal, el conjunto correcto de variables viene de cómo se generaron los datos, no de qué variables bajan el AIC. El método por pasos no sabe qué variable causa cuál.
Para predecir, tienes opciones mejores. La regularización con métodos como Lasso y elastic net es más estable, y la selección de variables con validación cruzada evalúa modelos en datos que no han visto.
Si decides usarla, estos pasos pueden hacer que los resultados sean más honestos:
La regresión por pasos automatiza la selección de predictores. Añade o elimina una variable cada vez y se detiene cuando ningún cambio mejora el modelo según tu criterio elegido.
La selección hacia delante empieza vacía y solo añade. La eliminación hacia atrás empieza con el modelo completo y solo elimina. La selección bidireccional hace ambas, por lo que puede deshacer una decisión previa.
Pero su sencillez implica que los predictores seleccionados pueden cambiar de una muestra a otra, el modelo puede ajustar ruido y los valores p e intervalos de confianza posteriores a la selección no son fiables. Tenlo en cuenta. Trata la regresión por pasos como una técnica de selección de modelos más. No es la forma predeterminada de construir un modelo de regresión.
Si quieres profundizar, lee sobre selección de variables en general, compara cómo AIC y BIC comparan modelos y prueba la regresión Lasso como primer paso hacia la regularización.
Aprende con DataCamp
Curso
Curso
Curso
blog
Javier Canales Luna
14 min
blog
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Natassha Selvaraj
11 min
Tutorial
Josef Waples
8 min