Curso
Introdução à Regressão com statsmodels em Python
4 h
62.5K
Você já olhou para um conjunto de regressão com 20 preditores e ficou na dúvida sobre quais incluir no modelo?
Se você colocar todos, o modelo provavelmente vai ajustar ruído junto com o sinal. Se escolher manualmente, dois analistas podem olhar os mesmos dados e chegar a modelos diferentes. E, nem precisa dizer, mesmo com apenas 20 preditores, há mais de um milhão de subconjuntos possíveis para comparar.
A regressão stepwise automatiza essa busca, adicionando ou removendo um preditor por vez com base em um critério estatístico, como p-valor ou AIC. Ela é bastante ensinada e usada, mas também tem limitações estatísticas — então não trate como método padrão de seleção de variáveis.
Neste artigo, vou mostrar os três principais caminhos: seleção forward, eliminação backward e seleção stepwise bidirecional.
Quer mais técnicas de seleção de variáveis? Leia nosso tutorial de seleção de features em Python para uma introdução amigável ao tema.
Regressão stepwise é um procedimento automatizado para escolher quais preditores entram em um modelo de regressão.
Ela não ajusta um único modelo, e sim uma sequência de modelos candidatos, e a cada passo adiciona ou remove um preditor com base em um critério de seleção. A busca termina quando nenhuma mudança adicional melhora o modelo segundo esse critério.
Imagine que você quer prever quanto um cliente gasta por ano. Você tem cinco preditores candidatos:
income
age
education
location
years_experience
A regressão stepwise pode começar com income, depois testar se age melhora o modelo, depois education e assim por diante. O modelo final pode manter apenas income e education se os outros três não melhorarem o critério o suficiente.
Uma distinção importante: regressão stepwise não é um tipo separado de modelo de regressão.
É um procedimento de seleção de variáveis aplicado sobre um modelo que você já conhece, geralmente a regressão linear. O resultado continua sendo um modelo de regressão comum; o stepwise apenas decide quais preditores entram.
Todo procedimento stepwise passa pelo mesmo loop:
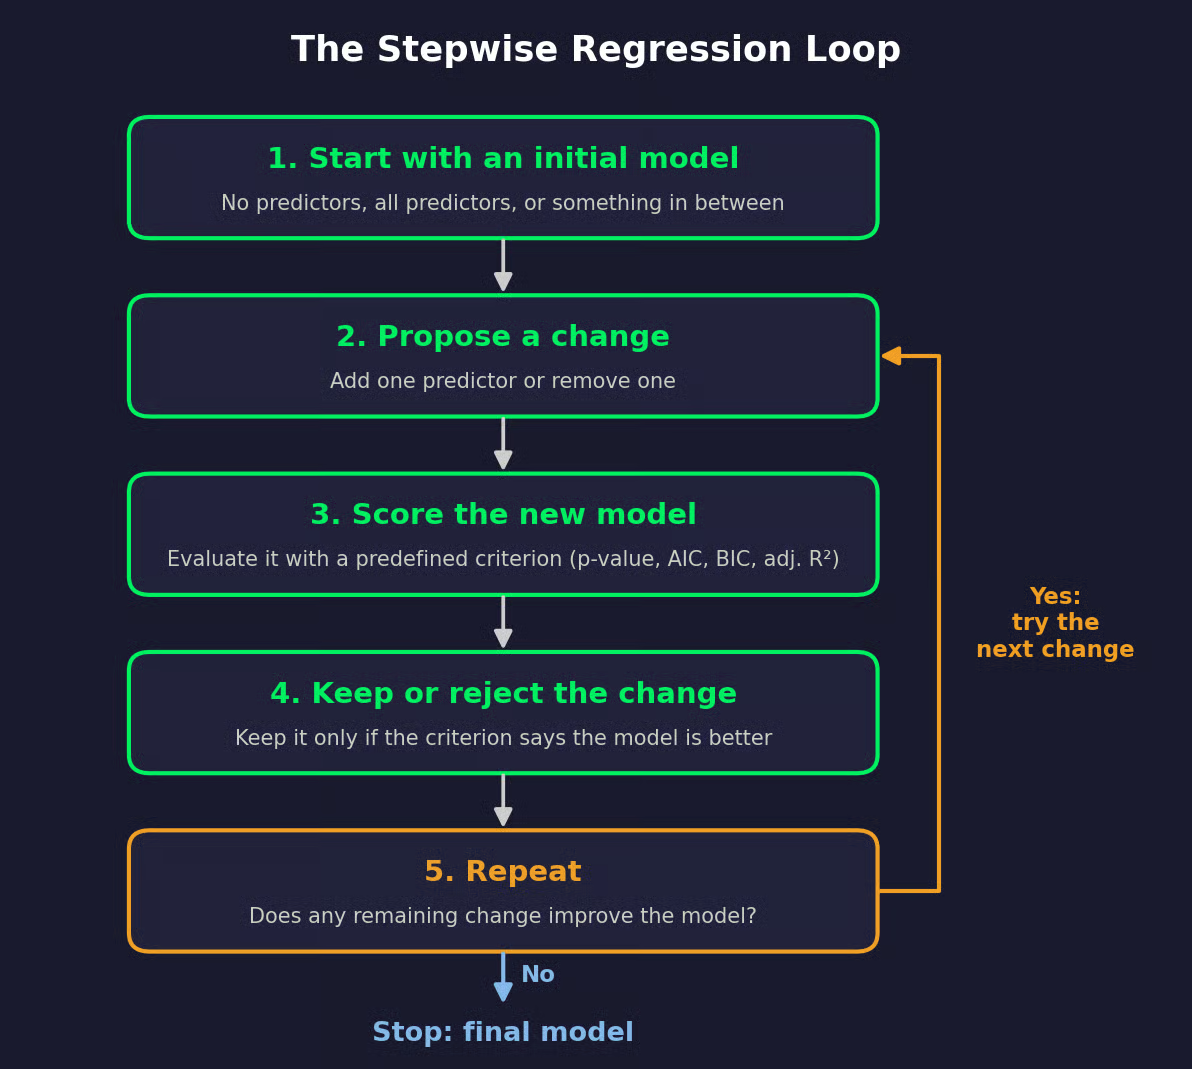
Loop da regressão stepwise
O algoritmo nunca olha mais de um passo à frente. Ele só pergunta se a próxima mudança única ajuda.
O critério decide o que significa "melhor". Estes são os quatro mais comuns:
O procedimento exato depende da direção da busca e do critério. A seleção forward só adiciona preditores, a eliminação backward só remove, e a seleção bidirecional faz ambos. E o mesmo conjunto de dados pode produzir modelos finais diferentes dependendo do critério escolhido.
Então, quando alguém diz que rodou regressão stepwise, as duas primeiras perguntas são: qual direção e qual critério.
Há três tipos de regressão stepwise, e a diferença está na direção da busca.
A seleção forward começa pequena e vai construindo a partir daí.
Você inicia com um modelo apenas com intercepto, ou com alguns preditores que você quer manter de qualquer forma. O algoritmo então ajusta um modelo candidato por preditor restante, cada um com aquele preditor adicionado. O preditor que mais melhora o critério entra no modelo.
O loop roda de novo, agora com o modelo maior como base. Ele para quando nenhum preditor restante atende à regra de seleção, por exemplo, quando nenhuma adição reduz o AIC.
A seleção forward pode começar mesmo quando você tem mais preditores do que observações, porque nunca precisa ajustar o modelo completo. O porém é que, uma vez que um preditor entra, ele fica, mesmo que adições posteriores o tornem redundante.
A eliminação backward vai no sentido oposto.
Você começa com o modelo completo, que inclui todos os preditores candidatos. O algoritmo tenta remover cada preditor um por vez e elimina aquele cuja saída mais melhora o critério. Depois reajusta o modelo menor e repete. A busca para quando nenhuma remoção melhora o critério.
Essa abordagem exige que o modelo completo seja estimável. Você precisa de mais observações do que parâmetros, e nenhum preditor pode ser combinação linear exata dos outros. Se você tem 50 preditores e 40 linhas, a eliminação backward nem consegue começar.
E ela tem o problema espelhado da seleção forward: uma vez que um preditor sai, ele não volta.
A seleção bidirecional combina as duas. Após cada adição, o algoritmo verifica se algum preditor que já está no modelo agora deveria sair.
Isso importa porque o valor de um preditor depende do que mais está no modelo. Suponha que bedrooms entre primeiro porque está correlacionado com o tamanho da casa. Quando square_feet entrar depois, bedrooms pode acrescentar quase nada. A seleção bidirecional pode removê-lo nesse ponto, enquanto a seleção forward o manteria.
O preço é fazer mais ajustes de modelo por passo. Você pode iniciar a seleção bidirecional de um modelo vazio ou completo.
Veja a comparação entre as três:
| Seleção forward | Eliminação backward | Seleção bidirecional | |
|---|---|---|---|
| Modelo inicial | Apenas intercepto ou um conjunto base pequeno | Modelo completo com todos os candidatos | Modelo vazio ou completo |
| Operações permitidas | Apenas adicionar | Apenas remover | Adicionar ou remover |
| Observações | Pode começar quando há mais preditores do que observações, mas adições iniciais não são revisadas | Precisa que o modelo completo seja estimável, e preditores removidos não voltam | Mais ajustes por passo, mas pode desfazer decisões anteriores |
Tipos de regressão stepwise
Vamos deixar isso mais concreto.
Gerei um conjunto sintético com 200 casas e quero prever price a partir de cinco preditores candidatos:
square_feet
bedrooms
age_years
distance_km (distância do centro)
lot_size_sqft
Vou usar seleção forward com AIC como critério, onde menor AIC é melhor. Você vai ver os mesmos dados novamente na seção de Python.
O modelo apenas com intercepto tem AIC de 5057,0. Veja como cada etapa fica — cada célula mostra o AIC ao adicionar aquele preditor ao modelo atual:
| Candidato | Etapa 1 | Etapa 2 | Etapa 3 | Etapa 4 | Etapa 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | in model | in model | in model | in model |
distance_km |
5020.3 | 4855.6 | in model | in model | in model |
age_years |
5050.2 | 4926.4 | 4841.4 | in model | in model |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | in model |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| AIC do modelo atual | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
Comparação de AIC
O que acontece em cada etapa:
Etapa 1: square_feet reduz o AIC em cerca de 102 pontos, então entra primeiro. bedrooms fica em segundo lugar por estar correlacionado com o tamanho
Etapa 2: distance_km dá a maior queda. bedrooms agora quase não ajuda, já que square_feet já carrega a maior parte da sua informação
Etapa 3: age_years entra
Etapa 4: lot_size_sqft reduz o AIC em apenas 1,6 ponto, mas menor é menor, então entra
Etapa 5: Adicionar bedrooms elevaria o AIC para 4840,8, então a busca para
O modelo final usa square_feet, distance_km, age_years e lot_size_sqft.
É um resultado razoável. Eu gerei os dados de forma que bedrooms não tenha efeito direto no preço, e o procedimento o deixou de fora.
Se você rodar eliminação backward nos mesmos dados, ela começa do modelo completo em 4840,8, remove bedrooms e termina com os mesmos quatro preditores. Forward e backward nem sempre concordam, mas aqui concordam.
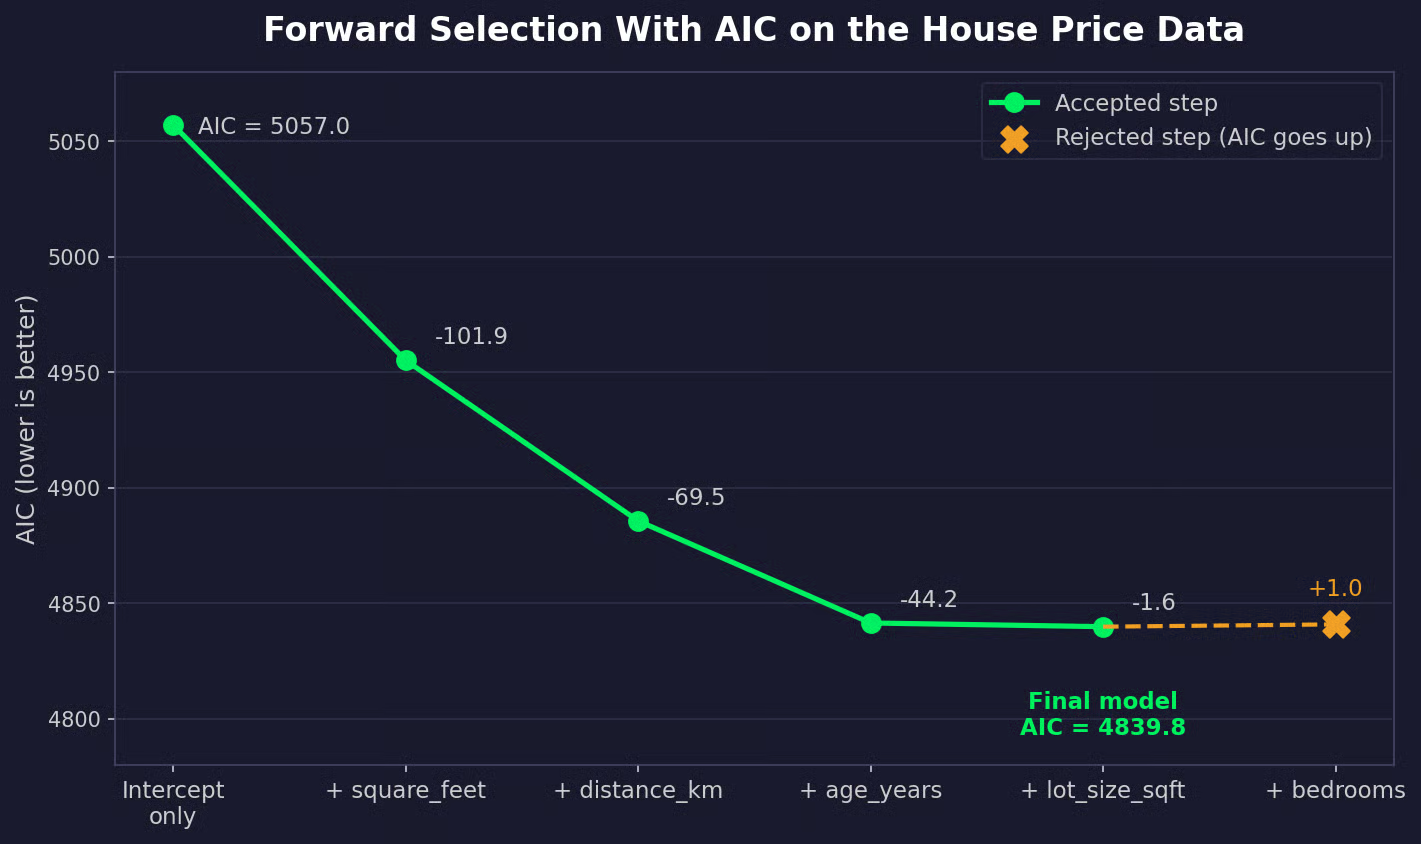
AIC do modelo atual após cada etapa da seleção forward
A direção da busca define como o algoritmo se comporta. O critério define quando ele para.
Essa é a abordagem mais antiga e usa dois limiares:
O limiar de remoção costuma ser maior que o de entrada, para o preditor não ficar entrando e saindo a cada passo. Ambos são convenções, não regras.
Todo p-valor assume que você fez um teste planejado de antemão. O stepwise roda um lote de testes a cada passo e mantém o menor p-valor. Se você roda 20 testes independentes a 0,05 em preditores sem efeito algum, a chance de pelo menos um parecer significativo é 1 − 0.95^20, algo em torno de 64%. Os preditores selecionados vão parecer mais fortes do que são — e vou explicar o porquê na seção de problemas.
No exemplo do preço das casas, lot_size_sqft tem p-valor em torno de 0,063 na etapa 4. Com limiar de entrada 0,05, a seleção forward para em três preditores.
O critério de informação de Akaike equilibra ajuste do modelo e complexidade:
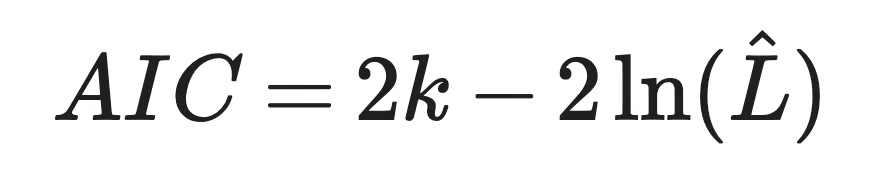
Fórmula do AIC
Aqui, k é o número de parâmetros estimados e L̂ é a verossimilhança maximizada do modelo. O segundo termo recompensa o ajuste e o primeiro cobra 2 pontos por parâmetro.
Um novo preditor nunca reduz a verossimilhança, então o termo de ajuste só pode melhorar. A questão é se melhora mais do que a taxa de 2 pontos. Para um único parâmetro adicionado, isso equivale a um teste de razão de verossimilhança com p-valor em torno de 0,157.
Por isso lot_size_sqft entrou pelo AIC, mas não com a regra de p-valor 0,05. O AIC é mais permissivo e tende a manter preditores mais fracos que ajudam na previsão.
O critério de informação bayesiano tem a mesma estrutura, com penalidade diferente:
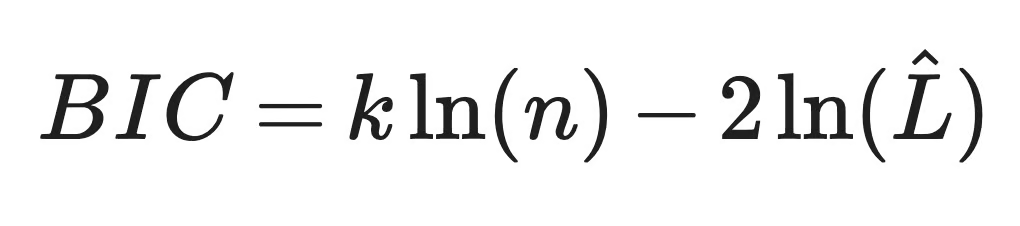
Fórmula do BIC
Nessa fórmula, n é o número de observações. Cada parâmetro agora custa ln(n) pontos em vez de 2, então o BIC penaliza a complexidade mais do que o AIC a partir de 8 observações. E a diferença cresce com o tamanho da amostra.
Com 200 casas, ln(200) é cerca de 5,3, o que equivale a um p-valor implícito em torno de 0,021 para um parâmetro adicionado. A seleção forward com BIC nos dados das casas para em três preditores e deixa lot_size_sqft de fora.
O R-quadrado comum é inútil como critério de seleção.
Ele nunca diminui quando você adiciona um preditor ao modelo linear, até mesmo uma coluna de puro ruído. Se você selecionar por R-quadrado, o modelo completo sempre vence.
O R-quadrado ajustado adiciona uma penalidade pelo número de preditores:
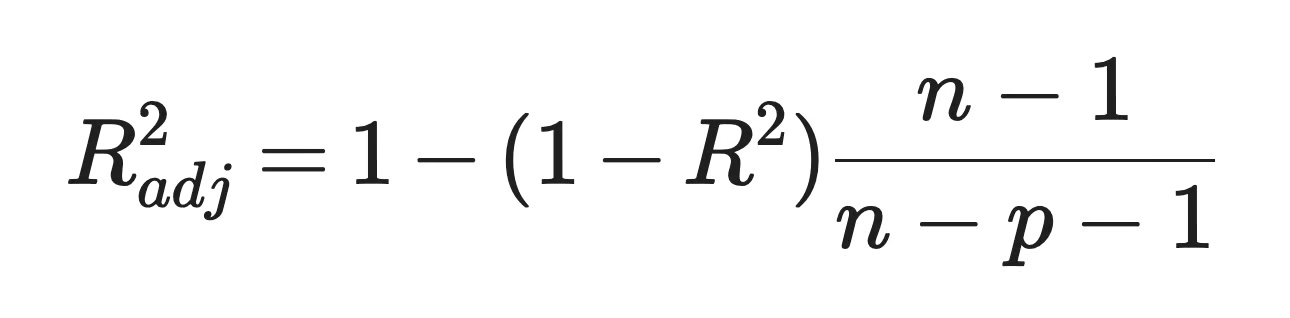
Fórmula do R-quadrado ajustado
Aqui, p é o número de preditores, e valores maiores são melhores. A penalidade é leve. Um novo preditor eleva o R-quadrado ajustado sempre que o valor absoluto do seu t-estatístico for maior que 1, então é o mais permissivo dos quatro critérios.
Nos dados das casas, o R-quadrado ajustado mantém lot_size_sqft e rejeita bedrooms por uma margem na quinta casa decimal.
Mesmos dados, mesma busca forward, respostas diferentes:
| Critério | Modelo final |
|---|---|
| P-valor (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| R-quadrado ajustado | square_feet, distance_km, age_years, lot_size_sqft |
Seleção de variáveis com critérios diferentes
As duas linguagens conseguem rodar regressão stepwise, mas de jeitos diferentes. Vou usar os mesmos dados de preço de casas do exemplo acima em ambas.
Python não tem uma função padrão de regressão stepwise.
Nem o statsmodels nem o scikit-learn têm um equivalente ao step() do R que selecione preditores por AIC ou p-valores. Então a opção mais transparente é escrever o loop você mesmo sobre o statsmodels. Dá umas 25 linhas e você vê cada decisão que ele toma.
Para deixar claro: a função forward_selection() abaixo é um helper meu, não um recurso do statsmodels. O statsmodels apenas ajusta os modelos e reporta os atributos .aic e .bic.
Primeiro, gere o conjunto e salve, para a seção de R usar exatamente as mesmas linhas:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Depois, o loop de seleção. Ele começa do modelo apenas com intercepto, ajusta um modelo por candidato restante e mantém a adição com menor valor do critério:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.UPPER()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")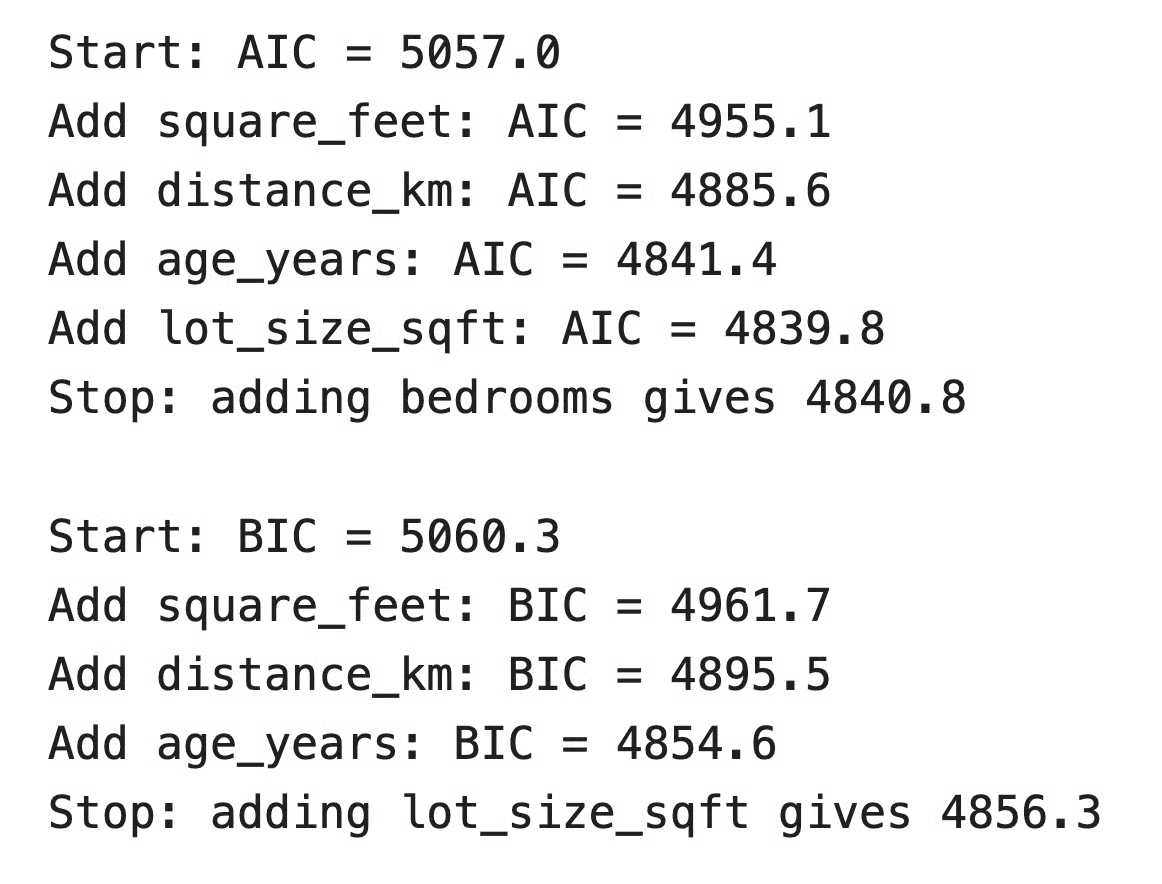
Seleção forward em Python
São os mesmos valores de AIC da tabela do exemplo. O AIC termina com quatro preditores, e o BIC para em três porque lot_size_sqft não supera sua penalidade maior.
Se preferir usar um pacote, o scikit-learn tem o SequentialFeatureSelector. Ele roda seleção forward ou backward, mas pontua cada candidato com validação cruzada em vez de AIC ou p-valores:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Features selecionadas em Python
Com n_features_to_select="auto", a busca para quando o R-quadrado com validação cruzada melhora menos que o tol. Nestes dados, termina com os mesmos quatro preditores do AIC.
O R já traz regressão stepwise nativamente.
A função step() vem no pacote stats do R base — nada para instalar. Você fornece um modelo inicial, um escopo que define o maior modelo a considerar e uma direção:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)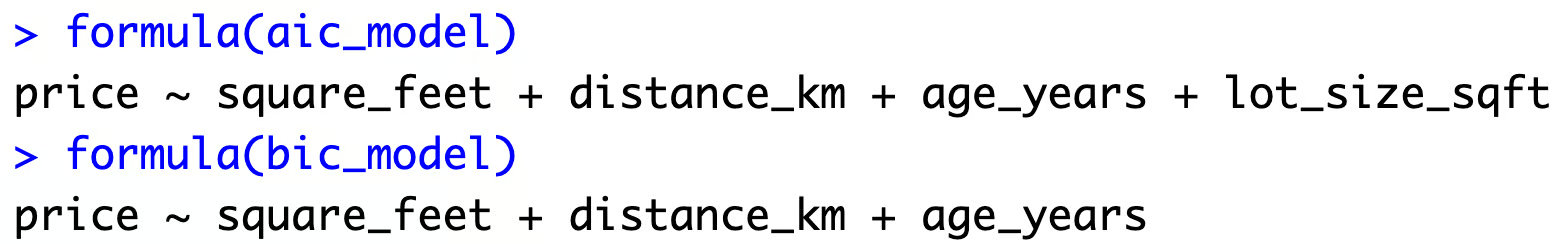
Fórmulas de AIC e BIC no R
O critério que o step() minimiza é controlado por um único argumento — k.
Ele calcula -2 log-likelihood + k * edf, onde edf é o número de coeficientes estimados. O padrão k = 2 equivale ao AIC. Se você definir k = log(n), obtém o BIC, mas o log impresso ainda rotula os valores como "AIC" — não se confunda com isso.
Para eliminação backward, comece pelo modelo completo:
backward_model <- step(full_model, direction = "backward")Nestes dados, ele remove bedrooms e para com os mesmos quatro preditores da seleção forward com AIC. Se você passar um scope e omitir direction, o step() assume seleção bidirecional.
Regressão stepwise não é a única forma de escolher preditores. Veja como ela se compara com três alternativas populares.
A regressão stepwise é uma busca gananciosa (greedy). A cada passo, faz o melhor movimento único e não olha para trás, a menos que você rode em ambas direções.
O best subset selection ajusta todas as combinações possíveis de preditores e mantém aquela com melhor valor do critério. Com 5 preditores, são 32 modelos. Com 20, mais de um milhão; com 40, mais de um trilhão. Algoritmos como branch-and-bound no pacote leaps do R conseguem pular boa parte desse trabalho, mas o custo ainda cresce muito conforme o número de preditores.
Nos dados das casas, o best subset com AIC escolhe os mesmos quatro preditores da seleção forward. Isso nem sempre acontece — tenha isso em mente.
A regressão stepwise toma decisões binárias. Um preditor está no modelo com seu coeficiente de mínimos quadrados completo, ou está fora com coeficiente zero.
A regressão Lasso ajusta todos os preditores de uma vez e adiciona uma penalidade à soma dos valores absolutos dos coeficientes. Essa penalidade encolhe todos os coeficientes em direção a zero e empurra os mais fracos até zero, então seleção e estimação acontecem em um passo só.
Uma pequena mudança nos dados altera um pouco os coeficientes do Lasso, enquanto pode virar uma decisão stepwise de dentro para fora. Você escolhe a força da penalidade com validação cruzada, por exemplo com LassoCV no scikit-learn ou cv.glmnet() no R.
Os coeficientes encolhidos são enviesados para zero de propósito. É a troca por estimativas mais estáveis e melhor desempenho fora da amostra.
Eliminação recursiva de features, ou RFE, parece com eliminação backward. Você ajusta um modelo com todas as features, remove as mais fracas, reajusta e repete.
A diferença é o que significa "mais fracas". A eliminação backward usa um critério estatístico como AIC ou p-valor. O RFE usa as próprias pontuações de importância do modelo, como magnitude dos coeficientes ou importâncias em árvores.
Isso faz do RFE uma ferramenta de machine learning primeiro. Ele funciona com qualquer modelo que tenha importância de features, incluindo random forests e SVMs, e geralmente você combina com validação cruzada via RFECV no scikit-learn. Você obtém um conjunto que prediz bem, mas sem critério baseado em verossimilhança e sem p-valores.
A regressão stepwise é fácil de rodar e explicar. Justamente por isso, seus problemas passam despercebidos com facilidade.
Estatísticos criticam o método há décadas — Regression Modeling Strategies, de Frank Harrell, e Whittingham et al. (2006) no Journal of Animal Ecology são dois exemplos conhecidos. Em um artigo de 2018 no Journal of Big Data, Gary Smith argumenta que a regressão stepwise fica menos eficaz quanto maior o número de variáveis explicativas potenciais — ou seja, não resolve o problema de excesso de preditores.
Pequenas mudanças nos dados podem mudar quais preditores você obtém.
Se você remover algumas linhas ou coletar uma nova amostra da mesma população, o stepwise pode retornar um modelo diferente. Preditores perto do limiar de seleção são os mais frágeis. Um preditor com efeito real porém pequeno, como lot_size_sqft no exemplo, pode entrar em uma amostra e ficar de fora na seguinte. Um preditor sem efeito, como bedrooms, pode entrar quando a amostra, por acaso, o favorece.
Isso importa porque você só vê uma amostra. O modelo que o stepwise entrega é um entre um conjunto possível, e a saída não diz quão amplo é esse conjunto.
O stepwise usa os mesmos dados para escolher os preditores e para estimar seus coeficientes.
Um preditor fraco entra no modelo principalmente nas amostras em que seu efeito aparenta ser maior do que é. Nas amostras em que parece menor, ele fica de fora. Assim, os coeficientes que você vê depois da seleção são grandes demais, em média.
Em bom português: a regressão stepwise mostra os vencedores — e vencedores parecem melhores do que são.
Os p-valores no sumário da regressão assumem que você escolheu o modelo antes de olhar os dados.
O stepwise faz o oposto. Ele roda um lote de testes, mantém os preditores que passam e então reporta p-valores como se esses fossem os únicos testados. Assim, os p-valores saem pequenos demais e os intervalos de confiança, estreitos demais.
O problema piora quando muitos candidatos não têm efeito. David Freedman mostrou isso em 1983 em The American Statistician — ao filtrar preditores de puro ruído e refazer o ajuste, o resultado parecia significativo mesmo sem nada a ser encontrado. Smith faz o mesmo ponto: variáveis irrelevantes podem parecer significativas por coincidência, enquanto variáveis reais podem ficar abaixo do limiar.
Se você reportar esses p-valores como evidência, pode estar reportando ruído.
Overfitting é o lado da previsão do mesmo problema.
Cada preditor candidato dá ao stepwise mais uma chance de ajustar um padrão que existe apenas na sua amostra. O modelo selecionado parece bom nos dados em que foi criado, mas esses padrões não se repetem em novos dados. Como resultado, o desempenho pode ser bom dentro da amostra e ruim fora dela.
E quanto mais preditores você oferece, mais chances ele tem de encontrar padrões que não existem.
Quando dois preditores têm informação parecida, o stepwise precisa escolher entre eles, e pequenas diferenças na amostra decidem a escolha.
square_feet e bedrooms nos dados das casas são um exemplo leve — uma vez que square_feet entra no modelo, bedrooms quase nada acrescenta. Com correlação mais forte, a escolha vira quase aleatória. Uma amostra mantém a variável A, a próxima mantém a B, e cada modelo conta uma história diferente sobre o que impulsiona o resultado.
Nenhuma das histórias é confiável. O stepwise não consegue te dizer que dois preditores são intercambiáveis — então apenas escolhe um.
O stepwise toma uma decisão por vez, e cada decisão depende das anteriores.
Isso significa que ele pode perder o melhor modelo. Suponha que dois preditores sejam inúteis sozinhos, mas fortes juntos — algo que pode acontecer quando cada um corrige ruído do outro. A seleção forward nunca vai adicionar nenhum, porque nenhum melhora o modelo em um único passo.
A eliminação backward e a seleção bidirecional reduzem esse risco, mas não o eliminam. Nenhuma das três verifica todas as combinações, então nenhuma pode prometer o melhor modelo para o critério escolhido.
A regressão stepwise é uma ferramenta para um trabalho específico.
Ela é uma boa escolha para:
É a escolha errada para inferência confirmatória e análise causal.
Se o objetivo é testar se um preditor tem efeito, os p-valores após seleção stepwise não respondem a essa pergunta. E se o objetivo é causal, o conjunto certo de variáveis vem de como os dados foram gerados, não de quais variáveis reduzem o AIC. O stepwise não sabe quem causa o quê.
Para previsão, você tem opções melhores. Regularização como Lasso e elastic net é mais estável, e a seleção de features com validação cruzada avalia modelos em dados que eles não viram.
Se decidir usar regressão stepwise, estes passos deixam os resultados mais honestos:
A regressão stepwise automatiza a seleção de preditores. Ela adiciona ou remove uma variável por vez e para quando nenhuma mudança melhora o modelo segundo o critério escolhido.
A seleção forward começa vazia e só adiciona. A eliminação backward começa com o modelo completo e só remove. A seleção bidirecional faz ambos, então consegue desfazer uma decisão anterior.
Mas a simplicidade significa que os preditores selecionados podem mudar de amostra para amostra, o modelo pode ajustar ruído e os p-valores e intervalos de confiança após a seleção não são confiáveis. Tenha isso em mente. Trate a regressão stepwise como uma técnica de seleção de modelos — não como o padrão para construir uma regressão.
Para ir além, estude seleção de features em geral, veja como AIC e BIC comparam modelos e experimente a regressão Lasso como primeiro passo em regularização.
Aprenda com a DataCamp
Curso
Curso
Curso