Kurs
Einführung in die Regression mit statsmodels in Python
4 Std.
62.5K
Hast du schon einmal auf einen Regressionsdatensatz mit 20 Prädiktoren geschaut und dich gefragt, welche davon ins Modell gehören?
Nimmst du alle auf, passt sich das Modell wahrscheinlich auch an Rauschen statt nur an Signal an. Wählst du von Hand, können zwei Analysten mit denselben Daten zu unterschiedlichen Modellen kommen. Und selbst bei nur 20 Prädiktoren gibt es über eine Million möglicher Teilmengen zum Vergleichen.
Stepwise Regression automatisiert diese Suche, indem sie auf Basis eines statistischen Kriteriums wie p-Wert oder AIC jeweils einen Prädiktor hinzufügt oder entfernt. Sie wird breit gelehrt und genutzt, hat aber auch statistische Grenzen – behandle sie daher nicht als Standardmethode für Feature-Auswahl.
In diesem Artikel zeige ich dir die drei Hauptansätze: Forward Selection, Backward Elimination und bidirektionale Stepwise Selection.
Du suchst weitere Verfahren zur Feature-Auswahl? Lies unser Python-Tutorial zur Feature Selection als einsteigerfreundliche Einführung.
Stepwise Regression ist ein automatisiertes Verfahren, um auszuwählen, welche Prädiktoren in ein Regressionsmodell kommen.
Sie passt nicht ein einzelnes Modell an, sondern eine Abfolge von Kandidatenmodellen und fügt bei jedem Schritt einen Prädiktor hinzu oder entfernt einen – je nach Auswahlkriterium. Die Suche endet, wenn keine Änderung das Modell gemäß diesem Kriterium weiter verbessert.
Stell dir vor, du willst vorhersagen, wie viel ein Kunde pro Jahr ausgibt. Du hast fünf mögliche Prädiktoren:
income
age
education
location
years_experience
Die Stepwise Regression könnte mit income starten, dann prüfen, ob age das Modell verbessert, dann education usw. Das Endmodell könnte nur income und education behalten, wenn die anderen drei das Kriterium nicht genügend verbessern.
Wichtig: Stepwise Regression ist kein eigener Regressionsmodelltyp.
Sie ist ein Variablenauswahlverfahren, das du auf ein bekanntes Modell anwendest – meist lineare Regression. Das Ergebnis ist weiterhin ein gewöhnliches Regressionsmodell; Stepwise entscheidet nur, welche Prädiktoren hineinkommen.
Jede Stepwise-Prozedur durchläuft dieselbe Schleife:
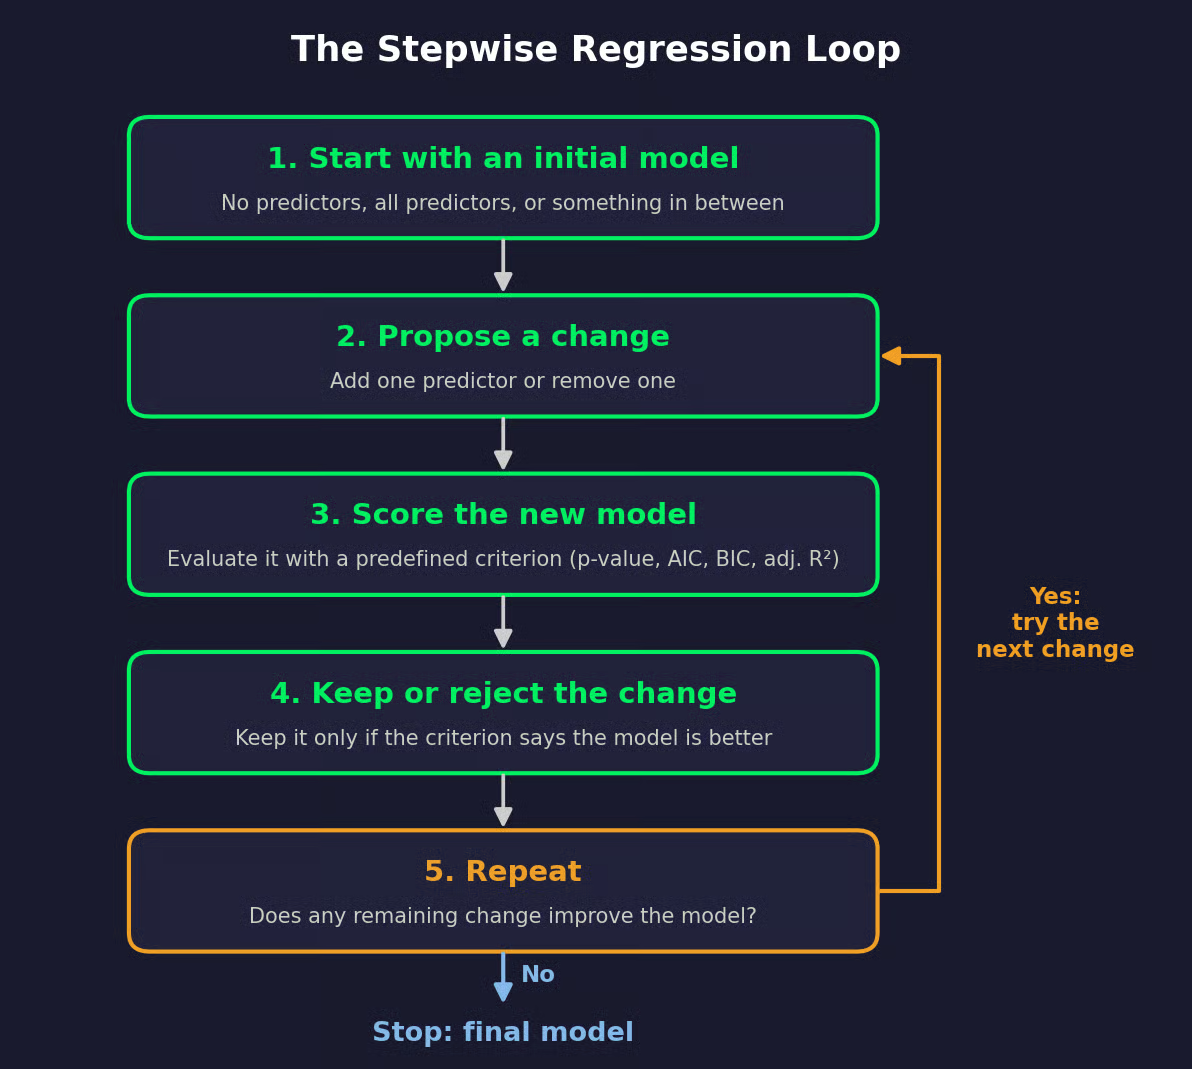
Ablauf der Stepwise Regression
Der Algorithmus schaut nie mehr als einen Schritt voraus. Er fragt nur, ob die nächste einzelne Änderung hilft.
Das Kriterium bestimmt, was „besser“ bedeutet. Diese vier sind am gebräuchlichsten:
Die genaue Prozedur hängt von Suchrichtung und Kriterium ab. Forward Selection fügt nur hinzu, Backward Elimination entfernt nur, bidirektionale Auswahl macht beides. Und derselbe Datensatz kann je nach Kriterium unterschiedliche Endmodelle liefern.
Wenn also jemand sagt, er habe Stepwise Regression verwendet, sind die ersten zwei Fragen: Welche Richtung und welches Kriterium?
Es gibt drei Arten der Stepwise Regression, und sie unterscheiden sich in einem Punkt – der Suchrichtung.
Forward Selection startet klein und baut darauf auf.
Du beginnst mit einem Modell nur mit Achsenabschnitt oder mit ein paar Prädiktoren, die du auf jeden Fall im Modell haben willst. Der Algorithmus passt dann pro verbleibendem Prädiktor je ein Kandidatenmodell an – jeweils mit genau diesem einen Zusatz. Der Prädiktor, der das Kriterium am stärksten verbessert, kommt ins Modell.
Dann läuft die Schleife erneut, nun mit dem größeren Modell als Basis. Sie stoppt, wenn kein verbleibender Prädiktor die Auswahlregel erfüllt, etwa wenn keine Hinzufügung den AIC verringert.
Forward Selection kann starten, selbst wenn du mehr Kandidatenprädiktoren als Beobachtungen hast, da das Vollmodell nie geschätzt werden muss. Der Haken: Ist ein Prädiktor einmal drin, bleibt er drin – auch wenn spätere Zusätze ihn überflüssig machen.
Backward Elimination geht den umgekehrten Weg.
Du startest mit dem Vollmodell, das alle Kandidaten enthält. Der Algorithmus versucht, nacheinander jeden Prädiktor zu entfernen und wirft den heraus, dessen Entfernung das Kriterium am meisten verbessert. Dann passt er das kleinere Modell erneut an und wiederholt den Vorgang. Die Suche stoppt, wenn keine Entfernung das Kriterium verbessert.
Dieser Ansatz setzt voraus, dass das Vollmodell schätzbar ist. Du brauchst mehr Beobachtungen als Parameter, und kein Prädiktor darf eine exakte Linearkombination anderer sein. Mit 50 Prädiktoren und 40 Zeilen kann Backward Elimination gar nicht erst starten.
Und sie hat das Spiegelbild-Problem der Forward Selection: Ist ein Prädiktor einmal raus, bleibt er draußen.
Die bidirektionale Auswahl kombiniert beides. Nach jeder Hinzufügung prüft der Algorithmus, ob ein bereits enthaltener Prädiktor jetzt wieder heraus sollte.
Das ist wichtig, weil der Wert eines Prädiktors davon abhängt, was sonst noch im Modell ist. Sagen wir, bedrooms kommt zuerst rein, weil es mit der Hausgröße korreliert. Wenn square_feet später dazukommt, trägt bedrooms womöglich kaum noch etwas bei. Bidirektionale Auswahl kann es dann entfernen, während Forward Selection es behalten würde.
Der Preis sind mehr Modellanpassungen pro Schritt. Du kannst bidirektional aus einem leeren oder einem vollen Modell starten.
So schneiden die drei Ansätze im Vergleich ab:
| Forward Selection | Backward Elimination | Bidirektionale Auswahl | |
|---|---|---|---|
| Startmodell | Nur Achsenabschnitt oder kleine Basis | Vollmodell mit allen Kandidaten | Entweder leeres oder volles Modell |
| Zulässige Operationen | Nur hinzufügen | Nur entfernen | Hinzufügen oder entfernen |
| Besonderheiten | Kann starten, wenn Prädiktoren Beobachtungen übersteigen, aber frühe Zusätze werden nicht revidiert | Braucht ein schätzbares Vollmodell; entfernte Prädiktoren kommen nicht zurück | Mehr Modellanpassungen pro Schritt, kann aber frühere Entscheidungen rückgängig machen |
Arten der Stepwise Regression
Machen wir es greifbarer.
Ich habe einen synthetischen Datensatz mit 200 Häusern generiert und möchte price aus fünf Kandidatenprädiktoren vorhersagen:
square_feet
bedrooms
age_years
distance_km (Entfernung vom Stadtzentrum)
lot_size_sqft
Ich verwende Forward Selection mit AIC als Kriterium, wobei ein niedrigerer AIC besser ist. Dieselben Daten siehst du später im Python-Abschnitt wieder.
Das Modell nur mit Achsenabschnitt hat einen AIC von 5057,0. So sieht jeder Schritt aus – jede Zelle zeigt den AIC, den du erhältst, wenn du diesen Prädiktor dem aktuellen Modell hinzufügst:
| Kandidat | Schritt 1 | Schritt 2 | Schritt 3 | Schritt 4 | Schritt 5 |
|---|---|---|---|---|---|
square_feet |
4955.1 | im Modell | im Modell | im Modell | im Modell |
distance_km |
5020.3 | 4855.6 | im Modell | im Modell | im Modell |
age_years |
5050.2 | 4926.4 | 4841.4 | im Modell | im Modell |
lot_size_sqft |
5057.9 | 4955.1 | 4844.4 | 4839.8 | im Modell |
bedrooms |
4993.4 | 4950.0 | 4885.1 | 4842.0 | 4840.8 |
| Aktueller Modell-AIC | 5057.0 | 4955.1 | 4885.6 | 4841.4 | 4839.8 |
AIC-Vergleich
Das passiert in den einzelnen Schritten:
Schritt 1: square_feet senkt den AIC um rund 102 Punkte und kommt zuerst rein. bedrooms liegt auf Platz zwei, weil es mit der Hausgröße korreliert
Schritt 2: distance_km bringt den größten Rückgang. bedrooms hilft jetzt kaum noch, da square_feet bereits den Großteil seiner Information enthält
Schritt 3: age_years kommt dazu
Schritt 4: lot_size_sqft senkt den AIC nur um 1,6 Punkte, aber niedriger ist niedriger – also rein damit
Schritt 5: Das Hinzufügen von bedrooms würde den AIC auf 4840,8 erhöhen, also stoppt die Suche
Das Endmodell verwendet square_feet, distance_km, age_years und lot_size_sqft.
Das ist ein plausibles Ergebnis. Ich habe die Daten so generiert, dass bedrooms keinen direkten Einfluss auf den Preis hat – und die Prozedur hat es weggelassen.
Wenn du auf denselben Daten Backward Elimination ausführst, startest du beim Vollmodell mit 4840,8, wirfst bedrooms raus und landest bei denselben vier Prädiktoren. Forward und Backward sind nicht immer einig, hier jedoch schon.
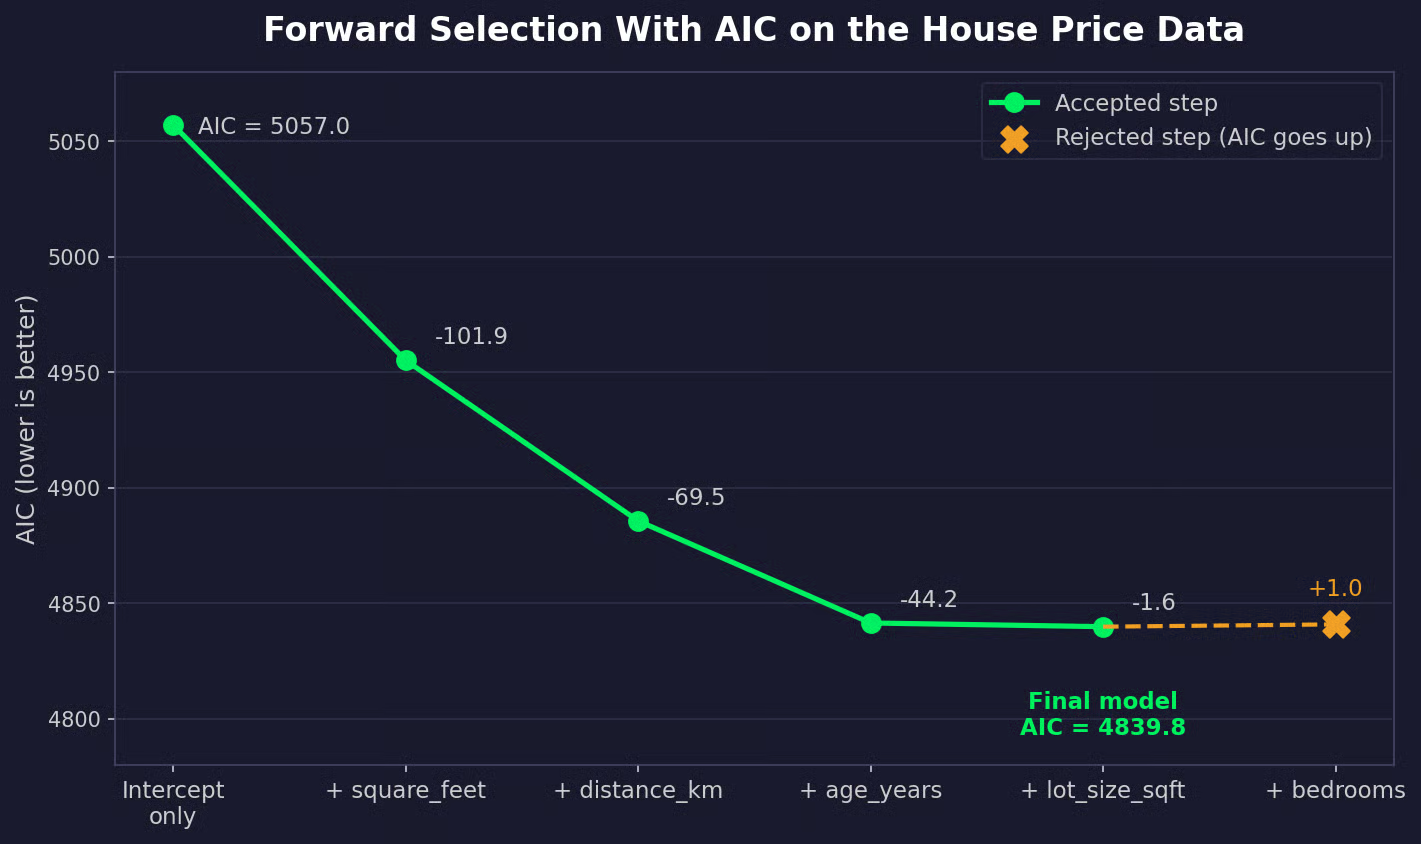
AIC des aktuellen Modells nach jedem Forward-Selection-Schritt
Die Suchrichtung bestimmt das Verhalten des Algorithmus. Das Kriterium bestimmt, wann er stoppt.
Das ist der älteste Ansatz und nutzt zwei Schwellenwerte:
Die Entfernungsschwelle liegt meist höher als die Eintrittsschwelle, damit Prädiktoren nicht bei jedem Schritt rein und raus wechseln. Beide Werte sind Konventionen, keine Regeln.
Jeder p-Wert setzt voraus, dass du einen einzelnen, vorab geplanten Test durchführst. Stepwise führt bei jedem Schritt mehrere Tests aus und behält den kleinsten p-Wert. Wenn du 20 unabhängige Tests mit 0,05 auf Prädiktoren ohne Effekt machst, ist die Chance, dass mindestens einer signifikant wirkt, 1 − 0.95^20 – etwa 64 %. Die ausgewählten Prädiktoren wirken stärker, als sie sind; warum, erkläre ich im Problemteil.
Im Hauspreis-Beispiel hat lot_size_sqft in Schritt 4 einen p-Wert von ca. 0,063. Mit einer Eintrittsschwelle von 0,05 stoppt die Forward Selection bei drei Prädiktoren.
Das Akaike Information Criterion balanciert Modellgüte und Komplexität:
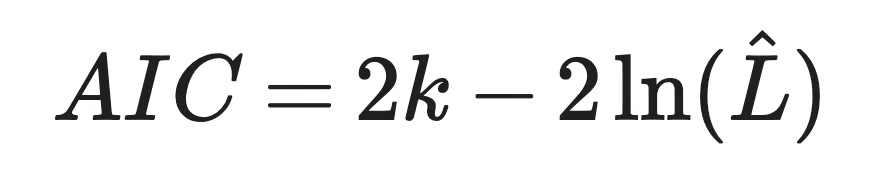
AIC-Formel
Hier ist k die Anzahl geschätzter Parameter und L̂ die maximierte Likelihood des Modells. Der zweite Term belohnt die Güte, der erste berechnet 2 Punkte pro Parameter.
Ein neuer Prädiktor senkt die Likelihood nie, daher kann sich der Güte-Term nur verbessern. Die Frage ist, ob die Verbesserung größer ist als die 2-Punkte-Strafe. Für einen einzelnen zusätzlichen Parameter entspricht das einem Likelihood-Ratio-Test mit einer p-Wert-Schwelle von etwa 0,157.
Darum kam lot_size_sqft bei AIC hinein, nicht aber bei der 0,05-p-Wert-Regel. AIC ist großzügiger und behält eher schwächere Prädiktoren, die die Vorhersage verbessern.
Das Bayesian Information Criterion hat die gleiche Struktur, aber eine andere Strafe:
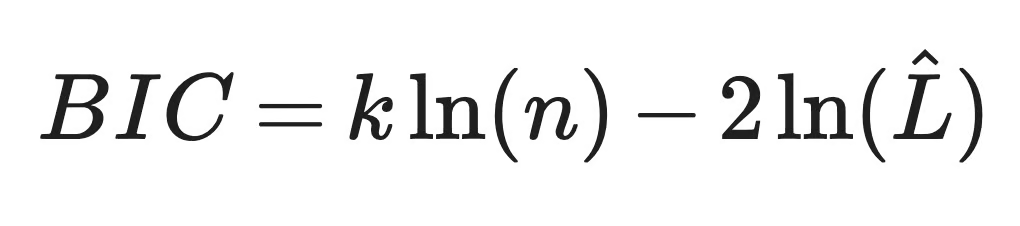
BIC-Formel
In dieser Formel ist n die Anzahl der Beobachtungen. Jeder Parameter kostet nun ln(n) Punkte statt 2. BIC bestraft Komplexität damit stärker als AIC, sobald du 8 oder mehr Beobachtungen hast – und die Lücke wächst mit der Stichprobe.
Bei 200 Häusern ist ln(200) etwa 5,3 – das entspricht implizit einer p-Wert-Schwelle von ca. 0,021 für einen zusätzlichen Parameter. Forward Selection mit BIC stoppt bei drei Prädiktoren und lässt lot_size_sqft draußen.
Das gewöhnliche R-Quadrat taugt nicht als Auswahlkriterium.
Es sinkt nie, wenn du einen Prädiktor zur linearen Regression hinzufügst – selbst nicht bei einer Spalte reinen Rauschens. Wählst du nach R-Quadrat, ist das Vollmodell immer „best“.
Das adjustierte R-Quadrat fügt eine Strafe für die Anzahl der Prädiktoren hinzu:
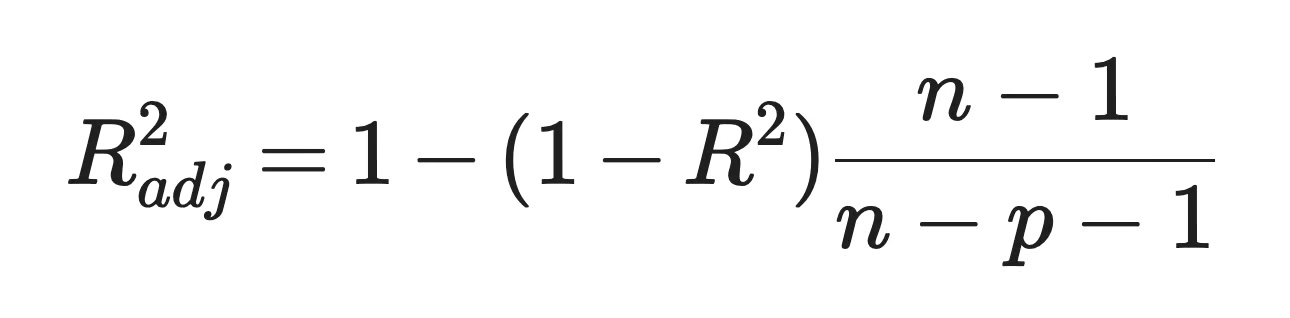
Formel für adjustiertes R-Quadrat
Hier ist p die Anzahl der Prädiktoren; höhere Werte sind besser. Die Strafe ist mild. Ein neuer Prädiktor erhöht das adjustierte R-Quadrat, sobald der Betrag seiner t-Statistik über 1 liegt – es ist somit das großzügigste der vier Kriterien.
Auf den Hausdaten behält das adjustierte R-Quadrat lot_size_sqft und verwirft bedrooms – mit einem Vorsprung in der fünften Nachkommastelle.
Gleiche Daten, gleiche Forward-Suche, unterschiedliche Antworten:
| Kriterium | Endmodell |
|---|---|
| p-Wert (0,05) | square_feet, distance_km, age_years |
| AIC | square_feet, distance_km, age_years, lot_size_sqft |
| BIC | square_feet, distance_km, age_years |
| Adjustiertes R-Quadrat | square_feet, distance_km, age_years, lot_size_sqft |
Variablenauswahl nach unterschiedlichen Kriterien
Beide Sprachen können Stepwise Regression ausführen, aber auf unterschiedliche Weise. Ich nutze in beiden Fällen die gleichen Hauspreisdaten wie oben.
Python hat keine Standardfunktion für Stepwise Regression.
Weder statsmodels noch scikit-learn haben ein Pendant zu Rs step(), das per AIC oder p-Wert Prädiktoren auswählt. Am transparentesten ist es daher, die Schleife selbst auf Basis von statsmodels zu schreiben. Das sind etwa 25 Zeilen, und du siehst jede Entscheidung.
Zur Klarstellung: Die Funktion forward_selection() unten ist mein eigener Helfer – kein statsmodels-Feature. statsmodels passt nur die Modelle an und liefert ihre .aic- und .bic-Attribute.
Erzeuge zuerst den Datensatz und speichere ihn, damit der R-Abschnitt exakt dieselben Zeilen nutzen kann:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200

square_feet = rng.normal(1800, 450, n).clip(700, 3500)
bedrooms = np.clip(np.round(square_feet / 600 + rng.normal(0, 0.6, n)), 1, 6)
age_years = rng.uniform(0, 60, n)
distance_km = rng.uniform(1, 30, n)
lot_size_sqft = rng.normal(6000, 1500, n).clip(2000, 12000)

# Bedrooms has no direct effect on price, lot size has a small one
price = (
    60000
    + 140 * square_feet
    - 1200 * age_years
    - 3500 * distance_km
    + 4 * lot_size_sqft
    + rng.normal(0, 45000, n)
)

house = pd.DataFrame({
    "square_feet": square_feet,
    "bedrooms": bedrooms,
    "age_years": age_years,
    "distance_km": distance_km,
    "lot_size_sqft": lot_size_sqft,
    "price": price,
})

house.to_csv("house_prices.csv", index=False)
Als Nächstes die Auswahlschleife. Sie startet beim Modell nur mit Achsenabschnitt, passt je ein Modell pro verbleibendem Kandidaten an und behält die Hinzufügung mit dem niedrigsten Kriteriumswert:
def forward_selection(data, target, candidates, criterion="aic"):
    selected = []
    remaining = list(candidates)

    # Score the intercept-only model first
    null_model = smf.ols(f"{target} ~ 1", data=data).fit()
    current_score = getattr(null_model, criterion)
    print(f"Start: {criterion.upper()} = {current_score:.1f}")

    while remaining:
        # Fit one model per remaining candidate
        scores = {}
        for candidate in remaining:
            formula = f"{target} ~ {' + '.join(selected + [candidate])}"
            scores[candidate] = getattr(smf.ols(formula, data=data).fit(), criterion)

        best = min(scores, key=scores.get)

        # Stop when the best addition doesn't lower the criterion
        if scores[best] >= current_score:
            print(f"Stop: adding {best} gives {scores[best]:.1f}")
            break

        selected.append(best)
        remaining.remove(best)
        current_score = scores[best]
        print(f"Add {best}: {criterion.upper()} = {current_score:.1f}")

    return selected


candidates = ["square_feet", "bedrooms", "age_years", "distance_km", "lot_size_sqft"]

aic_predictors = forward_selection(house, "price", candidates, criterion="aic")
print()
bic_predictors = forward_selection(house, "price", candidates, criterion="bic")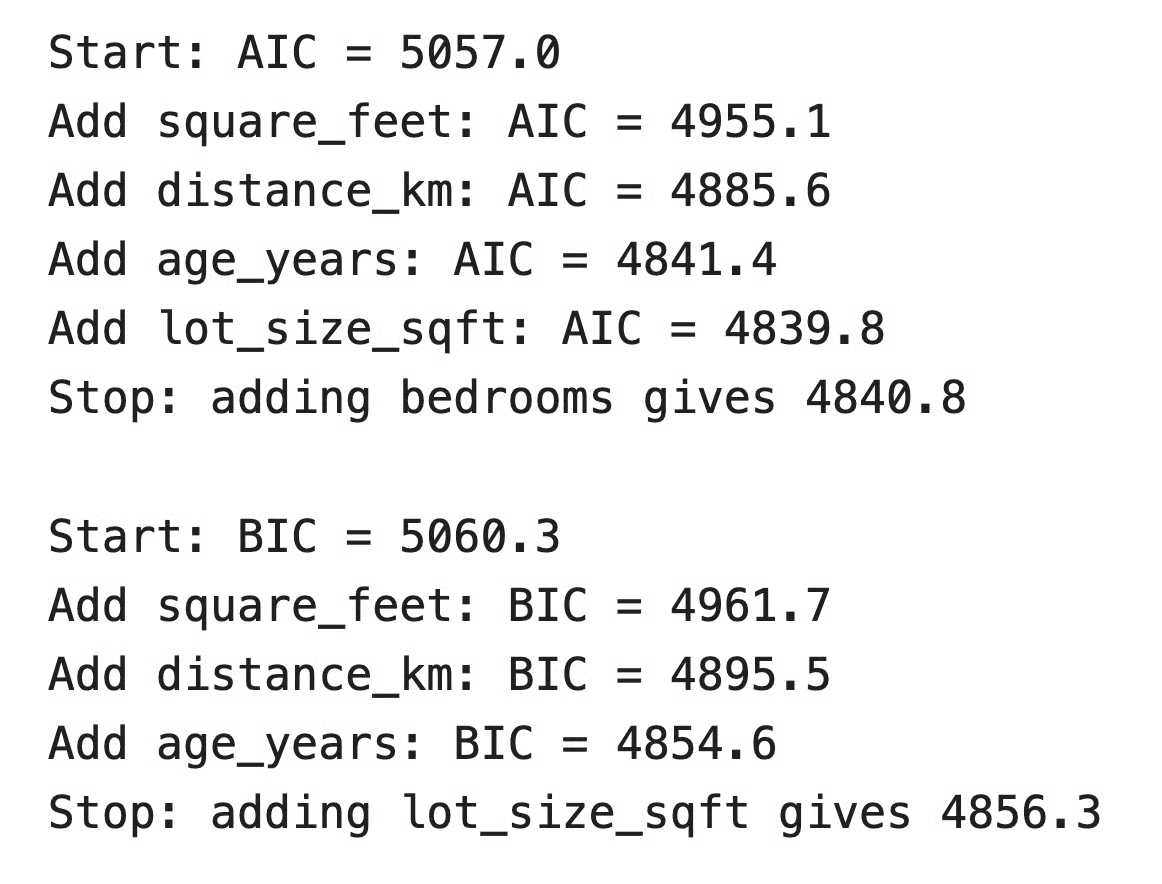
Forward Selection in Python
Das sind dieselben AIC-Werte wie in der Beispieltabelle. AIC endet mit vier Prädiktoren, BIC stoppt bei drei, weil lot_size_sqft seine höhere Strafe nicht ausgleicht.
Wenn du lieber ein Package nutzt: scikit-learn hat den SequentialFeatureSelector. Er führt Forward- oder Backward-Selection aus, bewertet aber jede Option per Cross-Validation statt per AIC oder p-Werten:
from sklearn.feature_selection import SequentialFeatureSelector
from sklearn.linear_model import LinearRegression

X = house.drop(columns="price")
y = house["price"]

sfs = SequentialFeatureSelector(
    LinearRegression(),
    n_features_to_select="auto",
    tol=0.001,
    direction="forward",
    scoring="r2",
    cv=5,
)
sfs.fit(X, y)
print(list(X.columns[sfs.get_support()]))
Ausgewählte Features in Python
Mit n_features_to_select="auto" stoppt die Suche, wenn sich das kreuzvalidierte R-Quadrat um weniger als tol verbessert. Auf diesen Daten endet sie mit denselben vier Prädiktoren wie AIC.
R hat Stepwise Regression eingebaut.
Die Funktion step() kommt mit dem stats-Paket von Base R, du musst nichts installieren. Du gibst ein Startmodell, einen Scope für das größte erlaubte Modell und eine Richtung an:
# Load the same data generated in the Python section
house <- read.csv("house_prices.csv")

# Intercept-only model and full model
null_model <- lm(price ~ 1, data = house)
full_model <- lm(
  price ~ square_feet + bedrooms + age_years + distance_km + lot_size_sqft,
  data = house
)

# Forward selection with AIC
aic_model <- step(null_model, scope = formula(full_model), direction = "forward")

# Forward selection with BIC
bic_model <- step(
  null_model,
  scope = formula(full_model),
  direction = "forward",
  k = log(nrow(house))
)

formula(aic_model)
formula(bic_model)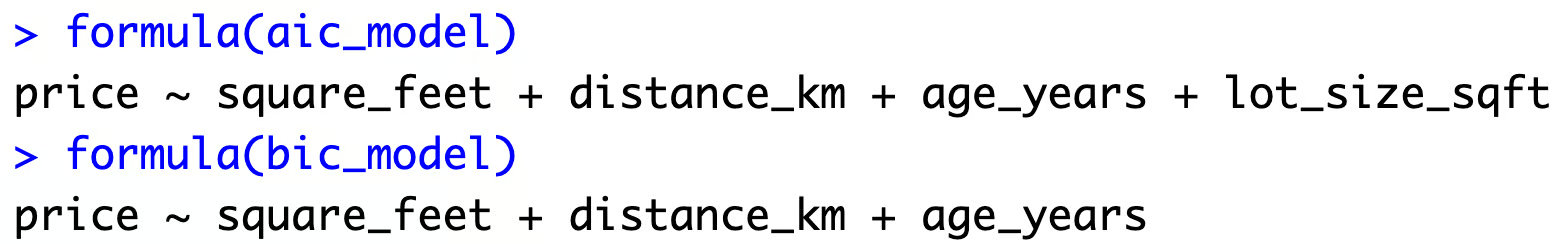
AIC- und BIC-Formeln in R
Das Kriterium, das step() minimiert, steuerst du über ein einziges Argument – k.
Es berechnet -2 log-likelihood + k * edf, wobei edf die Anzahl geschätzter Koeffizienten ist. Der Standard k = 2 ergibt AIC. Setzt du k = log(n), erhältst du BIC – die ausgegebene Spur nennt die Werte dennoch „AIC“, lass dich davon nicht verwirren.
Für Backward Elimination startest du vom Vollmodell:
backward_model <- step(full_model, direction = "backward")Auf diesen Daten entfernt es bedrooms und endet mit denselben vier Prädiktoren wie Forward AIC. Übergibst du einen scope und lässt direction weg, nutzt step() standardmäßig die bidirektionale Auswahl.
Stepwise Regression ist nicht die einzige Möglichkeit, Prädiktoren zu wählen. So schneidet sie im Vergleich zu drei beliebten Alternativen ab.
Stepwise Regression ist eine gierige Suche. In jedem Schritt macht sie den lokal besten Zug und schaut nicht zurück – außer bei bidirektionaler Suche.
Best Subset Selection passt jede mögliche Prädiktorkombination an und behält die mit dem besten Kriteriumswert. Mit 5 Prädiktoren sind das 32 Modelle. Mit 20 über eine Million, mit 40 über eine Billion. Algorithmen wie Branch-and-Bound im R-Paket leaps können viel Arbeit überspringen, aber die Kosten wachsen trotzdem schnell mit der Anzahl der Prädiktoren.
Auf den Hauspreisdaten wählt Best Subset Selection mit AIC dieselben vier Prädiktoren wie Forward Selection. Das ist nicht immer so – behalte es im Hinterkopf.
Stepwise Regression trifft Ja/Nein-Entscheidungen. Ein Prädiktor ist entweder im Modell mit seinem vollen Least-Squares-Koeffizienten oder draußen mit Null.
Lasso-Regression passt alle Prädiktoren gleichzeitig an und fügt eine Strafe auf die Summe der absoluten Koeffizientenwerte hinzu. Diese Strafe schrumpft jeden Koeffizienten in Richtung Null und drückt die schwächsten ganz auf Null – Auswahl und Schätzung in einem Schritt.
Eine kleine Datenänderung verschiebt Lasso-Koeffizienten nur wenig, während sie eine Stepwise-Entscheidung von „drin“ zu „draußen“ kippen kann. Die Strafstärke wählst du per Cross-Validation, z. B. mit LassoCV in scikit-learn oder cv.glmnet() in R.
Die geschrumpften Koeffizienten sind absichtlich gegen Null verzerrt. Das ist der Preis für stabilere Schätzungen und bessere Out-of-Sample-Vorhersagen.
Recursive Feature Elimination (RFE) sieht aus wie Backward Elimination. Du passt ein Modell mit allen Features an, entfernst die schwächsten, passt neu an und wiederholst.
Der Unterschied liegt in „schwächsten“. Backward Elimination nutzt ein statistisches Kriterium wie AIC oder p-Wert. RFE verwendet die Modell-eigenen Wichtigkeitsscores, z. B. Koeffizientenbeträge oder baumbasierte Feature-Importanzen.
Damit ist RFE primär ein Machine-Learning-Werkzeug. Es funktioniert mit jedem Modell mit Feature-Importance, einschließlich Random Forests und Support Vector Machines, und wird meist mit Cross-Validation via RFECV in scikit-learn kombiniert. Du erhältst ein Feature-Set, das gut vorhersagt – aber kein likelihood-basiertes Kriterium und keine p-Werte.
Stepwise Regression ist leicht zu nutzen und zu erklären. Genau deshalb übersieht man ihre Probleme leicht.
Statistiker kritisieren die Methode seit Jahrzehnten – Frank Harrells Regression Modeling Strategies und Whittingham et al. (2006) im Journal of Animal Ecology sind zwei bekannte Beispiele. In einem Paper von 2018 im Journal of Big Data argumentiert Gary Smith, dass Stepwise Regression mit wachsender Zahl potenzieller erklärender Variablen weniger wirksam wird – sie löst das Problem zu vieler Prädiktoren nicht.
Kleine Datenänderungen können die gewählten Prädiktoren ändern.
Entfernst du ein paar Zeilen oder sammelst eine neue Stichprobe aus derselben Grundgesamtheit, kann Stepwise ein anderes Modell liefern. Prädiktoren nahe der Auswahlgrenze sind am fragilsten. Ein Prädiktor mit realem, aber kleinem Effekt – wie lot_size_sqft im Beispiel – kann in einer Stichprobe drin und in der nächsten draußen sein. Ein Prädiktor ohne Effekt – wie bedrooms – kann hineinschlüpfen, wenn die Stichprobe ihn zufällig begünstigt.
Das ist relevant, weil du meist nur eine Stichprobe siehst. Das Modell, das Stepwise liefert, ist eines aus einer Bandbreite möglicher Modelle – und das Ergebnis sagt dir nicht, wie breit diese Bandbreite ist.
Stepwise nutzt dieselben Daten zur Auswahl der Prädiktoren und zur Schätzung ihrer Koeffizienten.
Ein schwacher Prädiktor kommt vor allem in Stichproben ins Modell, in denen sein Effekt zufällig stärker wirkt. In Stichproben, in denen er schwächer aussieht, bleibt er draußen. Die nach der Auswahl berichteten Koeffizienten sind daher im Mittel zu groß.
Kurz: Stepwise Regression zeigt dir die Gewinner – und Gewinner sehen besser aus, als sie sind.
Die p-Werte in einer Regressionszusammenfassung setzen voraus, dass du das Modell vorab festgelegt hast.
Stepwise macht das Gegenteil. Es führt viele Tests durch, behält die, die bestehen, und berichtet dann p-Werte, als hättest du nur diese getestet. Dadurch werden p-Werte zu klein und Konfidenzintervalle zu eng.
Das Problem verstärkt sich, wenn viele Kandidaten keinen Effekt haben. David Freedman zeigte das 1983 in The American Statistician: Wenn er reine Rauschvariablen vorsortierte und das Modell neu schätzte, sah das Ergebnis signifikant aus, obwohl es nichts zu finden gab. Smith betont dasselbe: Störvariablen können zufällig signifikant sein, während echte die Schwelle verfehlen.
Wenn du diese p-Werte als Beleg meldest, meldest du womöglich Rauschen.
Overfitting ist die Vorhersageseite desselben Problems.
Jeder Kandidatenprädiktor bietet Stepwise eine weitere Chance, ein Muster zu fitten, das nur in deiner Stichprobe existiert. Das gewählte Modell sieht auf den Trainingsdaten gut aus, aber diese Muster wiederholen sich in neuen Daten nicht. Folge: Stark in-sample, schwach out-of-sample.
Und je mehr Kandidaten du gibst, desto mehr Chancen, Scheinmuster zu finden.
Wenn zwei Prädiktoren ähnliche Information tragen, muss Stepwise zwischen ihnen wählen – kleine Stichprobenunterschiede entscheiden dann.
square_feet und bedrooms sind ein mildes Beispiel: Ist square_feet einmal drin, fügt bedrooms kaum etwas hinzu. Bei stärkerer Korrelation wird die Wahl fast zufällig. Eine Stichprobe behält Variable A, die nächste Variable B – und jedes Modell erzählt eine andere Ursache-Wirkung-Geschichte.
Keine der Geschichten ist verlässlich. Stepwise erkennt nicht, dass zwei Prädiktoren austauschbar sind – also wählt es einfach einen.
Stepwise trifft jeweils nur eine Entscheidung, und jede hängt von den vorherigen ab.
So kann es das beste Modell verpassen. Nehmen wir zwei Prädiktoren, die einzeln nutzlos sind, zusammen aber stark – etwa weil sie sich gegenseitig Rauschen wegkorrigieren. Forward Selection wird keinen der beiden hinzufügen, weil keiner in einem Einzelschritt verbessert.
Backward Elimination und bidirektionale Auswahl verringern dieses Risiko, eliminieren es aber nicht. Keiner der drei Ansätze prüft alle Kombinationen – also kann keiner das beste Modell für das gewählte Kriterium garantieren.
Stepwise Regression ist ein Werkzeug für einen engen Einsatzzweck.
Sie eignet sich gut für:
Für bestätigende Inferenz und Kausalanalyse ist sie die falsche Wahl.
Willst du testen, ob ein Prädiktor einen Effekt hat, liefern die p-Werte nach Stepwise-Auswahl darauf keine verlässliche Antwort. Und bei Kausalfragen leitet sich die richtige Variablenauswahl aus dem Entstehungsprozess der Daten ab – nicht daraus, welche Variablen den AIC senken. Stepwise weiß nicht, welche Variable was verursacht.
Für Vorhersage gibt es bessere Optionen. Regularisierung wie Lasso und Elastic Net ist stabiler, und kreuzvalidierte Feature-Auswahl bewertet Modelle auf Daten, die sie nicht gesehen haben.
Wenn du Stepwise Regression verwendest, machen diese Schritte die Ergebnisse ehrlicher:
Stepwise Regression automatisiert die Prädiktorenauswahl. Sie fügt jeweils eine Variable hinzu oder entfernt sie und stoppt, wenn keine Änderung das Modell nach deinem Kriterium verbessert.
Forward Selection startet leer und fügt nur hinzu. Backward Elimination startet voll und entfernt nur. Bidirektionale Auswahl macht beides und kann frühere Entscheidungen zurücknehmen.
Die Einfachheit hat ihren Preis: Die ausgewählten Prädiktoren können sich von Stichprobe zu Stichprobe ändern, das Modell kann Rauschen fitten, und p-Werte sowie Konfidenzintervalle nach der Auswahl sind nicht verlässlich. Behalte das im Hinterkopf. Nutze Stepwise Regression als eine Methode der Modellselektion – nicht als Standardweg zum Regressionsmodell.
Wenn du tiefer einsteigen willst, lies allgemein über Feature-Auswahl, sieh dir an, wie AIC und BIC Modelle vergleichen, und probiere Lasso-Regression als Einstieg in die Regularisierung.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Laiba Siddiqui
6 Min.