

Cursus
Cloud Computing begrijpen
2 uur
260.2K
Oefen en volg je voortgang.
Ga Verder Met GoogleVoor starters bevatten GCP-sollicitatievragen en -antwoorden weinig tot geen technische elementen. Het doel is om je begrip te peilen van GCP’s aanbod en hoe de producten samenhangen. Je krijgt deze vragen waarschijnlijk als je nog nooit met GCP hebt gewerkt of als de interviewer je niveau wil inschatten en met de basis wil beginnen.
Je moet bekend zijn met kernservices van GCP, zoals Compute Engine, Kubernetes Engine, Cloud Storage, BigQuery, Cloud SQL en Pub/Sub. Er kunnen ook vragen komen over:
Klinken deze concepten je onbekend en weet je niet waar te beginnen? Probeer dan onze cursus Introduction to GCP. Die geeft je een solide basis in bovenstaande onderwerpen.
Hier zijn enkele vragen die een interviewer kan stellen, met voorbeeldantwoorden:
Google Compute Engine biedt schaalbare virtuele machines die draaien in Google’s datacenters. Deze VM’s worden vaak gebruikt voor het draaien van webapplicaties, het hosten van databases en het afhandelen van grootschalige rekentaken zoals dataverwerking en machinelearning-workloads.
Google Cloud Storage biedt vier hoofdklassen: Standard Storage voor vaak geraadpleegde data met hoge performance, Nearline Storage voor data die minder dan eens per maand wordt benaderd tegen lagere kosten, Coldline Storage voor data die minder dan eens per jaar wordt benaderd tegen nog lagere kosten, en Archive Storage voor langetermijnarchivering en back-ups met de laagste kosten.
Let op: Je scoort bonuspunten als je praktische voorbeelden kunt geven van het soort data dat in elke opslagklasse thuishoort. Als je bijvoorbeeld solliciteert bij een socialmedia-app, kun je het hebben over profielfoto’s, gebruikersactiviteitslogs en compliance-data.
Pub/Sub is ontworpen voor realtime messaging en event-driven architecturen om asynchrone communicatie tussen services te ondersteunen. Typische use-cases zijn loggingsystemen, data-ingestiepijplijnen, realtime analytics en het integreren van microservices.
BigQuery is Google’s serverless datawarehouse en is ontworpen om grote datasets efficiënt met SQL te verwerken. Het gebruikt kolomgebaseerde opslag, waarbij data op schijf in kolommen in plaats van rijen wordt opgeslagen, om te optimaliseren voor leesintensieve operaties. Het maakt ook gebruik van parallelle verwerking, waardoor taken over meerdere machines kunnen worden verdeeld en gelijktijdig kunnen worden verwerkt. Hierdoor kan BigQuery snelle queries uitvoeren, zelfs op petabytes aan data. Daarnaast integreert het met andere GCP-services zoals Dataflow voor dataverwerking en Pub/Sub voor realtime data-inname. BigQuery bevat ook features zoals BigQuery ML om machine learning direct binnen het platform uit te voeren.
Deze vragen komen zodra je interviewer heeft vastgesteld dat je basiskennis hebt van GCP’s aanbod. Ze zijn doorgaans technischer en toetsen je begrip van specifieke services, hun configuraties en hoe je ze effectief gebruikt in verschillende scenario’s.
Je kunt ze waarschijnlijk beantwoorden als je hands-on ervaring met GCP hebt en eerder resources beheerde, IAM-beleidsregels implementeerde, VM’s configureerde, of als je onze cursus Understanding Cloud Computing hebt voltooid.
Je bouwt voort op je kennis van GCP’s aanbod en laat een dieper begrip zien van de volgende services:
Je hoeft niet overal expert in te zijn. Alleen al bekend zijn met de meest gangbare features en configuratieopties helpt enorm!
Hier is een lijst met veelvoorkomende interviewvragen met voorgestelde antwoorden:
Om autoscaling in Google Compute Engine te configureren en te beheren, begin ik met het opzetten van instance groups. Vervolgens definieer ik autoscalingbeleid op basis van relevante metrics zoals CPU-gebruik en load balancing-belasting. Deze configuratie zorgt ervoor dat het systeem opschaalt bij hoge vraag om performance te behouden en afschaalt bij lage vraag om kosten te optimaliseren.
Voor het inrichten en gebruiken van Cloud Pub/Sub voor een realtime messaging-applicatie maak ik gebruik van topics en subscriptions om de messageflow te beheren. Ik configureer message-retention en acknowledgment-instellingen om betrouwbare levering te garanderen. Afhankelijk van de use-case gebruik ik push-subscriptions voor realtime levering of pull-subscriptions voor batchverwerking. Daarnaast integreer ik Pub/Sub met andere GCP-services zoals Dataflow voor dataverwerking en Cloud Functions voor eventgestuurde verwerking.
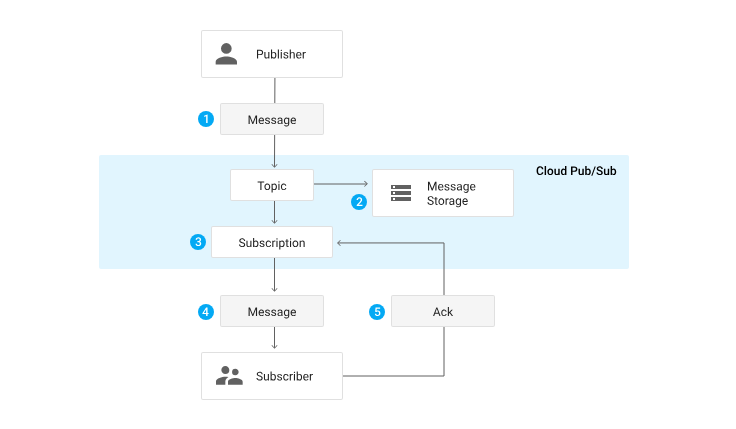
Levenscyclus van een bericht via Pub/Sub. Bron: GCP Pub/Sub-documentatie
Om tijdelijke toegang tot resources te verlenen met Google Cloud IAM, begin ik met het aanmaken van custom roles met alleen de noodzakelijke rechten, volgens het least-privilege-principe. Vervolgens configureer ik serviceaccounts om toegang voor applicaties en services te beheren. Voor kortdurende toegang gebruik ik Identity-Aware Proxy (IAP) om credentials met een korte levensduur uit te geven of genereer ik signed URLs voor Cloud Storage om tijdgebonden toegang tot specifieke resources te bieden.
Op dit niveau zoeken interviewers naar diepgaande technische expertise, hands-on ervaring en het vermogen om complexe oplossingen in GCP te ontwerpen. Ze verwachten dat je antwoorden rekening houden met best practices voor het optimaliseren en beveiligen van cloudomgevingen. Hoewel er uitzonderingen kunnen zijn, krijg je doorgaans alleen geavanceerde vragen als je solliciteert naar een seniorfunctie of een rol met een sterk DevOps-component.
Boven op de basis- en middenniveaubegrippen kan je interviewer vragen naar de algemene architectuur en het ontwerp van schaalbare cloudoplossingen, en hoe je features zoals multiregio-deployments, load balancing, autoscaling en disaster recovery benut. Je moet ook weten hoe je hybride en multicloudoplossingen beheert en geavanceerde securitypraktijken implementeert met IAM, VPC-beveiliging, data-encryptie en GCP’s tools voor monitoring en bescherming.
Hieronder staan mogelijke interviewvragen met voorbeeldantwoorden:
Voor het opzetten van een CI/CD-pijplijn met GCP-services voor een microservicesapplicatie begin ik met Cloud Build voor het bouwen en testen van de code. De gebouwde containerimages sla ik op in Container Registry. Voor deployment gebruik ik Kubernetes Engine of Cloud Run, afhankelijk van de applicatievereisten. Daarnaast zet ik Infrastructure as Code (IaC)-tools zoals Deployment Manager of Terraform in om infrastructuur te beheren, en monitor ik deployments met Google Cloud’s Operations Suite om soepele werking en snelle issue-resolutie te garanderen.
Voor het monitoren en troubleshooten van een complexe GCP-omgeving richt ik Google Cloud’s Operations Suite in, met tools voor monitoring en logging. Ik maak custom dashboards om key metrics te visualiseren en stel alerts in voor kritieke events. Voor incidentmanagement gebruik ik geïntegreerde tools om issues te volgen en op te lossen. Bij het debuggen analyseer ik logs en gebruik ik metrics om performanceknelpunten en andere problemen te identificeren. Deze allesomvattende aanpak helpt de betrouwbaarheid en prestaties van de omgeving te borgen.
Om machinelearningservices op GCP te benutten voor een predictieve analytics-oplossing gebruik ik het AI Platform om modellen te trainen en te deployen. Voor het bouwen van custom modellen zet ik AutoML in. Voor ML-taken in de database integreer ik BigQuery ML. Daarnaast gebruik ik voorgetrainde API’s voor specifieke taken zoals vision of natural language processing. Om de hele pijplijn efficiënt te houden, richt ik datapijplijnen in voor preprocessing, voer ik feature engineering uit en implementeer ik modelmonitoring en -hertraining om de nauwkeurigheid en relevantie van voorspellingen te behouden.
Als je solliciteert naar een rol als data scientist, wil je interviewer je vermogen testen om met grote datasets te werken, statistische methoden toe te passen, predictieve modellen te bouwen en cloudresources in te zetten voor data-analyse.
Je moet een goede kennis hebben van GCP’s kernservices en begrijpen wat hun mogelijkheden, use-cases en integratiepatronen zijn. Data scientists moeten ook weten van:
Veel van deze onderwerpen komen aan bod in onze cursus Introduction to BigQuery, als je een opfrisser wilt.
Hier zijn voorbeeldvragen en -antwoorden:
Voor datapreprocessing en feature engineering in GCP gebruik ik Cloud Dataflow voor schaalbare datatransformaties en Dataprep voor datacleaning. Ik benut de SQL-mogelijkheden van BigQuery om feature engineering uit te voeren, zoals het creëren van nieuwe features, omgaan met missende waarden, het encoderen van categorische variabelen en het schalen van features zodat ze het juiste formaat hebben voor ML-modellen.
Om reproduceerbaarheid en schaalbaarheid te borgen, versioneer ik datasets en modellen om wijzigingen en updates bij te houden. Ik gebruik AI Platform Pipelines om ML-workflows te orkestreren en ML Metadata om metadata met betrekking tot experimenten te tracken. Daarnaast gebruik ik Kubernetes Engine om gecontaineriseerde omgevingen te creëren, wat zorgt voor consistente en schaalbare runs van mijn experimenten.
Voor deep-learningprojecten richt ik eerst een deep-learningomgeving in met TensorFlow, waarin ik neurale netwerken bouw en train. Ik gebruik AI Platform voor gedistribueerde training en hyperparametertuning om de modelprestatie te optimaliseren. Zodra het model is getraind, deploy ik het met AI Platform voor het serveren van voorspellingen. Om performance verder te optimaliseren en resources te beheren, monitor ik het verbruik en pas ik de infrastructuur aan waar nodig, zodat de rekenkracht efficiënt wordt benut.
Data engineers zijn verantwoordelijk voor het ontwerpen en bouwen van schaalbare en betrouwbare datasystemen, het beheren van datapijplijnen en het waarborgen van datakwaliteit en betrouwbaarheid op GCP.
Je moet een goede kennis hebben van GCP’s kernservices en begrijpen wat hun mogelijkheden, use-cases en integratiepatronen zijn. GCP Data Engineer-interviewvragen gaan ook over de volgende onderwerpen:
Enkele vragen en antwoorden zijn:
Voor datapartitionering en sharding in een gedistribueerd databasesysteem op GCP pas ik technieken toe om schaalbaarheid en performance te waarborgen. Range partitioning verdeelt data op basis van waardebereiken, terwijl hash partitioning data verdeelt via een hashfunctie. Samengestelde partitionering combineert meerdere methoden. Deze strategieën implementeer je in diensten zoals Bigtable, Firestore of Cloud Spanner om data efficiënt te beheren en snelle toegang en retrieval te garanderen.
Voor schema-evolutie en versiebeheer in een data lake op GCP gebruik ik tools zoals Avro of Protobuf om schemawijzigingen in de tijd te managen. Ik onderhoud een schemaregister om schema’s te versioneren en consistentie over datasets te borgen. Daarnaast implementeer ik datagovernancepraktijken om consistentie te bewaren en backward compatibility te garanderen, zodat wijzigingen en updates beheersbaar blijven zonder bestaande workflows te verstoren.
Om een datapijplijn te implementeren met Google Cloud Dataflow en BigQuery, begin ik met het inrichten van Dataflow voor ETL-processen. Dit omvat het schrijven van Dataflow-jobs om data uit verschillende bronnen te extraheren, te transformeren en in BigQuery te laden. Ik integreer Pub/Sub voor realtime data-inname, zodat verwerking tijdig en accuraat is. Daarnaast beheer ik schema’s, pas ik partitioneringsstrategieën toe en gebruik ik optimalisatietechnieken voor efficiënte opslag en retrieval in BigQuery.
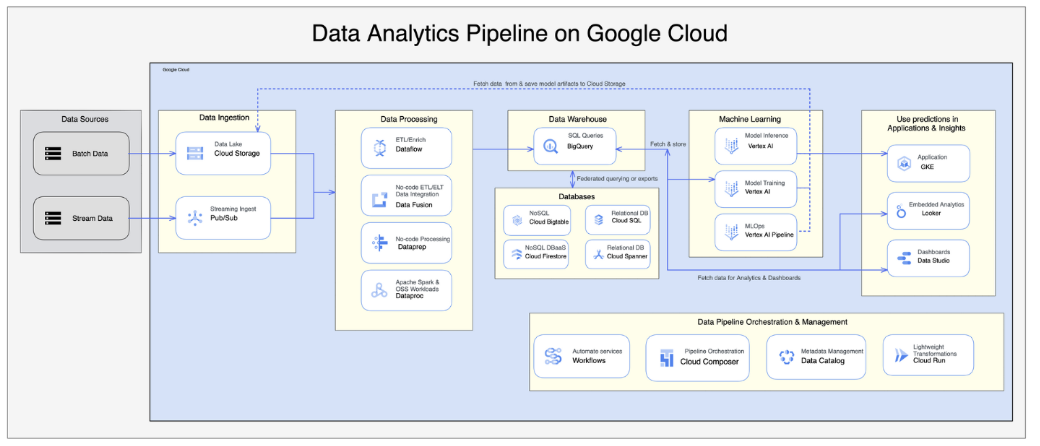
Bron: GCP Data Pipeline Architecture-artikel
De meeste vragen hier testen je expertise in het ontwerpen van oplossingen die zowel aan zakelijke als technische eisen voldoen. Je interviewer wil zeker weten dat de oplossingen die je voorstelt betrouwbaar, veilig en kosteneffectief zijn.
Je moet een goede kennis hebben van GCP’s kernservices en een diep begrip van hun mogelijkheden, use-cases en integratiepatronen.
Als cloudarchitect kun je verantwoordelijk zijn voor de migratie of integratie van complete systemen naar GCP. Daarom kunnen GCP-architectuurvragen je expertise testen op hybride of multicloudarchitecturen en best practices voor het ontwerpen van betrouwbare cloudoplossingen op schaal. Leun op je eerdere ervaring en vertel over use-cases en scenario’s die je in het verleden succesvol hebt aangepakt.
Enkele vragen en antwoorden zijn:
Voor de migratie van een grootschalige on-premises applicatie naar GCP begin ik met een assessmentfase om de huidige infrastructuur te evalueren en afhankelijkheden te identificeren. In de planningsfase ontwerp ik de migratiestrategie, inclusief het kiezen van passende GCP-services en tools zoals Migrate for Compute Engine voor VM-migratie en opties voor datatransfer. In de uitvoeringsfase herontwerp ik de applicatie voor de cloud, behandel ik afhankelijkheden, test ik grondig en implementeer ik strategieën om downtime te minimaliseren.
Multicloudapplicaties worden vaak gebruikt voor disaster recovery, data-analyse of workloadverdeling. Het integreren van GCP met andere cloudproviders brengt uitdagingen mee zoals netwerkconnectiviteit, datatransfer, identiteitsbeheer en het handhaven van security over omgevingen heen. Tools zoals Anthos helpen bij het beheren van multicloud Kubernetes-clusters en zorgen voor naadloze integratie en efficiënte operatie.
Voor disaster recovery en business continuity in een GCP-architectuur richt ik cross-regio-replicatie in om dataredundantie te waarborgen. Door failovermechanismen te implementeren blijft de service beschikbaar bij storingen. Regelmatige back-ups zijn cruciaal voor databescherming en ik test DR-procedures periodiek om te zorgen dat ze effectief en up-to-date zijn.
Voor kostenoptimalisatie op GCP gebruik ik Compute Engine Preemptible VM’s voor voordelige compute. Rightsizing van instances zorgt dat resources passend zijn toegewezen op basis van gebruik. Het benutten van committed use-kortingen kan de kosten verder verlagen. Daarnaast gebruik ik kostenbeheertools zoals Cost Explorer en Budgets om uitgaven te monitoren en te beheersen, met behoud van performance en schaalbaarheid.
Let op: Een vaak over het hoofd gezien onderwerp dat toch geregeld in interviews terugkomt, is kostenoptimalisatie. Volgens het Flexera 2024 State of the Cloud Report geven bedrijven kostenoptimalisatie prioriteit bij cloud computing, dus zorg dat je weet hoe je kostenbeheertools in GCP gebruikt en dat je strategieën begrijpt zoals resourceprovisioning en rightsizing.
Nu je beter weet wat je kunt verwachten in je GCP-interview, kun je de gaten in je kennis gaan dichten.
Hoewel theoretische cursussen geweldig zijn om te starten, vind ik dat hands-on oefenen met realistische scenario’s de beste manier is om GCP-expertise op te bouwen. Er zijn veel bronnen die je kunt gebruiken en ik raad de Google Cloud Training-cursussen aan als je je de maandelijkse $29 kunt veroorloven.
Daarnaast is DataCamp's DataLab een uitstekend platform om je skills te oefenen. DataLab is een cloudgebaseerd notebook waarmee je kunt experimenteren met code, data analyseren, samenwerken en inzichten delen zonder installatie. Het biedt een naadloze omgeving om met real-world data te werken en is daarmee een praktisch hulpmiddel om je datavaardigheden te slijpen.
Je kunt je studie ook verder uitbouwen en een officiële GCP-certificering aan je cv of LinkedIn-profiel toevoegen om je skills te tonen aan potentiële werkgevers. Voor elke certificering biedt Google een gratis oefenexamen. Die zijn bedoeld om je op de officiële test voor te bereiden, maar werken ook uitstekend voor interviews—dus neem ze zeker door.
Ik hoop dat je deze gids nuttig vond en wens je heel veel succes met je interview!
Leren met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

