
Leerpad
Data-engineer in Python
40 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleEen essentieel onderdeel van het aansturen van een succesvol bedrijf is het verzamelen van data, het opsporen van inconsistenties, die afhandelen, de data opslaan in een geïntegreerd platform en deze gebruiken om goed onderbouwde beslissingen te nemen.
Maar stel je voor dat je al deze taken elke keer dat je een project draait handmatig moet doen. Meer dan 40% van de werknemers besteedt minstens een kwart van hun werkweek aan dataverzamel- en invoertaken. Het is dan ook geen verrassing dat er tijdens het proces fouten bij gegevensinvoer of corruptie optreden.
Daar komt data-orchestratie om de hoek kijken. In dit artikel leggen we precies uit wat data-orchestratie is en waarom het cruciaal is. We bekijken ook een paar populaire data-orchestratietools om je op weg te helpen.
Data-orchestratie is een methode of tool die data-gerelateerde activiteiten beheert. De taken omvatten het verzamelen van data, kwaliteitscontroles uitvoeren, data tussen systemen verplaatsen, workflows automatiseren en meer.
Kort gezegd: data-orchestratie is de methode waarbij gesiloëde data op verschillende locaties wordt samengebracht, voorbereid en gepresenteerd voor analyse.
Data engineers hoeven niet langer aangepaste scripts te schrijven voor ETL-taken. In plaats daarvan verzamelen en ordenen data-orchestratietools de data, zodat die gemakkelijk toegankelijk is voor analysetools.
Data-orchestratie vereenvoudigt zaken door:
Afbeelding door de auteur
Vóór data-orchestratie moesten data engineers ongestructureerde data handmatig ophalen uit API's, spreadsheets en databases. Daarna maakten ze die data schoon, standaardiseerden het formaat en stuurden het naar doelsystemen.
Volgens een recente studie vindt 95% van de bedrijven dit proces lastig, vooral met ongestructureerde data. Data-orchestratie kan deze taken echter automatiseren. Het proces regelt het opschonen en voorbereiden van data en zorgt voor de juiste volgorde van datastromen tussen systemen.
We weten dat data-orchestratie data centraliseert. Maar wat als je je geen enkel groot opslagsysteem kunt veroorloven om alles op te slaan? In zo'n geval vereenvoudigt data-orchestratie het ophalen van data rechtstreeks vanaf de plek waar die is opgeslagen, vaak in realtime. Uiteindelijk betekent dit dat je geen enorm enkel opslagsysteem nodig hebt.
Daarnaast verbetert data-orchestratie de datakwaliteit. Neem datatransformatie als voorbeeld. Deze stap draait om het omzetten van data naar een standaardformaat en het waarborgen van consistentie en nauwkeurigheid in alle betrokken systemen.
Een ander groot pluspunt van data-orchestratie is het vermogen om data in realtime te beheren en te verwerken. Dynamische prijsstrategieën, aandelenhandel en -voorspellingen, en klantgedragstrends zijn gebieden waar realtime dataverwerking essentieel is, en data-orchestratie maakt dat eenvoudiger.
Tot slot is data-orchestratie essentieel voor iedereen die werkt met big data en frequente datastreamingtaken, vooral voor bedrijven die meerdere opslagsystemen beheren.
De drie belangrijkste stappen van data-orchestratie zijn dataverzameling, -voorbereiding en -activatie. Laten we ze in detail bekijken.
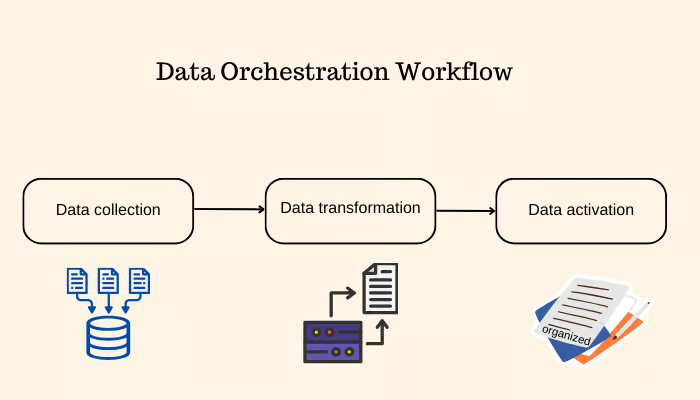
Afbeelding door de auteur
Data is niet altijd meteen perfect voor analyse zodra het uit een CSV-bestand komt. In eerste instantie moet je ruwe data verzamelen uit uiteenlopende bronnen zoals websites, API's en databases.
De eerste fase van orchestratie omvat daarom het verzamelen van data uit deze verschillende bronnen, het uitvoeren van integriteits- en nauwkeurigheidscontroles en het vervolgens voorbereiden voor de volgende stap.
Verschillende systemen kunnen hetzelfde veld in een dataset anders weergeven. Zo kan je customer relationship management (CRM)-software klant-ID's als getallen opslaan, terwijl de financiële database ze als strings bewaart.
Om dergelijke inconsistenties te voorkomen, gebruiken data-orchestratietools transformers die het dataformaat standaardiseren, zodat de data consistent en betrouwbaar is.
In deze laatste fase van orchestratie wordt de data operationeel ingezet. Geactiveerde data is gepolijste data die klaar is voor gebruik, door analyseteams of -tools.
Je kunt deze data eenvoudig analyseren om patronen, trends en uitdagingen te ontdekken binnen je marketing-, finance-, sales- en klantenserviceteams.
Je kunt deze inzichten gebruiken om gepersonaliseerde content voor je bezoekers te ontwerpen, aangepaste prijsplannen te offreren en premium klantenservice te leveren aan gerichte doelgroepen.
Orchestratie biedt veel kansen op het gebied van dataorganisatie en -analyse. Hier zijn een paar factoren die data-orchestratie stroomlijnt:
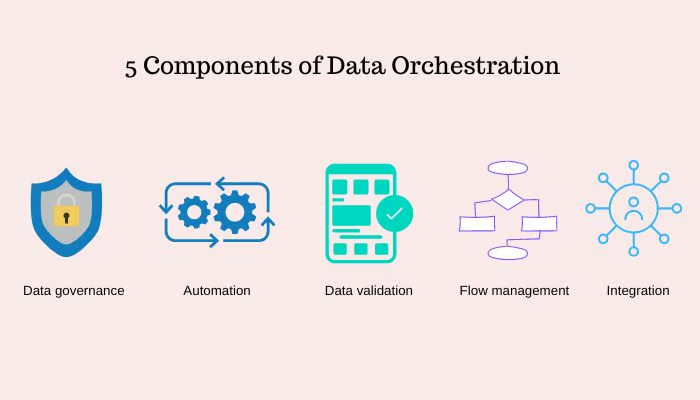
Afbeelding door de auteur
Het primaire doel van data-orchestratie is het automatiseren van diverse taken die komen kijken bij het verwerken van grote hoeveelheden data. Bij dataintegratie bijvoorbeeld automatiseren data-orchestratietools het verzamelen en combineren van data uit meerdere bronnen.
Tijdens datatransformatie zetten de tools verschillende dataformaten om naar één consistent formaat. Ze automatiseren ook de verplaatsing van data tussen systemen en pijplijnen.
Kortom, data-orchestratie automatiseert de taken die nodig zijn om data samen te brengen, het formaat te standaardiseren, het op te schonen voor analyse en de nauwkeurigheid te behouden.
Integratie houdt in dat data uit meerdere locaties wordt gecombineerd in een centrale opslag om een eenduidig beeld van je data te creëren. Orchestratie vereenvoudigt dit proces door data op vaste intervallen te verzamelen of op basis van de triggers die je instelt.
Zo kun je in de orchestratietool een regel instellen om automatisch data te verzamelen en te integreren zodra er een update in de pijplijn is.
Data-orchestratie automatiseert workflows door taken over pijplijnen heen in te plannen. Het automatiseert de datastroom tussen verschillende systemen en coördineert de juiste volgorde van bewerkingen.
Hoe zorgt het ervoor dat taken in de juiste volgorde draaien? Orchestratietools laten je aangepaste triggers definiëren om taken in te plannen.
Je kunt bijvoorbeeld een vaste volgorde voor de datastroom definiëren, zoals pijplijn 1 naar pijplijn 2 en vervolgens naar 3, of aangepaste voorwaarden instellen, zoals: als data aan bepaalde criteria voldoet, ga naar pijplijn 2, anders stuur naar pijplijn 3.
Data governance verwijst naar het waarborgen van de beschikbaarheid, kwaliteit en beveiliging van de data van je organisatie, een concept dat varieert per sector, domein en locatie.
Zo kan het alleen extraheren en opslaan van noodzakelijke data en het verwijderen ervan na gebruik worden beschouwd als een datagovernancebeleid.
Data-orchestratie volgt de herkomst van data, welke data wordt opgeslagen en hoe die gedurende de levenscyclus wordt getransformeerd. Deze registraties helpen je te voldoen aan governancebeleid en regelgevingen zoals de AVG en CCPA.
Data-orchestratie valideert je data regelmatig op kwaliteit en nauwkeurigheid. Sommige orchestratietools bevatten ingebouwde validators voor basiscontroles.
Zo controleert een datatypevalidator of de waarden in de kolom met namen zijn opgeslagen als string. De tools laten je ook aangepaste validatieregels instellen die specifiek zijn voor jouw behoeften.
We hebben eerder bekeken hoe data-orchestratie werkt. Zo kun je het proces starten en hierop let je bij het selecteren van de juiste data-orchestratietool.
De eerste stap in het orchestratieproces is het definiëren van je doelen. Bepaal wat je met dit proces wilt bereiken, of dat nu het inplannen van workflows is, het verenigen van data of het behouden van kwaliteitsdata.
Begin met het evalueren van je huidige data-infrastructuur, het vinden van inconsistenties, identificeren welke datataken de meeste tijd kosten en nagaan hoe gemakkelijk je analyseteam of -tools toegang hebben tot de huidige data. Is dat eenvoudig, of zijn er knelpunten?
Breng al deze pijnpunten in kaart en definieer de orchestratiedoelen die deze problemen kunnen aanpakken.
Zodra je de doelen hebt bepaald, is de volgende stap het vinden van tools die data-orchestratiemechanismen in je systemen kunnen implementeren. Hier zijn een paar overwegingen om je te helpen de juiste data-orchestratietool te kiezen:
Data-orchestratie wordt een onmisbaar middel om verschillende datataken te versnellen en in te plannen. Toch kent data-orchestratie zowel voordelen als uitdagingen.
Hier zijn enkele uitdagingen die aandacht kunnen vragen bij het implementeren van data-orchestratie in je systemen.
|
1. Wees specifiek in je doelen |
Duidelijke doelen helpen je workflows en het orchestratieproces op koers te houden en in lijn met de doelstellingen. |
|
2. Definieer heldere datakwaliteitsmetrics |
Als dataformaat, -structuur en -nauwkeurigheid je zorgen baren, monitor dan die metrics gedurende het hele orchestratieproces om kwaliteitsdata te behouden. |
|
3. Gebruik beheerde cloudoplossingen |
Beheerde cloudoplossingen zijn diensten van derden die verschillende data-orchestratietools eenvoudig verbinden met de andere platforms die jouw organisatie gebruikt. |
|
4. Implementeer databeveiligingsmaatregelen |
Implementeer standaard beveiligingsprotocollen en datagovernancebeleid om je data gedurende de hele orchestratielevenscyclus te beveiligen. |
|
5. Kies de juiste tools |
Let bij het kiezen van de orchestratietool op schaalbaarheid, gebruiksgemak, integraties, beveiligingsfuncties en meer. |
Elke data-gedreven organisatie maakt tegenwoordig gebruik van tools en technieken voor data-orchestratie om big data effectief te verwerken. Hier zijn enkele use-cases:
Veel organisaties hebben data in de cloud en computeresources in-house, of andersom. In zulke gevallen ontstaan vertragingen omdat on-premise tools moeten communiceren met data op cloudservers. Data-orchestratie overbrugt echter deze kloof en helpt ze met elkaar te communiceren en samen te werken alsof ze in dezelfde omgeving zitten.
80% van de kijktijd bij Netflix komt via het aanbevelingssysteem. Dat systeem gebruikt Netflix Maestro, een workflow-orchestrator om de zeer grootschalige dataworkflows van Netflix te draaien.
Als klantgedrag, voorraaddata, financiële transacties, advertentieweergaven en productaanbevelingen op aparte platforms staan, helpt dat e-commercebedrijven niet om inzichten te verkrijgen. Daarom gebruiken e-commercebedrijven data-orchestratie om deze data te verenigen en om te zetten in bruikbare inzichten.
Orchestratietools automatiseren en stroomlijnen taken en technieken voor data-orchestratie. Ze verzorgen alles van dataverzameling tot -activatie, verminderen menselijke fouten en verbeteren efficiëntie en snelheid.
De markt is overspoeld met opties, dus we hebben het onderzoek voor je gedaan en enkele populaire data-orchestratietools geselecteerd:
Afbeelding door de auteur
Apache Airflow is een open-source orchestratietool om workflows of pijplijnen te maken, in te plannen en te monitoren met Python. De workflows van de tool worden weergegeven als een Directed Acyclic Graph (DAG) om taken en hun afhankelijkheden binnen workflows te organiseren.
Uitleg van DAG's:
Met de gebruiksvriendelijke interface navigeer je snel naar bepaalde DAG's en volg je de status en logs van diverse taken.
Prefect is een andere Python-gebaseerde orchestratietool om workflows tussen datapijplijnen te bouwen en te automatiseren. Met Prefect kun je complexe taakafhankelijkheden en -sequenties opsplitsen in overzichtelijke subflows.
Prefect ondersteunt het uitvoeren van taken tijdens runtime, het draaien van workflows in hybride omgevingen, het cachen van vaak uitgevoerde pijplijnresultaten en meer.
Een cloudgebaseerd platform voor het moeiteloos ontwerpen en uitvoeren van datapijplijnen. Met Keboola-extractors kun je data uit elke bron ophalen en eenvoudig in het platform laden. Zodra de data binnen is, kun je de transformaties van de tool gebruiken om die te standaardiseren.
De component "Applications" van Keboola voert uitgebreide datamanipulatie- en transformatietaken uit.
Dragster is een open-source data-orchestrator die het maken en onderhouden van datapijplijnen vereenvoudigt. Geïnspireerd door Airflow kun je met de tool workflow-DAG's maken met een Python-gebaseerde domain-specific language (DSL).
Zo kunnen ontwikkelaars hun afhankelijkheden en transformaties eenvoudig definiëren met de tool.
Data-orchestratie vereenvoudigt het bouwen van geautomatiseerde dataworkflows door dataverzameling, datatransformatie en dataverplaatsing binnen pijplijnen te verzorgen. Dit maakt het voor bedrijven makkelijker om met big data om te gaan, ETL-taken uit te voeren en ML-implementaties op te schalen.
In deze tutorial hebben we alles doorgenomen wat je nodig hebt om te beginnen met data-orchestratie, een breed toegepaste techniek onder data engineers van vandaag. Ga verder met leren via deze bronnen:
Word vandaag nog Data Engineer!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

