किसी भी सफल व्यवसाय को आगे बढ़ाने का एक अहम हिस्सा है डेटा इकट्ठा करना, असंगतियों की पहचान करना, उनका समाधान करना, डेटा को एकीकृत प्लेटफ़ॉर्म में संग्रहीत करना, और सूचित निर्णय लेने के लिए उसका उपयोग करना।
पर कल्पना कीजिए कि हर बार प्रोजेक्ट चलाते समय ये सभी कार्य हाथ से करने पड़ें। 40% से अधिक कर्मचारी अपने कार्य-सप्ताह का कम से कम एक-चौथाई हिस्सा डेटा संग्रह और एंट्री कार्यों में बिताते हैं। साथ ही, इस प्रक्रिया के दौरान डेटा एंट्री त्रुटियाँ या करप्शन समस्याएँ होना भी अचरज नहीं है।
यहीं डेटा ऑर्केस्ट्रेशन काम आता है। यह लेख बताता है कि डेटा ऑर्केस्ट्रेशन वास्तव में क्या है और यह क्यों महत्वपूर्ण है। हम आपको शुरुआत करने में मदद के लिए कुछ लोकप्रिय डेटा ऑर्केस्ट्रेशन टूल्स का भी अन्वेषण करेंगे।
डेटा ऑर्केस्ट्रेशन क्या है?
डेटा ऑर्केस्ट्रेशन एक विधि या टूल है जो डेटा-संबंधित गतिविधियों का प्रबंधन करता है। कार्यों में डेटा एकत्र करना, गुणवत्ता जाँच करना, सिस्टमों के बीच डेटा स्थानांतरित करना, वर्कफ़्लो को स्वचालित करना, और बहुत कुछ शामिल है।
सरल शब्दों में, डेटा ऑर्केस्ट्रेशन वह तरीका है जिसमें अलग-अलग स्थानों पर बिखरे डेटा को मिलाकर तैयार किया जाता है और विश्लेषण के लिए प्रस्तुत किया जाता है।
डेटा इंजीनियरों को अब ETL कार्यों के लिए कस्टम स्क्रिप्ट बनाने की ज़रूरत नहीं रहती। इसकी बजाय, डेटा ऑर्केस्ट्रेशन टूल्स डेटा को इकट्ठा और व्यवस्थित करते हैं, जिससे वह एनालिटिक्स टूल्स के लिए तुरंत सुलभ हो जाता है।
डेटा ऑर्केस्ट्रेशन चीजों को इस प्रकार आसान बनाता है:
- अलग-अलग डेटा स्रोतों को एकीकृत करना
- वर्कफ़्लो ईवेंट्स को सही क्रम में निष्पादित करना
- डेटा को वांछित फ़ॉर्मेट में बदलना
- विभिन्न स्टोरेज प्लेटफ़ॉर्म्स के बीच डेटा प्रवाह को स्वचालित करना
डेटा ऑर्केस्ट्रेशन महत्वपूर्ण क्यों है?
चित्र: लेखक द्वारा
डेटा ऑर्केस्ट्रेशन से पहले, डेटा इंजीनियरों को APIs, स्प्रेडशीट्स और डेटाबेस से असंरचित डेटा को मैन्युअल रूप से निकालना पड़ता था। फिर वे उस डेटा को साफ़ करते, फ़ॉर्मेट को मानकीकृत करते और उसे लक्षित सिस्टमों तक भेजते थे।
एक हालिया अध्ययन के अनुसार, 95% व्यवसाय इस प्रक्रिया को कठिन पाते हैं, खासकर असंरचित डेटा के साथ। हालाँकि, डेटा ऑर्केस्ट्रेशन इन कार्यों को स्वचालित कर सकता है। यह प्रक्रिया डेटा की सफ़ाई और तैयारी को नियंत्रित करती है और सिस्टमों के बीच डेटा प्रवाह के सही क्रम को सुनिश्चित करती है।
हम जानते हैं कि डेटा ऑर्केस्ट्रेशन डेटा को केंद्रीकृत करता है। पर यदि आप इसे सहेजने के लिए एक बड़ा एकल स्टोरेज सिस्टम वहन नहीं कर सकते तो? ऐसे में, डेटा ऑर्केस्ट्रेशन डेटा को उसी स्थान से लाना सरल बना देता है जहाँ वह संग्रहीत है, अक्सर रीयल-टाइम में। अंततः, इसका अर्थ है कि आपको एक विशाल एकल स्टोरेज सिस्टम की आवश्यकता नहीं है।
साथ ही, डेटा ऑर्केस्ट्रेशन डेटा की गुणवत्ता में सुधार करता है। उदाहरण के लिए, डेटा ट्रांसफ़ॉर्मेशन को लें। यह चरण डेटा को एक मानक फ़ॉर्मेट में बदलने और शामिल सिस्टमों में स्थिरता और सटीकता सुनिश्चित करने के बारे में है।
डेटा ऑर्केस्ट्रेशन का एक और बड़ा लाभ इसकी रीयल-टाइम में डेटा प्रबंधन और प्रोसेसिंग करने की क्षमता है। डायनेमिक प्राइसिंग रणनीतियाँ, स्टॉक ट्रेडिंग और पूर्वानुमान, और ग्राहक व्यवहार रुझान कुछ ऐसे क्षेत्र हैं जहाँ रीयल-टाइम प्रोसेसिंग जरूरी है—और डेटा ऑर्केस्ट्रेशन इन्हें सरल बनाता है।
अंततः, डेटा ऑर्केस्ट्रेशन उन सभी के लिए आवश्यक है जो बिग डेटा और बारंबार डेटा स्ट्रीमिंग कार्यों से निपटते हैं, खासकर वे कंपनियाँ जो कई स्टोरेज सिस्टम्स का प्रबंधन करती हैं।
डेटा ऑर्केस्ट्रेशन कैसे काम करता है
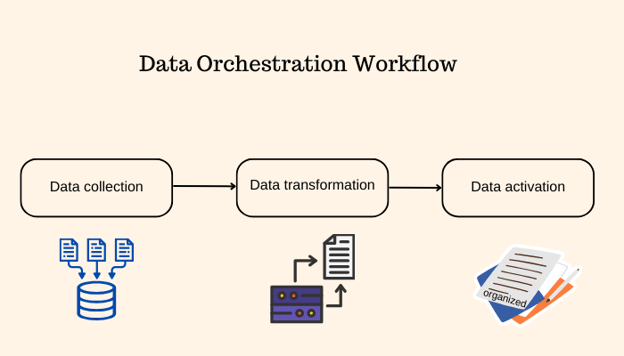
डेटा ऑर्केस्ट्रेशन के तीन मुख्य चरण हैं: डेटा संग्रह, तैयारी और सक्रियण। आइए इन्हें विस्तार से समझते हैं।
चित्र: लेखक द्वारा
डेटा संग्रह और तैयारी
विश्लेषण के लिए डेटा हमेशा CSV फ़ाइल से सीधे पूर्णतः उपयुक्त नहीं होता। शुरुआत में, आपको वेबसाइटों, APIs और डेटाबेस जैसे विभिन्न स्रोतों से कच्चा डेटा एकत्र करना होगा।
इसलिए, ऑर्केस्ट्रेशन का पहला चरण इन विभिन्न स्रोतों से डेटा इकट्ठा करना, अखंडता और सटीकता की जाँच करना, और फिर अगले चरण के लिए उसे तैयार करना शामिल है।
डेटा ट्रांसफ़ॉर्मेशन
विभिन्न सिस्टम एक ही डेटासेट के फ़ील्ड को अलग-अलग ढंग से प्रस्तुत करते हैं। उदाहरण के लिए, आपका कस्टमर रिलेशन मैनेजमेंट (CRM) सॉफ़्टवेयर ग्राहक IDs को संख्याओं के रूप में संग्रहीत कर सकता है, जबकि वित्तीय डेटाबेस उन्हें स्ट्रिंग्स में रख सकता है।
ऐसी असंगतियों से बचने के लिए, डेटा ऑर्केस्ट्रेशन टूल्स ट्रांसफ़ॉर्मर्स का उपयोग करते हैं जो डेटा फ़ॉर्मेट को मानकीकृत करते हैं, जिससे सुसंगत और विश्वसनीय डेटा सुनिश्चित होता है।
डेटा सक्रियण
ऑर्केस्ट्रेशन का यह अंतिम चरण डेटा को परिचालन उपयोग में लाता है। सक्रियित डेटा वह परिष्कृत डेटा है जो एनालिटिक्स टीमों या टूल्स द्वारा उपयोग के लिए तैयार होता है।
आप अपने मार्केटिंग, वित्त, बिक्री और ग्राहक सहायता विभागों में पैटर्न, रुझान और चुनौतियों की खोज के लिए इस डेटा का आसानी से विश्लेषण कर सकते हैं।
आप इन निष्कर्षों का उपयोग अपने आगंतुकों के लिए वैयक्तिकृत सामग्री डिज़ाइन करने, अनुकूलित मूल्य-योजनाएँ पेश करने और लक्षित दर्शकों के लिए प्रीमियम ग्राहक सेवा प्रदान करने में कर सकते हैं।
डेटा ऑर्केस्ट्रेशन के प्रमुख विचार
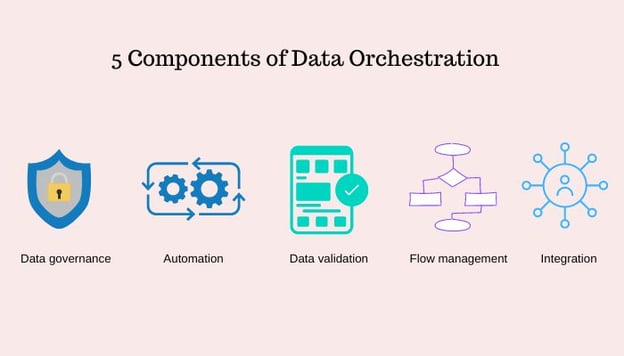
ऑर्केस्ट्रेशन डेटा संगठन और विश्लेषण में कई संभावनाएँ प्रदान करता है। यहाँ कुछ कारक हैं जिन्हें डेटा ऑर्केस्ट्रेशन सुव्यवस्थित करता है:
चित्र: लेखक द्वारा
स्वचालन
डेटा ऑर्केस्ट्रेशन का प्राथमिक उद्देश्य बड़े पैमाने पर डेटा संभालने में शामिल विभिन्न कार्यों को स्वचालित करना है। उदाहरण के लिए, डेटा इंटीग्रेशन में, डेटा ऑर्केस्ट्रेशन टूल्स कई स्रोतों से डेटा के संग्रह और संयोजन को स्वचालित कर देते हैं।
डेटा ट्रांसफ़ॉर्मेशन के दौरान, टूल्स विभिन्न डेटा फ़ॉर्मेट्स को एक एकल, सुसंगत फ़ॉर्मेट में बदलते हैं। वे सिस्टमों और पाइपलाइनों में डेटा की आवाजाही को भी स्वचालित करते हैं।
कुल मिलाकर, डेटा ऑर्केस्ट्रेशन उन कार्यों को स्वचालित करता है जिनमें डेटा को साथ लाना, उसके फ़ॉर्मेट को मानकीकृत करना, विश्लेषण के लिए उसे साफ़ करना और सटीक डेटा बनाए रखना शामिल है।
डेटा एकीकरण
इंटीग्रेशन का अर्थ है कई स्थानों से डेटा को एक केंद्रीकृत रिपॉज़िटरी में जोड़ना ताकि आपके डेटा का एकीकृत दृश्य बनाया जा सके। ऑर्केस्ट्रेशन इस प्रक्रिया को आसान बनाता है—डेटा को नियमित अंतराल पर या आपके द्वारा निर्धारित ट्रिगर्स के आधार पर एकत्र करके।
उदाहरण के लिए, आप ऑर्केस्ट्रेशन टूल में एक नियम सेट कर सकते हैं कि पाइपलाइन में कोई अपडेट होने पर डेटा को स्वचालित रूप से एकत्रित और एकीकृत किया जाए।
डेटा फ़्लो प्रबंधन
डेटा ऑर्केस्ट्रेशन पाइपलाइनों के बीच कार्यों को शेड्यूल करके वर्कफ़्लोज़ को स्वचालित करता है। यह विभिन्न सिस्टमों के बीच डेटा के प्रवाह को स्वचालित करता है, और ऑपरेशनों के सही क्रम का समन्वय करता है।
तो, यह कैसे सुनिश्चित करता है कि कार्य सही क्रम में चलें? ऑर्केस्ट्रेशन टूल्स आपको कार्यों को शेड्यूल करने के लिए कस्टम ट्रिगर्स परिभाषित करने देते हैं।
उदाहरण के लिए, आप डेटा फ़्लो के लिए एक निश्चित क्रम परिभाषित कर सकते हैं—जैसे पाइपलाइन 1 से 2 और फिर 3—या कस्टम शर्तें लगा सकते हैं, जैसे यदि डेटा कुछ मानदंडों को पूरा करता है तो उसे पाइपलाइन 2 में भेजें, अन्यथा पाइपलाइन 3 में भेजें।
डेटा गवर्नेंस
डेटा गवर्नेंस से तात्पर्य आपकी संस्था के डेटा की उपलब्धता, गुणवत्ता और सुरक्षा बनाए रखने से है—जो उद्योग, डोमेन और स्थान के अनुसार भिन्न हो सकता है।
उदाहरण के लिए, केवल आवश्यक डेटा निकालना और संग्रहीत करना और उपयोग के बाद उसे हटा देना—इसे डेटा गवर्नेंस नीति माना जा सकता है।
डेटा ऑर्केस्ट्रेशन डेटा के स्रोत, कौन-सा डेटा संग्रहीत है, और जीवनचक्र के दौरान वह कैसे रूपांतरित होता है, इन सबका ट्रैक रखता है। ये अभिलेख आपको GDPR और CCPA जैसी गवर्नेंस नीतियों और विनियमों का पालन करने में मदद करेंगे।
डेटा मान्यकरण
डेटा ऑर्केस्ट्रेशन नियमित रूप से आपके डेटा की गुणवत्ता और सटीकता का सत्यापन करता है। कुछ ऑर्केस्ट्रेशन टूल्स में बुनियादी गुणवत्ता जाँच के लिए बिल्ट-इन वैलिडेटर्स होते हैं।
उदाहरण के लिए, एक डेटा टाइप वैलिडेटर जाँचता है कि नेम कॉलम के मान स्ट्रिंग डेटा टाइप में संग्रहीत हैं या नहीं। टूल्स आपको अपनी आवश्यकताओं के अनुरूप कस्टम वैलिडेशन नियम स्थापित करने की सुविधा भी देते हैं।
डेटा ऑर्केस्ट्रेशन लागू करना
हमने पहले के अनुभागों में देखा कि डेटा ऑर्केस्ट्रेशन कैसे काम करता है। तो यहाँ बताया गया है कि आप प्रक्रिया कैसे शुरू कर सकते हैं और सही डेटा ऑर्केस्ट्रेशन टूल चुनने के लिए कुछ प्रमुख सुझाव।
योजना बनाना और अपनी आवश्यकताओं का आकलन करना
ऑर्केस्ट्रेशन प्रक्रिया का पहला कदम अपने लक्ष्यों को परिभाषित करना है। तय करें कि आप इस प्रक्रिया के माध्यम से क्या हासिल करना चाहते हैं—चाहे वह वर्कफ़्लो शेड्यूल करना हो, डेटा को एकीकृत करना हो, या गुणवत्तापूर्ण डेटा बनाए रखना हो।
अपनी मौजूदा डेटा अवसंरचना का मूल्यांकन करना शुरू करें, असंगतियाँ ढूँढें, यह पहचानें कि कौन-से डेटा कार्य अधिक समय ले रहे हैं, और जाँचें कि आपकी एनालिटिक्स टीम या टूल्स वर्तमान डेटा तक कितनी आसानी से पहुँच पाते हैं। क्या यह उनके लिए आसान है, या कोई कठिनाई है?
इन सभी दर्द-बिंदुओं की पहचान करें और उन ऑर्केस्ट्रेशन लक्ष्यों को परिभाषित करें जो इन मुद्दों का समाधान कर सकें।
सही टूल्स का चयन
एक बार लक्ष्य तय हो जाने पर अगला कदम ऐसे टूल्स ढूँढना है जो आपके सिस्टम्स में डेटा ऑर्केस्ट्रेशन तंत्र लागू कर सकें। सही डेटा ऑर्केस्ट्रेशन टूल चुनने में मदद के लिए यहाँ कुछ बातें ध्यान में रखें:
- ऐसा लचीला टूल चुनें जो भविष्य में आसानी से अपडेट और डिप्लॉयमेंट की अनुमति दे।
- क्योंकि आपको कई स्रोतों से डेटा संभालना है, सुनिश्चित करें कि चुना गया ऑर्केस्ट्रेशन टूल आपके विभिन्न डेटा वेयरहाउस, एनालिटिक्स प्लेटफ़ॉर्म्स, पाइपलाइनों आदि के साथ अच्छी तरह इंटीग्रेट हो सके।
- अपने व्यवसाय की वृद्धि पर विचार करें। सुनिश्चित करें कि आप ऐसा टूल चुनें जो आपकी डेटा आवश्यकताओं के साथ स्केल कर सके।
- बिल्ट-इन एडिटर्स वाला उपयोगकर्ता-अनुकूल टूल आपको वर्कफ़्लो आसानी से डिज़ाइन करने, कार्यों को शेड्यूल करने, एक्सेस कंट्रोल सेट करने आदि में मदद करता है।
डेटा ऑर्केस्ट्रेशन की आम चुनौतियाँ
डेटा ऑर्केस्ट्रेशन विभिन्न डेटा कार्यों को तेज़ करने और शेड्यूल करने के लिए एक आवश्यक संपत्ति बनता जा रहा है। हालाँकि, डेटा ऑर्केस्ट्रेशन के साथ फायदे भी हैं और चुनौतियाँ भी।
यहाँ कुछ चुनौतियाँ दी गई हैं जिन पर अपने सिस्टम्स में डेटा ऑर्केस्ट्रेशन लागू करते समय ध्यान देने की आवश्यकता हो सकती है।
- सुरक्षा: ऑर्केस्ट्रेशन प्रक्रिया के दौरान डेटा इधर-उधर होता है, इसलिए SSL/TLS एन्क्रिप्शन, डेटा एक्सेस कंट्रोल्स, मल्टी-फैक्टर ऑथेंटिकेशन आदि जैसे सुरक्षा उपाय लागू करना महत्वपूर्ण है।
- रीयल-टाइम डेटा स्ट्रीमिंग: रीयल-टाइम डेटा की माँग बढ़ रही है। ऐसे में, आपके डेटा ऑर्केस्ट्रेशन प्रक्रिया को पाइपलाइनों के बीच डेटा को न्यूनतम विलंब के साथ तेज़ी से ले जाने में सक्षम होना चाहिए।
- संसाधन प्रबंधन: समानांतर निष्पादन के दौरान, अलग-अलग प्रक्रियाओं को एक ही कंप्यूटिंग संसाधनों या अवसंरचना की आवश्यकता हो सकती है। कार्यों की प्राथमिकता तय करना और सही संसाधन आवंटन चुनौतीपूर्ण हो सकता है।
- प्रतिभा आवश्यकताएँ: आपको अपने सिस्टम्स में डेटा ऑर्केस्ट्रेशन टूल्स और तकनीकों को स्थापित और सेट अप करने के लिए कुशल डेटा पेशेवरों को नियुक्त या प्रशिक्षित करना होगा।
- डेटा साइलोज़: यह आम बात है कि आपका वित्तीय डेटा मार्केटिंग टीमों के लिए सुलभ न हो और HR डेटा टेक विभाग के लिए उपलब्ध न हो। ऐसी सीमित पहुँच डेटा पाइपलाइनों के बीच अंतःक्रियाओं को प्रतिबंधित कर सकती है।
प्रभावी डेटा ऑर्केस्ट्रेशन के लिए रणनीतियाँ
|
1. अपने लक्ष्यों में विशिष्ट रहें
|
स्पष्ट लक्ष्य परिभाषित करने से आप वर्कफ़्लो और ऑर्केस्ट्रेशन प्रक्रिया को पटरी पर और उद्देश्यों के अनुरूप रख पाते हैं।
|
|
2. स्पष्ट डेटा गुणवत्ता मीट्रिक्स तय करें
|
यदि डेटा का फ़ॉर्मेट, संरचना और सटीकता आपको चिंतित करती है, तो गुणवत्ता बनाए रखने के लिए ऑर्केस्ट्रेशन प्रक्रिया के दौरान उन मीट्रिक्स की निगरानी करें।
|
|
3. प्रबंधित क्लाउड समाधान अपनाएँ
|
प्रबंधित क्लाउड समाधान थर्ड-पार्टी सेवाएँ होती हैं जो आपकी संस्था द्वारा उपयोग किए जाने वाले अन्य प्लेटफ़ॉर्म्स के साथ विभिन्न डेटा ऑर्केस्ट्रेशन टूल्स को आसानी से जोड़ती हैं।
|
|
4. डेटा सुरक्षा उपाय लागू करें
|
ऑर्केस्ट्रेशन जीवनचक्र के दौरान अपने डेटा को सुरक्षित रखने के लिए मानक सुरक्षा प्रोटोकॉल और डेटा गवर्नेंस नीतियाँ लागू करें।
|
|
5. सही टूल्स चुनें
|
ऑर्केस्ट्रेशन टूल तय करते समय स्केलेबिलिटी, उपयोग में आसानी, इंटीग्रेशन, सुरक्षा सुविधाएँ आदि पर विचार करें।
|
डेटा ऑर्केस्ट्रेशन के केस स्टडीज़
आज हर डेटा-चालित कंपनी बिग डेटा को प्रभावी ढंग से संभालने के लिए डेटा ऑर्केस्ट्रेशन टूल्स और तकनीकों का उपयोग करती है। इसके कुछ उपयोग-परिदृश्य यहाँ हैं:
हाइब्रिड परिवेश
कई संगठनों का डेटा क्लाउड में होता है और कंप्यूटिंग संसाधन इन-हाउस, या इसका उल्टा। ऐसे मामलों में देरी होती है क्योंकि ऑन-प्रिमाइसेस टूल्स को क्लाउड सर्वर पर मौजूद डेटा के साथ इंटरैक्ट करना पड़ता है। हालाँकि, डेटा ऑर्केस्ट्रेशन इस अंतर को पाटता है, उन्हें ऐसे संचार और साथ काम करने में सक्षम बनाता है मानो वे एक ही परिवेश में हों।
रीयल-टाइम डेटा स्ट्रीमिंग
Netflix के स्ट्रीम समय का 80% उसके रिकमेंडर सिस्टम के माध्यम से आता है। यह रिकमेंडर सिस्टम Netflix Maestro का उपयोग करता है—एक वर्कफ़्लो ऑर्केस्ट्रेटर—जो Netflix के अति-वृहद डेटा वर्कफ़्लोज़ को चलाता है।
ई-कॉमर्स
ग्राहक व्यवहार, इन्वेंट्री डेटा, वित्तीय लेनदेन, विज्ञापनों के प्रदर्शन और उत्पाद अनुशंसाओं का डेटा यदि अलग-अलग प्लेटफ़ॉर्म्स पर बिखरा हो तो ई-कॉमर्स व्यवसायों को अंतर्दृष्टि निकालने में मदद नहीं मिलती। यही कारण है कि ई-कॉमर्स व्यवसाय इस डेटा को एकीकृत करने और क्रियाशील अंतर्दृष्टि निकालने के लिए डेटा ऑर्केस्ट्रेशन का लाभ उठाते हैं।
लोकप्रिय ऑर्केस्ट्रेशन टूल्स का अवलोकन
ऑर्केस्ट्रेशन टूल्स डेटा ऑर्केस्ट्रेशन कार्यों और तकनीकों को स्वचालित और सुव्यवस्थित करते हैं। वे डेटा संग्रह से लेकर सक्रियण तक सब संभालते हैं, मानव त्रुटियों को कम करते हैं और दक्षता व गति में सुधार करते हैं।
बाज़ार विकल्पों से भरा हुआ है, इसलिए हमने आपके लिए शोध किया है और कुछ लोकप्रिय डेटा ऑर्केस्ट्रेशन टूल्स चुने हैं:
चित्र: लेखक द्वारा
Apache Airflow
Apache Airflow एक ओपन-सोर्स ऑर्केस्ट्रेशन टूल है जो Python का उपयोग करके वर्कफ़्लो या पाइपलाइन बनाने, शेड्यूल करने और मॉनिटर करने के लिए है। टूल के वर्कफ़्लोज़ को Directed Acyclic Graph (DAG) के रूप में दर्शाया जाता है ताकि वर्कफ़्लोज़ के भीतर कार्यों और उनकी निर्भरताओं को व्यवस्थित किया जा सके।
DAGs को समझना:
- Directed: कार्यों के बीच परिभाषित आवाजाही या संबंध। यानी कार्य एक परिभाषित पथ में जुड़े होते हैं। उदाहरण के लिए, टास्क 1 टास्क 2 पर निर्भर है, अर्थात टास्क 1 केवल टास्क 2 के पूरा होने के बाद ही चलता है।
- Acyclic: निर्भरताओं में लूप न होने को सुनिश्चित करता है। उदाहरण के लिए, यदि टास्क 1 टास्क 2 पर निर्भर है और टास्क 2 टास्क 1 पर, तो यह एक न ख़त्म होने वाला लूप है। आर्किटेक्चर ऐसे लूप्स से बचता है ताकि कार्य सुचारु रूप से चल सकें।
इसके आसान यूज़र इंटरफ़ेस के साथ, आप कुछ ही क्लिक में विशिष्ट DAGs तक नेविगेट कर सकते हैं और विभिन्न कार्यों की स्थिति और लॉग्स ट्रैक कर सकते हैं।
Prefect
Prefect एक और Python-आधारित ऑर्केस्ट्रेशन टूल है जिसका उपयोग डेटा पाइपलाइनों के बीच वर्कफ़्लोज़ बनाने और स्वचालित करने के लिए किया जाता है। Prefect के साथ, आप जटिल कार्य-निर्भरताओं और अनुक्रमों को सुव्यवस्थित सब-फ़्लोज़ में विभाजित कर सकते हैं।
Prefect की विशेषताओं में रनटाइम पर कार्यों का निष्पादन, हाइब्रिड परिवेशों में वर्कफ़्लोज़ चलाना, बार-बार निष्पादित होने वाले पाइपलाइन परिणामों को कैश करना, और बहुत कुछ शामिल है।
Keboola
डेटा पाइपलाइनों को सहजता से डिज़ाइन और निष्पादित करने के लिए क्लाउड-आधारित प्लेटफ़ॉर्म। Keboola एक्सट्रैक्टर्स के साथ, आप किसी भी स्रोत से डेटा ला सकते हैं और उसे आसानी से प्लेटफ़ॉर्म में लोड कर सकते हैं। डेटा आ जाने के बाद, आप टूल के ट्रांसफ़ॉर्मेशंस का उपयोग करके उसे मानकीकृत कर सकते हैं।
Keboola का “Applications” कंपोनेंट व्यापक डेटा मैनिप्युलेशन और ट्रांसफ़ॉर्मेशन कार्य करता है।
Dragster
Dragster एक ओपन-सोर्स डेटा ऑर्केस्ट्रेटर है जो डेटा पाइपलाइनों को बनाना और बनाए रखना सरल बनाता है। Airflow से प्रेरित यह टूल आपको Python-आधारित डोमेन-विशिष्ट भाषा (DSL) का उपयोग करके वर्कफ़्लो DAGs बनाने देता है।
इस तरह, डेवलपर्स टूल का उपयोग करके अपनी निर्भरताओं और ट्रांसफ़ॉर्मेशंस को आसानी से परिभाषित कर सकते हैं।
निष्कर्ष
डेटा ऑर्केस्ट्रेशन, पाइपलाइनों को बनाए रखने में शामिल डेटा संग्रह, डेटा ट्रांसफ़ॉर्मेशन और डेटा मूवमेंट कार्यों को संभालकर स्वचालित डेटा वर्कफ़्लो बनाने की प्रक्रिया को सरल बनाता है। इससे कंपनियों के लिए बिग डेटा संभालना, ETL कार्य निष्पादित करना और ML डिप्लॉयमेंट स्केल करना आसान हो जाता है।
इस ट्यूटोरियल में, हमने आज के डेटा इंजीनियरों के बीच व्यापक रूप से प्रचलित डेटा ऑर्केस्ट्रेशन के साथ शुरुआत करने के लिए आवश्यक सभी बातों पर चर्चा की। सीखना जारी रखने के लिए, इन संसाधनों पर नज़र डालें:


किसी भी सफल व्यवसाय को आगे बढ़ाने का एक अहम हिस्सा है डेटा इकट्ठा करना, असंगतियों की पहचान करना, उनका समाधान करना, डेटा को एकीकृत प्लेटफ़ॉर्म में संग्रहीत करना, और सूचित निर्णय लेने के लिए उसका उपयोग करना।
पर कल्पना कीजिए कि हर बार प्रोजेक्ट चलाते समय ये सभी कार्य हाथ से करने पड़ें। 40% से अधिक कर्मचारी अपने कार्य-सप्ताह का कम से कम एक-चौथाई हिस्सा डेटा संग्रह और एंट्री कार्यों में बिताते हैं। साथ ही, इस प्रक्रिया के दौरान डेटा एंट्री त्रुटियाँ या करप्शन समस्याएँ होना भी अचरज नहीं है।
यहीं डेटा ऑर्केस्ट्रेशन काम आता है। यह लेख बताता है कि डेटा ऑर्केस्ट्रेशन वास्तव में क्या है और यह क्यों महत्वपूर्ण है। हम आपको शुरुआत करने में मदद के लिए कुछ लोकप्रिय डेटा ऑर्केस्ट्रेशन टूल्स का भी अन्वेषण करेंगे।
डेटा ऑर्केस्ट्रेशन क्या है?
डेटा ऑर्केस्ट्रेशन एक विधि या टूल है जो डेटा-संबंधित गतिविधियों का प्रबंधन करता है। कार्यों में डेटा एकत्र करना, गुणवत्ता जाँच करना, सिस्टमों के बीच डेटा स्थानांतरित करना, वर्कफ़्लो को स्वचालित करना, और बहुत कुछ शामिल है।
सरल शब्दों में, डेटा ऑर्केस्ट्रेशन वह तरीका है जिसमें अलग-अलग स्थानों पर बिखरे डेटा को मिलाकर तैयार किया जाता है और विश्लेषण के लिए प्रस्तुत किया जाता है।
डेटा इंजीनियरों को अब ETL कार्यों के लिए कस्टम स्क्रिप्ट बनाने की ज़रूरत नहीं रहती। इसकी बजाय, डेटा ऑर्केस्ट्रेशन टूल्स डेटा को इकट्ठा और व्यवस्थित करते हैं, जिससे वह एनालिटिक्स टूल्स के लिए तुरंत सुलभ हो जाता है।
डेटा ऑर्केस्ट्रेशन चीजों को इस प्रकार आसान बनाता है:
डेटा ऑर्केस्ट्रेशन महत्वपूर्ण क्यों है?
चित्र: लेखक द्वारा
डेटा ऑर्केस्ट्रेशन से पहले, डेटा इंजीनियरों को APIs, स्प्रेडशीट्स और डेटाबेस से असंरचित डेटा को मैन्युअल रूप से निकालना पड़ता था। फिर वे उस डेटा को साफ़ करते, फ़ॉर्मेट को मानकीकृत करते और उसे लक्षित सिस्टमों तक भेजते थे।
एक हालिया अध्ययन के अनुसार, 95% व्यवसाय इस प्रक्रिया को कठिन पाते हैं, खासकर असंरचित डेटा के साथ। हालाँकि, डेटा ऑर्केस्ट्रेशन इन कार्यों को स्वचालित कर सकता है। यह प्रक्रिया डेटा की सफ़ाई और तैयारी को नियंत्रित करती है और सिस्टमों के बीच डेटा प्रवाह के सही क्रम को सुनिश्चित करती है।
हम जानते हैं कि डेटा ऑर्केस्ट्रेशन डेटा को केंद्रीकृत करता है। पर यदि आप इसे सहेजने के लिए एक बड़ा एकल स्टोरेज सिस्टम वहन नहीं कर सकते तो? ऐसे में, डेटा ऑर्केस्ट्रेशन डेटा को उसी स्थान से लाना सरल बना देता है जहाँ वह संग्रहीत है, अक्सर रीयल-टाइम में। अंततः, इसका अर्थ है कि आपको एक विशाल एकल स्टोरेज सिस्टम की आवश्यकता नहीं है।
साथ ही, डेटा ऑर्केस्ट्रेशन डेटा की गुणवत्ता में सुधार करता है। उदाहरण के लिए, डेटा ट्रांसफ़ॉर्मेशन को लें। यह चरण डेटा को एक मानक फ़ॉर्मेट में बदलने और शामिल सिस्टमों में स्थिरता और सटीकता सुनिश्चित करने के बारे में है।
डेटा ऑर्केस्ट्रेशन का एक और बड़ा लाभ इसकी रीयल-टाइम में डेटा प्रबंधन और प्रोसेसिंग करने की क्षमता है। डायनेमिक प्राइसिंग रणनीतियाँ, स्टॉक ट्रेडिंग और पूर्वानुमान, और ग्राहक व्यवहार रुझान कुछ ऐसे क्षेत्र हैं जहाँ रीयल-टाइम प्रोसेसिंग जरूरी है—और डेटा ऑर्केस्ट्रेशन इन्हें सरल बनाता है।
अंततः, डेटा ऑर्केस्ट्रेशन उन सभी के लिए आवश्यक है जो बिग डेटा और बारंबार डेटा स्ट्रीमिंग कार्यों से निपटते हैं, खासकर वे कंपनियाँ जो कई स्टोरेज सिस्टम्स का प्रबंधन करती हैं।
डेटा ऑर्केस्ट्रेशन कैसे काम करता है
डेटा ऑर्केस्ट्रेशन के तीन मुख्य चरण हैं: डेटा संग्रह, तैयारी और सक्रियण। आइए इन्हें विस्तार से समझते हैं।
चित्र: लेखक द्वारा
डेटा संग्रह और तैयारी
विश्लेषण के लिए डेटा हमेशा CSV फ़ाइल से सीधे पूर्णतः उपयुक्त नहीं होता। शुरुआत में, आपको वेबसाइटों, APIs और डेटाबेस जैसे विभिन्न स्रोतों से कच्चा डेटा एकत्र करना होगा।
इसलिए, ऑर्केस्ट्रेशन का पहला चरण इन विभिन्न स्रोतों से डेटा इकट्ठा करना, अखंडता और सटीकता की जाँच करना, और फिर अगले चरण के लिए उसे तैयार करना शामिल है।
डेटा ट्रांसफ़ॉर्मेशन
विभिन्न सिस्टम एक ही डेटासेट के फ़ील्ड को अलग-अलग ढंग से प्रस्तुत करते हैं। उदाहरण के लिए, आपका कस्टमर रिलेशन मैनेजमेंट (CRM) सॉफ़्टवेयर ग्राहक IDs को संख्याओं के रूप में संग्रहीत कर सकता है, जबकि वित्तीय डेटाबेस उन्हें स्ट्रिंग्स में रख सकता है।
ऐसी असंगतियों से बचने के लिए, डेटा ऑर्केस्ट्रेशन टूल्स ट्रांसफ़ॉर्मर्स का उपयोग करते हैं जो डेटा फ़ॉर्मेट को मानकीकृत करते हैं, जिससे सुसंगत और विश्वसनीय डेटा सुनिश्चित होता है।
डेटा सक्रियण
ऑर्केस्ट्रेशन का यह अंतिम चरण डेटा को परिचालन उपयोग में लाता है। सक्रियित डेटा वह परिष्कृत डेटा है जो एनालिटिक्स टीमों या टूल्स द्वारा उपयोग के लिए तैयार होता है।
आप अपने मार्केटिंग, वित्त, बिक्री और ग्राहक सहायता विभागों में पैटर्न, रुझान और चुनौतियों की खोज के लिए इस डेटा का आसानी से विश्लेषण कर सकते हैं।
आप इन निष्कर्षों का उपयोग अपने आगंतुकों के लिए वैयक्तिकृत सामग्री डिज़ाइन करने, अनुकूलित मूल्य-योजनाएँ पेश करने और लक्षित दर्शकों के लिए प्रीमियम ग्राहक सेवा प्रदान करने में कर सकते हैं।
डेटा ऑर्केस्ट्रेशन के प्रमुख विचार
ऑर्केस्ट्रेशन डेटा संगठन और विश्लेषण में कई संभावनाएँ प्रदान करता है। यहाँ कुछ कारक हैं जिन्हें डेटा ऑर्केस्ट्रेशन सुव्यवस्थित करता है:
चित्र: लेखक द्वारा
स्वचालन
डेटा ऑर्केस्ट्रेशन का प्राथमिक उद्देश्य बड़े पैमाने पर डेटा संभालने में शामिल विभिन्न कार्यों को स्वचालित करना है। उदाहरण के लिए, डेटा इंटीग्रेशन में, डेटा ऑर्केस्ट्रेशन टूल्स कई स्रोतों से डेटा के संग्रह और संयोजन को स्वचालित कर देते हैं।
डेटा ट्रांसफ़ॉर्मेशन के दौरान, टूल्स विभिन्न डेटा फ़ॉर्मेट्स को एक एकल, सुसंगत फ़ॉर्मेट में बदलते हैं। वे सिस्टमों और पाइपलाइनों में डेटा की आवाजाही को भी स्वचालित करते हैं।
कुल मिलाकर, डेटा ऑर्केस्ट्रेशन उन कार्यों को स्वचालित करता है जिनमें डेटा को साथ लाना, उसके फ़ॉर्मेट को मानकीकृत करना, विश्लेषण के लिए उसे साफ़ करना और सटीक डेटा बनाए रखना शामिल है।
डेटा एकीकरण
इंटीग्रेशन का अर्थ है कई स्थानों से डेटा को एक केंद्रीकृत रिपॉज़िटरी में जोड़ना ताकि आपके डेटा का एकीकृत दृश्य बनाया जा सके। ऑर्केस्ट्रेशन इस प्रक्रिया को आसान बनाता है—डेटा को नियमित अंतराल पर या आपके द्वारा निर्धारित ट्रिगर्स के आधार पर एकत्र करके।
उदाहरण के लिए, आप ऑर्केस्ट्रेशन टूल में एक नियम सेट कर सकते हैं कि पाइपलाइन में कोई अपडेट होने पर डेटा को स्वचालित रूप से एकत्रित और एकीकृत किया जाए।
डेटा फ़्लो प्रबंधन
डेटा ऑर्केस्ट्रेशन पाइपलाइनों के बीच कार्यों को शेड्यूल करके वर्कफ़्लोज़ को स्वचालित करता है। यह विभिन्न सिस्टमों के बीच डेटा के प्रवाह को स्वचालित करता है, और ऑपरेशनों के सही क्रम का समन्वय करता है।
तो, यह कैसे सुनिश्चित करता है कि कार्य सही क्रम में चलें? ऑर्केस्ट्रेशन टूल्स आपको कार्यों को शेड्यूल करने के लिए कस्टम ट्रिगर्स परिभाषित करने देते हैं।
उदाहरण के लिए, आप डेटा फ़्लो के लिए एक निश्चित क्रम परिभाषित कर सकते हैं—जैसे पाइपलाइन 1 से 2 और फिर 3—या कस्टम शर्तें लगा सकते हैं, जैसे यदि डेटा कुछ मानदंडों को पूरा करता है तो उसे पाइपलाइन 2 में भेजें, अन्यथा पाइपलाइन 3 में भेजें।
डेटा गवर्नेंस
डेटा गवर्नेंस से तात्पर्य आपकी संस्था के डेटा की उपलब्धता, गुणवत्ता और सुरक्षा बनाए रखने से है—जो उद्योग, डोमेन और स्थान के अनुसार भिन्न हो सकता है।
उदाहरण के लिए, केवल आवश्यक डेटा निकालना और संग्रहीत करना और उपयोग के बाद उसे हटा देना—इसे डेटा गवर्नेंस नीति माना जा सकता है।
डेटा ऑर्केस्ट्रेशन डेटा के स्रोत, कौन-सा डेटा संग्रहीत है, और जीवनचक्र के दौरान वह कैसे रूपांतरित होता है, इन सबका ट्रैक रखता है। ये अभिलेख आपको GDPR और CCPA जैसी गवर्नेंस नीतियों और विनियमों का पालन करने में मदद करेंगे।
डेटा मान्यकरण
डेटा ऑर्केस्ट्रेशन नियमित रूप से आपके डेटा की गुणवत्ता और सटीकता का सत्यापन करता है। कुछ ऑर्केस्ट्रेशन टूल्स में बुनियादी गुणवत्ता जाँच के लिए बिल्ट-इन वैलिडेटर्स होते हैं।
उदाहरण के लिए, एक डेटा टाइप वैलिडेटर जाँचता है कि नेम कॉलम के मान स्ट्रिंग डेटा टाइप में संग्रहीत हैं या नहीं। टूल्स आपको अपनी आवश्यकताओं के अनुरूप कस्टम वैलिडेशन नियम स्थापित करने की सुविधा भी देते हैं।
डेटा ऑर्केस्ट्रेशन लागू करना
हमने पहले के अनुभागों में देखा कि डेटा ऑर्केस्ट्रेशन कैसे काम करता है। तो यहाँ बताया गया है कि आप प्रक्रिया कैसे शुरू कर सकते हैं और सही डेटा ऑर्केस्ट्रेशन टूल चुनने के लिए कुछ प्रमुख सुझाव।
योजना बनाना और अपनी आवश्यकताओं का आकलन करना
ऑर्केस्ट्रेशन प्रक्रिया का पहला कदम अपने लक्ष्यों को परिभाषित करना है। तय करें कि आप इस प्रक्रिया के माध्यम से क्या हासिल करना चाहते हैं—चाहे वह वर्कफ़्लो शेड्यूल करना हो, डेटा को एकीकृत करना हो, या गुणवत्तापूर्ण डेटा बनाए रखना हो।
अपनी मौजूदा डेटा अवसंरचना का मूल्यांकन करना शुरू करें, असंगतियाँ ढूँढें, यह पहचानें कि कौन-से डेटा कार्य अधिक समय ले रहे हैं, और जाँचें कि आपकी एनालिटिक्स टीम या टूल्स वर्तमान डेटा तक कितनी आसानी से पहुँच पाते हैं। क्या यह उनके लिए आसान है, या कोई कठिनाई है?
इन सभी दर्द-बिंदुओं की पहचान करें और उन ऑर्केस्ट्रेशन लक्ष्यों को परिभाषित करें जो इन मुद्दों का समाधान कर सकें।
सही टूल्स का चयन
एक बार लक्ष्य तय हो जाने पर अगला कदम ऐसे टूल्स ढूँढना है जो आपके सिस्टम्स में डेटा ऑर्केस्ट्रेशन तंत्र लागू कर सकें। सही डेटा ऑर्केस्ट्रेशन टूल चुनने में मदद के लिए यहाँ कुछ बातें ध्यान में रखें:
डेटा ऑर्केस्ट्रेशन की आम चुनौतियाँ
डेटा ऑर्केस्ट्रेशन विभिन्न डेटा कार्यों को तेज़ करने और शेड्यूल करने के लिए एक आवश्यक संपत्ति बनता जा रहा है। हालाँकि, डेटा ऑर्केस्ट्रेशन के साथ फायदे भी हैं और चुनौतियाँ भी।
यहाँ कुछ चुनौतियाँ दी गई हैं जिन पर अपने सिस्टम्स में डेटा ऑर्केस्ट्रेशन लागू करते समय ध्यान देने की आवश्यकता हो सकती है।
प्रभावी डेटा ऑर्केस्ट्रेशन के लिए रणनीतियाँ
1. अपने लक्ष्यों में विशिष्ट रहें
स्पष्ट लक्ष्य परिभाषित करने से आप वर्कफ़्लो और ऑर्केस्ट्रेशन प्रक्रिया को पटरी पर और उद्देश्यों के अनुरूप रख पाते हैं।
2. स्पष्ट डेटा गुणवत्ता मीट्रिक्स तय करें
यदि डेटा का फ़ॉर्मेट, संरचना और सटीकता आपको चिंतित करती है, तो गुणवत्ता बनाए रखने के लिए ऑर्केस्ट्रेशन प्रक्रिया के दौरान उन मीट्रिक्स की निगरानी करें।
3. प्रबंधित क्लाउड समाधान अपनाएँ
प्रबंधित क्लाउड समाधान थर्ड-पार्टी सेवाएँ होती हैं जो आपकी संस्था द्वारा उपयोग किए जाने वाले अन्य प्लेटफ़ॉर्म्स के साथ विभिन्न डेटा ऑर्केस्ट्रेशन टूल्स को आसानी से जोड़ती हैं।
4. डेटा सुरक्षा उपाय लागू करें
ऑर्केस्ट्रेशन जीवनचक्र के दौरान अपने डेटा को सुरक्षित रखने के लिए मानक सुरक्षा प्रोटोकॉल और डेटा गवर्नेंस नीतियाँ लागू करें।
5. सही टूल्स चुनें
ऑर्केस्ट्रेशन टूल तय करते समय स्केलेबिलिटी, उपयोग में आसानी, इंटीग्रेशन, सुरक्षा सुविधाएँ आदि पर विचार करें।
डेटा ऑर्केस्ट्रेशन के केस स्टडीज़
आज हर डेटा-चालित कंपनी बिग डेटा को प्रभावी ढंग से संभालने के लिए डेटा ऑर्केस्ट्रेशन टूल्स और तकनीकों का उपयोग करती है। इसके कुछ उपयोग-परिदृश्य यहाँ हैं:
हाइब्रिड परिवेश
कई संगठनों का डेटा क्लाउड में होता है और कंप्यूटिंग संसाधन इन-हाउस, या इसका उल्टा। ऐसे मामलों में देरी होती है क्योंकि ऑन-प्रिमाइसेस टूल्स को क्लाउड सर्वर पर मौजूद डेटा के साथ इंटरैक्ट करना पड़ता है। हालाँकि, डेटा ऑर्केस्ट्रेशन इस अंतर को पाटता है, उन्हें ऐसे संचार और साथ काम करने में सक्षम बनाता है मानो वे एक ही परिवेश में हों।
रीयल-टाइम डेटा स्ट्रीमिंग
Netflix के स्ट्रीम समय का 80% उसके रिकमेंडर सिस्टम के माध्यम से आता है। यह रिकमेंडर सिस्टम Netflix Maestro का उपयोग करता है—एक वर्कफ़्लो ऑर्केस्ट्रेटर—जो Netflix के अति-वृहद डेटा वर्कफ़्लोज़ को चलाता है।
ई-कॉमर्स
ग्राहक व्यवहार, इन्वेंट्री डेटा, वित्तीय लेनदेन, विज्ञापनों के प्रदर्शन और उत्पाद अनुशंसाओं का डेटा यदि अलग-अलग प्लेटफ़ॉर्म्स पर बिखरा हो तो ई-कॉमर्स व्यवसायों को अंतर्दृष्टि निकालने में मदद नहीं मिलती। यही कारण है कि ई-कॉमर्स व्यवसाय इस डेटा को एकीकृत करने और क्रियाशील अंतर्दृष्टि निकालने के लिए डेटा ऑर्केस्ट्रेशन का लाभ उठाते हैं।
लोकप्रिय ऑर्केस्ट्रेशन टूल्स का अवलोकन
ऑर्केस्ट्रेशन टूल्स डेटा ऑर्केस्ट्रेशन कार्यों और तकनीकों को स्वचालित और सुव्यवस्थित करते हैं। वे डेटा संग्रह से लेकर सक्रियण तक सब संभालते हैं, मानव त्रुटियों को कम करते हैं और दक्षता व गति में सुधार करते हैं।
बाज़ार विकल्पों से भरा हुआ है, इसलिए हमने आपके लिए शोध किया है और कुछ लोकप्रिय डेटा ऑर्केस्ट्रेशन टूल्स चुने हैं:
चित्र: लेखक द्वारा
Apache Airflow
Apache Airflow एक ओपन-सोर्स ऑर्केस्ट्रेशन टूल है जो Python का उपयोग करके वर्कफ़्लो या पाइपलाइन बनाने, शेड्यूल करने और मॉनिटर करने के लिए है। टूल के वर्कफ़्लोज़ को Directed Acyclic Graph (DAG) के रूप में दर्शाया जाता है ताकि वर्कफ़्लोज़ के भीतर कार्यों और उनकी निर्भरताओं को व्यवस्थित किया जा सके।
DAGs को समझना:
इसके आसान यूज़र इंटरफ़ेस के साथ, आप कुछ ही क्लिक में विशिष्ट DAGs तक नेविगेट कर सकते हैं और विभिन्न कार्यों की स्थिति और लॉग्स ट्रैक कर सकते हैं।
Prefect
Prefect एक और Python-आधारित ऑर्केस्ट्रेशन टूल है जिसका उपयोग डेटा पाइपलाइनों के बीच वर्कफ़्लोज़ बनाने और स्वचालित करने के लिए किया जाता है। Prefect के साथ, आप जटिल कार्य-निर्भरताओं और अनुक्रमों को सुव्यवस्थित सब-फ़्लोज़ में विभाजित कर सकते हैं।
Prefect की विशेषताओं में रनटाइम पर कार्यों का निष्पादन, हाइब्रिड परिवेशों में वर्कफ़्लोज़ चलाना, बार-बार निष्पादित होने वाले पाइपलाइन परिणामों को कैश करना, और बहुत कुछ शामिल है।
Keboola
डेटा पाइपलाइनों को सहजता से डिज़ाइन और निष्पादित करने के लिए क्लाउड-आधारित प्लेटफ़ॉर्म। Keboola एक्सट्रैक्टर्स के साथ, आप किसी भी स्रोत से डेटा ला सकते हैं और उसे आसानी से प्लेटफ़ॉर्म में लोड कर सकते हैं। डेटा आ जाने के बाद, आप टूल के ट्रांसफ़ॉर्मेशंस का उपयोग करके उसे मानकीकृत कर सकते हैं।
Keboola का “Applications” कंपोनेंट व्यापक डेटा मैनिप्युलेशन और ट्रांसफ़ॉर्मेशन कार्य करता है।
Dragster
Dragster एक ओपन-सोर्स डेटा ऑर्केस्ट्रेटर है जो डेटा पाइपलाइनों को बनाना और बनाए रखना सरल बनाता है। Airflow से प्रेरित यह टूल आपको Python-आधारित डोमेन-विशिष्ट भाषा (DSL) का उपयोग करके वर्कफ़्लो DAGs बनाने देता है।
इस तरह, डेवलपर्स टूल का उपयोग करके अपनी निर्भरताओं और ट्रांसफ़ॉर्मेशंस को आसानी से परिभाषित कर सकते हैं।
निष्कर्ष
डेटा ऑर्केस्ट्रेशन, पाइपलाइनों को बनाए रखने में शामिल डेटा संग्रह, डेटा ट्रांसफ़ॉर्मेशन और डेटा मूवमेंट कार्यों को संभालकर स्वचालित डेटा वर्कफ़्लो बनाने की प्रक्रिया को सरल बनाता है। इससे कंपनियों के लिए बिग डेटा संभालना, ETL कार्य निष्पादित करना और ML डिप्लॉयमेंट स्केल करना आसान हो जाता है।
इस ट्यूटोरियल में, हमने आज के डेटा इंजीनियरों के बीच व्यापक रूप से प्रचलित डेटा ऑर्केस्ट्रेशन के साथ शुरुआत करने के लिए आवश्यक सभी बातों पर चर्चा की। सीखना जारी रखने के लिए, इन संसाधनों पर नज़र डालें: