
Last chance! 50% off DataCamp Premium
Sale ends in
Data is essentieel voor bedrijven en organisaties, en het organiseren van de stroom van al die data is precies waar datapijplijnen in uitblinken. Wat zijn datapijplijnen, en wat moet je weten om er zelf een te bouwen?
Data is de levensader van moderne bedrijven en organisaties en stuurt besluitvorming, inzichten en innovatie aan. Het beheren en benutten van de kracht van data kan echter complex en intimiderend zijn. Daar komen datapijplijnen om de hoek kijken. Maar wat zijn datapijplijnen?
Een datapijplijn is een systeem dat data uit verschillende bronnen ophaalt en naar een nieuwe locatie leidt, zoals een database, repository of applicatie, waarbij onderweg eventuele benodigde datatransformatie plaatsvindt (data van het ene formaat of de ene structuur naar het andere omzetten). Eindgebruikers van deze pijplijn variëren van analisten en data scientists tot businessleaders.
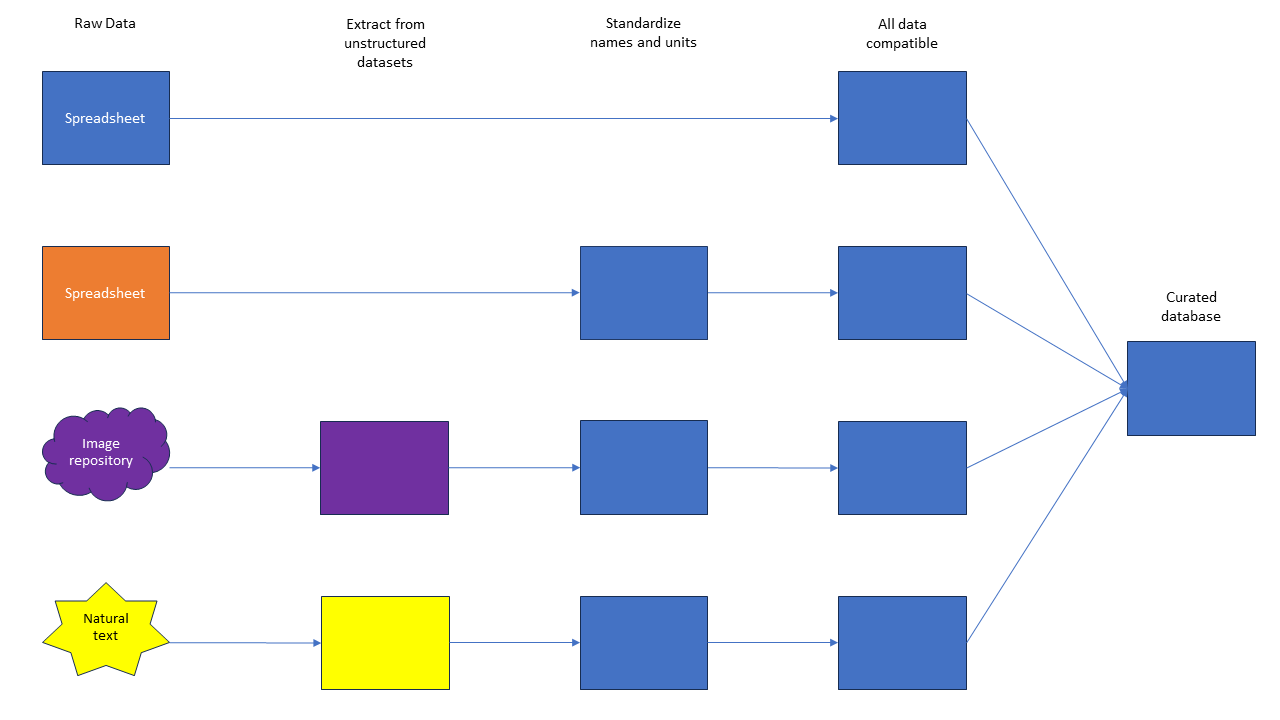
Figuur 1: Voorbeeld van een eenvoudige datapijplijn. In dit voorbeeld heb je vier databronnen: twee gestructureerde en twee ongestructureerde. Via een reeks stappen extraheer je gestructureerde data uit de ongestructureerde datasets, standaardiseer je alle namen en eenheden en, zodra alle data compatibel is, kun je één gecureerde database maken met alle benodigde informatie. Deze database kan vervolgens worden gebruikt door analisten, scientists of businessleaders.
Hoewel dit eenvoudig klinkt, brengt het veel hoofdbrekens en keuzes met zich mee. In veel organisaties is het bouwen en onderhouden van pijplijnen een volledige functie voor data-engineers. In andere organisaties is het slechts één van de vele taken van een data scientist. Wie de pijplijn onderhoudt, hangt vaak af van de omvang van de organisatie, de complexiteit van de pijplijnen en het beschikbare budget.
Het bouwen van een betrouwbare, veilige en tijdige pijplijn is een cruciaal onderdeel van datagedreven besluitvorming. Of je nu geïnteresseerd bent in data-engineering of in een andere rol binnen het dataproces, het loont om datapijplijnen te begrijpen.
Je vraagt je misschien af waarom je überhaupt een pijplijn nodig hebt. Als je met kant-en-klare datasets werkt of met data uit slechts één bron, zoals je bij Kaggle of DataCamp-oefeningen vindt, had je waarschijnlijk geen pijplijn nodig. Deze gecureerde datasets zijn al zo ingericht dat analisten ze direct kunnen ophalen en gebruiken.
Maar als je informatie uit meerdere bronnen wilt combineren, moet je mogelijk een pijplijn opzetten om ervoor te zorgen dat alle data toegankelijk is voor je analyse.
Hier zijn enkele belangrijke redenen om datapijplijnen te overwegen:
Stel, je wilt weten of het gemiddelde GPA van studenten in een schooldistrict correleert met het gemiddelde inkomen in de county of met de bevolkingsomvang. Voor deze analyse moet je GPA-data ophalen uit elk schooldistrict in je analyse, inkomensdata van de IRS en bevolkingsomvang van het Census Bureau.
Je zou deze informatie waarschijnlijk één keer handmatig kunnen verzamelen. Maar stel dat je deze analyse regelmatig moet herhalen. Met een betrouwbare pijplijn kun je deze informatieverzameling automatiseren, wat je tijd en gedoe bespaart.
Naast het verzamelen van data op één plek kunnen pijplijnen je helpen omgaan met inconsistenties in data uit verschillende bronnen. Zo kan het Census Bureau counties identificeren met de volledige naam, terwijl de IRS counties met een afgekorte naam aanduidt.
Binnen de pijplijn kun je een systeem opzetten om te standaardiseren hoe counties in de eindrepository worden geïdentificeerd. Of misschien wordt populatie in verschillende items met verschillende eenheden aangeduid en moet je standaardiseren welk eenhedensysteem in je eindbestemming wordt gebruikt. Dit soort aanpassingen noemen we transformaties.
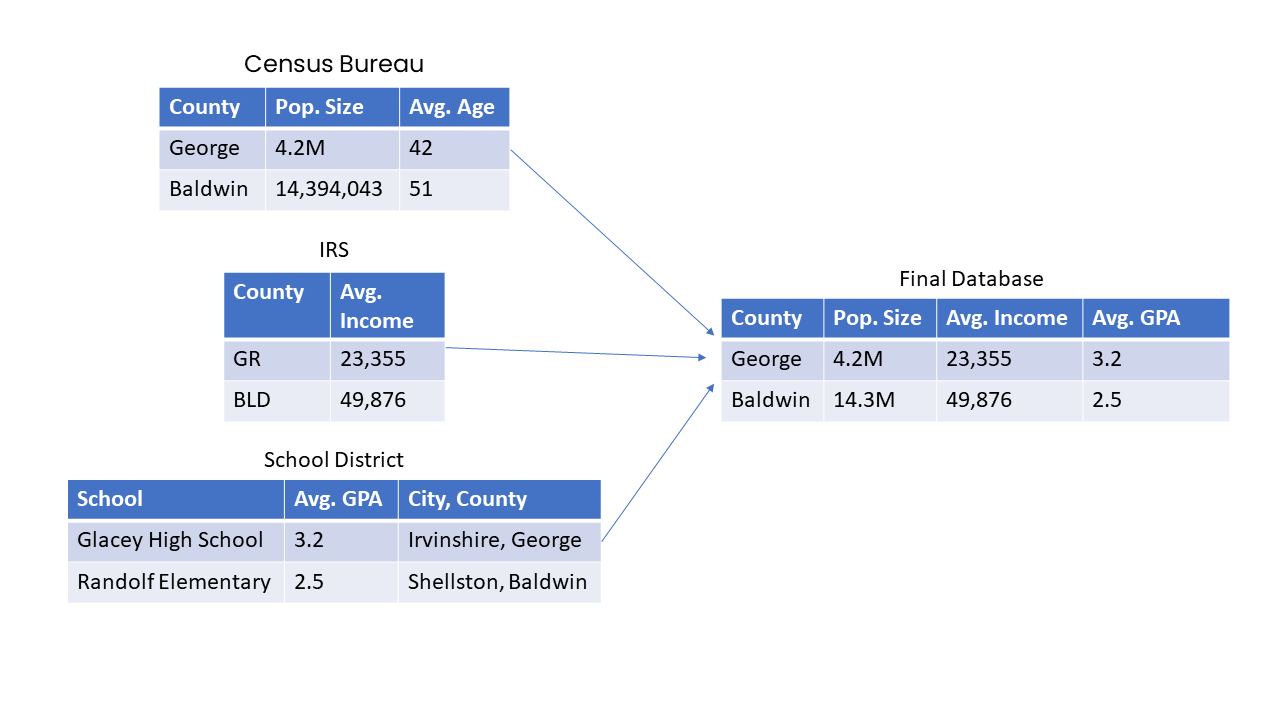
Figuur 2: Bij het combineren van informatie uit verschillende bronnen kunnen transformaties zoals eenheidsconversies en gestandaardiseerde namen nodig zijn.
Datapijplijnen worden over het algemeen ontwikkeld en onderhouden door data-engineers.
Zodra de data aan het einde van de pijplijn is verzameld, opgeschoond en georganiseerd, kan deze worden opgehaald door diverse stakeholders, waaronder data-analisten, data scientists of business-analisten.
De data kan vervolgens worden gebruikt voor realtime analytics, in een updatende dashboard worden gezet of aan een machinelearningmodel worden toegevoegd. Soms is het eindpunt van de pijplijn een applicatie of dashboard dat door een businessleader of individu wordt gebruikt.
Pijplijnen worden gebruikt in vrijwel elke sector die grote hoeveelheden data benut. In sommige grote organisaties, zoals in de techsector, zijn hun pijplijnen complex, streng gereguleerd en beheerd door een team van gespecialiseerde engineers.
In kleinere organisaties, bijvoorbeeld een enkele onderzoeker die data verzamelt van meerdere sensoren wereldwijd, kan de pijplijn heel overzichtelijk en eenvoudig zijn, met slechts een paar stappen. Andere voorbeelden zijn een effectenmakelaar die financiële informatie verzamelt om te beslissen welke aandelen te kopen, of een ziekenhuisgroep die patiëntendossiers verzamelt van verschillende aangesloten ziekenhuizen.
Pijplijnen zijn ook cruciaal voor machinelearningmodellen. Deze modellen verbruiken enorme hoeveelheden data, en een goede pijplijn is essentieel voor een soepele werking. Deze MLOps-tutorial geeft meer details over hoe pijplijnen in machine learning worden gebruikt.
Data kan op verschillende manieren worden opgeslagen, afhankelijk van het type data en het beoogde gebruik. Drie termen die je waarschijnlijk tegenkomt in de context van dataopslag zijn data lakes, databases en datawarehouses. Laten we ze kort behandelen.
Een data lake is een grote, flexibele opslagrepository die zowel gestructureerde als ongestructureerde data op schaal kan opslaan. Het stelt organisaties in staat om ruwe, onbewerkte data uit diverse bronnen, zoals weblogs, sensoren, sociale media en meer, in het oorspronkelijke formaat op te slaan.
Data lakes staan bekend om hun veelzijdigheid, omdat ze data scientists en analisten in staat stellen om data op verschillende manieren te verkennen, transformeren en analyseren. Ze zijn vooral waardevol voor big data en geavanceerde analytics, waar het schema en de structuur van de data niet vooraf zijn gedefinieerd, wat organisaties de flexibiliteit geeft om inzichten uit diverse databronnen te halen.
Databases zijn algemenere systemen die worden gebruikt voor het efficiënt opslaan, beheren en ophalen van gestructureerde data. Hoewel ze overeenkomsten hebben met datawarehouses, worden databases doorgaans gebruikt voor transactionele data, dagelijkse operaties en realtime applicaties. Ze bestaan in verschillende typen, waaronder relationele databases, NoSQL-databases en in-memory databases, elk geschikt voor specifieke opslag- en verwerkingsvereisten. Databases waarborgen dataintegriteit, ondersteunen gelijktijdige toegang en bieden uiteenlopende mechanismen voor het bevragen en ophalen van data.
Datawarehouses daarentegen zijn sterk gestructureerde en geoptimaliseerde repositories die zijn ontworpen voor het opslaan, organiseren en bevragen van gestructureerde data, primair voor analytische doeleinden. Ze volgen doorgaans een vooraf gedefinieerd schema, handhaven datakwaliteit en -consistentie en zijn geoptimaliseerd voor complexe query- en rapportagetaken.
Datawarehouses zijn ideaal voor bedrijven die op basis van historische data weloverwogen beslissingen willen nemen, omdat ze één bron van waarheid bieden voor gestandaardiseerde rapportage en analytics. Data wordt meestal uit verschillende bronnen geëxtraheerd, naar een consistent formaat getransformeerd en in het datawarehouse geladen voor analyse.
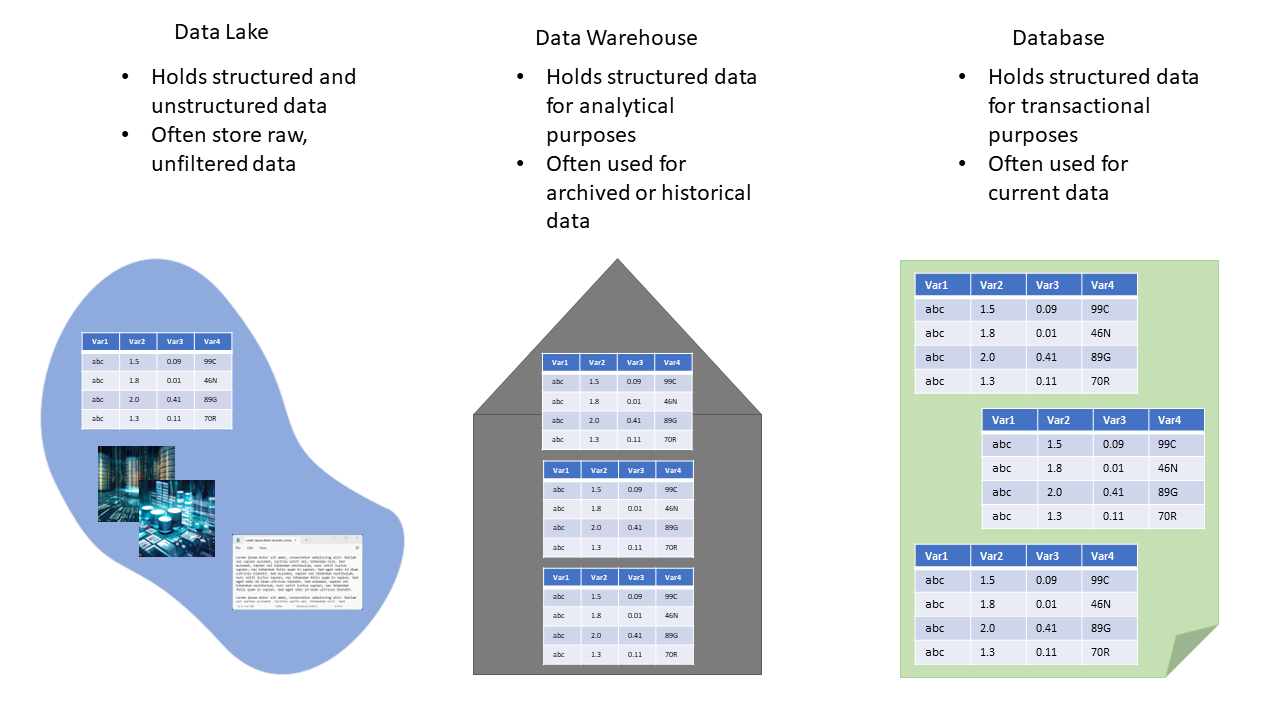
Figuur 3: Toont enkele verschillen tussen een data lake, een datawarehouse en een database. Een data lake kan worden gebruikt als voorafgaande stap in een pijplijn die kan eindigen in een warehouse of database.
Pijplijnen volgen over het algemeen één van twee hoofdmodellen: ETL (Extract, Transform, Load) of ELT (Extract, Load, Transform).
ETL volgt een sequentiële aanpak. Eerst wordt data uit verschillende bronsystemen geëxtraheerd, zoals databases, bestanden, API’s of andere datarepositories.
Na extractie wordt de data getransformeerd om aan het gewenste schema, de datakwaliteit en de bedrijfsregels te voldoen. Deze transformatie kan het opschonen, aggregeren en structureren van de data omvatten. Ten slotte wordt de getransformeerde data geladen in het doelsysteem, vaak in een formaat dat is geoptimaliseerd voor rapportage en analytics.
ETL is nuttig wanneer data aanzienlijke herstructurering of opschoning nodig heeft voordat deze in het datawarehouse wordt opgeslagen, omdat dit garandeert dat de data schoon en klaar is voor analyse. Deze ETL met Python-cursus geeft je een gedetailleerd overzicht van ETL met Python en SQL.
ELT draait de volgorde van de transformatiefase om. In het ELT-proces wordt data eerst uit bronsystemen geëxtraheerd en zonder grote transformaties geladen in een datawarehouse, of soms een datalake. De transformatie en verwerking van de data vinden plaats binnen het datawarehouse zelf.
Deze aanpak benut de rekenkracht en flexibiliteit van moderne datawarehouses en big-dataplatforms en is geschikt wanneer je grote hoeveelheden ruwe data wilt opslaan en transformaties on demand wilt uitvoeren.
ELT geniet vaak de voorkeur wanneer je een datawarehousingoplossing hebt die complexe transformaties efficiënt aankan, zoals cloudgebaseerde datawarehouses of gedistribueerde dataverwerkingsframeworks zoals Hadoop.
Er zijn veel tools beschikbaar voor het ontwikkelen van pijplijnen. De juiste keuze hangt af van de grootte van je pijplijn, schaalbehoeften, budget en doelen. Je kunt een complete pijplijn bouwen met Python en SQL (of R en SQL), of je kunt diverse commerciële tools gebruiken.
Hier is een korte lijst met enkele gangbare commerciële technologieën en tools.
Bekijk ook onze lijst met de beste ETL-tools en waarom je ze zou gebruiken in een apart artikel.
De eerste stap bij het creëren van een datapijplijn is het verzamelen van de data die je in de pijplijn stopt. Er zijn online verschillende plekken met actuele informatie, waaronder overheidswebpagina’s, sociale media en sommige non-profitorganisaties. Vaak bieden deze een API die relatief eenvoudig te gebruiken is.
Een API (application programming interface) is in wezen software die communicatie tussen twee of meer applicaties mogelijk maakt. Zo kun je bijvoorbeeld een API voor Twitter in je Python-applicatie integreren, zodat je applicatie namens jou tweets kan plaatsen of tweets kan “lezen”. Het is eigenlijk een tussenpersoon.
Je kunt een API aan het begin van je pijplijn gebruiken om data uit verschillende bronnen te verzamelen. Zo kun je met een API indieningsdata van de SEC ophalen of klinische data uit tabellen van de NIH verzamelen.
Een andere techniek om data te verzamelen is webscraping. Dit is een techniek waarbij je met een op maat geschreven script informatie van een webpagina op internet verzamelt. Python-bibliotheken zoals BeautifulSoup en Scrapy maken dit proces vrij gemakkelijk, maar je moet nog steeds door html of xml kunnen navigeren om de informatie te vinden die je nodig hebt.
Wil je meer leren over webscraping, dan heeft DataCamp materiaal over Beautiful Soup in Python, webscraping met R, en webscraping voor NLP.
Er zijn ook codeloze diensten voor webscraping beschikbaar. Hier is een dergelijke dienst waarmee je informatie van een webpagina kunt verzamelen en de pagina op wijzigingen kunt monitoren.
Je dataverzamelingsproces kan een mix omvatten van gestructureerde data (zoals spreadsheets of databases) en ongestructureerde data (zoals tekst of afbeeldingen).
Afhankelijk van je einddoel voor de pijplijn, kun je informatie uit je ongestructureerde data extraheren om een uniform gestructureerde dataset te maken, of je laat een deel ongestructureerd en zorgt ervoor dat de eindgebruiker over de juiste kruisverwijzingen beschikt.
Gestructureerde data kan vaak worden geëxtraheerd met SQL-queries of ETL-tools, terwijl ongestructureerde data mogelijk NLP-technieken of gespecialiseerde tools vereist.
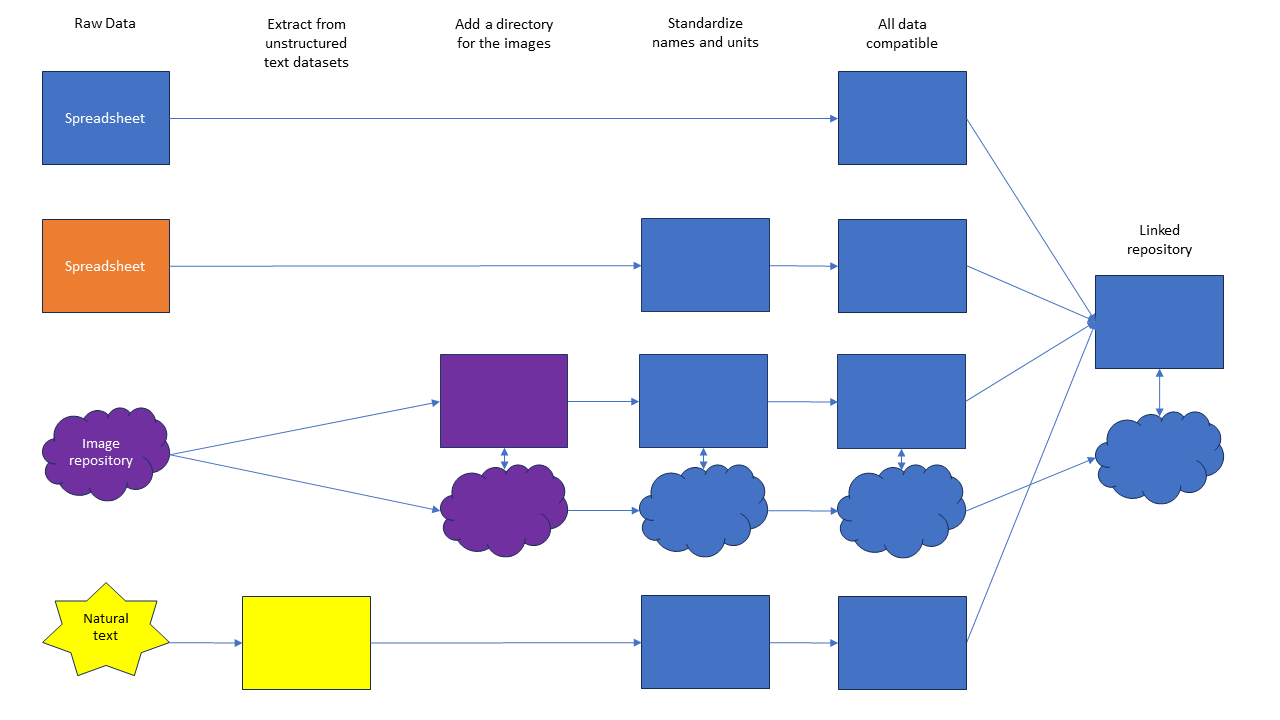
Figuur 4: Voorbeeld van een datapijplijn waarbij ongestructureerde data aan het eind intact blijft. In dit voorbeeld willen we een repository maken met gecureerde gestructureerde data en gelinkte afbeeldingen. Dit zou ook een datalake kunnen zijn. In plaats van gestructureerde data uit de afbeeldingen te extraheren, hebben we een directory gemaakt die de afbeeldingen koppelt aan de relevante data in de database. De eindgebruiker kan dan de ruwe afbeelding per rij in een spreadsheet ophalen, indien nodig. Alternatief hadden we een analyse van de afbeeldingen kunnen doen en een afbeelding met geïsoleerde of verwijderde secties kunnen leveren. Voor informatie hierover, bekijk deze tutorial over beeldanalyse.
Zodra je databronnen beschikbaar zijn en je een einddoel voor ogen hebt, kun je beginnen met het opzetten van je pijplijn.
Het eerste wat je moet doen, is je pijplijn plannen. Ik raad aan om dit eerst op papier uit te tekenen. Zet helemaal links je databronnen en helemaal rechts je einddoel. Daartussen leg je alle stappen vast die nodig zijn om van je bronnen naar je einddoel te komen.
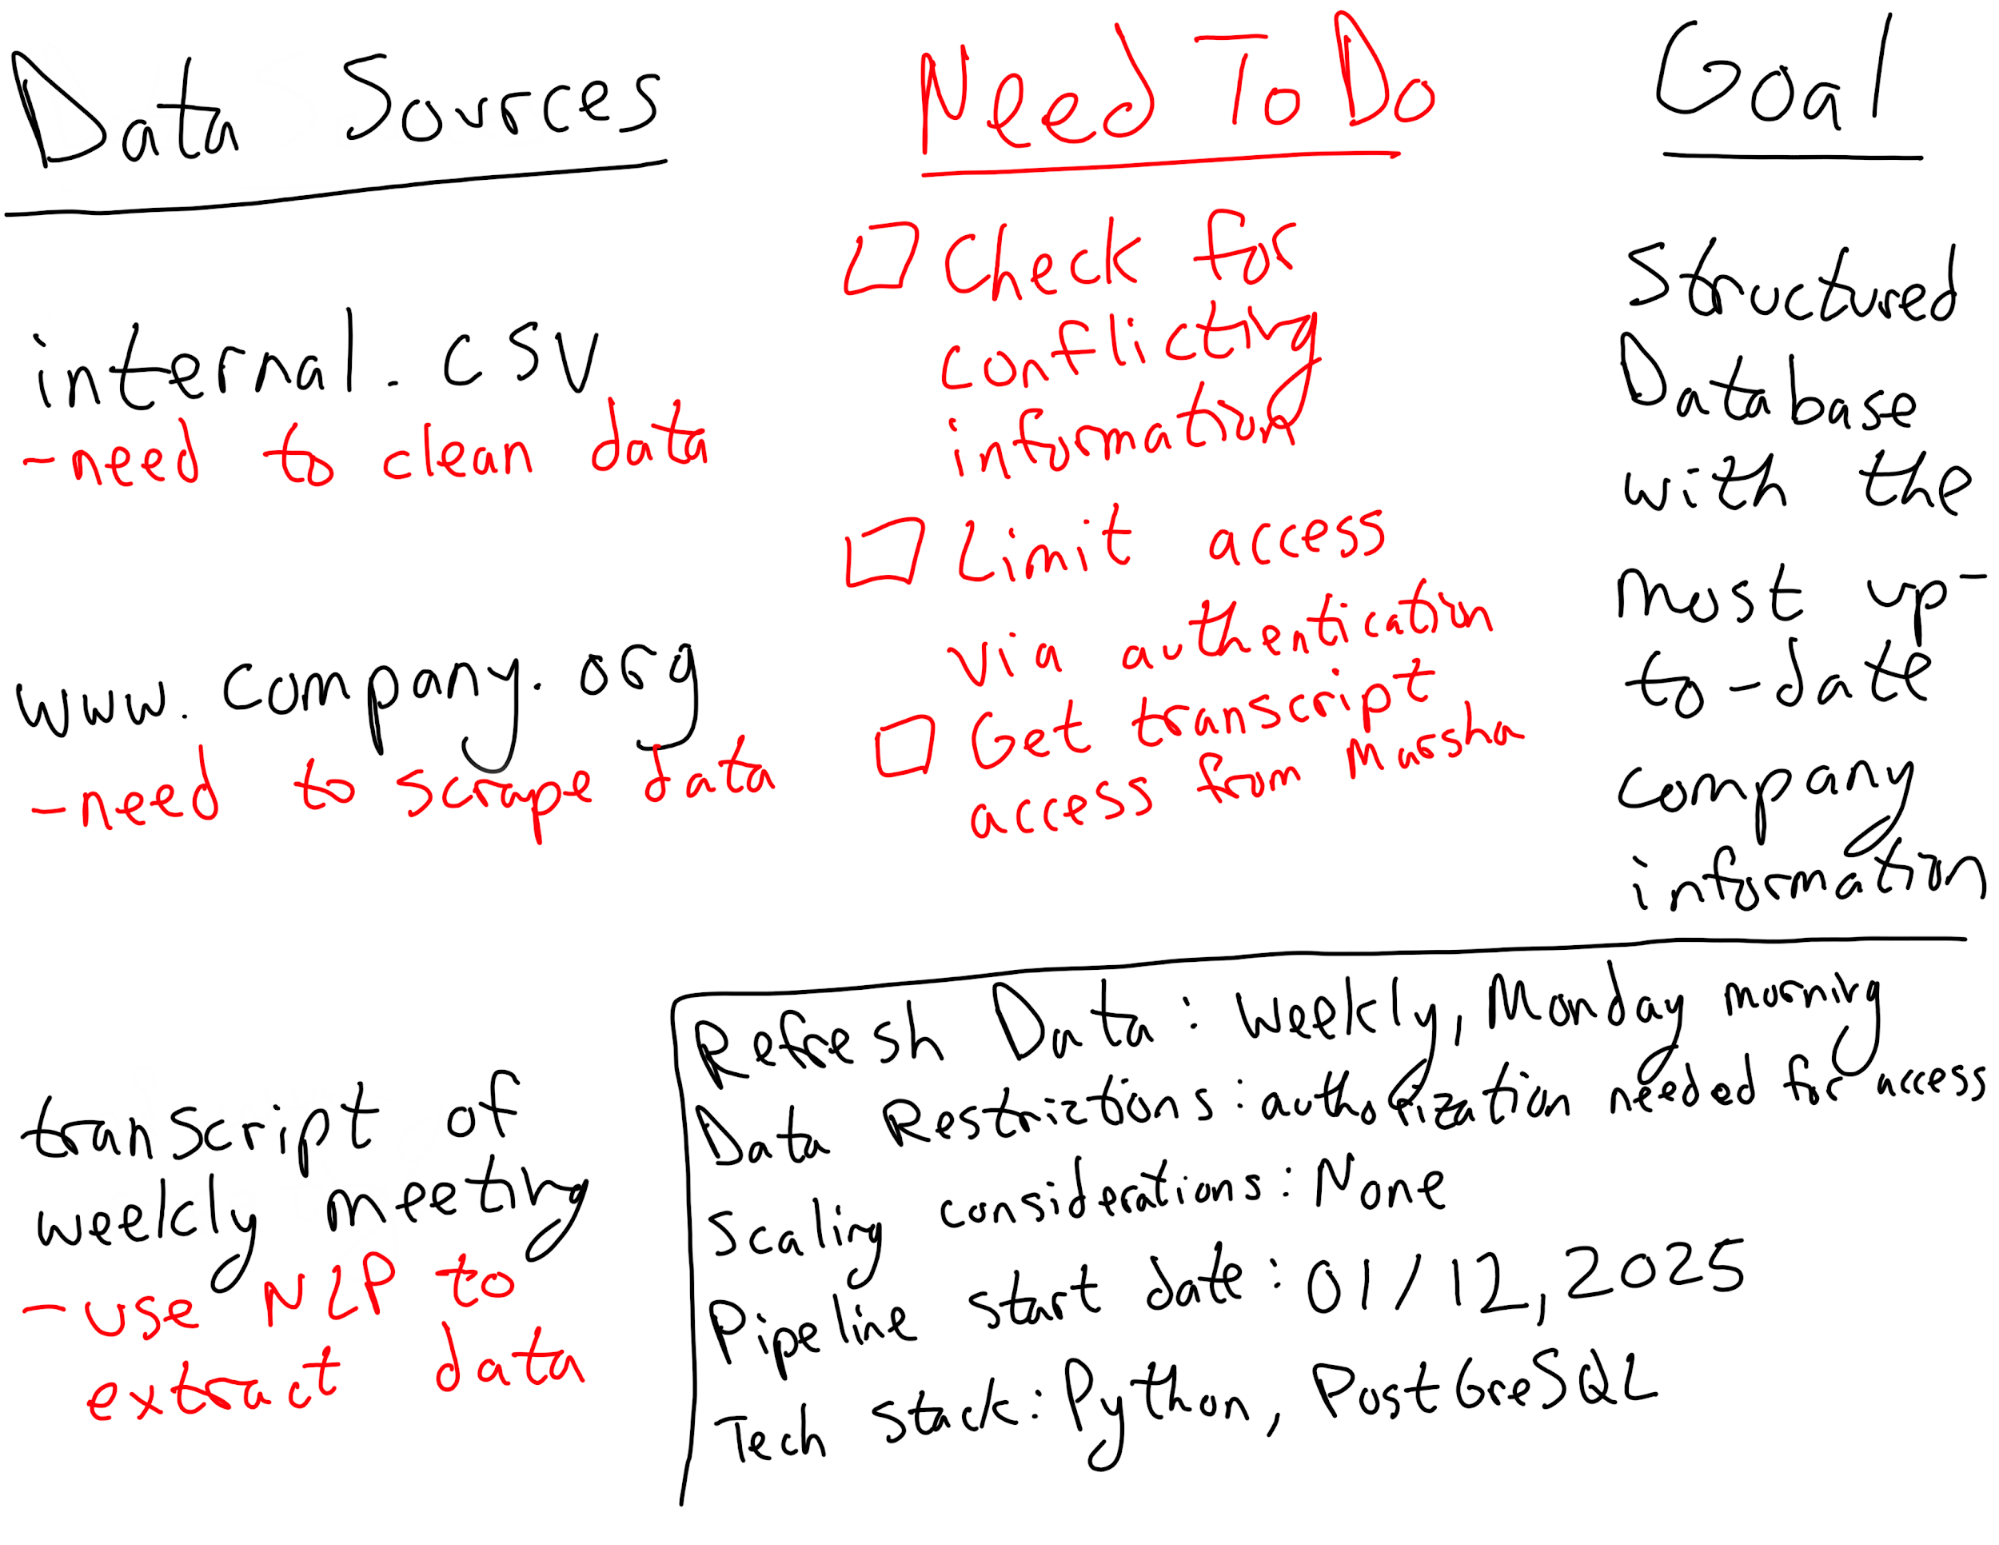
Figuur 5: Voorbeeldplan voor een pijplijn.
Enkele potentiële stappen die je moet opnemen, zijn:
Zodra je je plan hebt uitgetekend, kun je gaan bouwen. Dit kan volledig in je favoriete programmeertaal gecodeerd zijn, of bestaan uit één of meer diensten die pijplijnen ondersteunen. Houd tijdens de bouw je eindgebruiker en diens behoeften steeds in het vizier.
Een cruciale beslissing is hoe vaak je de data wilt updaten. Als de meest actuele informatie noodzakelijk is, moet je een pijplijn opzetten die klaar is voor realtime verwerking. Als dit nauwkeurigheidsniveau niet nodig is, kun je overwegen om in batches te verwerken om resources te besparen. Dit betekent dat de data de pijplijnstappen in batches doorloopt, bijvoorbeeld wekelijks of dagelijks, in plaats van continu.
Iets anders om in gedachten te houden tijdens het bouwen van je pijplijn is hoe je deze in de toekomst gaat onderhouden. Je wilt een manier creëren om de werking van de pijplijn te monitoren en onverwachte problemen te kunnen detecteren en corrigeren.
Typfouten, onvolledige of dubbele items en verschillende bestandstypen zijn slechts enkele van de vele uitdagingen waar je pijplijn lang na de initiële setup mee te maken kan krijgen. Het opzetten van solide foutafhandeling en monitoring kan je veel gedoe besparen.
Voor een gedetailleerdere blik op het ontwerpen van datapijplijnen, met name in een machinelearningcontext, bekijk DataCamp’s cursus Designing Machine Learning Workflows in Python.
Zoals met alles in data is het belangrijk om je pijplijn niet complexer te maken dan nodig. Eenvoudigere pijplijnen zijn goedkoper en makkelijker te onderhouden, eenvoudiger te updaten en beter te begrijpen als je de pijplijn moet overdragen aan een andere engineer.
Aan het begin van het ontwerpproces is het belangrijk om de projectvereisten te evalueren, inclusief verwachte toekomstige schaalvergroting. Dit helpt je de passende complexiteit te kiezen.
Heb je bijvoorbeeld een tijdelijke pijplijn nodig om enkele maanden data te verzamelen van drie verschillende sensoren, dan kun je kiezen voor een eenvoudige pijplijn met één stap die een wijdverbreide, gratis oplossing gebruikt, zoals Google Drive.
Heb je daarentegen gevoelige data of zijn meerdere transformaties nodig, dan moet je mogelijk aangepaste code in Python of C# met versleuteling voor de pijplijn maken.
Tot slot kan het zijn dat je nu een kleine pijplijn opzet, maar een grootschalige uitbreiding in de komende jaren verwacht. In dat geval wil je waarschijnlijk een pijplijn bouwen met voldoende infrastructuur om die groei aan te kunnen.
Het is verleidelijk om eerst een kleinere pijplijn te ontwerpen met het plan om later een nieuwe, grootschaligere pijplijn te bouwen als dat nodig is. Dat kan werken, maar wees voorzichtig!
Veel data-engineers krijgen de taak een pijplijn te repareren die niet is ontworpen voor de huidige schaal, omdat het bouwen van een nieuwe te duur of tijdrovend wordt geacht.
Hoewel eenvoud key is, is het verstandig om bij een langetermijnpijplijn rekening te houden met verwachte uitbreidingsplannen.
Een paar vragen die je aan het begin van een project kunt stellen:
Een veelvoorkomende valkuil voor junior engineers is meebuigen met trends in plaats van de beste tools voor de klus te kiezen.
Een voorbeeld is hoe veel bedrijven generatieve AI in hun techstack proberen te proppen zonder goed use-case.
Als dataprofessional is het belangrijk dat je op de hoogte blijft van nieuwe technologieën en trends. Kies echter de tool die het beste bij je project past, in plaats van trends te volgen die kunnen leiden tot een slechte pijplijn.
Zodra je een plan voor je pijplijn hebt, is het belangrijk optimalisatiemethoden te overwegen. Je wilt de data krijgen die je nodig hebt, met je gewenste resolutie en verversingsfrequentie, terwijl je het verbruik van rekenresources of de doorlooptijd door de pijplijn minimaliseert.
Een essentieel onderdeel van pijplijnoptimalisatie is het monitoren en loggen van de datastroom door de pijplijn. Dit geeft inzicht in waar knelpunten de datastroom kunnen vertragen of meer rekenkracht vergen.
Veelvoorkomende knelpunten zijn trage databronnen, resourcebeperkingen of inefficiënte datatransformaties.
Zodra je knelpunten hebt geïdentificeerd, kun je denken aan manieren om de prestaties te optimaliseren:
Een andere optimalisatie-overweging is de verversingsfrequentie van de data. Als data elke minuut door je pijplijn wordt ververst, maar je slechts elke vijf minuten een update nodig hebt, kan het terugbrengen van onnodige verversingen processors vrijmaken en het energieverbruik verminderen.
Bepaalde soorten data die door je pijplijnen stromen, kunnen veiligheids- of privacykwesties met zich meebrengen. Medische data is bijvoorbeeld sterk gereguleerd door de Amerikaanse overheid en vereist aanzienlijk meer beveiligingsmaatregelen dan data over kijkgedrag naar media. Andere voorbeelden van data die meer beveiliging vereisen, zijn financiële data en wachtwoorden.
De soorten beveiligingsmaatregelen die je toepast, hangen af van de risico’s bij dat type data. In sommige gevallen volstaat anonimisering, waarbij persoonlijke informatie wordt losgekoppeld of verwijderd uit de dataset. Dit kan worden gebruikt in medisch onderzoek waar persoonlijk identificerende informatie niet nodig is, maar andere informatie uit de medische dossiers wel.
Andere beveiligingsmaatregelen die je mogelijk moet toepassen, zijn versleuteling en toegangscontrole via inlogautorisaties. Deze methoden kunnen worden gebruikt voor financiële data of bedrijfsgeheimen.
Bij alle gevoelige data is het belangrijk dat je vertrouwd bent met en voldoet aan overheidsregelgeving, zoals de AVG (General Data Protection Regulation) of HIPAA (Health Insurance Portability and Accountability Act).
Afhankelijk van je sector en de typen data die je verwerkt, moet je mogelijk ook voldoen aan aanvullende regelgeving, zoals CCPA (California Consumer Privacy Act) of FERPA (Family Educational Rights and Privacy Act).
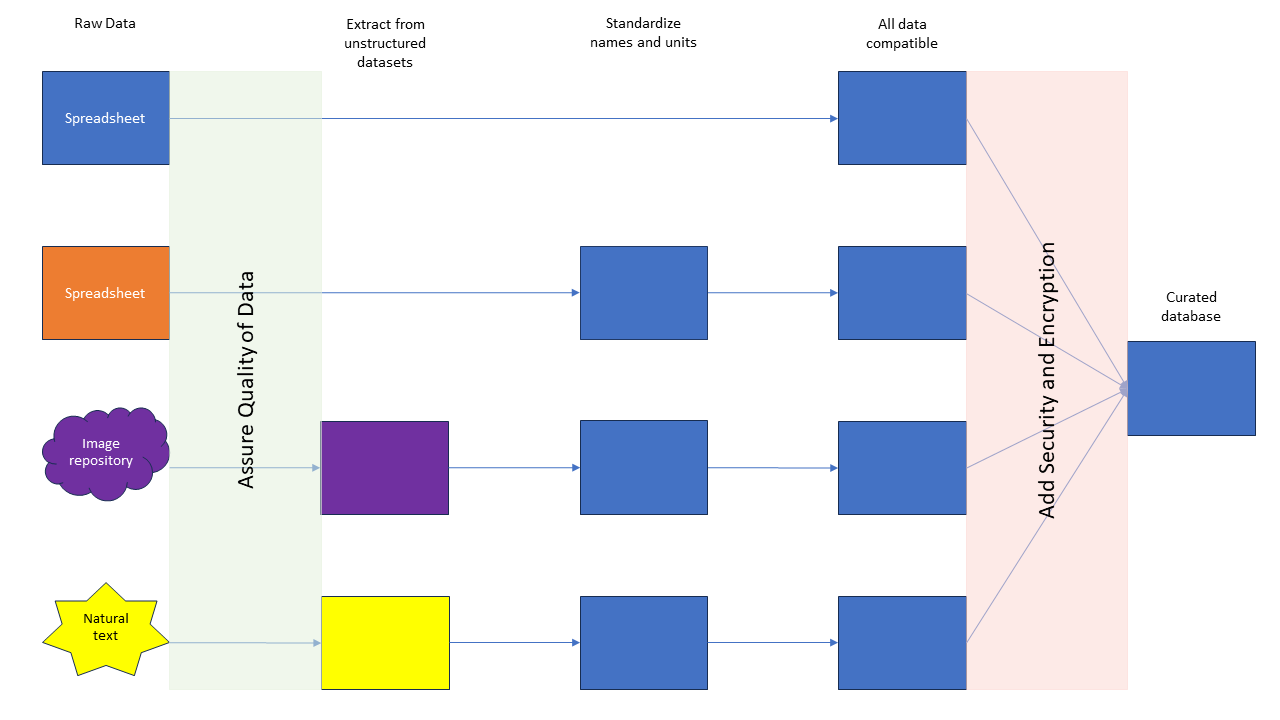
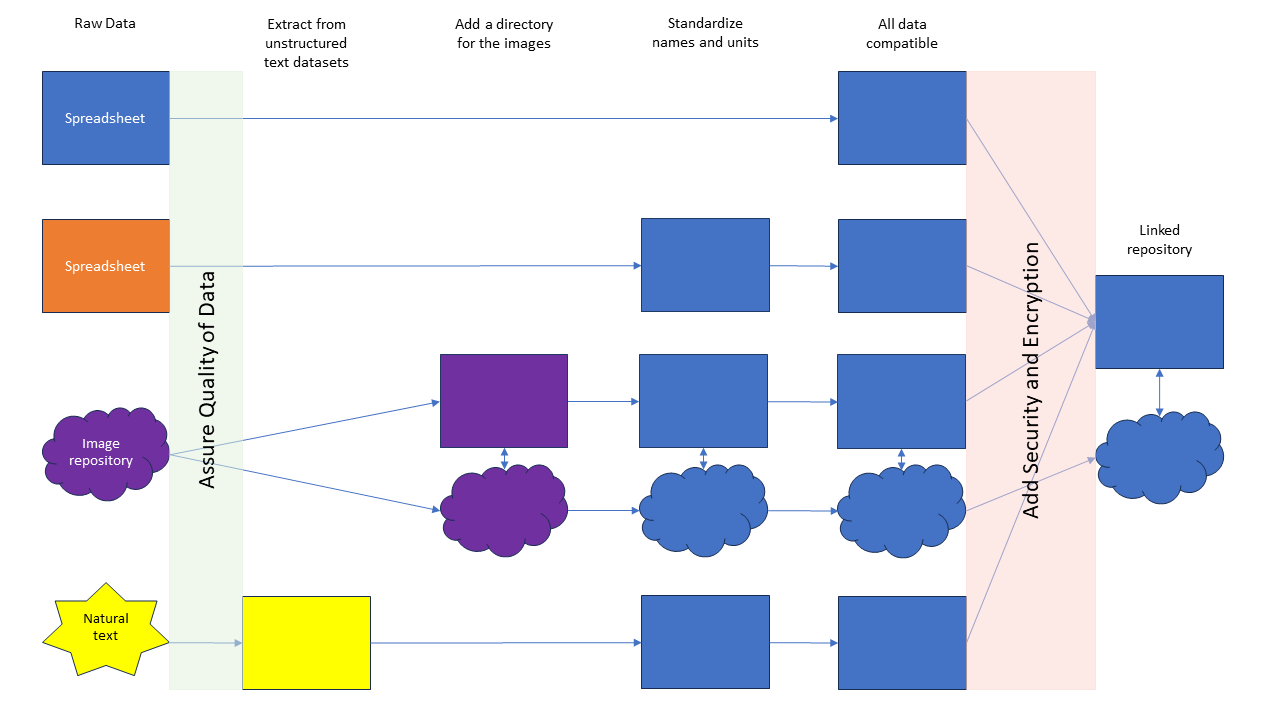
Figuur 6: Voorbeeld van het toevoegen van kwaliteitsborging en beveiligingsstappen in een pijplijn.
Datapijplijnen en de engineers die ze bouwen zijn de onbezongen helden van de datawereld. Ze laten data naadloos van plek naar plek stromen en organiseren en sorteren deze. Volgens Statista werd er alleen al in 2020 wereldwijd 64,2 zettabyte aan data gegenereerd, geconsumeerd en opgeslagen, en dat cijfer stijgt elk jaar.
Het bouwen en onderhouden van robuuste datapijplijnen wordt in deze dataomgeving steeds crucialer. Als deze tutorial je interesse in datapijplijnen heeft gewekt, bekijk dan deze inleidende cursus voor een diepere kijk. Wil je leren hoe je datapijplijnen bouwt, bekijk dan deze Python Data Engineering-cursus om te beginnen. En als je je carrière wilt starten en je vaardigheden aan werkgevers wilt bewijzen, bekijk dan onze Data Engineer-certificering.
Begin vandaag nog met het gebruiken van datapijplijnen!
Cursus
Cursus
blog
Adel Nehme
15 min


