
Cursus
Artificial Intelligence begrijpen
2 uur
426.1K
Tot maart 2026 had Mistral de helft van een voice-pipeline gebouwd. De Voxtral Transcribe-modellen deden spraak-naar-tekst, maar de omgekeerde richting ontbrak. Wilde je applicatie laten spreken, dan moest je een andere provider gebruiken: meestal ElevenLabs voor expressieve stemkloon, OpenAI's TTS-1 voor een minimale integratie, of Google Cloud's Neural2 als je al in dat ecosysteem zat.
Voxtral TTS vult dat gat. Het is Mistrals eerste text-to-speech-model, een systeem met 4,1 miljard parameters dat op basis van een korte audioreferentie spraak in negen talen genereert. De modelgewichten staan op Hugging Face, en de cloud-API is live voor $0,016 per 1.000 tekens, met open gewichten voor self-hosting.
Nog een opmerking over de naamgeving: de eerdere Voxtral-modellen uit juli 2025 zijn spraak-naar-tekst-modellen. Voxtral TTS, uitgebracht op 26 maart 2026, gaat de andere kant op.
Voxtral TTS is een text-to-speech-model dat geschreven tekst omzet in gesproken audio in negen talen: Engels, Frans, Duits, Spaans, Nederlands, Portugees, Italiaans, Hindi en Arabisch. Je kunt een van de 20 ingebouwde preset-stemmen gebruiken, of een referentie-audiofragment aanleveren om de stem van een specifieke spreker te klonen. De aanbevolen fragmentlengte voor klonen is 5 tot 25 seconden, al accepteert het model vanaf 3 seconden.
Mistrals belangrijkste claim is een kleine footprint gecombineerd met wat het omschrijft als kwaliteit op frontier-niveau. De standaard BF16-gewichten op Hugging Face zijn circa 8 GB, en voor self-hosting heb je een GPU met minstens 16 GB VRAM nodig om de inference-overhead op te vangen. In het paper staat dat gequantiseerde versies de gewichten kunnen terugbrengen tot ongeveer 3 GB, al zijn die niet de standaardrelease. Pierre Stock, VP of Science bij Mistral, zei tegen VentureBeat dat het model zelfs op een smartphone kan draaien, maar dat hangt af van quantization en ik kon het niet onafhankelijk verifiëren.
Het model ondersteunt ook wat Mistral "Voice-as-an-instruction" noemt. In plaats van SSML-tags of expliciete emotielabels te gebruiken om te sturen hoe de gegenereerde spraak klinkt, leidt Voxtral TTS de toon, het ritme en de emotionele uitvoering rechtstreeks af uit de door jou aangeleverde stemreferentie. Geef een referentieclip van iemand die opgewonden spreekt, en de gegenereerde spraak neigt die uitvoering te weerspiegelen. Dit is een andere aanpak dan ElevenLabs, dat expliciete emolabels gebruikt om de generatie te sturen.
Voxtral TTS is een transformer-based, autoregressief, flow-matching model gebouwd op Ministral 3B. Het heeft drie componenten: een transformer-decoder-backbone met 3,4B parameters die semantische tokens voorspelt op basis van tekst- en steminput; een flow-matching akoestische transformer met 390M parameters die die tokens omzet in audiorepresentaties; en een neural audio codec met 300M parameters die Mistral from scratch heeft gebouwd, werkend op 12,5 Hz met frames van 80 milliseconden. De codec houdt de audiorepresentatie efficiënt: hij opereert in een sterk gecomprimeerde latente ruimte, waardoor het volledige model met 4,1B parameters audio van hoge kwaliteit kan genereren terwijl de BF16-gewichten rond ~8 GB blijven.
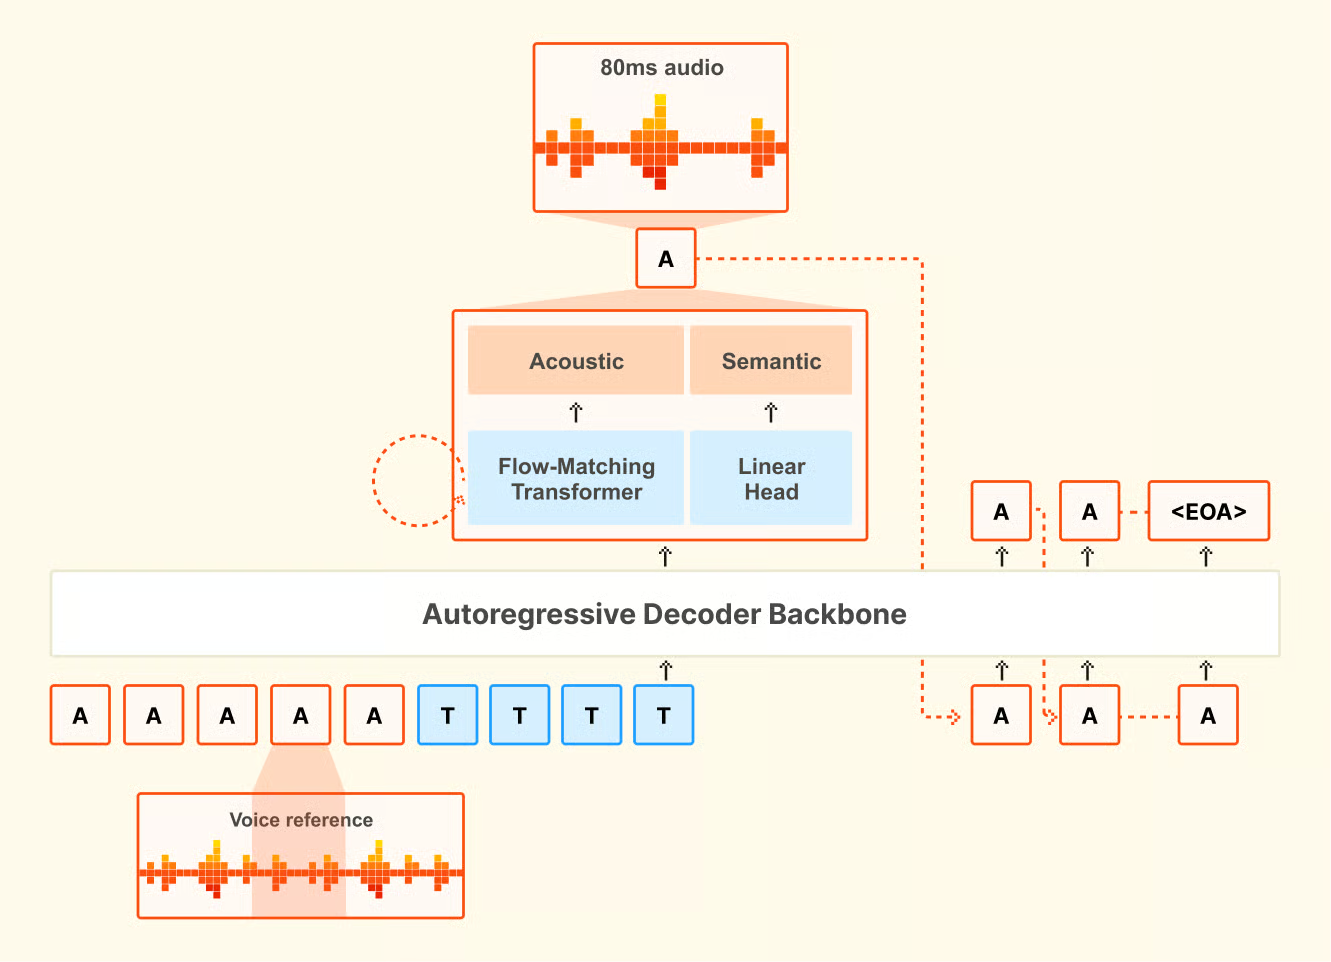
Architectuuroverzicht van Voxtral TTS. Bron: Mistral AI.
Deze driestaps-pipeline maakt stemklonen ook mogelijk: de codec vangt sprekerskenmerken in de latente ruimte, die de backbone en akoestische transformer vervolgens gebruiken om die stem op nieuwe tekst te reproduceren.
Bij stemklonen geef je een korte referentieclip en genereert het model spraak die het accent, de intonatie en het ritme van de spreker vastlegt, inclusief natuurlijke pauzes en timing.
Wat me in het onderzoek verraste, is de cross-linguale capaciteit. Als je een Franse stemreferentie geeft en je prompt in het Duits typt, genereert het model vaak Duitse spraak die lijkt op de Franse spreker, met veel van diens accent en stemkenmerken. Het model is hier niet expliciet op getraind. Het is emergent gedrag, en het kan nuttig zijn voor spraak-naar-spraakvertaling waarbij het behouden van de oorspronkelijke stem over talen heen belangrijk is.
Een praktisch detail: aangepaste stemklonen vereist de Mistral API. De open-gewichtenrelease is beperkt tot diezelfde 20 preset-stemmen. Wil je een specifieke stem klonen op de self-hosted versie, dan heb je de voice creation-endpoint van de API nodig.
Alle benchmarkdata hier komt uit Mistrals eigen interne evaluaties. Het model is nog zo recent dat, op het moment van schrijven, geen onafhankelijke third-party benchmarks zijn gepubliceerd. De Artificial Analysis Speech Arena Leaderboard, een onafhankelijke TTS-ranking, heeft Voxtral TTS nog niet toegevoegd.
Mistral gebruikte voorkeursevaluaties door mensen in plaats van geautomatiseerde metrics zoals Mean Opinion Score (MOS), met het argument in het research paper dat geautomatiseerde scores natuurlijkheid niet betrouwbaar vangen over talen en culturen heen. De tests waren blinde luistersessies uitgevoerd door native annotators in alle negen ondersteunde talen.
In tests met de ingebouwde flagship-stemmen van elk model werd Voxtral TTS in 58,3% van de vergelijkingen verkozen door menselijke beoordelaars. In zero-shot stemkloontests, waarbij beide modellen een korte referentieclip kregen en spraak uit dezelfde tekst genereerden, steeg dat percentage naar 68,4%. De kloof was het grootst in Hindi (ongeveer 80% voorkeur) en Spaans (ongeveer 88% voorkeur). Nederlands was een zwak punt, met 49,4%, wat betekent dat ElevenLabs Flash v2.5 daar de overhand had.
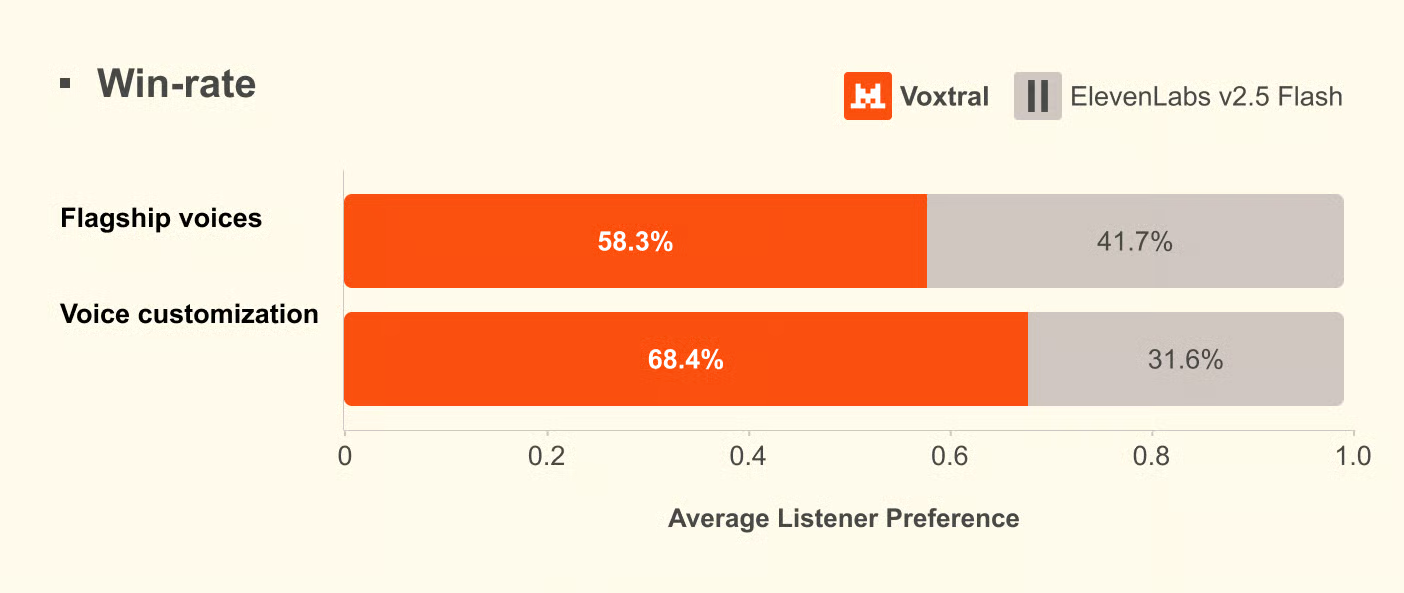
Resultaten van menselijke voorkeur uit Mistral-evaluaties. Bron: Mistral AI.
Mistral voerde ook aparte tests uit rond emotionele sturing, ditmaal vergeleken met ElevenLabs v3 en Gemini 2.5 Flash TTS in plaats van Flash v2.5. Tegen ElevenLabs v3 waren de twee modellen ongeveer gelijk op expliciete sturing; Voxtral had een klein voordeel op impliciete sturing. Tegen Gemini 2.5 Flash TTS kwam Gemini met circa 65% als beste uit de bus, waardoor Gemini in die vergelijking de betere performer is. Deze cijfers, zoals alle in deze sectie, komen uit Mistrals eigen paper.
Qua latency meldt Mistral 70 milliseconden op een enkele NVIDIA H200. End-to-end time-to-first-audio via de API is ongeveer 0,8 seconden met PCM en grofweg 1,5 tot 2 seconden met MP3.
Ik heb me op drie scenario's gericht. Ten eerste: houdt een preset-stem stand voor algemene voice-over, en breekt de natuurlijkheid op de plekken waar TTS-systemen doorgaans struikelen? Ten tweede: hoe goed legt stemklonen een echte spreker vast op basis van een kort fragment, en hoeveel doet fragmentlengte ertoe? Ten derde: hoeveel beïnvloedt het uitvoerformaat in de praktijk de latency?
Installeer eerst de officiële Python-SDK en stel je API-sleutel in. Je hebt een Mistral-account nodig met facturatie ingeschakeld.
pip install mistralaiStel je API-sleutel in als omgevingsvariabele:
export MISTRAL_API_KEY="your-api-key-here"De preset-stemmen dekken Amerikaans Engels, Brits Engels en Franse dialecten en zijn een prima startpunt voor algemene voice-overs waarbij de identiteit van de spreker niet uitmaakt.
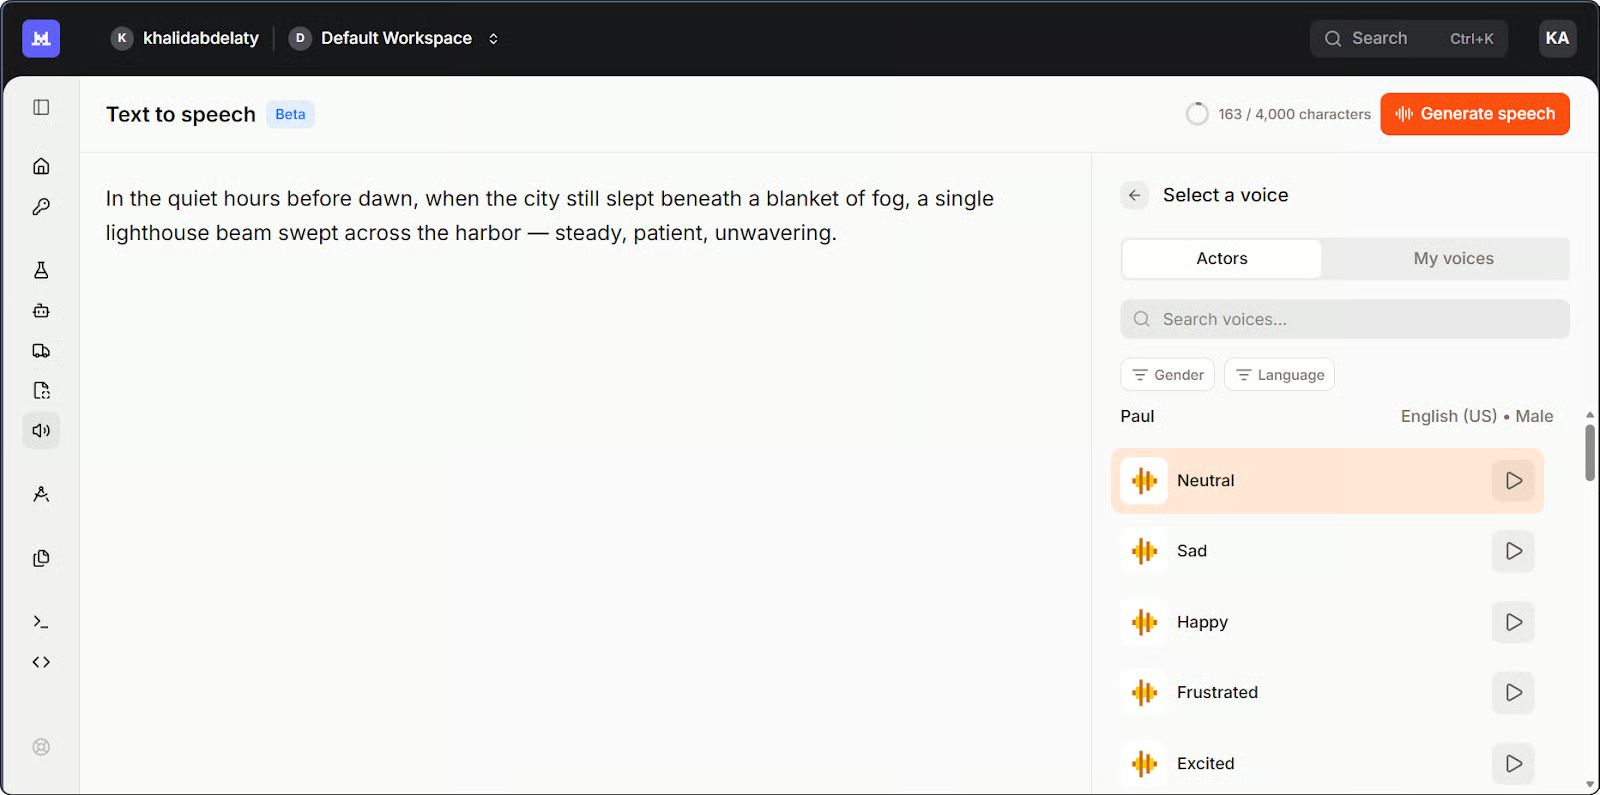
Mistral Studio playground voor Voxtral TTS. Afbeelding door auteur.
Hier is de simpelste variant, met een preset-stem:
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Generate speech from text
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="Welcome to Voxtral TTS. This is a basic speech generation test.",
    voice_id="your-voice-id",  # Use a voice ID from your account
    response_format="mp3",
)

# Save the audio file
Path("basic_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to basic_output.mp3")
Een paar dingen om op te letten. De methode is .complete(), niet .create() zoals je misschien verwacht als je van OpenAI's TTS-API komt. De response retourneert base64-gecodeerde audio in response.audio_data, dus je moet die decoderen voordat je naar schijf schrijft.
Het eerste wat ik controleerde, was het ritme aan het einde van zinnen. Veel TTS-modellen vallen mechanisch terug op de laatste punt, een vlakke cadans die meteen synthetisch klinkt. Dat bleef hier overeind. Wat me verraste, waren de komma-pauzes midden in zinnen: goedkopere systemen behandelen die vaak als harde stops, maar hier bleef het tempo doorlopen. De uitspraak was overal accuraat, ook van het woord "Voxtral" zelf, waarvan ik verwachtte dat het lastig zou zijn.
Als de identiteit van de spreker ertoe doet, kun je via de API een herbruikbaar stemprofiel aanmaken op basis van een korte referentieclip.
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Encode your reference audio as base64
sample_audio_b64 = base64.b64encode(
    Path("reference_voice.mp3").read_bytes()
).decode()

# Create a reusable voice profile
voice = client.audio.voices.create(
    name="my-custom-voice",
    sample_audio=sample_audio_b64,
    sample_filename="reference_voice.mp3",
    languages=["en"],
    gender="male",
)

print(f"Created voice with ID: {voice.id}")

# Generate speech using the cloned voice
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="This sentence was generated using a cloned voice from just a few seconds of reference audio.",
    voice_id=voice.id,
    response_format="mp3",
)

Path("cloned_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to cloned_output.mp3")
Terminaluitvoer van script voor stemklonen. Afbeelding door auteur.
Mijn eerste poging gebruikte een fragment van ongeveer drie seconden. De output klonk aannemelijk maar generiek: de juiste stemhoogte, maar zonder de specifieke nuances die een stem herkenbaar maken. Het had van iedereen kunnen zijn. Toen ik overschakelde naar een fragment van acht seconden, was het verschil duidelijk: de gekloonde output pakte het accent, het ritme en de lichte stijging aan het einde van vragen die het kortere fragment volledig had afgevlakt.
De gekloonde stem klonk niet identiek aan de bron, maar zat duidelijk in hetzelfde register met vergelijkbare timing. Op basis van mijn tests is 8 tot 15 seconden een goed midden tussen moeite en kwaliteitswinst.
Het uitvoerformaat beïnvloedt hoe snel de eerste audiochunk binnenkomt. Ik heb twee formaten getest.
import os
import time
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

text = "This is a latency test comparing PCM and MP3 output formats from Voxtral TTS."
voice_id = "your-voice-id"


def time_to_first_chunk(response_format):
    start = time.time()
    stream = client.audio.speech.complete(
        model="voxtral-mini-tts-2603",
        input=text,
        voice_id=voice_id,
        response_format=response_format,
        stream=True,
    )
    for _ in stream:
        return time.time() - start  # return on first chunk


pcm_time = time_to_first_chunk("pcm")
mp3_time = time_to_first_chunk("mp3")

print(f"PCM latency: {pcm_time:.2f}s")
print(f"MP3 latency: {mp3_time:.2f}s")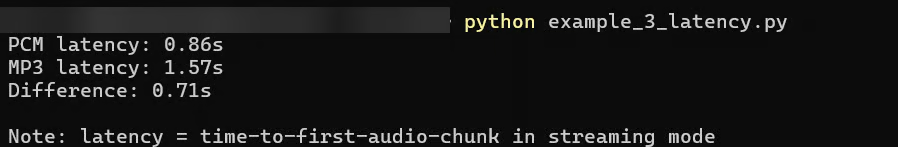
Latentievergelijking tussen twee uitvoerformaten. Afbeelding door auteur.
Ik draaide de MP3-test eerst, omdat dat de natuurlijke default is voor de meeste audiowerkstromen. Het resultaat was bruikbaar rond 1,5 tot 2 seconden, maar voor een voice-agent is dat een merkbare pauze voordat audio begint te spelen. Mistrals documentatie noemt tot 3 seconden voor MP3; dat zag ik in de praktijk niet, al verschillen netwerkcondities. PCM kwam uit rond 0,6 tot 0,9 seconden, in lijn met Mistrals gemelde ~0,8 seconde.
Het nadeel is dat PCM ruwe, ongecomprimeerde audio is, dus je applicatie moet dat verwerken of converteren voor standaardweergave. Als je naar een bestand schrijft of een standaard audioplayer voedt, is MP3 eenvoudiger. Als je de audiostack direct beheert, zoals in een voice-agent pipeline, is PCM in de praktijk de beste keuze qua latency.
De API ondersteunt vijf uitvoerformaten: MP3, WAV, PCM (raw float32), FLAC en Opus. Het model genereert tot twee minuten audio in één keer. Voor langere content handelt de API dit automatisch af met wat Mistral "smart interleaving" noemt: de tekst wordt opgesplitst in stukken, elk stuk wordt gesynthetiseerd en ze worden zonder hoorbare gaten samengevoegd.
Ik heb ook een korte Streamlit-app gemaakt die alle drie de voorbeelden in één interface combineert. Hier is een snelle walkthrough van hoe het werkt:
Leer AI met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

