
Khóa học
Hiểu về Trí tuệ Nhân tạo
2 giờ
426.1K
Đến tháng 3 năm 2026, Mistral đã xây dựng được một nửa chuỗi xử lý giọng nói. Các mô hình Voxtral Transcribe xử lý từ giọng nói sang văn bản, nhưng chưa có cách đi theo chiều ngược lại. Nếu bạn muốn ứng dụng của mình biết nói, bạn phải dùng nhà cung cấp khác, thường là ElevenLabs cho nhân bản giọng nói giàu biểu cảm, OpenAI's TTS-1 cho tích hợp tối giản, hoặc Google Cloud's Neural2 nếu bạn đã ở trong hệ sinh thái đó.
Voxtral TTS lấp đầy khoảng trống đó. Đây là mô hình chuyển văn bản thành giọng nói đầu tiên của Mistral, một hệ thống 4,1 tỷ tham số có thể tạo giọng nói bằng chín ngôn ngữ từ một đoạn âm thanh tham chiếu ngắn. Trọng số mô hình có sẵn trên Hugging Face, và API đám mây đã hoạt động với giá $0,016 cho mỗi 1.000 ký tự, kèm trọng số mở để tự lưu trữ.
Một lưu ý về cách đặt tên: các mô hình Voxtral từ tháng 7/2025 là mô hình chuyển giọng nói sang văn bản. Voxtral TTS, phát hành ngày 26/03/2026, đi theo chiều ngược lại.
Voxtral TTS là mô hình chuyển văn bản thành giọng nói, biến văn bản viết thành âm thanh lời nói bằng chín ngôn ngữ: tiếng Anh, Pháp, Đức, Tây Ban Nha, Hà Lan, Bồ Đào Nha, Ý, Hindi và Ả Rập. Bạn có thể dùng một trong 20 giọng dựng sẵn, hoặc cung cấp một đoạn âm thanh tham chiếu để nhân bản giọng nói của một người cụ thể. Độ dài đoạn tham chiếu khuyến nghị để nhân bản là 5 đến 25 giây, dù mô hình chấp nhận ít nhất 3 giây.
Tuyên bố chính của Mistral là kích thước gọn nhẹ kết hợp với chất lượng ở mức tiên phong. Trọng số BF16 mặc định trên Hugging Face khoảng 8 GB, và tự lưu trữ cần GPU với ít nhất 16 GB VRAM để đáp ứng chi phí suy luận. Bài báo nghiên cứu lưu ý rằng các phiên bản lượng tử hóa có thể giảm trọng số xuống khoảng 3 GB, dù đó không phải bản phát hành mặc định. Pierre Stock, Phó Chủ tịch Khoa học của Mistral, nói với VentureBeat rằng mô hình thậm chí có thể chạy trên điện thoại thông minh, dù điều đó phụ thuộc vào lượng tử hóa và tôi không thể tự xác minh độc lập.
Mô hình cũng hỗ trợ cái mà Mistral gọi là "Voice-as-an-instruction" (Giọng nói như hướng dẫn). Thay vì dựa vào thẻ SSML hoặc nhãn cảm xúc rõ ràng để điều khiển cách giọng nói được tạo ra, Voxtral TTS suy ra tông giọng, nhịp điệu và cách truyền tải cảm xúc trực tiếp từ mẫu giọng tham chiếu bạn cung cấp. Đưa cho nó một đoạn tham chiếu ai đó đang nói đầy phấn khích, giọng tạo ra có xu hướng phản ánh cách truyền tải đó. Đây là cách tiếp cận khác với ElevenLabs, vốn dùng nhãn cảm xúc rõ ràng để điều hướng quá trình tạo.
Voxtral TTS là mô hình dựa trên transformer, tự hồi quy, dùng flow-matching, được xây dựng trên Ministral 3B. Nó có ba thành phần: một backbone decoder transformer 3,4 tỷ tham số dự đoán token ngữ nghĩa từ văn bản và giọng nói đầu vào; một transformer âm học flow-matching 390 triệu tham số chuyển các token đó thành biểu diễn âm thanh; và một codec âm thanh thần kinh 300 triệu tham số do Mistral xây dựng từ đầu, hoạt động ở 12,5 Hz với khung 80 mili giây. Codec là thứ giúp biểu diễn âm thanh hiệu quả: nó hoạt động trong không gian latent nén chặt, đó là lý do mô hình 4,1 tỷ tham số hoàn chỉnh có thể tạo âm thanh chất lượng cao trong khi giữ trọng số BF16 khoảng ~8 GB.
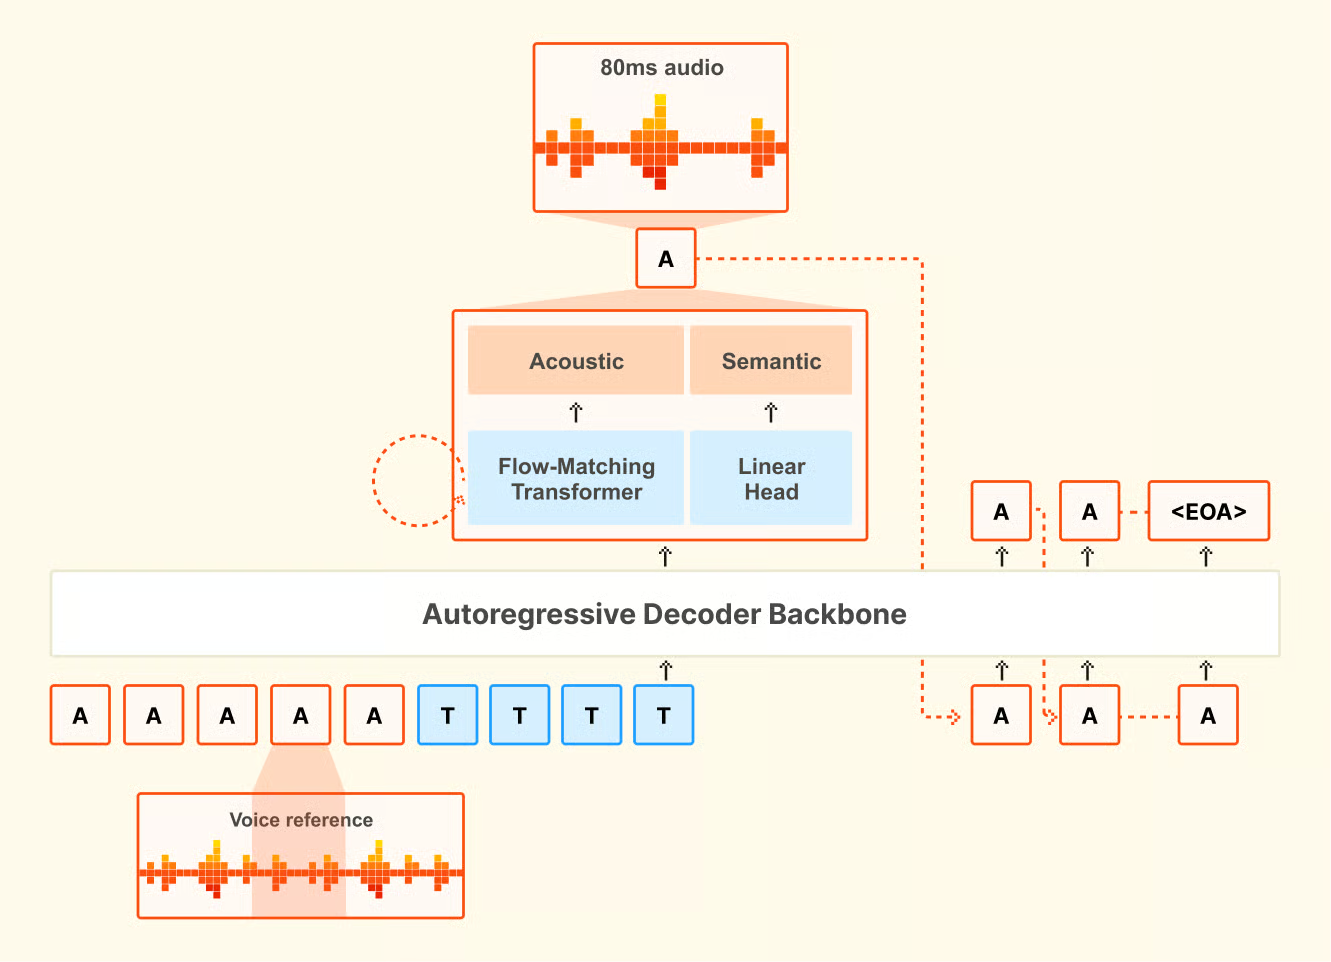
Tổng quan kiến trúc của Voxtral TTS. Nguồn: Mistral AI.
Chuỗi ba giai đoạn này cũng là yếu tố khiến nhân bản giọng nói khả thi: codec ghi nhận đặc trưng người nói trong không gian latent, sau đó backbone và transformer âm học dùng để tái tạo giọng đó trên văn bản mới.
Với nhân bản giọng nói, bạn cung cấp một đoạn tham chiếu ngắn và mô hình sẽ tạo giọng nói nắm bắt được chất giọng, ngữ điệu và nhịp điệu của người nói, bao gồm cả ngắt nghỉ và tốc độ tự nhiên.
Điều khiến tôi bất ngờ trong nghiên cứu là khả năng liên ngôn ngữ. Nếu bạn đưa một tham chiếu giọng nói tiếng Pháp và nhập lời nhắc bằng tiếng Đức, mô hình có xu hướng tạo giọng nói tiếng Đức nghe tương tự người nói tiếng Pháp đó, giữ được nhiều nét giọng và đặc trưng âm sắc của họ. Đây không phải điều mô hình được huấn luyện rõ ràng để làm. Nó là hành vi nổi lên và có thể hữu ích cho dịch giọng nói sang giọng nói khi cần giữ tiếng nói gốc của người nói qua các ngôn ngữ.
Một chi tiết thực tế: nhân bản giọng tùy chỉnh cần API của Mistral. Bản phát hành trọng số mở bị giới hạn ở 20 giọng dựng sẵn đó. Nếu bạn muốn nhân bản một giọng cụ thể trên phiên bản tự lưu trữ, bạn cần endpoint tạo giọng của API.
Tất cả dữ liệu điểm chuẩn ở đây đến từ các đánh giá nội bộ của Mistral. Mô hình còn đủ mới để, tại thời điểm viết bài, chưa có điểm chuẩn độc lập từ bên thứ ba được công bố. Bảng xếp hạng Artificial Analysis Speech Arena, một bảng xếp hạng TTS độc lập, hiện chưa thêm Voxtral TTS.
Mistral sử dụng đánh giá ưu tiên của con người thay vì các chỉ số tự động như Mean Opinion Score (MOS), với lập luận trong bài nghiên cứu rằng điểm số tự động không phản ánh một cách tin cậy tính tự nhiên xuyên ngôn ngữ và văn hóa. Các thử nghiệm là so sánh nghe mù do người bản ngữ thực hiện trên cả chín ngôn ngữ được hỗ trợ.
Trong các bài thử dùng giọng chủ lực dựng sẵn của mỗi mô hình, Voxtral TTS được người đánh giá ưa thích trong 58,3% so sánh. Trong các thử nghiệm nhân bản giọng zero-shot, nơi cả hai mô hình nhận cùng một đoạn tham chiếu ngắn và tạo giọng nói từ cùng văn bản, tỷ lệ đó tăng lên 68,4%. Chênh lệch lớn nhất ở tiếng Hindi (khoảng 80% ưa thích) và tiếng Tây Ban Nha (khoảng 88% ưa thích). Tuy nhiên, tiếng Hà Lan là điểm yếu, ở mức 49,4%, nghĩa là ElevenLabs Flash v2.5 nhỉnh hơn ở ngôn ngữ đó.
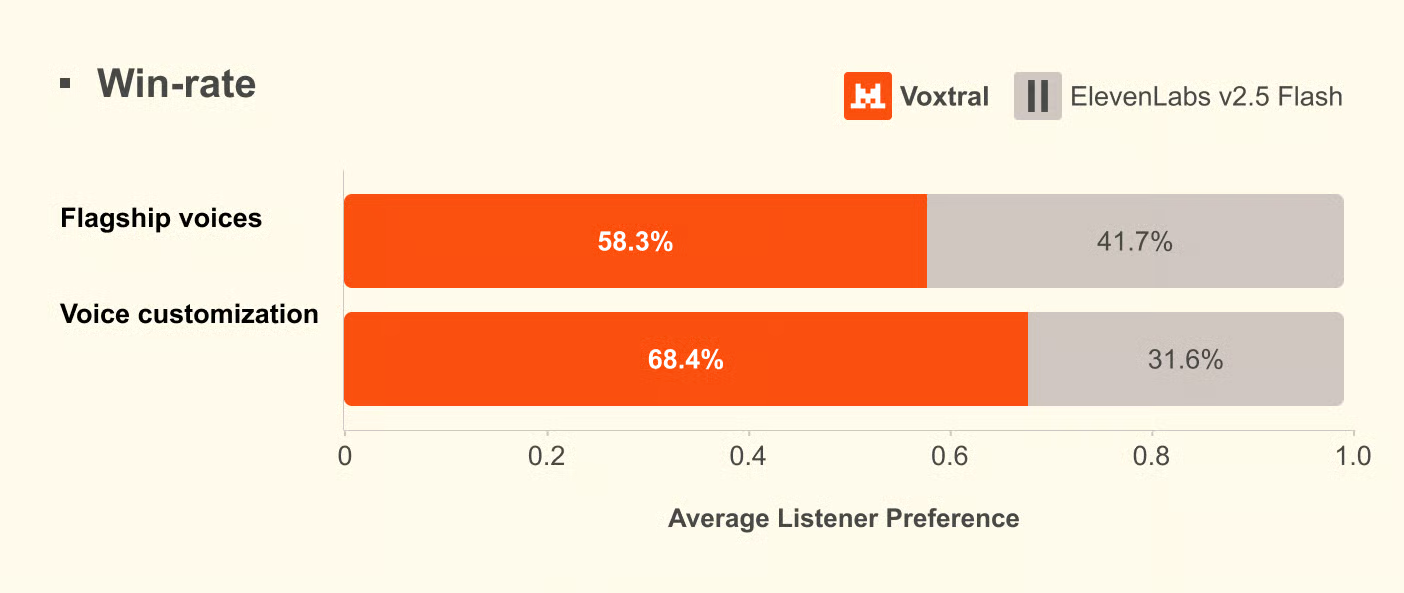
Kết quả ưu tiên của con người từ đánh giá của Mistral. Nguồn: Mistral AI.
Mistral cũng chạy một bộ thử nghiệm điều hướng cảm xúc riêng, lần này so sánh với ElevenLabs v3 và Gemini 2.5 Flash TTS thay vì Flash v2.5. So với ElevenLabs v3, hai mô hình gần như ngang nhau ở điều hướng tường minh; Voxtral nhỉnh hơn chút ở điều hướng ngầm. So với Gemini 2.5 Flash TTS, Gemini vượt lên khoảng 65%, khiến Gemini là bên hoạt động tốt hơn trong so sánh đó. Các con số này, như toàn bộ phần này, đến từ chính bài báo của Mistral.
Về độ trễ, Mistral báo cáo 70 mili giây trên một NVIDIA H200. Thời gian từ đầu đến âm thanh đầu tiên từ API khoảng 0,8 giây với PCM và khoảng 1,5 đến 2 giây với MP3.
Tôi tập trung vào ba kịch bản. Thứ nhất, liệu một giọng dựng sẵn có ổn cho thuyết minh chung, cụ thể là liệu tính tự nhiên có sụp đổ ở những chỗ mà hệ thống TTS thường thất bại hay không. Thứ hai, khả năng nhân bản giọng nói từ một đoạn ngắn tốt đến đâu, và độ dài đoạn tham chiếu thực sự quan trọng đến mức nào. Thứ ba, định dạng đầu ra ảnh hưởng thế nào đến độ trễ trong thực tế.
Đầu tiên, cài đặt Python SDK chính thức và đặt khóa API. Bạn sẽ cần một tài khoản Mistral đã bật thanh toán.
pip install mistralaiĐặt khóa API của bạn làm biến môi trường:
export MISTRAL_API_KEY="your-api-key-here"Các giọng dựng sẵn bao phủ tiếng Anh Mỹ, tiếng Anh Anh và các phương ngữ tiếng Pháp, và là điểm khởi đầu hợp lý cho thuyết minh chung khi không cần quan tâm đến danh tính người nói.
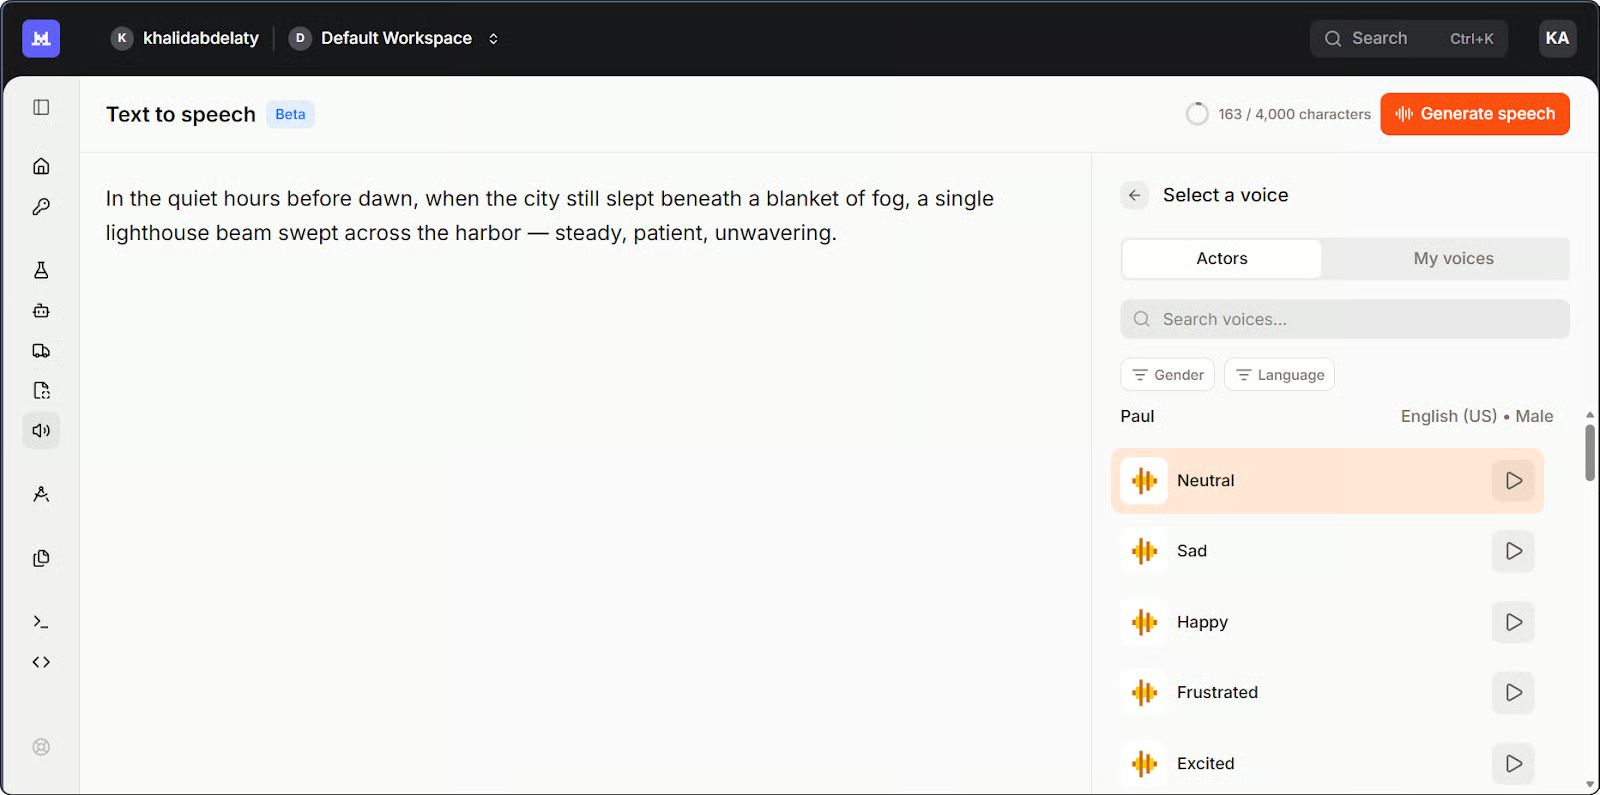
Sân chơi Mistral Studio cho Voxtral TTS. Ảnh: Tác giả.
Đây là phiên bản đơn giản nhất, dùng giọng dựng sẵn:
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Generate speech from text
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="Welcome to Voxtral TTS. This is a basic speech generation test.",
    voice_id="your-voice-id",  # Use a voice ID from your account
    response_format="mp3",
)

# Save the audio file
Path("basic_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to basic_output.mp3")
Có vài điểm cần lưu ý. Phương thức là .complete(), không phải .create() như bạn có thể kỳ vọng nếu đến từ API TTS của OpenAI. Phản hồi trả về âm thanh mã hóa base64 trong response.audio_data, nên bạn cần giải mã trước khi ghi ra đĩa.
Điều đầu tiên tôi kiểm tra là nhịp câu ở cuối câu. Nhiều mô hình TTS rơi xuống một cách máy móc ở dấu chấm cuối, nhịp điệu phẳng khiến nhận ra ngay là tổng hợp. Ở đây thì vẫn ổn. Điều khiến tôi ngạc nhiên là các điểm ngắt phẩy giữa câu: các hệ rẻ hơn thường coi đó là điểm dừng cứng, nhưng nhịp độ ở đây vẫn liền mạch. Phát âm chính xác suốt đoạn, kể cả từ "Voxtral" vốn tôi nghĩ sẽ vấp.
Khi danh tính người nói quan trọng, API cho phép bạn tạo hồ sơ giọng nói có thể tái sử dụng từ một đoạn tham chiếu ngắn.
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Encode your reference audio as base64
sample_audio_b64 = base64.b64encode(
    Path("reference_voice.mp3").read_bytes()
).decode()

# Create a reusable voice profile
voice = client.audio.voices.create(
    name="my-custom-voice",
    sample_audio=sample_audio_b64,
    sample_filename="reference_voice.mp3",
    languages=["en"],
    gender="male",
)

print(f"Created voice with ID: {voice.id}")

# Generate speech using the cloned voice
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="This sentence was generated using a cloned voice from just a few seconds of reference audio.",
    voice_id=voice.id,
    response_format="mp3",
)

Path("cloned_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to cloned_output.mp3")
Đầu ra terminal từ script nhân bản giọng. Ảnh: Tác giả.
Lần thử đầu tôi dùng một đoạn dài khoảng ba giây. Kết quả nghe hợp lý nhưng chung chung: đúng quãng giọng, nhưng thiếu những luyến láy đặc trưng giúp nhận diện. Có thể là bất kỳ ai. Khi tôi chuyển sang đoạn tám giây, khác biệt rõ rệt: đầu ra nhân bản bắt được chất giọng, nhịp điệu và độ nâng nhẹ ở cuối câu hỏi mà đoạn ngắn hơn đã làm phẳng hoàn toàn.
Giọng nhân bản không giống hệt nguồn, nhưng rõ ràng cùng quãng và nhịp tương tự. Theo thử nghiệm của tôi, 8 đến 15 giây là điểm cân bằng tốt giữa công sức và chất lượng.
Định dạng đầu ra ảnh hưởng đến tốc độ nhận đoạn âm thanh đầu tiên. Tôi thử hai định dạng.
import os
import time
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

text = "This is a latency test comparing PCM and MP3 output formats from Voxtral TTS."
voice_id = "your-voice-id"


def time_to_first_chunk(response_format):
    start = time.time()
    stream = client.audio.speech.complete(
        model="voxtral-mini-tts-2603",
        input=text,
        voice_id=voice_id,
        response_format=response_format,
        stream=True,
    )
    for _ in stream:
        return time.time() - start  # return on first chunk


pcm_time = time_to_first_chunk("pcm")
mp3_time = time_to_first_chunk("mp3")

print(f"PCM latency: {pcm_time:.2f}s")
print(f"MP3 latency: {mp3_time:.2f}s")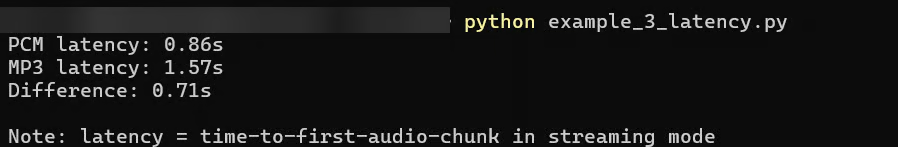
So sánh độ trễ giữa hai định dạng đầu ra. Ảnh: Tác giả.
Tôi chạy thử MP3 trước, vì đó là mặc định tự nhiên cho hầu hết quy trình âm thanh. Kết quả dùng được ở khoảng 1,5 đến 2 giây, nhưng với một tác tử giọng nói, đó là khoảng dừng nhận thấy trước khi âm thanh bắt đầu phát. Tài liệu của Mistral nêu có thể lên đến 3 giây với MP3; tôi không gặp trong thực tế, dù điều kiện mạng có thể khác. PCM vào khoảng 0,6 đến 0,9 giây, phù hợp với con số ~0,8 giây Mistral báo cáo.
Đổi lại, PCM là âm thanh thô, chưa nén, nên ứng dụng của bạn cần xử lý hoặc chuyển đổi trước khi phát theo chuẩn. Nếu bạn lưu file hoặc đưa vào trình phát âm thanh tiêu chuẩn, MP3 đơn giản hơn. Nếu bạn kiểm soát trực tiếp chuỗi âm thanh, như trong pipeline tác tử giọng nói, PCM là lựa chọn thực tiễn về độ trễ.
API hỗ trợ năm định dạng đầu ra: MP3, WAV, PCM (float32 thô), FLAC và Opus. Mô hình tạo tối đa hai phút âm thanh trong một lần. Với nội dung dài hơn, API sẽ xử lý tự động bằng cái Mistral gọi là "smart interleaving": tách văn bản thành đoạn, tổng hợp từng đoạn và nối lại mà không có khoảng trống có thể nghe thấy.
Tôi cũng ghép một ứng dụng Streamlit ngắn kết hợp cả ba ví dụ vào một giao diện. Dưới đây là phần giới thiệu nhanh cách nó hoạt động:
Học AI với DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
