
课程
理解 Artificial Intelligence
2 小时
426.1K
截至 2026 年 3 月,Mistral 的语音管线只完成了一半。其 Voxtral Transcribe 模型负责语音转文本,但无法反向转换。如果您需要让应用开口说话,就得借助其他提供商:通常是用于富有表现力的声音克隆的 ElevenLabs、集成最简的 OpenAI TTS-1,或已在该生态中的 Google Cloud Neural2。
Voxtral TTS 填补了这块空白。它是 Mistral 的首个文本转语音模型,拥有 41 亿参数,可基于一段简短的音频参考在九种语言中生成语音。模型权重已发布在 Hugging Face,云端 API 已上线,价格为每 1,000 个字符 0.016 美元,且开放权重可用于自托管。
关于命名需注意:较早的 2025 年 7 月发布的 Voxtral 模型 是语音转文本模型。2026 年 3 月 26 日发布的 Voxtral TTS 则反向工作。
Voxtral TTS 是一款文本转语音模型,可将书面文本转换为九种语言的口语音频:英语、法语、德语、西班牙语、荷兰语、葡萄牙语、意大利语、印地语和阿拉伯语。您可以使用 20 个内置预设声音之一,或提供参考音频片段来克隆特定说话者的声音。官方建议用于克隆的片段长度为 5–25 秒,最短可接受 3 秒。
Mistral 的主要主张是小巧的体量与其所谓前沿级质量并存。Hugging Face 上的默认 BF16 权重大约 8 GB,而自托管推理需要至少 16 GB 显存的 GPU 以覆盖开销。论文指出,量化版本可将权重降至约 3 GB,但这不是默认发布。Mistral 科学副总裁 Pierre Stock 告诉 VentureBeat,该模型甚至可以在智能手机上运行,不过这取决于量化方案,我未能独立验证。
该模型还支持 Mistral 称之为“将声音作为指令”(Voice-as-an-instruction)的方法。与依赖 SSML 标签或显式情感标签来控制合成语音的方式不同,Voxtral TTS 可直接从您提供的语音参考中推断语气、节奏和情感表达。给它一段激动语气的参考片段,生成的语音往往会体现出类似的表达方式。这与 ElevenLabs 通过显式情感标签引导生成的做法不同。
Voxtral TTS 是一款基于 Transformer、采用自回归与流匹配(flow-matching)方法的模型,构建于 Ministral 3B 之上。它包含三个组件:一个 34 亿参数的 Transformer 解码器骨干网络,从文本与语音输入中预测语义 token;一个 3.9 亿参数的流匹配声学 Transformer,将这些 token 转换为音频表示;以及一个由 Mistral 自研的 3 亿参数神经音频编解码器,以 12.5 Hz、80 毫秒帧率运行。该编解码器保持了高效的音频表示:它在高度压缩的潜在空间中工作,这也是为何完整的 41 亿参数模型能够生成高质量音频,同时将 BF16 权重保持在约 8 GB。
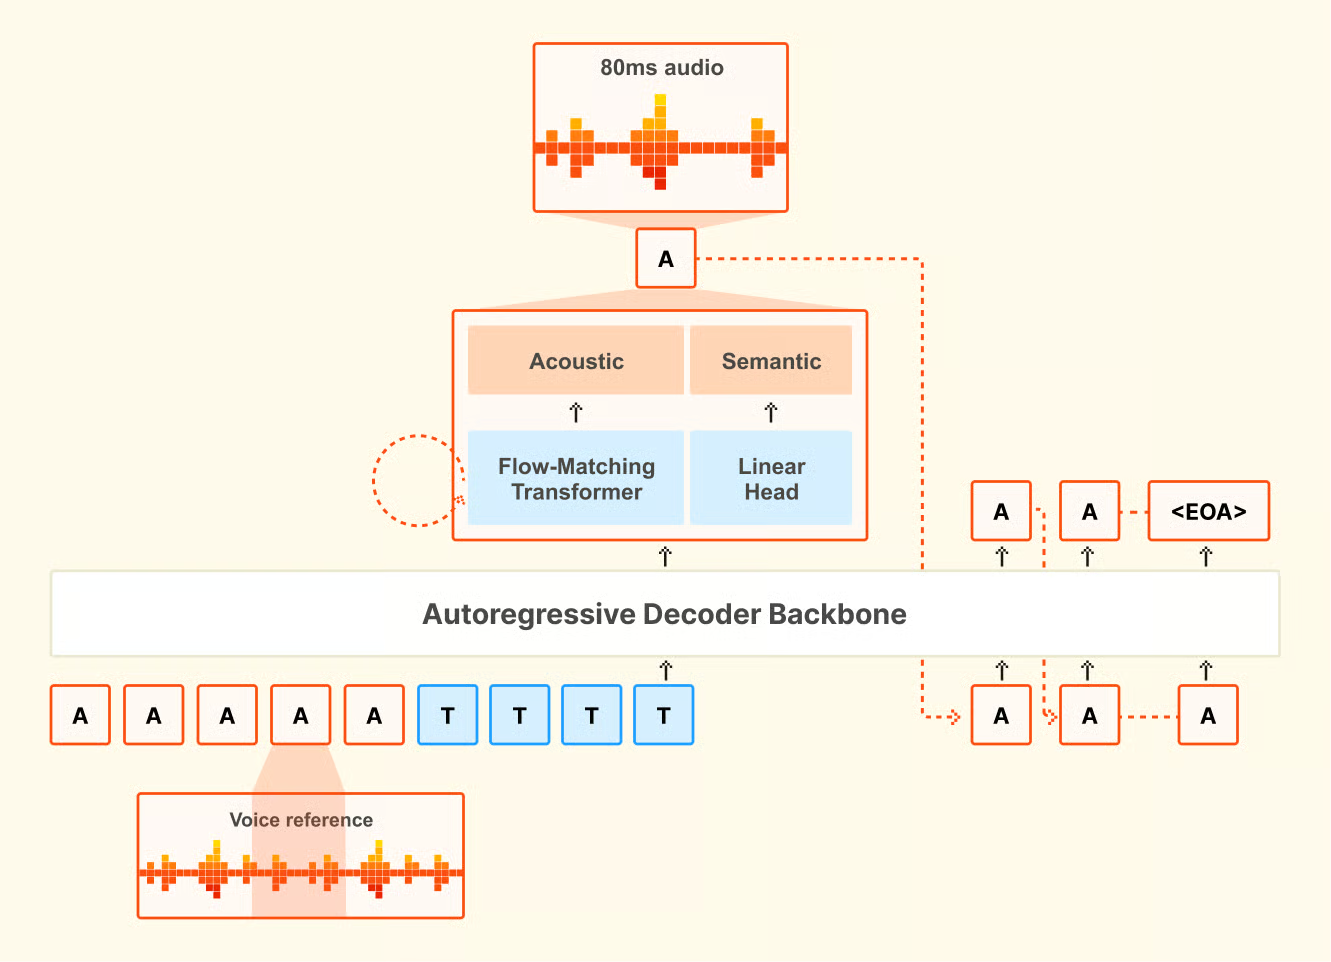
Voxtral TTS 的架构概览。来源:Mistral AI。
这条三阶段流水线也使得声音克隆成为可能:编解码器在潜在空间中捕捉说话者特征,骨干网络与声学 Transformer 则据此在新文本上重现该声音。
通过声音克隆,您只需提供一段简短的参考片段,模型即可生成语音,捕捉说话者的口音、语调与节奏,包括自然的停顿与语速。
让我在研究中感到意外的是跨语言能力。如果您提供法语的语音参考,而用德语编写提示,模型常会生成德语语音,同时保留法语说话者的音色与诸多声学特征。这并非模型的显式训练目标,而是一种涌现行为;在语音到语音翻译中希望跨语言保留原声的场景里,它可能很有用。
一个实用细节:自定义声音克隆需要使用 Mistral API。开放权重版本仅限同样的 20 个预设声音。如果您想在自托管版本中克隆特定声音,需要使用 API 的语音创建端点。
本节所有基准数据均来自 Mistral 的内部评估。由于模型发布尚新,撰写本文时尚无独立第三方基准。独立的 TTS 排名 Artificial Analysis Speech Arena Leaderboard 也尚未加入 Voxtral TTS。
Mistral 采用人工偏好评估,而非 Mean Opinion Score(MOS)等自动化指标,并在其 论文中指出,自动评分难以可靠地跨语言与文化捕捉自然度。测试由各支持语言的母语标注者进行盲听对比。
在使用各模型自带旗舰声音的测试中,Voxtral TTS 在 58.3% 的对比中获得人类标注者偏好。在零样本声音克隆测试中(两个模型都接收同一短参考片段并从相同文本生成语音),这一比例上升至 68.4%。差距在印地语(约 80% 偏好)和西班牙语(约 88% 偏好)上最为明显。荷兰语是弱项,仅为 49.4%,即 ElevenLabs Flash v2.5 在该语言上占优。
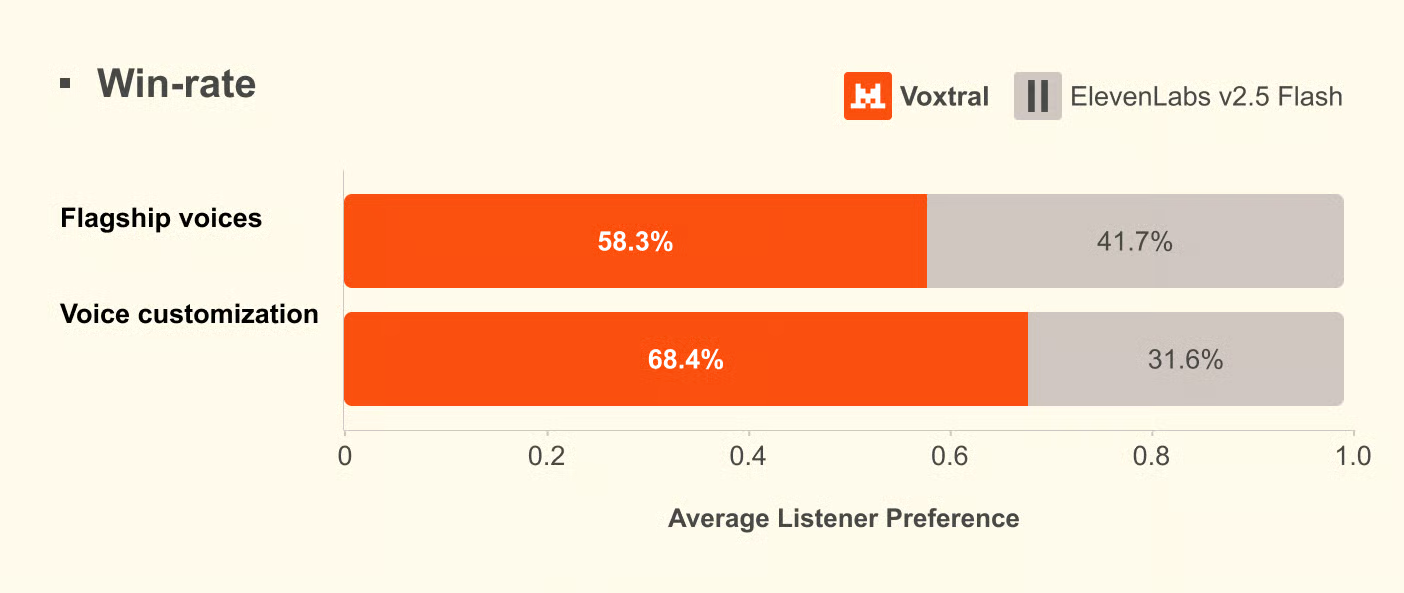
Mistral 评估的人类偏好结果。来源:Mistral AI。
Mistral 还进行了独立的情感引导测试,这次的对比对象是 ElevenLabs v3 与 Gemini 2.5 Flash TTS,而非 Flash v2.5。与 ElevenLabs v3 对比,两者在显式引导上大致持平;在隐式引导上 Voxtral 略占优势。与 Gemini 2.5 Flash TTS 对比,Gemini 以约 65% 的优势胜出,在该对比中表现更好。以上数据均出自 Mistral 论文。
在延迟方面,Mistral 报告在单张 NVIDIA H200 上为 70 毫秒。API 端到端首帧音频时间(time-to-first-audio)约为 PCM 0.8 秒、MP3 约 1.5–2 秒。
我聚焦于三种场景。其一,预设声音在通用解说中的表现,尤其是 TTS 系统常翻车的自然度问题。其二,声音克隆能否通过一段短片段捕捉真实说话者,以及片段时长到底有多大影响。其三,输出格式在实际中对延迟的影响。
首先安装官方 Python SDK 并设置 API 密钥。您需要一个启用计费的 Mistral 账户。
pip install mistralai将您的 API 密钥设置为环境变量:
export MISTRAL_API_KEY="your-api-key-here"预设声音涵盖美式英语、英式英语和法语方言,对于不强调说话者身份的通用解说是一个合理的起点。
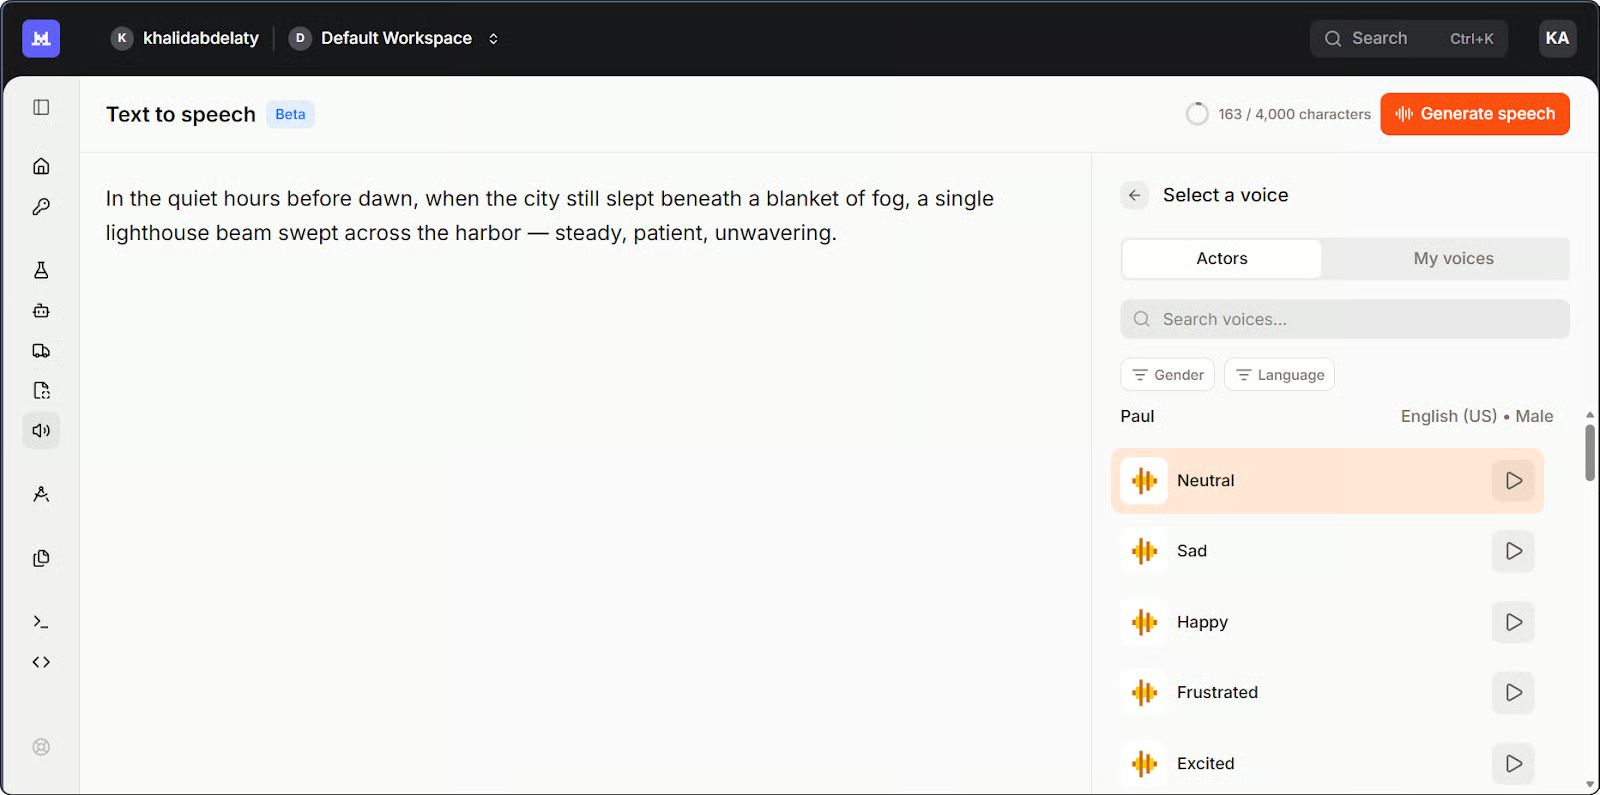
Voxtral TTS 的 Mistral Studio 操作台。作者拍摄。
以下是最简单的用法,使用预设声音:
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Generate speech from text
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="Welcome to Voxtral TTS. This is a basic speech generation test.",
    voice_id="your-voice-id",  # Use a voice ID from your account
    response_format="mp3",
)

# Save the audio file
Path("basic_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to basic_output.mp3")
需要注意两点。使用的方法是 .complete(),而不是 .create() ——如果您来自 OpenAI 的 TTS API 可能会有此预期。响应会在 response.audio_data 中返回 base64 编码的音频,因此写入磁盘前需要解码。
我首先检查的是句末节奏。许多 TTS 模型在句号处机械式下落,平直的收尾会立刻暴露“合成感”。这里的表现经得住考验。让我意外的是句中逗号处的停顿:低价系统往往将其视作硬停,但这里的节奏保持连贯。发音整体准确,包括“Voxtral”这个词,本以为会绊一下。
当说话者身份重要时,API 允许您从一段短参考片段创建可复用的声音配置。
import base64
import os
from pathlib import Path
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

# Encode your reference audio as base64
sample_audio_b64 = base64.b64encode(
    Path("reference_voice.mp3").read_bytes()
).decode()

# Create a reusable voice profile
voice = client.audio.voices.create(
    name="my-custom-voice",
    sample_audio=sample_audio_b64,
    sample_filename="reference_voice.mp3",
    languages=["en"],
    gender="male",
)

print(f"Created voice with ID: {voice.id}")

# Generate speech using the cloned voice
response = client.audio.speech.complete(
    model="voxtral-mini-tts-2603",
    input="This sentence was generated using a cloned voice from just a few seconds of reference audio.",
    voice_id=voice.id,
    response_format="mp3",
)

Path("cloned_output.mp3").write_bytes(base64.b64decode(response.audio_data))
print("Saved to cloned_output.mp3")
声音克隆脚本的终端输出。作者拍摄。
我第一次尝试使用了约三秒的片段。输出听起来可信但泛化:音域对了,但缺少能让人一听就认出的细微语调,像是谁都行。换成八秒片段后,差异明显:克隆输出捕捉到了说话者的口音、节奏,以及疑问句末尾轻微上扬——短片段里这些都被完全抹平了。
克隆声音并非与源音一模一样,但能清晰地处在同一声区,且语速相近。就我的测试而言,8–15 秒在投入与效果之间达到了较好的平衡。
输出格式会影响首段音频到达的速度。我测试了两种格式。
import os
import time
from mistralai.client import Mistral

client = Mistral(api_key=os.getenv("MISTRAL_API_KEY"))

text = "This is a latency test comparing PCM and MP3 output formats from Voxtral TTS."
voice_id = "your-voice-id"


def time_to_first_chunk(response_format):
    start = time.time()
    stream = client.audio.speech.complete(
        model="voxtral-mini-tts-2603",
        input=text,
        voice_id=voice_id,
        response_format=response_format,
        stream=True,
    )
    for _ in stream:
        return time.time() - start  # return on first chunk


pcm_time = time_to_first_chunk("pcm")
mp3_time = time_to_first_chunk("mp3")

print(f"PCM latency: {pcm_time:.2f}s")
print(f"MP3 latency: {mp3_time:.2f}s")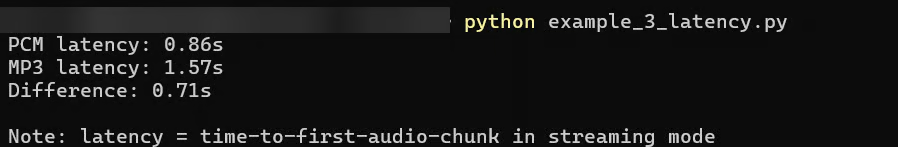
两种输出格式的延迟对比。作者拍摄。
我先测了 MP3,因为在多数音频工作流中它是自然默认。结果可用,大约 1.5–2 秒,但对语音代理而言,在开始播放前这段可感知的停顿并不理想。Mistral 文档称 MP3 可达 3 秒;我未遇到如此情况,但网络状况会有差异。PCM 大约为 0.6–0.9 秒,与 Mistral 报告的约 0.8 秒一致。
权衡在于 PCM 是原始未压缩音频,因此您的应用需要在标准播放前处理或转换。如果要保存文件或交由标准播放器,MP3 更简单;若您能直接控制音频栈,如在语音代理流水线中,从延迟角度看 PCM 更实用。
API 支持五种输出格式:MP3、WAV、PCM(原始 float32)、FLAC 和 Opus。模型可在一次生成中输出最长两分钟的音频。对于更长内容,API 会自动采用 Mistral 所称的“智能交错”:将文本拆分为片段、分别合成并无缝拼接。
我还用 Streamlit 做了一个小应用,把上述三个示例整合在一个界面中。下面是其工作流程的快速演示:
在 DataCamp 学习 AI
课程
课程
课程