
Last chance! 50% off DataCamp Premium
Sale ends in
Weet je waarom je model 99% nauwkeurigheid heeft op trainingsdata maar in productie niets goed lijkt te voorspellen?
Er is een verschil tussen een model dat uit het hoofd leert en een model dat echt leert. Generaliseren is de kern van machine learning: je wilt voorspellingen die standhouden op data die het model nog nooit heeft gezien, niet alleen op de data die je tijdens het trainen gebruikte. Als dat niet zo is, gaat het bijna altijd in een van twee richtingen mis.
Die twee richtingen zijn overfitting en underfitting. Je moet weten met welke van de twee je te maken hebt voordat je het kunt oplossen.
In dit artikel laat ik je zien hoe je overfitting en underfitting herkent, waarom ze ontstaan en welke praktische stappen je helpen om de balans te vinden.
Underfitting ontstaat wanneer je model te simpel is om te representeren wat er daadwerkelijk in de data gebeurt.
Stel je voor dat je woningprijzen probeert te voorspellen met één regel: "elk huis kost $300.000". Die regel zal bijna overal fout zijn. Hij ziet geen wijken, woonoppervlak, aantal slaapkamers, garage of bouwjaar. Het model heeft bij lange na niet genoeg flexibiliteit om het patroon te volgen.
Je kunt underfitting telkens op dezelfde manier herkennen. De nauwkeurigheid op de training is laag, en de nauwkeurigheid op de test is ook laag. Beide cijfers zijn slecht, maar het belangrijkste is dat ze samen slecht zijn.
Een klassiek geval is een rechte lijn fitten op data die kromt. De lijn snijdt door het midden en mist de vorm. Geen hoeveelheid extra trainingsdata redt het, omdat het model de relatie simpelweg niet kan representeren.
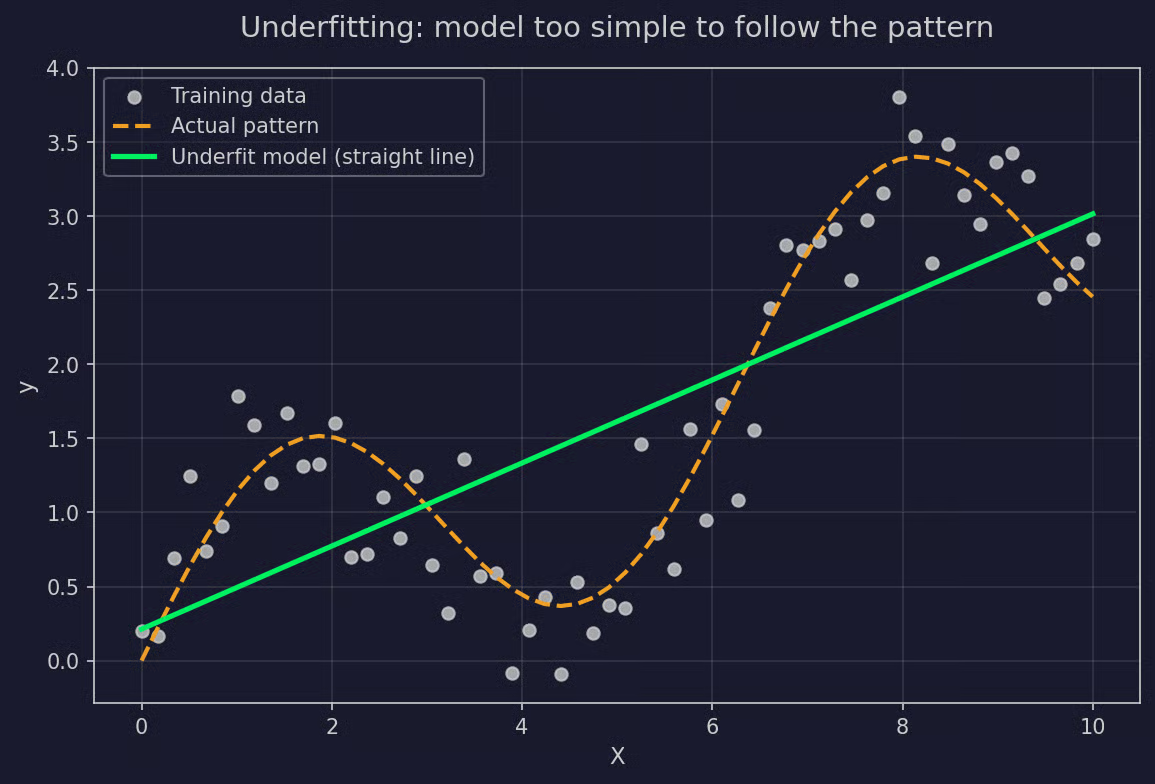
Voorbeeld van underfitting
Overfitting is het tegenovergestelde probleem. Het model is te complex.
In plaats van het algemene patroon te leren, onthoudt het de trainingsset. Elk ruispunt, elke vreemde uitschieter, elke piek en dal, elk toeval in de data krijgt aandacht alsof het een echt patroon is. Het model wordt bijna perfect voor de data waarop het is getraind.
Het voordeel van overfitting is dat je het makkelijk ziet. De nauwkeurigheid op de training ziet er geweldig uit, maar de nauwkeurigheid op de test is belabberd.
Denk aan een student die de examenantwoorden woordelijk uit het hoofd leert maar de onderliggende stof nooit begrijpt. Die scoort goed op het oefenexamen en zakt waarschijnlijk voor het echte.
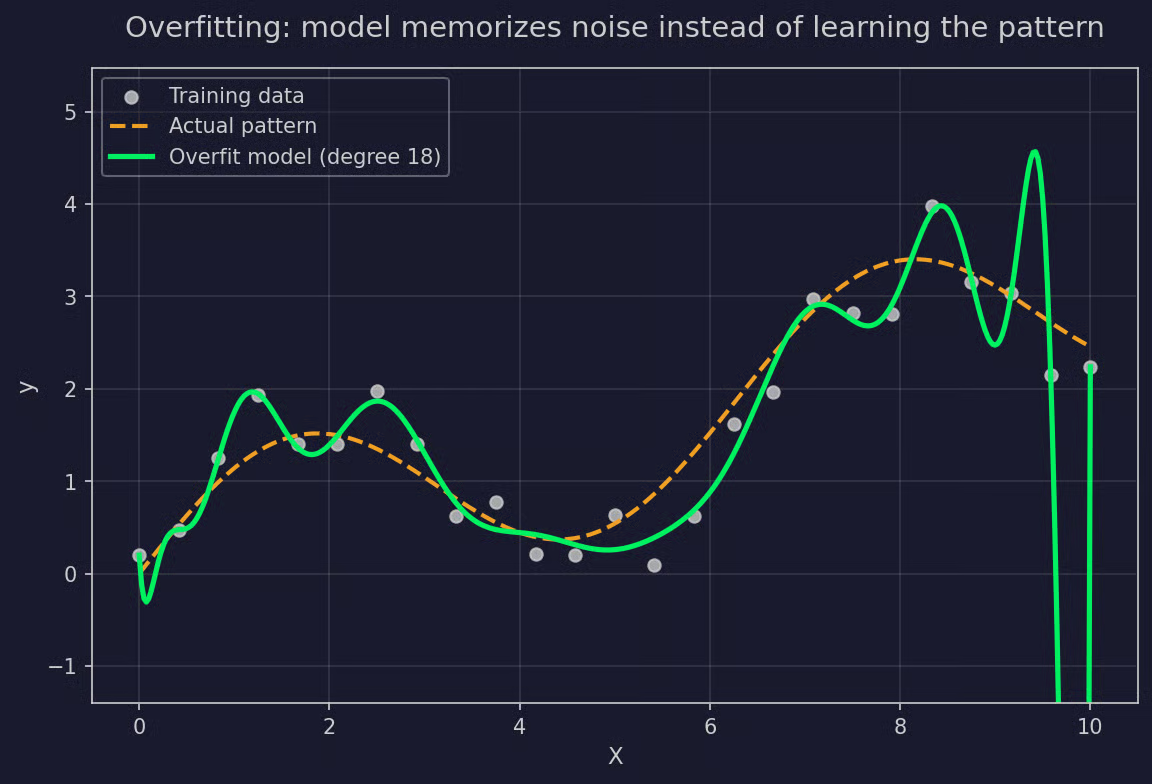
Voorbeeld van overfitting
Nu je ze allebei hebt gezien, is het verschil makkelijker te herkennen. Underfitting-modellen presteren niet op data die ze al gezien hebben. Overfitting-modellen presteren niet op data die ze nog niet hebben gezien.
Ze zien er tijdens het trainen anders uit:
De oorzaken spiegelen elkaar ook. Underfitting komt door te weinig doen: simpele modellen en ontbrekende features. Overfitting komt door te veel doen: complexe modellen en te veel features.
Hier is een samenvatting van de twee:
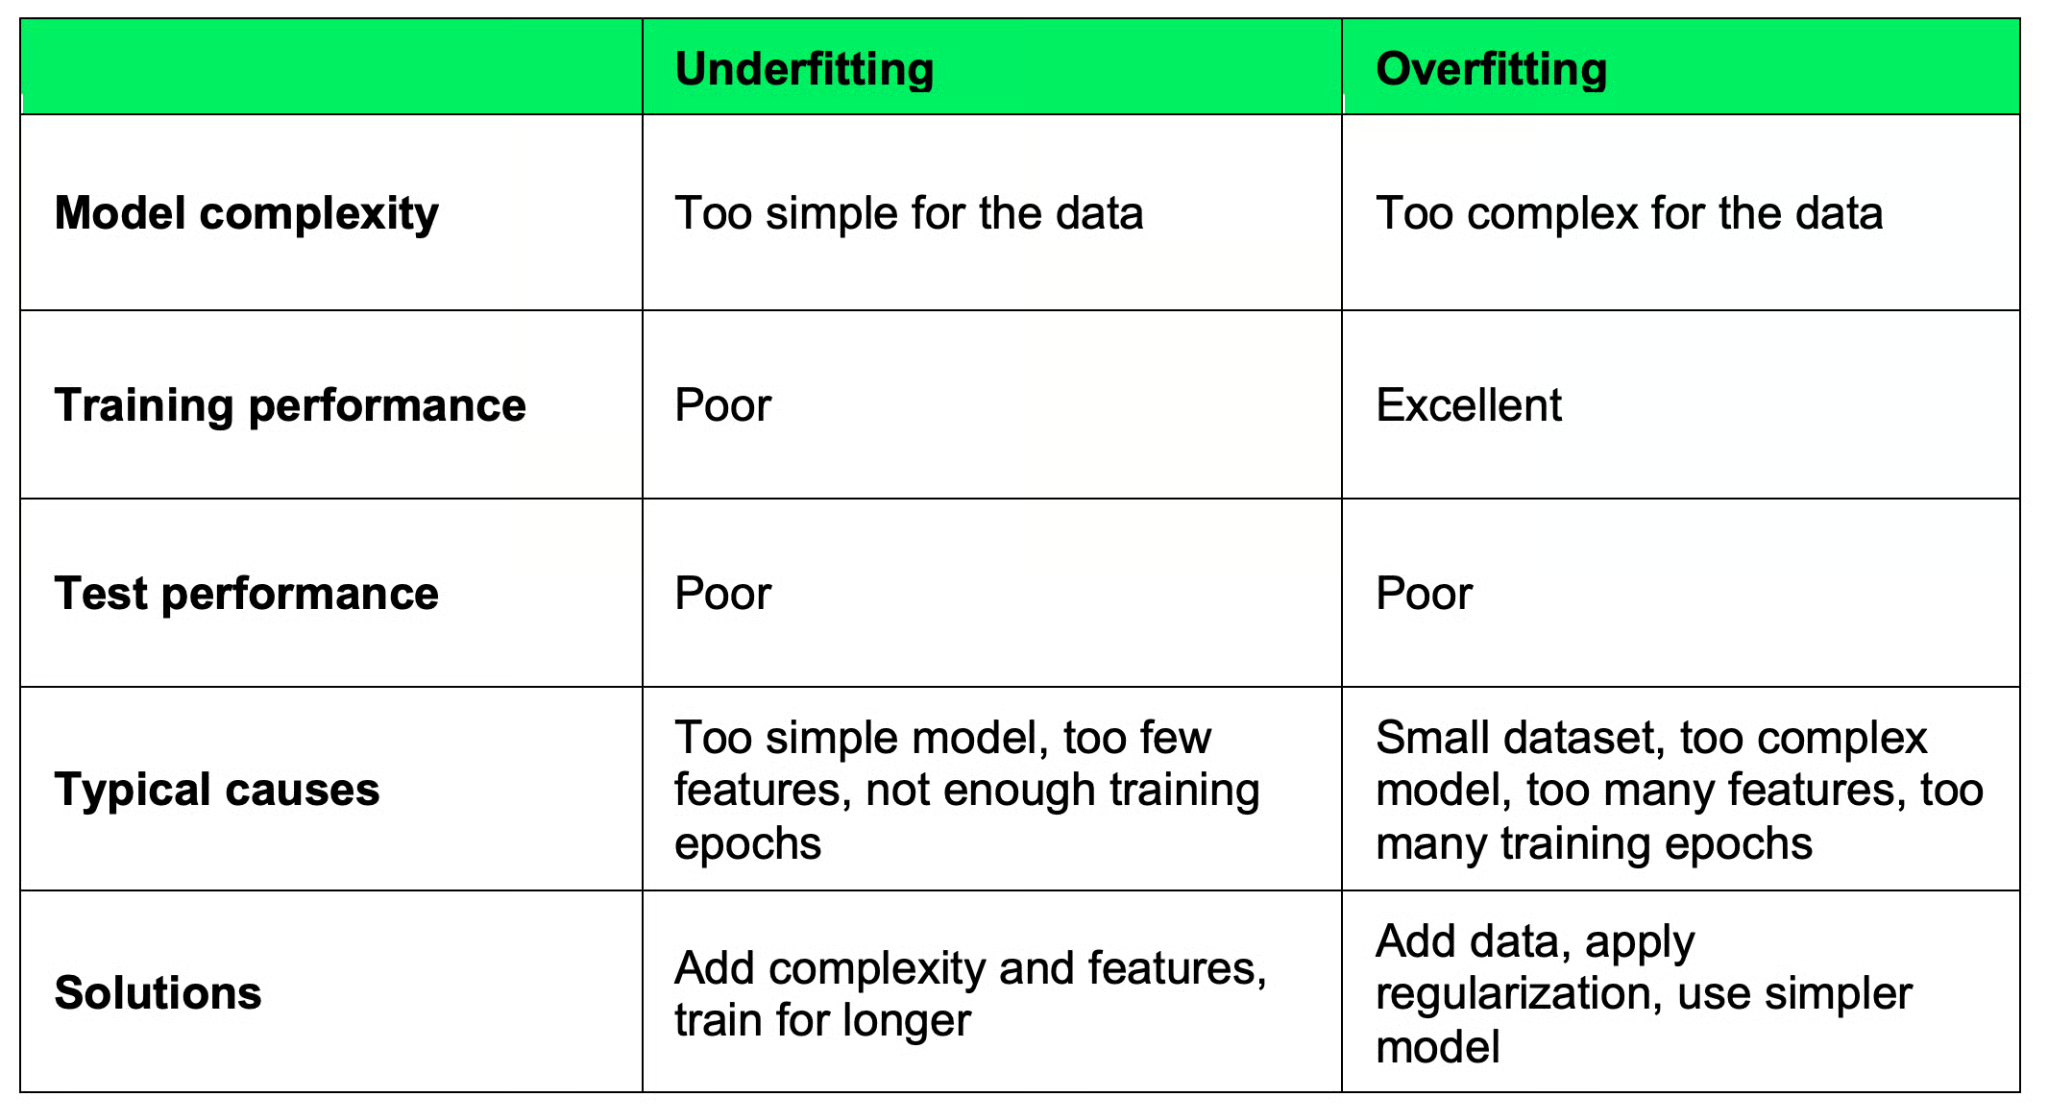
Underfitting vergeleken met overfitting
Weten hoe underfitting en overfitting er in theorie uitzien is één ding, ze in je eigen modellen vangen is iets anders.
Het makkelijkste is hier om trainingsfout te vergelijken met testfout, en naar leercurves te kijken.
De snelste check is om je data op te splitsen in een trainingsset en een testset, het model te trainen en de fout op beide te bekijken.
Bij underfitting zijn beide fouten hoog. Het model heeft de trainingsdata niet goed geleerd en zal het niet beter doen op data die het nooit heeft gezien. Je krijgt aan beide kanten hetzelfde slechte resultaat.
Bij overfitting is de trainingsfout heel laag terwijl de testfout hoog blijft. Het model heeft de trainingsdata uit het hoofd geleerd, maar die kennis draagt niet over.
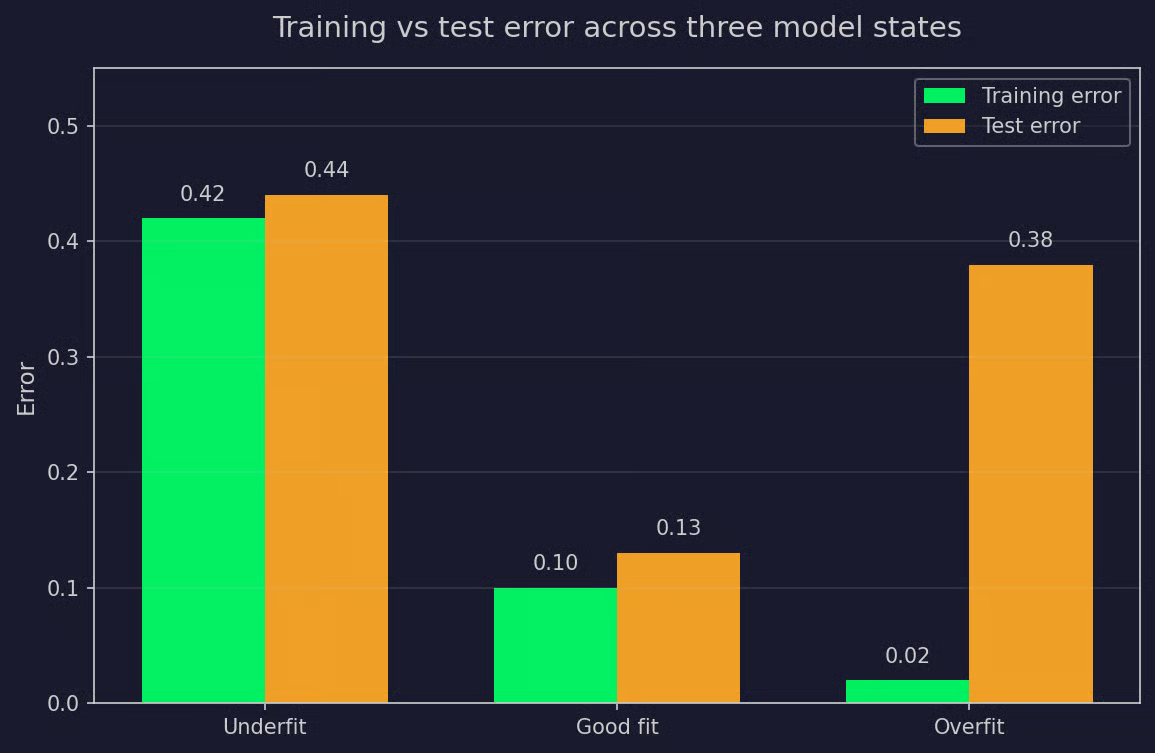
Visualisatie van training vs. testfout
Je wilt de kloof tussen deze twee cijfers analyseren. Een kleine kloof met hoge fouten wijst op underfitting. Een grote kloof met lage trainingsfout en hoge testfout wijst op overfitting. Een kleine kloof met lage fouten aan beide kanten is het doel, want dat betekent dat het model de werkelijke datavertegenwoordiging heeft geleerd.
Leercurves zetten training- en validatiefout uit tegen de grootte van de trainingsset of tegen het aantal trainingsiteraties. Ze laten zien wat er gebeurt terwijl het model leert.
In een underfit model vlakken beide curves snel af op een hoge fout. Meer data toevoegen helpt niet, omdat het model het patroon in de eerste plaats niet kan representeren. Beide curves blijven hoog.
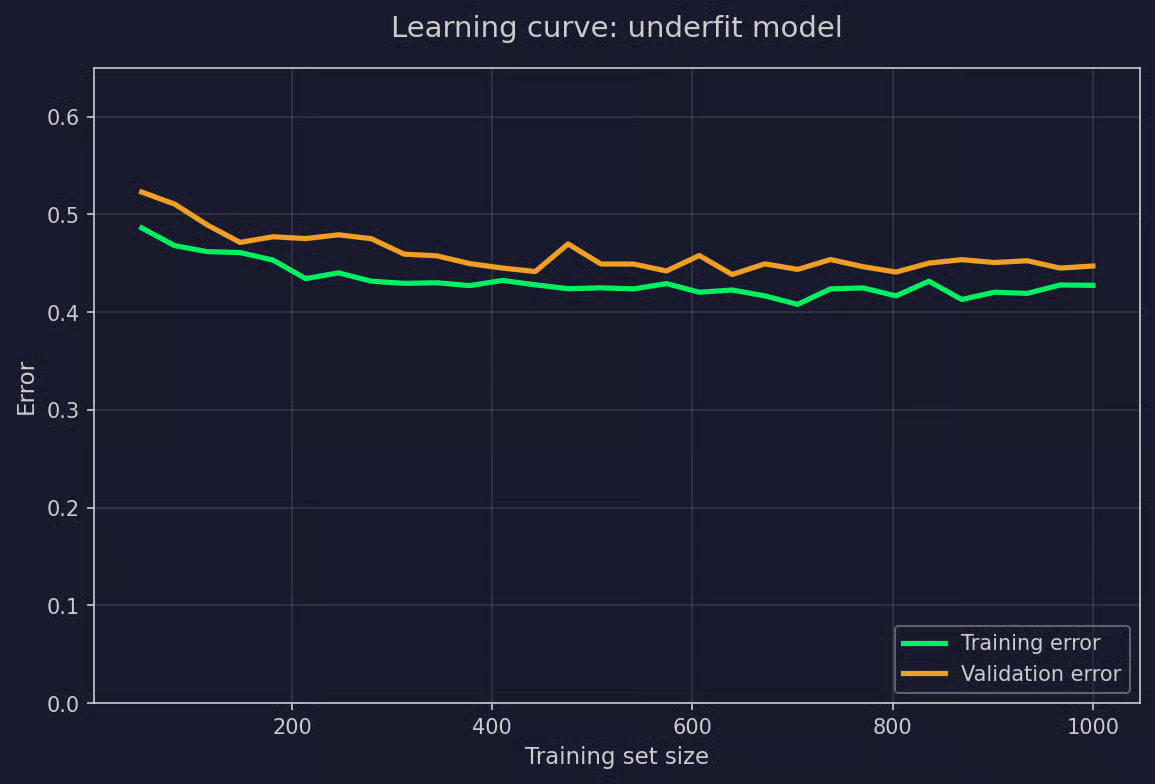
Curves van een underfit model
In een overfit model daalt de trainingscurve naar bijna nul terwijl de validatiecurve hoog blijft. De kloof ertussen wordt groter naarmate het trainen doorgaat. Die groeiende kloof is hoe overfitting eruitziet in een grafiek.
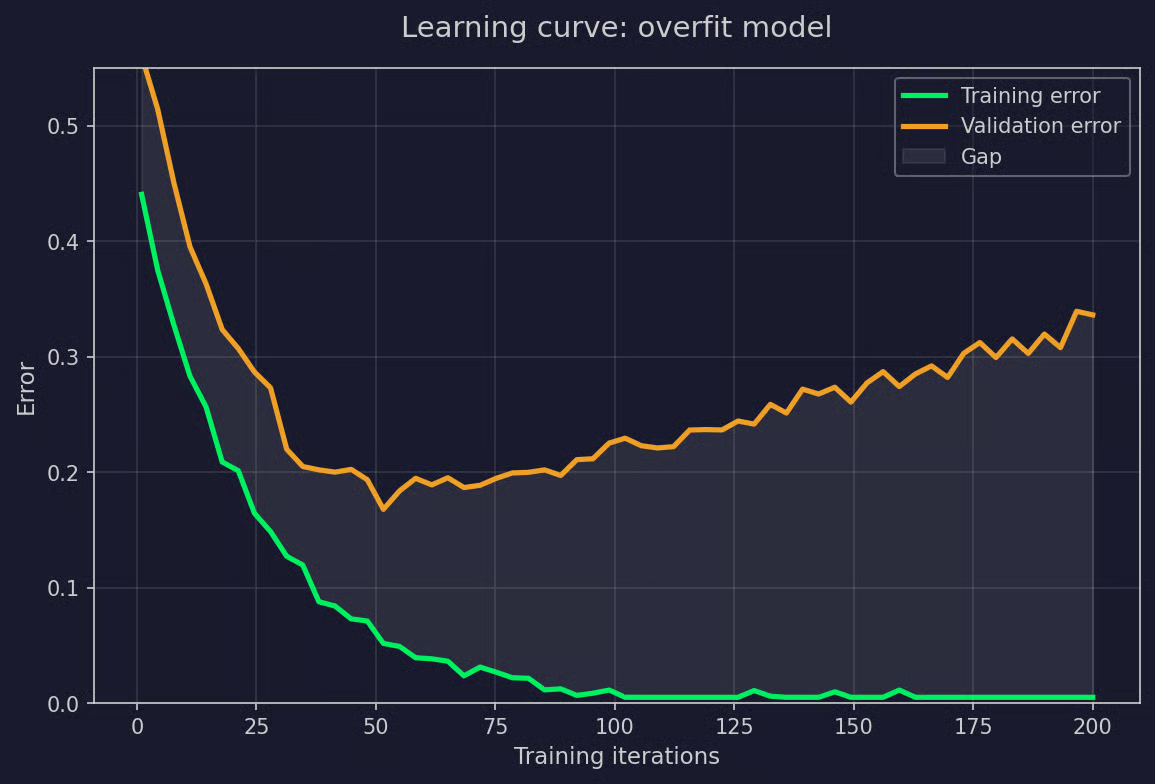
Curves van een overfit model
Een gezond model laat beide curves dalen en bij elkaar komen op een lage fout, met een kleine kloof ertussen.
Als je weet hoe je ze herkent, is de volgende vraag waarom ze opduiken. Beide komen voort uit een mismatch tussen het model en het probleem, maar dan in tegenovergestelde richtingen.
Underfitting is bijna altijd terug te voeren op een van drie dingen.
Overfitting ontstaat doordat je het model meer vrijheid geeft dan de data nodig heeft.
De bias-variantieafweging verklaart waarom modelprestaties draaien om het vinden van de sweet spot waar je model goed generaliseert naar onzichtbare data zonder het probleem te simplificeren of te overfitten op je trainingsset.
Bias is de fout die ontstaat door de aannames die een model over de data maakt. Een model met hoge bias heeft sterke, simplistische aannames. Het kan de werkelijke complexiteit van wat er in de data gebeurt niet representeren.
Dit is precies wat underfitting is. Het model is te star om de patronen te passen, dus het produceert voorspellingen die ernaast zitten, hoeveel data je het ook geeft.
Als je een model met hoge bias 100 keer traint op verschillende samples, maken alle 100 versies vergelijkbare fouten. Hun voorspellingen clusteren rond het verkeerde antwoord.
Variantie is de fout die ontstaat doordat een model te gevoelig is voor de specifieke data waarop het is getraind. Een model met hoge variantie pikt elk klein patroontje op, meestal ruis.
Dit is wat overfitting is. Het model past de trainingsset heel nauwkeurig, maar kleine veranderingen in de trainingsdata leiden tot heel andere voorspellingen.
Als je een model met hoge variantie 100 keer traint op verschillende samples, krijg je 100 heel verschillende modellen. Hun voorspellingen liggen alle kanten op, zelfs voor dezelfde input.
Je kunt noch bias noch variantie volledig elimineren, je kunt alleen tussen beide verschuiven.
Verklein je de bias door het model complexer te maken, dan gaat de variantie omhoog. Verklein je de variantie door het model te vereenvoudigen, dan gaat de bias omhoog. Het doel is het midden te vinden, waar de totale fout het laagst is.
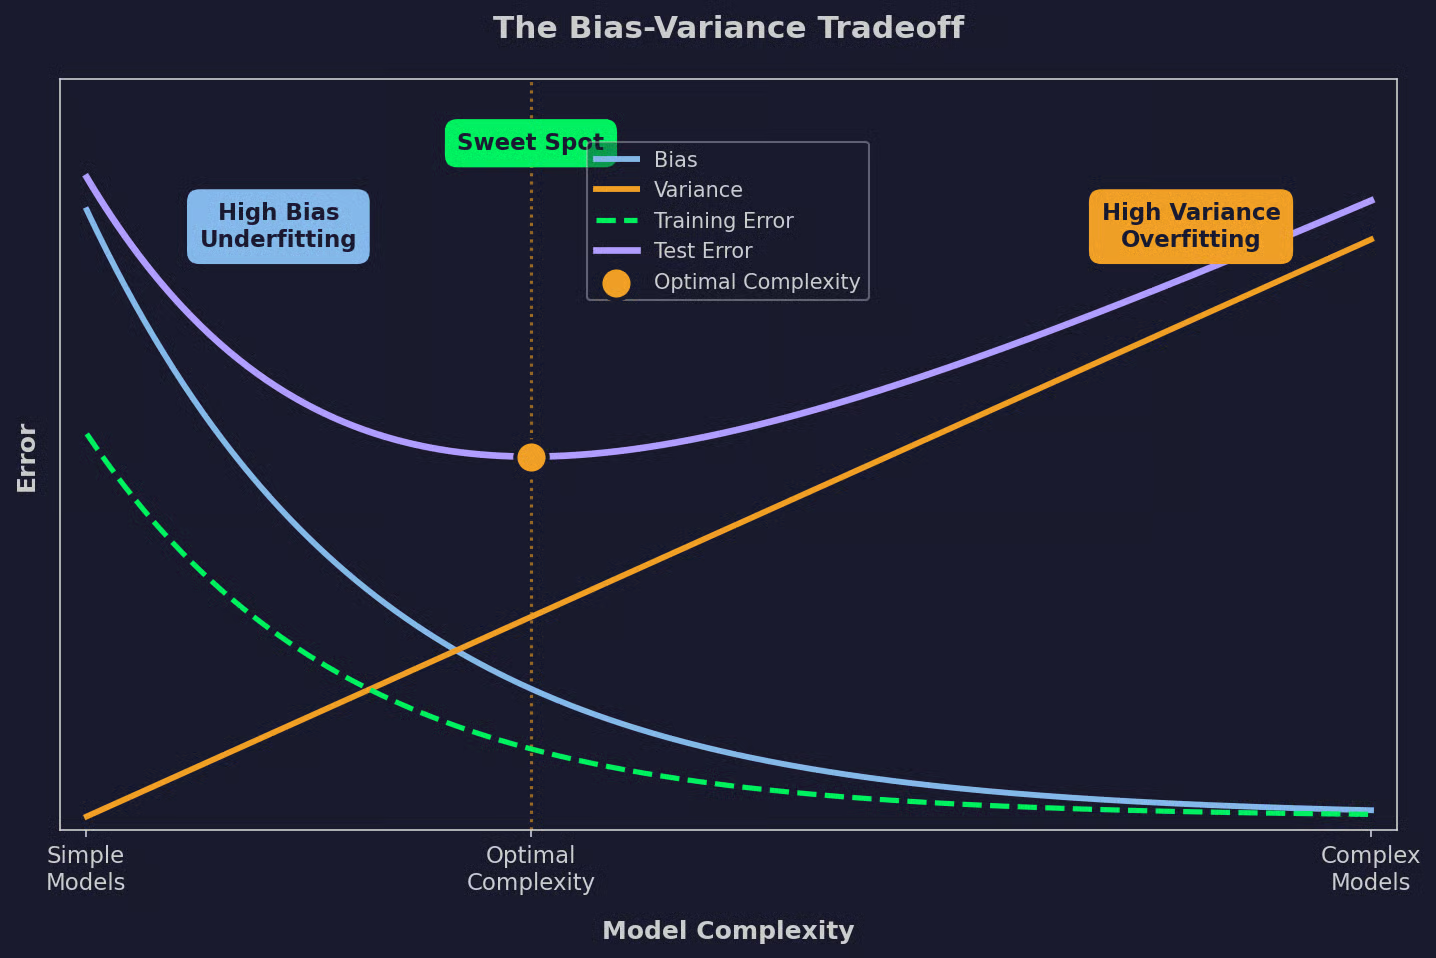
Voorbeeld van bias-variantieafweging
Zodra je underfitting hebt vastgesteld, heb je een paar manieren om het op te lossen. Ze geven het model allemaal meer capaciteit om de patronen in je data te representeren.
Een paar goede features hebben vaak meer impact dan van architectuur wisselen. Begin daarmee voordat je het model zelf verandert.
Overfitting oplossen vraagt om de omgekeerde aanpak. Je wilt het model begrenzen zodat het stopt met de trainingsdata uit het hoofd leren.
Regularisatie en early stopping zijn meestal de eerste dingen om te proberen. Ze kosten niets en helpen bijna altijd.
Verschillende modelfamilies laten underfitting en overfitting op hun eigen manieren zien. Zo kunnen drie veelvoorkomende modellen in beide richtingen misgaan.
max_depth, min_samples_split en pruning.Ik laat je nu twee klassieke voorbeelden met code zien die deze patronen duidelijk maken.
Een rumoerige sinusgolf is een goede testcase. Als je polynomen van verschillende graden fit, zie je het gedrag van het model veranderen.
import numpy as np

# Data
np.random.seed(7)
X = np.linspace(0, 1, 30)
y_true = np.sin(2 * np.pi * X)
y = y_true + np.random.normal(0, 0.2, X.shape)

# Fit polynomials of three degrees
X_smooth = np.linspace(0, 1, 300)
degrees = [1, 3, 15]

for degree in degrees:
    coefs = np.polyfit(X, y, deg=degree)
    y_pred = np.polyval(coefs, X_smooth)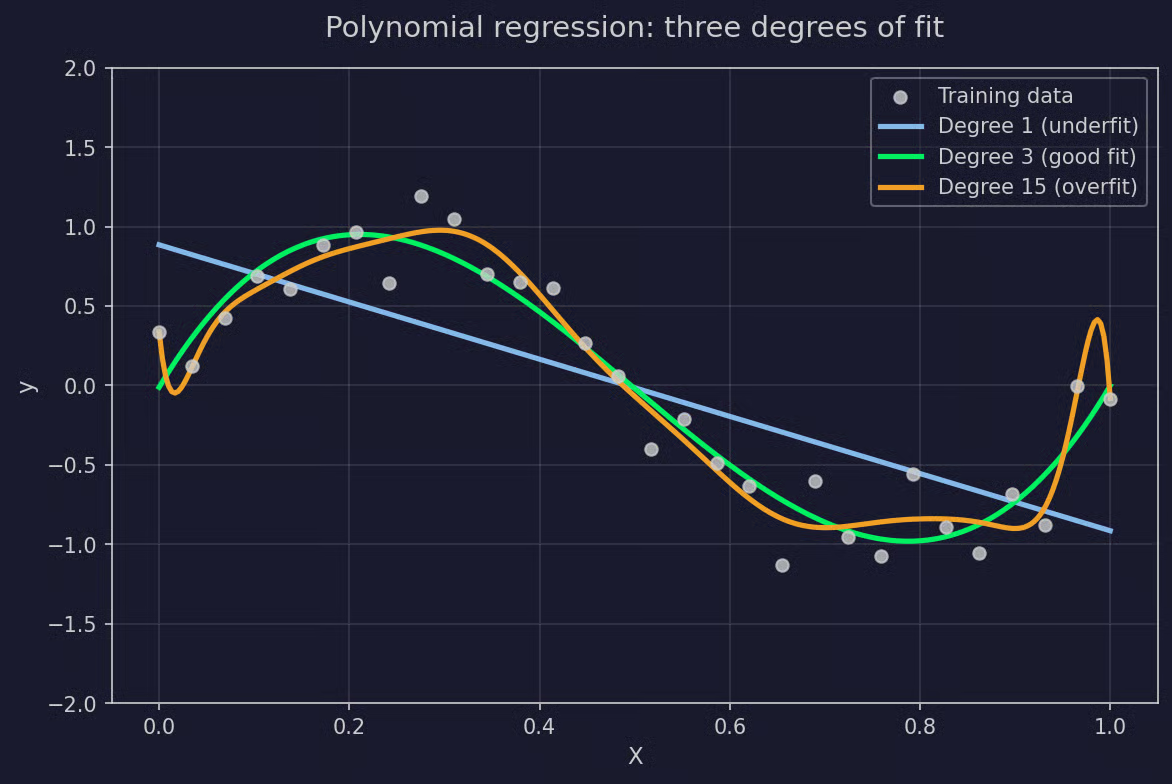
Voorbeeld van polynomiale regressie
Graad 1 is een rechte lijn die underfit. Die kan de kromme helemaal niet volgen. Graad 3 representeert de werkelijke vorm. Hij vangt wat ruis op maar blijft dicht bij de waarheid. Graad 15 overfit doordat hij door elk trainingspunt slingert en enorme oscillaties ertussen veroorzaakt.
Hetzelfde verhaal zie je bij beslisbomen. Je kunt bomen met toenemende diepte op dezelfde data trainen en de fout op zowel training- als testsets meten.
import numpy as np
from sklearn.tree import DecisionTreeRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Data
np.random.seed(11)
X = np.linspace(0, 10, 250).reshape(-1, 1)
y = np.sin(X).ravel() + np.random.normal(0, 0.3, 250)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0
)

depths = range(1, 21)
train_errors = []
test_errors = []

for depth in depths:
    tree = DecisionTreeRegressor(max_depth=depth, random_state=0)
    tree.fit(X_train, y_train)
    train_errors.append(mean_squared_error(y_train, tree.predict(X_train)))
    test_errors.append(mean_squared_error(y_test, tree.predict(X_test)))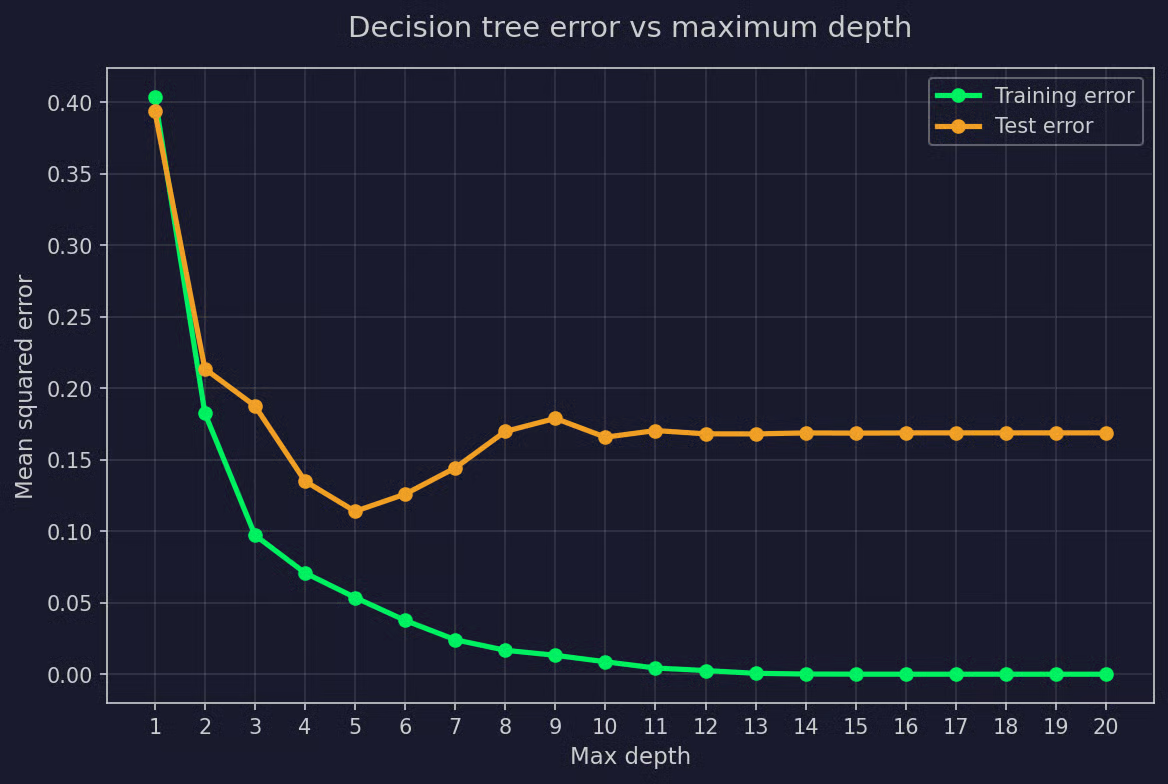
Voorbeeld van een beslisboom
De trainingsfout neemt af naarmate de boom dieper wordt en nadert uiteindelijk nul wanneer elk blad slechts één trainingspunt bevat. De testfout daalt aanvankelijk terwijl de boom de werkelijke relaties in de data vastlegt, en stijgt daarna weer wanneer diepere splits ruis beginnen te fitten. Het minimum ligt bij de diepte die beide in balans brengt.
Zelfs als je de juiste metriek kiest, trek je makkelijk de verkeerde conclusies. Dit moet je níet doen bij het evalueren van modelprestaties:
Je zou altijd op alle vier moeten controleren voordat je een model accepteert. De meeste productieproblemen zijn aan een (of meer) hiervan gerelateerd.
Underfitting en overfitting zijn de twee manieren waarop een model niet kan generaliseren. De een blijft te simpel om het patroon te leren. De ander probeert elk punt in je dataset te leren.
Het echte doel van trainen is ergens daartussenin uitkomen, waar bias en variantie in balans zijn en de totale fout het laagst is.
Validatieprestaties zijn de metriek die je vertelt waar je staat. Houd ze bij tijdens het trainen en laat het verschil tussen training- en validatiefout je beslissingen sturen. Als de validatiefout stopt met verbeteren terwijl de trainingsfout blijft dalen, ben je voorbij de sweet spot. Als beide hoog blijven, heb je die nog niet bereikt.
Wil je meer geavanceerde data science-concepten leren en in 2026 job-ready zijn? Schrijf je in voor onze Machine Learning Engineer track om van de basis naar MLOps te gaan.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


