
Last chance! 50% off DataCamp Premium
Sale ends in
Sai perché il tuo modello ha il 99% di accuratezza sui dati di training ma in produzione non azzecca nemmeno una previsione?
C’è differenza tra un modello che ha memorizzato e uno che ha imparato. La generalizzazione è l’obiettivo del machine learning: vuoi previsioni valide su dati che il modello non ha mai visto, non solo su quelli usati durante l’addestramento. Quando non succede, di solito ci si trova in uno di due casi.
Questi due casi sono overfitting e underfitting. Devi sapere quale dei due stai affrontando prima di poterlo risolvere.
In questo articolo ti mostrerò come riconoscere overfitting e underfitting, perché si verificano e i passi pratici per trovare l’equilibrio.
L'underfitting si verifica quando il tuo modello è troppo semplice per rappresentare ciò che accade davvero nei dati.
Immagina di prevedere i prezzi delle case con una singola regola: "ogni casa costa $300.000". Quella regola sarà sbagliata quasi ovunque. Non vede i quartieri, i metri quadri, il numero di camere da letto, il box auto o l’anno di costruzione. Il modello non ha la flessibilità necessaria per seguire il pattern.
Puoi individuare l'underfitting sempre allo stesso modo. L'accuratezza sul training è bassa, e anche quella sul test è bassa. Entrambi i numeri sono scarsi, ma la cosa chiave è che lo sono insieme.
Un caso classico è adattare una linea retta a dati curvilinei. La linea taglia a metà e perde la forma. Nessuna quantità extra di dati di training potrà salvarla, perché il modello in sé non può rappresentare la relazione.
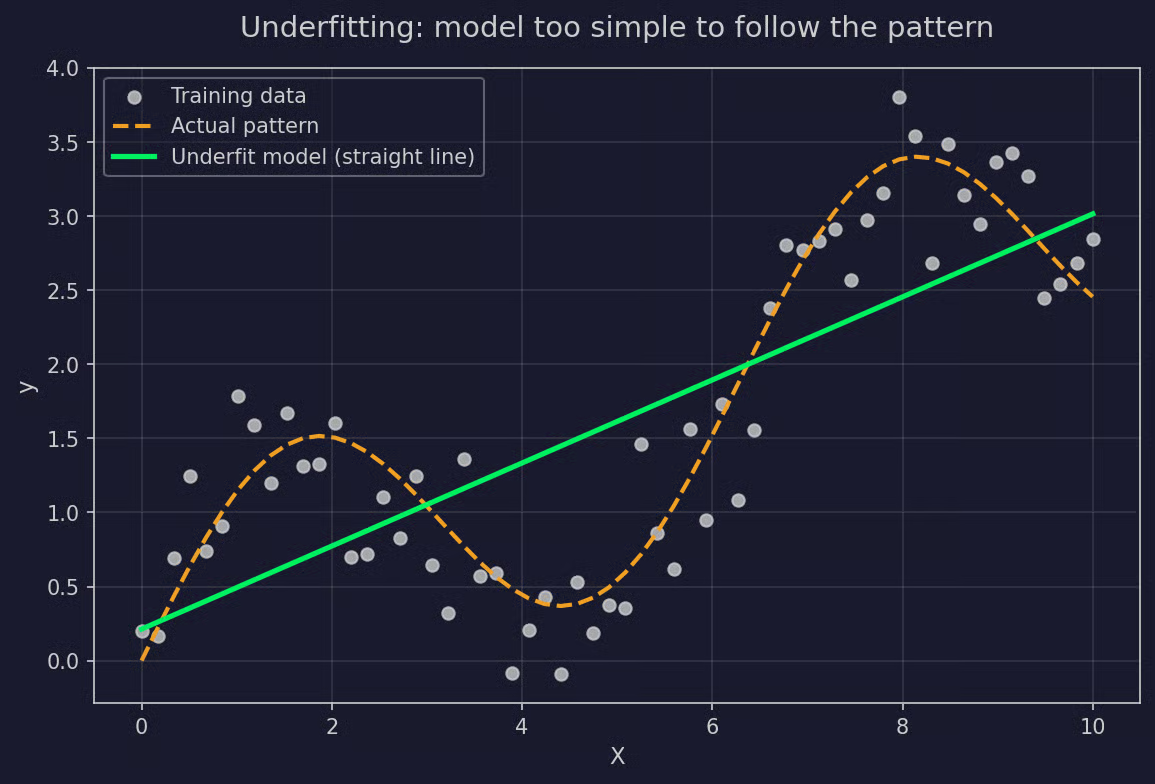
Esempio di underfitting
L'overfitting è il problema opposto. Il modello è troppo complesso.
Invece di apprendere il pattern generale, memorizza il set di training. Ogni punto di rumore, ogni outlier strano, ogni picco e valle, ogni coincidenza nei dati riceve attenzione come se fosse un pattern reale. Il modello diventa quasi perfetto sui dati su cui è stato addestrato.
La cosa positiva dell'overfitting è che lo riconosci facilmente. L'accuratezza sul training sembra ottima, ma quella sul test è pessima.
Pensa a uno studente che memorizza le risposte dell'esame parola per parola senza imparare davvero la materia. Fa un ottimo punteggio sulle prove pratiche e probabilmente fallisce su quella reale.
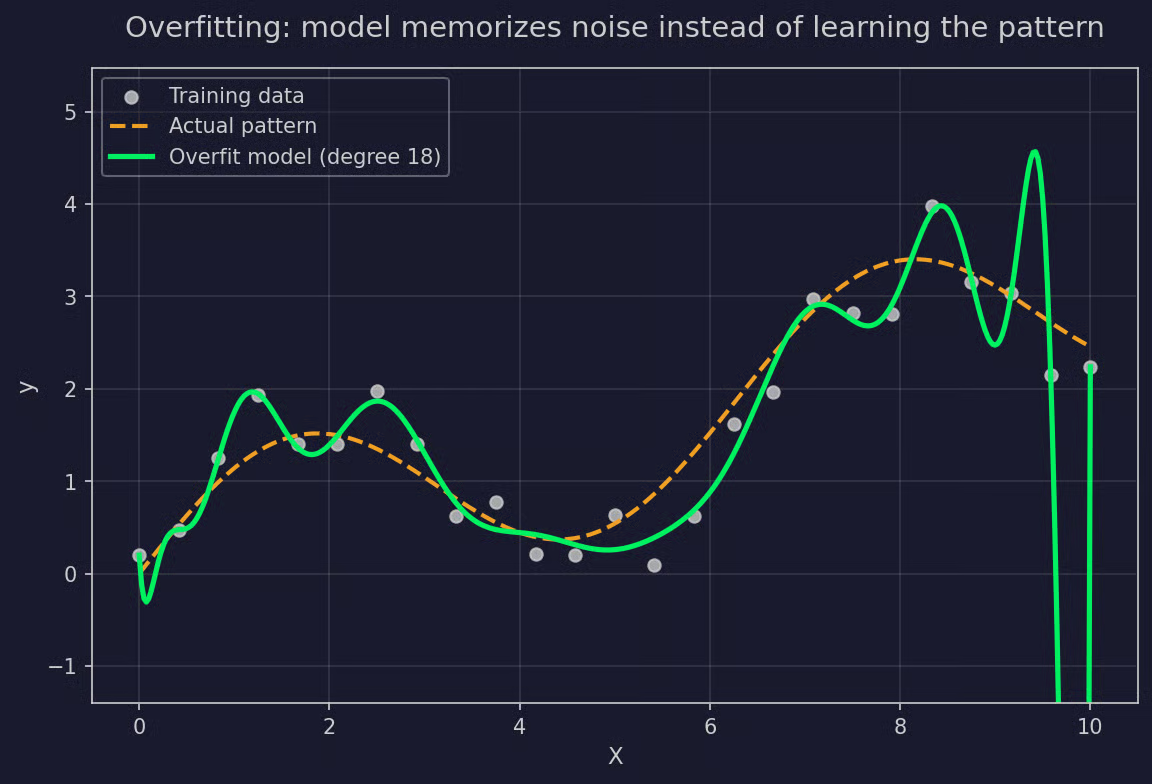
Esempio di overfitting
Ora che li hai visti entrambi, la differenza è più facile da cogliere. I modelli in underfitting non sanno performare sui dati che hanno visto. I modelli in overfitting non sanno performare sui dati che non hanno visto.
I due si presentano in modo diverso durante l'addestramento:
Anche le cause si rispecchiano. L'underfitting deriva dal fare troppo poco: modelli semplici e feature mancanti. L'overfitting deriva dal fare troppo: modelli complessi e troppe feature.
Ecco un riepilogo dei due:
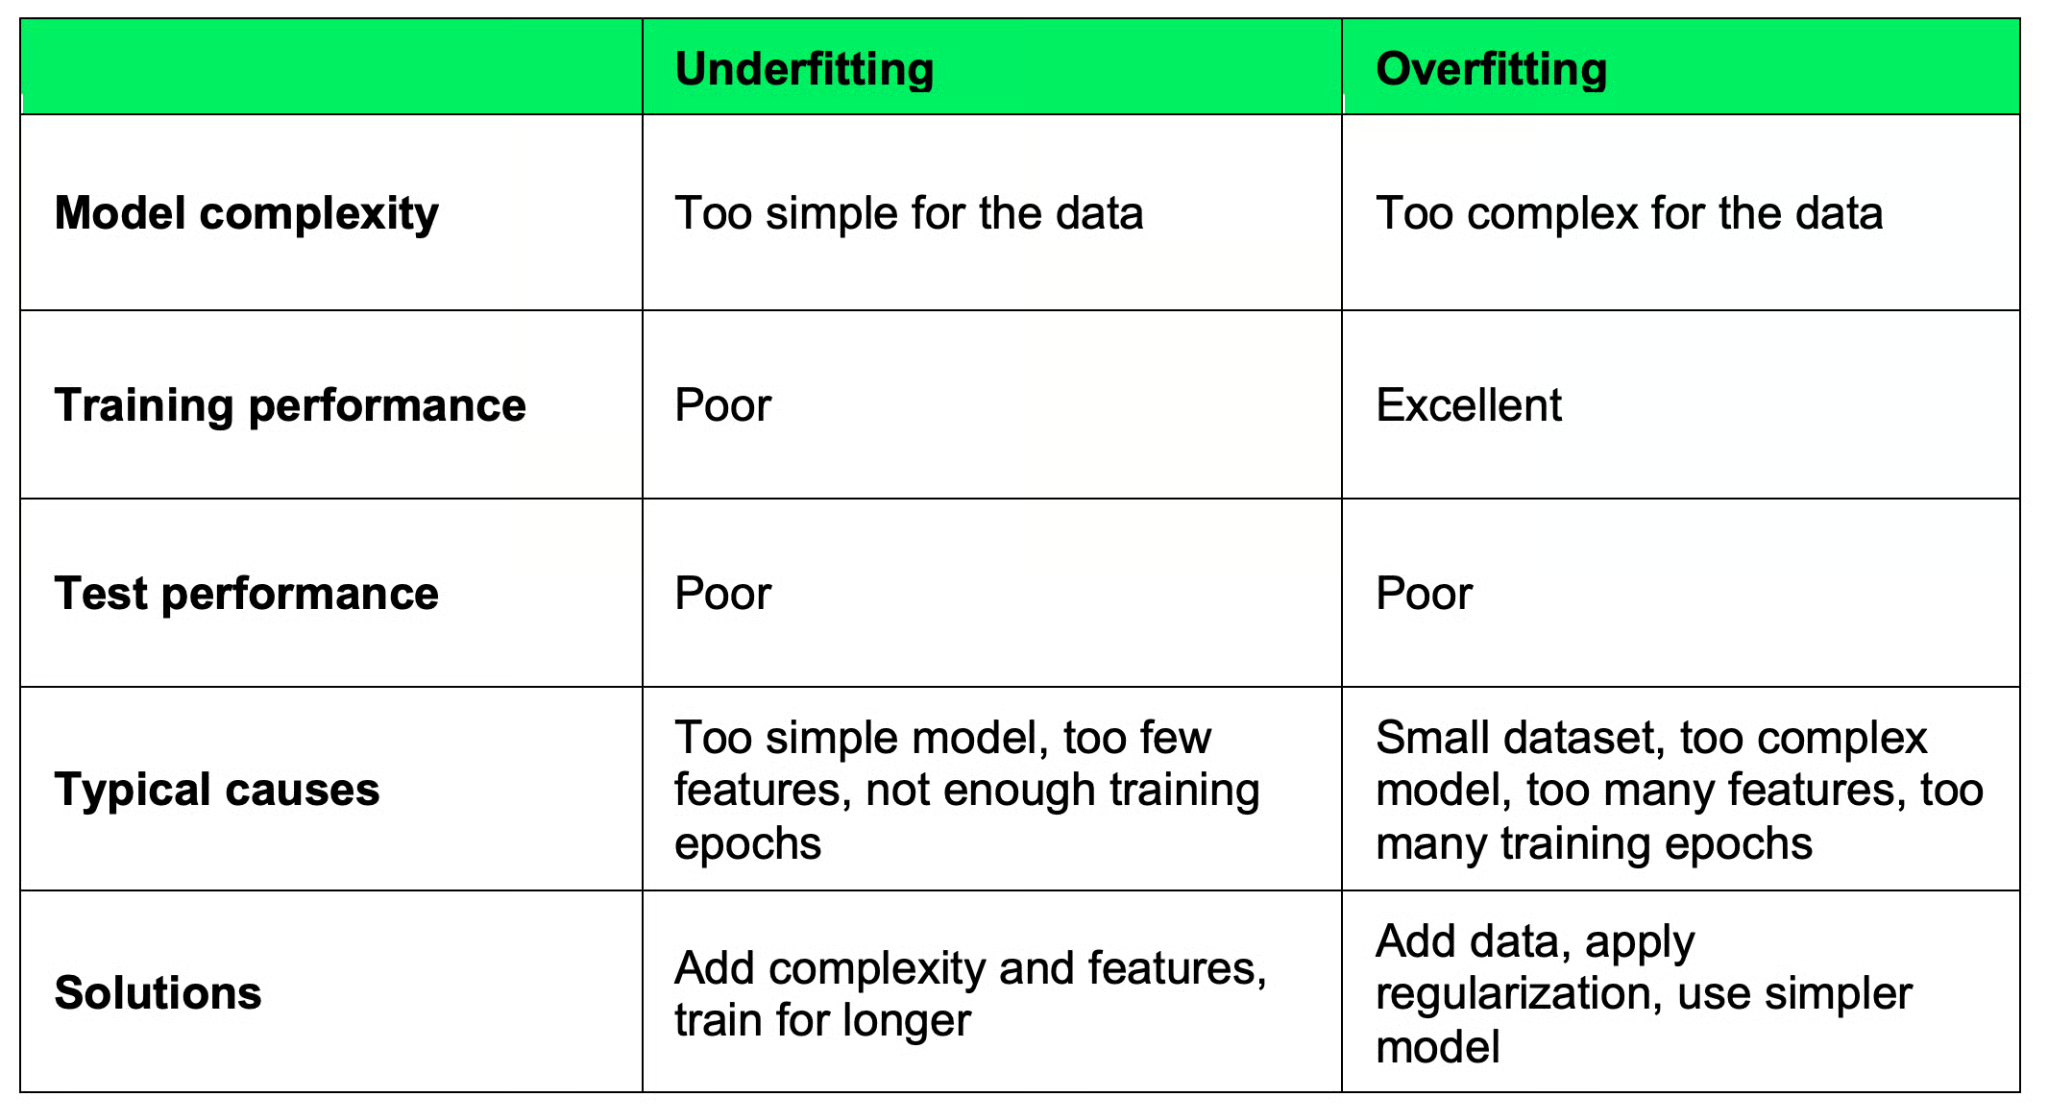
Underfitting rispetto a overfitting
Sapere come appaiono in teoria è una cosa, intercettarli nei tuoi modelli è un’altra.
La cosa più semplice è confrontare l'errore di training con quello di test e guardare le learning curve.
Il controllo più rapido è dividere i dati in un training set e un test set, addestrare il modello e osservare l'errore su ciascuno.
Con l'underfitting, entrambi gli errori saranno alti. Il modello non ha imparato bene i dati di training e non andrà meglio su dati mai visti. Hai lo stesso risultato scarso su entrambi i fronti.
Con l'overfitting, l'errore di training sarà molto basso mentre quello di test resta alto. Il modello ha memorizzato i dati di training, ma questa conoscenza non si trasferisce.
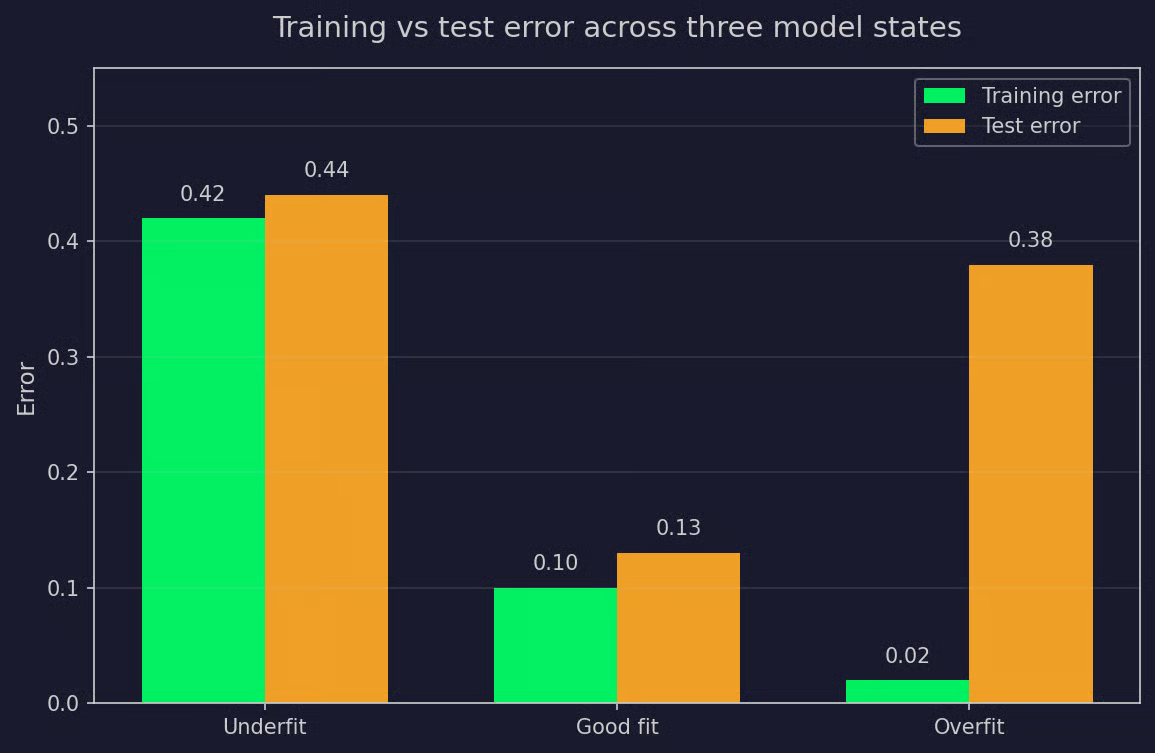
Visualizzazione errore training vs test
Vuoi analizzare il divario tra questi due numeri. Un divario piccolo con errori alti indica underfitting. Un grande divario con errore di training basso ed errore di test alto indica overfitting. Un divario piccolo con errori bassi su entrambi è l'obiettivo, perché significa che il modello ha appreso la rappresentazione reale dei dati.
Le learning curve tracciano l'errore di training e di validazione rispetto alla dimensione del training set, o rispetto alle iterazioni di training. Mostrano cosa succede durante l'apprendimento del modello.
In un modello underfit, entrambe le curve si appiattiscono rapidamente su un errore alto. Aggiungere più dati non aiuta, perché il modello non può rappresentare il pattern alla base. Entrambe le curve restano alte.
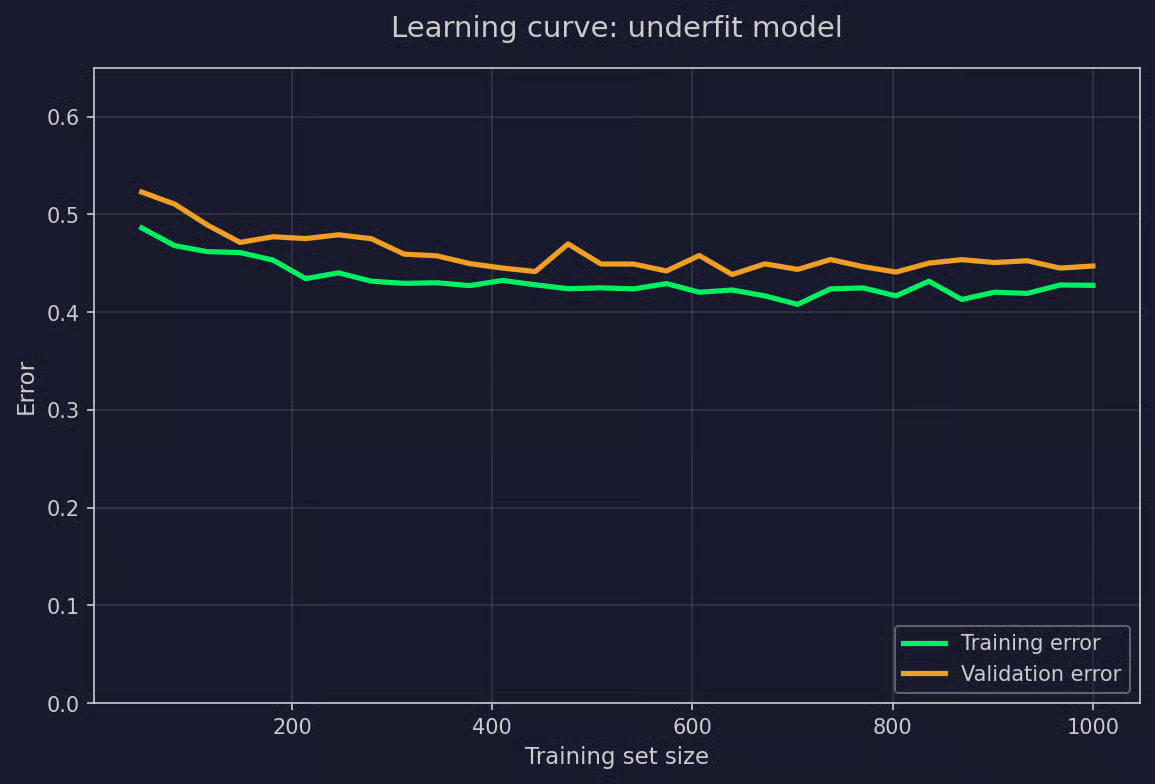
Curve di un modello underfit
In un modello overfit, la curva di training scende quasi a zero mentre quella di validazione resta alta. Il divario tra le due si allarga man mano che l'addestramento continua. Quel divario crescente è l'overfitting in un grafico.
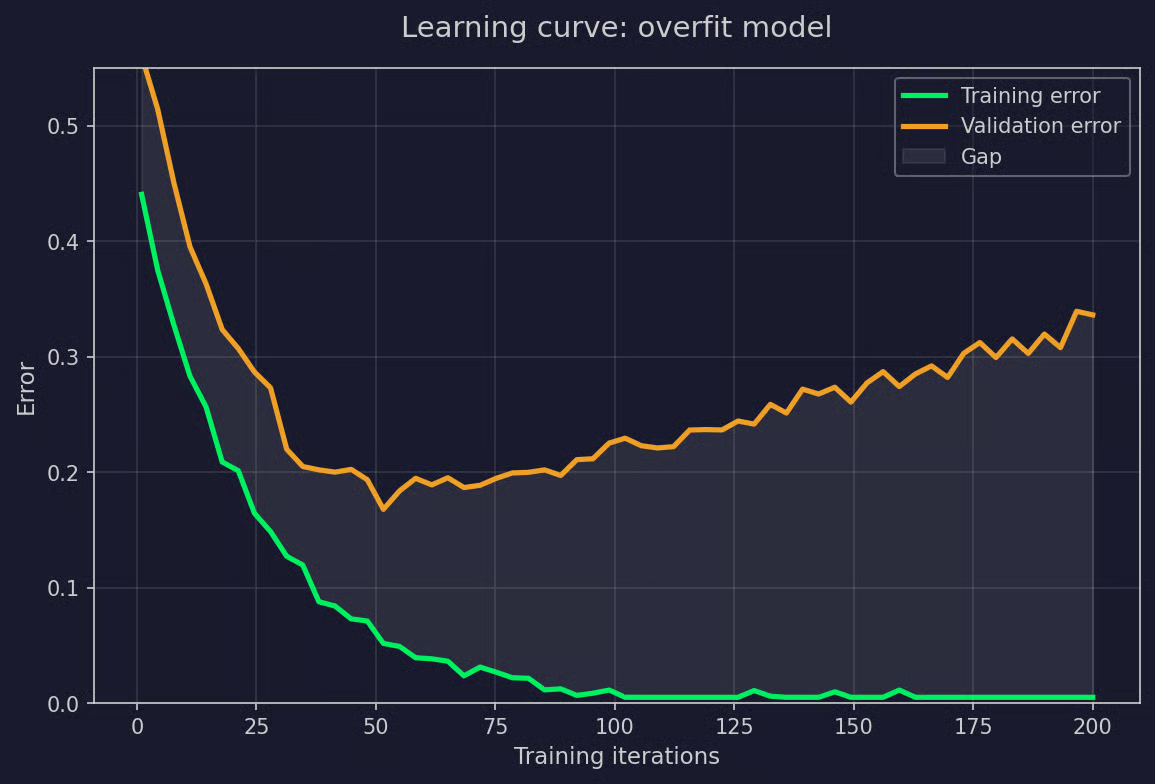
Curve di un modello overfit
Un modello sano mostra entrambe le curve che scendono e si incontrano su un errore basso, con un piccolo divario tra loro.
Una volta che sai riconoscerli, la domanda successiva è perché compaiono. Entrambi derivano da una mancata corrispondenza tra modello e problema, ma in direzioni opposte.
L'underfitting quasi sempre si riconduce a una di tre cose.
L'overfitting nasce dal dare al modello più libertà di quanta i dati richiedano.
Il trade-off bias-varianza spiega perché le prestazioni del modello dipendono dal trovare il punto giusto in cui il modello generalizza bene su dati non visti senza semplificare troppo il problema o andare in overfitting sul training set.
Il bias è l'errore che deriva dalle assunzioni del modello sui dati. Un modello con bias alto ha assunzioni forti e semplicistiche. Non riesce a rappresentare la reale complessità di ciò che accade nei dati.
Questo è esattamente l'underfitting. Il modello è troppo rigido per adattarsi ai pattern, quindi produce previsioni sballate, indipendentemente da quanti dati gli dai.
Se addestri 100 volte un modello con bias alto su campioni diversi, tutte e 100 le versioni faranno errori simili. Le loro previsioni si raggruppano attorno alla risposta sbagliata.
La varianza è l'errore che deriva da un modello troppo sensibile ai dati specifici su cui è stato addestrato. Un modello con varianza alta coglie ogni piccolo pattern, di solito il rumore.
Questo è l'overfitting. Il modello si adatta molto da vicino al training set, ma piccoli cambiamenti nei dati di training portano a previsioni molto diverse.
Se addestri 100 volte un modello con varianza alta su campioni diversi, otterrai 100 modelli molto diversi. Le loro previsioni sono ovunque, anche sullo stesso input.
Non puoi eliminare del tutto né bias né varianza, puoi solo spostarti tra i due.
Riduci il bias rendendo il modello più complesso, e la varianza sale. Riduci la varianza semplificando il modello, e il bias sale. L'obiettivo è trovare la via di mezzo, dove l'errore totale è al minimo.
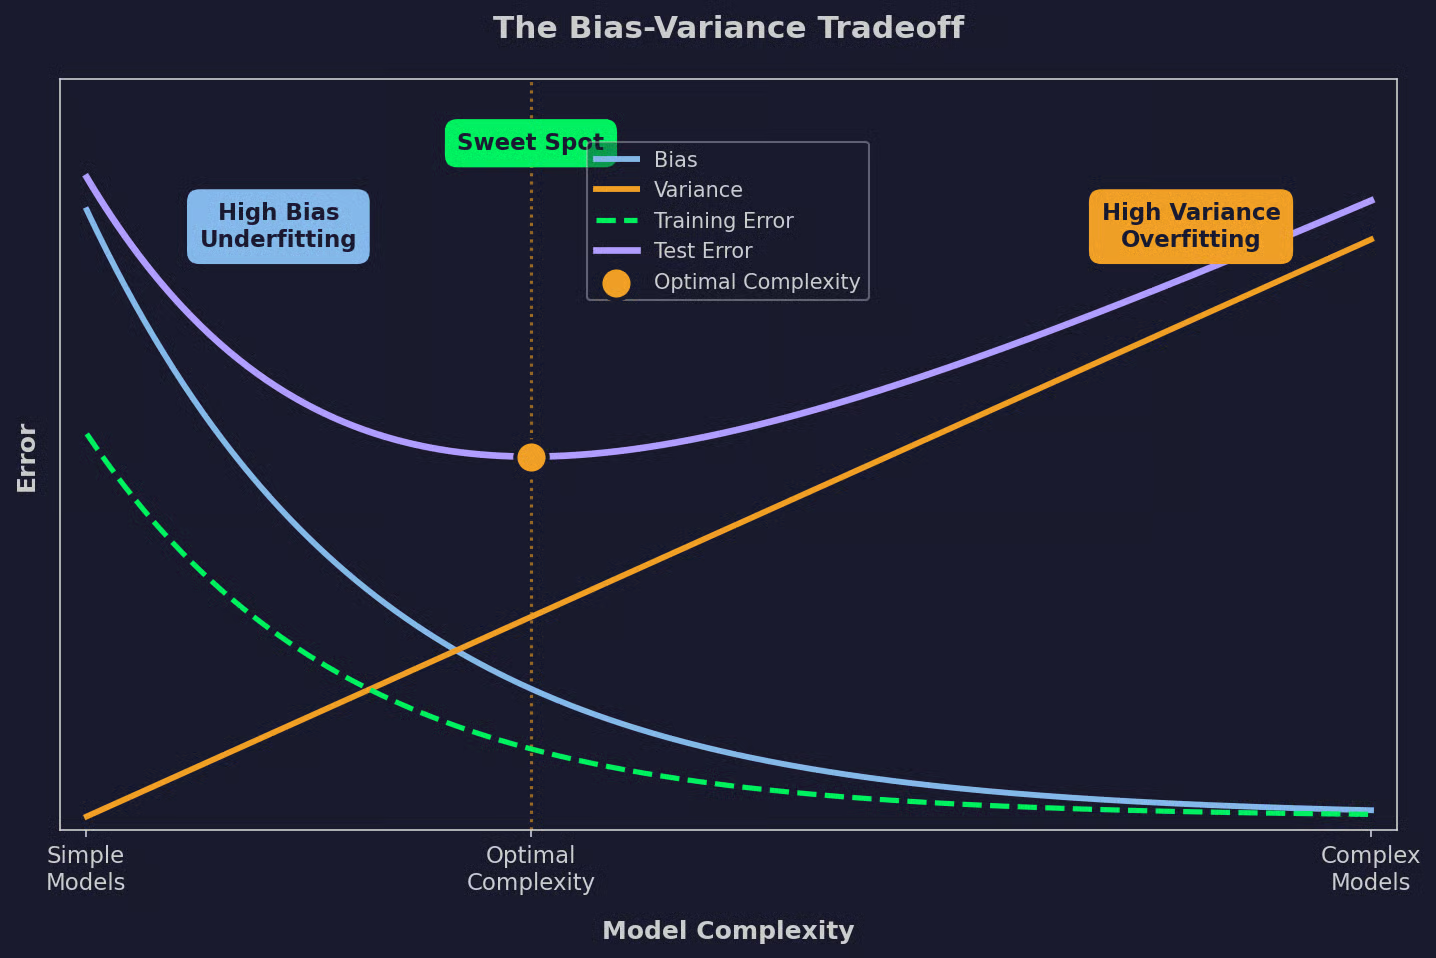
Esempio di trade-off bias-varianza
Una volta diagnosticato l'underfitting, hai varie strade per risolverlo. Tutte danno al modello più capacità di rappresentare i pattern nei tuoi dati.
Alcune buone feature spesso incidono più di un cambio di architettura. Parti da lì prima di modificare il modello stesso.
Per correggere l'overfitting devi fare l'opposto. Vuoi vincolare il modello in modo che smetta di memorizzare i dati di training.
Regolarizzazione ed early stopping sono di solito le prime cose da provare. Non costano nulla e quasi sempre aiutano.
Famiglie di modelli diverse mostrano underfitting e overfitting a modo loro. Ecco come tre casi comuni possono fallire in entrambe le direzioni.
max_depth, min_samples_split e il pruning.Ora ti guiderò attraverso due esempi classici con codice che renderanno questi pattern facili da vedere.
Una sinusoide rumorosa è un buon caso di test. Quando adatti polinomi di gradi diversi, puoi vedere cambiare il comportamento del modello.
import numpy as np

# Data
np.random.seed(7)
X = np.linspace(0, 1, 30)
y_true = np.sin(2 * np.pi * X)
y = y_true + np.random.normal(0, 0.2, X.shape)

# Fit polynomials of three degrees
X_smooth = np.linspace(0, 1, 300)
degrees = [1, 3, 15]

for degree in degrees:
    coefs = np.polyfit(X, y, deg=degree)
    y_pred = np.polyval(coefs, X_smooth)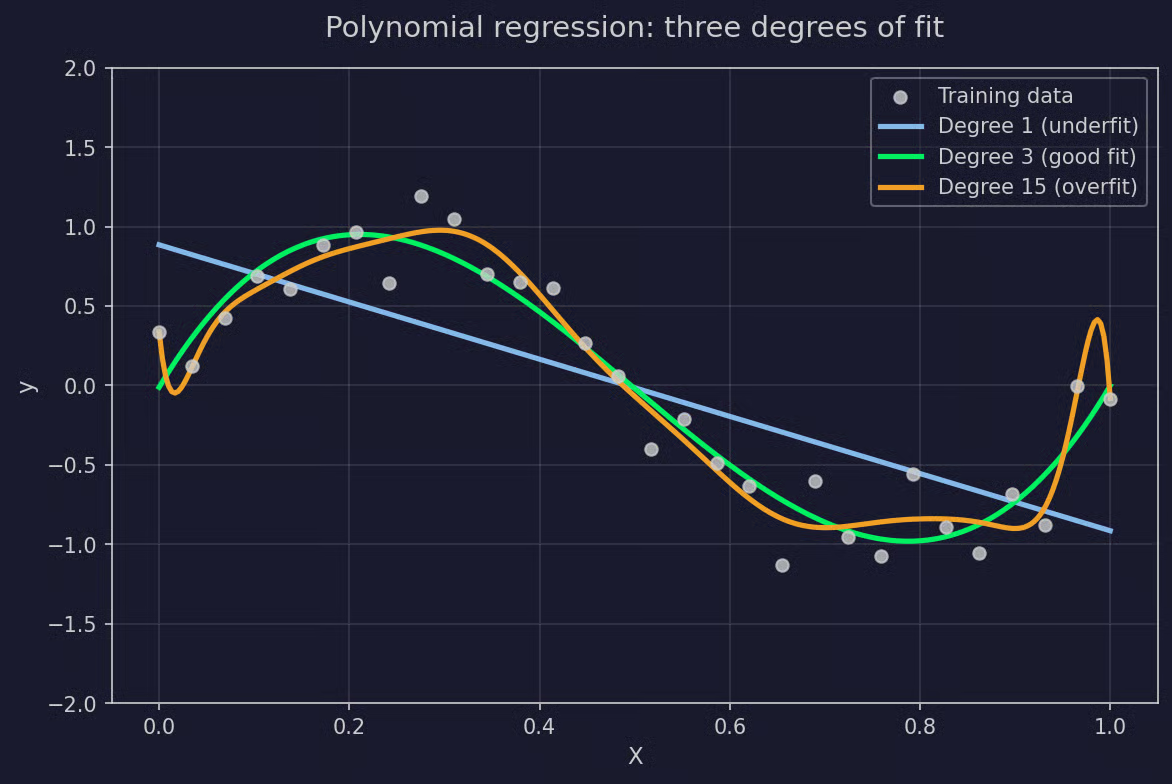
Esempio di regressione polinomiale
Il grado 1 è una retta che va in underfitting. Non riesce a seguire affatto la curva. Il grado 3 rappresenta la forma reale. Assorbe un po’ di rumore ma resta vicino alla verità. Il grado 15 va in overfitting, serpeggiando tra ogni punto di training e generando grandi oscillazioni tra di essi.
La stessa storia si vede con gli alberi decisionali. Puoi addestrare alberi di profondità crescente sugli stessi dati e misurare l'errore su training e test set.
import numpy as np
from sklearn.tree import DecisionTreeRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Data
np.random.seed(11)
X = np.linspace(0, 10, 250).reshape(-1, 1)
y = np.sin(X).ravel() + np.random.normal(0, 0.3, 250)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0
)

depths = range(1, 21)
train_errors = []
test_errors = []

for depth in depths:
    tree = DecisionTreeRegressor(max_depth=depth, random_state=0)
    tree.fit(X_train, y_train)
    train_errors.append(mean_squared_error(y_train, tree.predict(X_train)))
    test_errors.append(mean_squared_error(y_test, tree.predict(X_test)))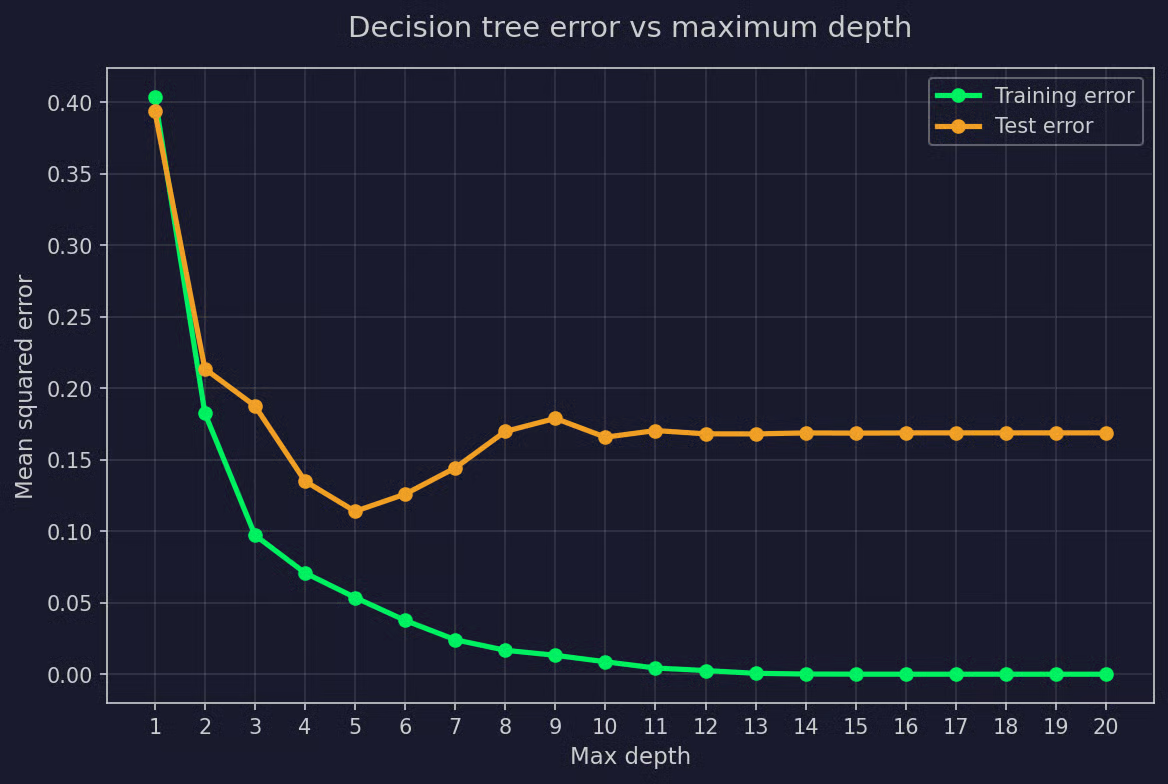
Esempio di albero decisionale
L'errore di training diminuisce man mano che l'albero diventa più profondo, avvicinandosi infine a zero quando ogni foglia contiene un solo punto di training. L'errore di test scende inizialmente mentre l'albero cattura le relazioni reali nei dati, poi risale quando split più profondi iniziano ad adattarsi al rumore. Il minimo si trova alla profondità che bilancia i due.
Anche scegliendo la metrica giusta, è facile trarre conclusioni errate. Ecco cosa non dovresti fare quando valuti le prestazioni di un modello:
Dovresti sempre controllare tutti e quattro prima di chiudere con un modello. La maggior parte dei fallimenti in produzione è legata a uno (o più) di questi aspetti.
Underfitting e overfitting sono i due modi in cui un modello fallisce nel generalizzare. Uno resta troppo semplice per apprendere il pattern. L'altro prova a imparare ogni punto del tuo dataset.
L'obiettivo reale del training è mettersi nel mezzo, dove bias e varianza sono bilanciati e l'errore totale è al minimo.
Le prestazioni in validazione sono la metrica che ti dice dove sei. Tienile d'occhio durante l'addestramento e lascia che la differenza tra errore di training e di validazione guidi le tue decisioni. Se l'errore di validazione smette di migliorare mentre quello di training continua a scendere, hai superato il punto ottimale. Se entrambi restano alti, non ci sei ancora arrivato.
Vuoi imparare concetti di data science più avanzati e diventare pronto per il lavoro nel 2026? Iscriviti al nostro Machine Learning Engineer track per passare dalle basi all'MLOps.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min




