
Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.3K
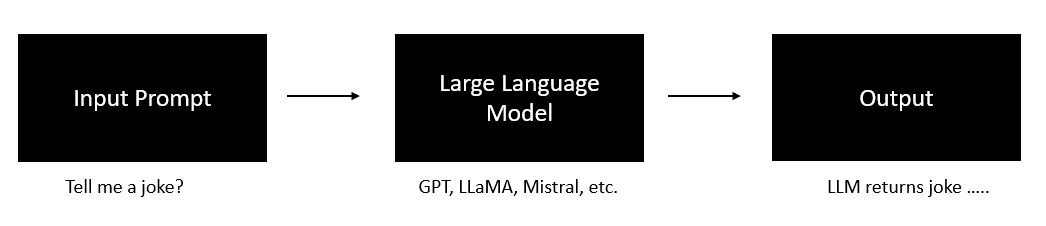
LangChain is een open-source framework waarmee je eenvoudig applicaties bouwt met taalmodellen zoals GPT, LLaMA, Mistral, enzovoort.
Een van de krachtigste functies van LangChain is de ondersteuning voor geavanceerde prompt engineering. Prompt engineering verwijst naar het ontwerpen en optimaliseren van prompts om de meest nauwkeurige en relevante reacties van een taalmodel te krijgen.
In deze post behandelen we de basis van prompts, hoe LangChain prompts gebruikt, prompttemplates, geheugen, agents en chains. Voor elk van deze kernconcepten bekijken we meerdere codevoorbeelden in Python, zodat je aan het einde van deze tutorial zelfverzekerd je eigen applicaties kunt bouwen met het LangChain-framework in Python.
Benieuwd hoe je met LangChain en GPT een eenvoudige AI-agent maakt? Bekijk onze Prompt Engineering met GPT & LangChain AI Code-Along:
Afbeelding door de auteur
We hebben een volledige gids over prompt engineering, maar kort samengevat: het is de praktijk van het creëren van tekstinvoer die effectief communiceert met generatieve AI-modellen. Deze prompts, geschreven in natuurlijke taal, specificeren de taak die we de AI willen laten uitvoeren.
Ze kunnen sterk variëren, van simpele vragen zoals een uitleg van een wiskundig theorem tot creatievere verzoeken zoals het schrijven van een gedicht over een bepaald thema.
Bij prompt engineering draait het niet alleen om wat je vraagt, maar vooral om hoe je het vraagt. Dat kan inhouden: de juiste bewoording kiezen, een bepaalde toon of stijl instellen, noodzakelijke context geven of zelfs een rol voor de AI definiëren, zoals vragen om te antwoorden alsof het een native speaker van een bepaalde taal is.
In sommige gevallen kunnen prompts ook voorbeelden bevatten om het leerproces van de AI te sturen. Deze techniek, bekend als few-shot learning, kan bijzonder effectief zijn voor complexe taken.
Bij modellen die afbeeldingen of audio genereren, beschrijven prompts doorgaans het gewenste resultaat in detail: van onderwerp en stijl tot compositie en sfeer van het eindproduct. De kunst van prompt engineering zit in het bijstellen van deze elementen om de AI te sturen naar het gewenste resultaat.
Afbeelding door de auteur
Prompts zijn de input die je aan large language models (LLM’s) geeft om een gewenst antwoord op te wekken. Goed ontworpen prompts zijn cruciaal om nuttige output van LLM’s te krijgen. Het doel van prompt engineering is om prompts zorgvuldig te construeren die leiden tot nauwkeurige, relevante en behulpzame LLM-antwoorden.
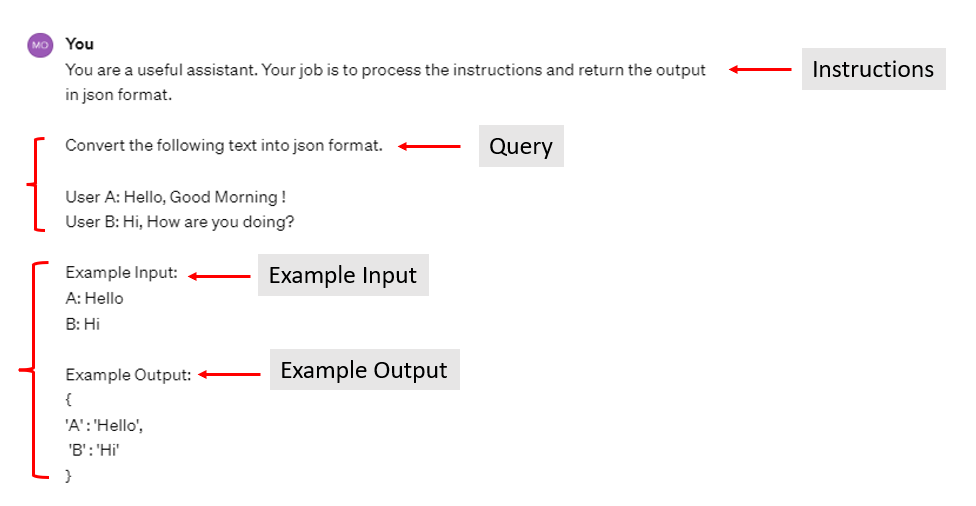
Een goede prompt bevat doorgaans deze vier componenten:
Behalve de query is alles optioneel, maar het kan de kwaliteit van de reactie aanzienlijk beïnvloeden, vooral de instructies die het LLM richting geven over de taak en de verwachte respons.
Voorbeelden laten het gewenste outputformaat zien voor een gegeven voorbeeldinvoer.
De query is de vraag of het verzoek dat aan het LLM wordt gedaan.
Effectieve prompts bouwen betekent deze elementen creatief combineren op basis van het probleem dat je oplost.
LangChain biedt verschillende klassen en functies om te helpen bij het opbouwen en gebruiken van prompts, waardoor het eenvoudiger wordt om complexe taken met taalmodellen te beheren.
LangChain biedt first-class ondersteuning voor prompt engineering via het object `PromptTemplate`.
Prompttemplates dienen als gestructureerde leidraad voor het formuleren van queries voor taalmodellen.
Deze templates bestaan doorgaans uit aanwijzingen, een selectie van voorbeeldinputs (few-shot voorbeelden) en op maat gemaakte vragen en contexten die geschikt zijn voor specifieke taken.
Het doel van LangChain is om templates te ontwerpen die compatibel zijn met verschillende taalmodellen, zodat je templates gemakkelijk tussen modellen kunt uitwisselen.
Kortom: je kunt de klasse PromptTemplate gebruiken om een template voor een stringprompt te maken.
from langchain.prompts import PromptTemplate


prompt_template = PromptTemplate.from_template(
    "Tell me a {adjective} joke about {content}."
)
prompt_template.format(adjective="sad", content="data scientists")Output:
>>> 'Tell me a sad joke about data scientists.'
Het is niet noodzakelijk om een variabele te hebben. Je kunt met deze klasse ook een prompt maken als je geen variabelen hebt.
from langchain.prompts import PromptTemplate
prompt_template = PromptTemplate.from_template("Tell me a joke")
prompt_template.format()Output:
>>> 'Tell me a joke'
Wat als je een chatapplicatie bouwt waarin je elke keer de berichtengeschiedenis naar het LLM moet opslaan en meesturen zodra een gebruiker een nieuw bericht stuurt? Dit handmatig doen kost veel tijd.
Voor ondersteunde chatmodellen kun je in plaats daarvan ChatPromptTemplate gebruiken:
from langchain.prompts import ChatPromptTemplate


chat_template = ChatPromptTemplate.from_messages(
    [
        ("system", "You are a helpful AI bot. Your name is {name}."),
        ("human", "Hello, how are you doing?"),
        ("ai", "I'm doing well, thanks!"),
        ("human", "{user_input}"),
    ]
)


messages = chat_template.format_messages(name="Bob", user_input="What is your name?")


print(messages)
Output:
>>> [SystemMessage(content='You are a helpful AI bot. Your name is Bob.'),
>>> HumanMessage(content='Hello, how are you doing?'),
>>> AIMessage(content="I'm doing well, thanks!"),
>>> HumanMessage(content='What is your name?')]
Dan vraag je je misschien af: waarom hebben we PromptTemplates nodig? Waarom kunnen we de stringprompt niet rechtstreeks doorgeven aan het LLM? Dit zijn goede redenen om LangChains PromptTemplate te gebruiken:
In taalmodelapplicaties die chatten omvatten is het belangrijk dat het systeem eerdere gesprekken onthoudt.
Net als in een normale chat moet het systeem kunnen terugkijken op wat er eerder is gezegd.
In de eenvoudigste vorm betekent dit dat het systeem een paar voorgaande berichten kan zien. Een geavanceerder systeem onthoudt meer details, zoals feiten over verschillende onderwerpen en hoe die met elkaar samenhangen.
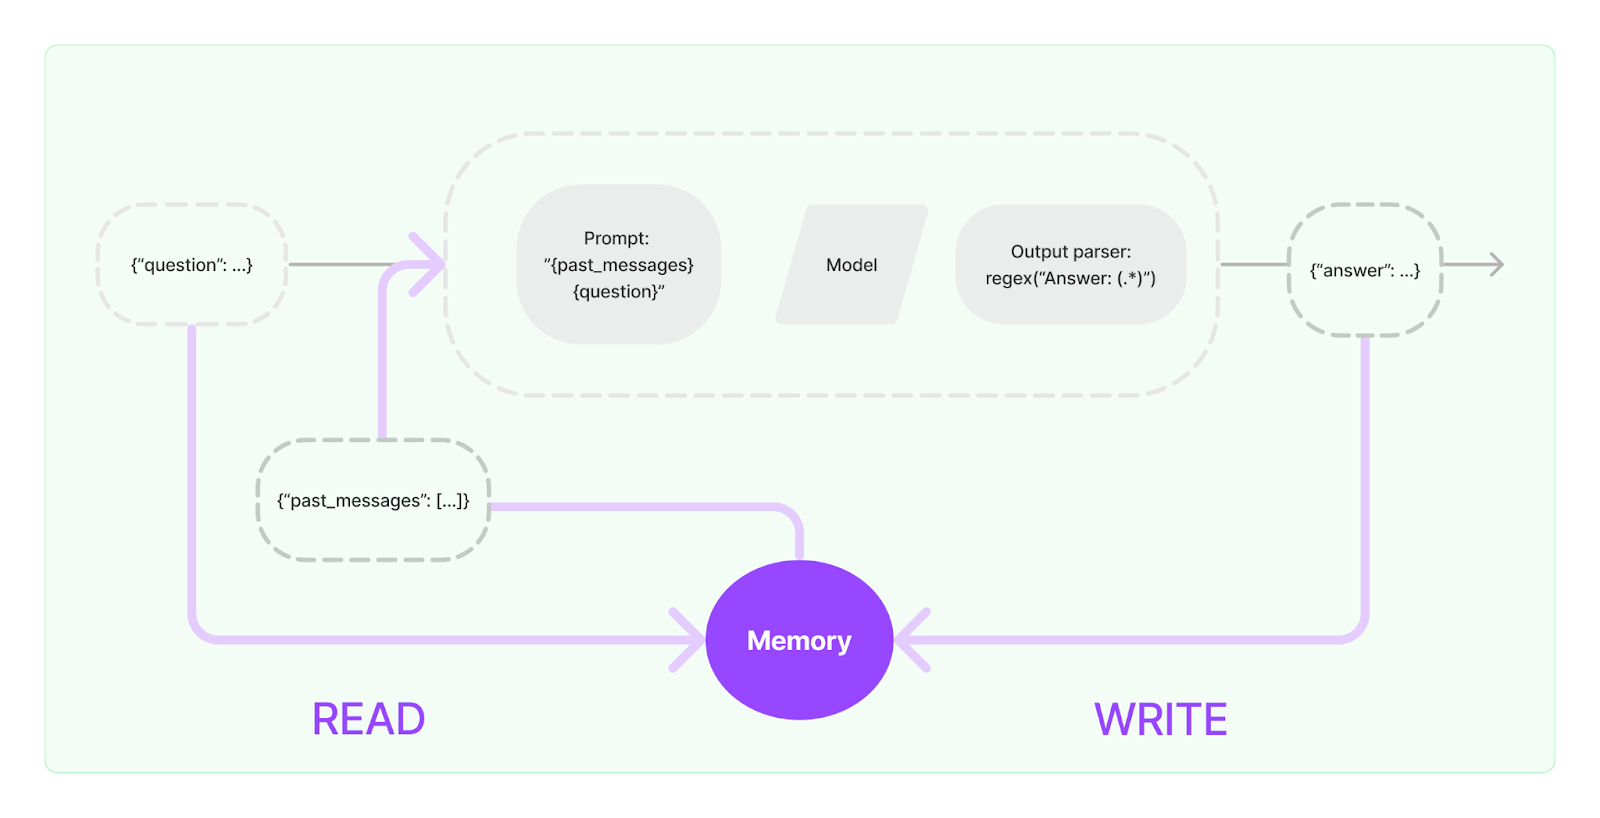
Dit vermogen om eerdere chats te onthouden heet "geheugen". LangChain helpt om geheugen aan deze chatsystemen toe te voegen.
Geheugen in LangChain doet twee hoofdactiviteiten:
Geheugen in LangChain (Beeldbron)
Om de functie Memory in LangChain te gebruiken, kun je de klasse ConversationBufferMemory gebruiken.
from langchain.memory import ConversationBufferMemory
memory = ConversationBufferMemory(return_messages=True)
memory.chat_memory.add_user_message("hi!")
memory.chat_memory.add_ai_message("what's up?")
memory.chat_memory.add_user_message("how are you doing?")
memory.chat_memory.add_ai_message("I am fine, thank you and you?")


# to check the variables history
memory.load_memory_variables({})
Output:
>>> {'history': [HumanMessage(content='hi!'),
>>> AIMessage(content="what's up?"),
>>> HumanMessage(content='how are you doing?'),
>>> AIMessage(content='I am fine, thank you and you?')]}
Het retourneert een woordenboek waarin de sleutel standaard history is. Deze sleutel verwijst naar een lijst met berichten, en die berichten kunnen afkomstig zijn van een mens (HumanMessage) of van het LLM (AIMessage).
Voor eenvoudige taken werkt één LLM (Large Language Model) prima. Voor complexere taken is het meestal nodig om meerdere stappen en/of modellen te koppelen.
De oude manier om Chains in LangChain te gebruiken is via de Chain-interface.
De nieuwere en aanbevolen methode is de LangChain Expression Language (LCEL). Hoewel LCEL de voorkeur heeft voor nieuwe projecten, is de Chain-methode nog steeds nuttig en ondersteund.
from langchain.llms import OpenAI
from langchain.chat_models import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain.schema import StrOutputParser


model = ChatOpenAI(openai_api_key = “...”)


prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "You're a expert data scientist and machine learning engineer who offer its expertise and responds to the point and accurately.",
        ),
        ("human", "{question}"),
    ]
)
runnable = prompt | model | StrOutputParser()


for chunk in runnable.stream({"question": "How is machine learning different than deep learning?"}):
print(chunk, end="", flush=True)Output:
>>> Machine learning and deep learning are subfields of artificial intelligence (AI) that involve training models to make predictions or decisions based on data. While there is an overlap between the two, they ……..
De manier waarop runnable is gemaakt is niet bepaald standaard voor Python, maar deze | is een pipe-operator. Prompt | model | StrOutputParser() betekent dat Prompt door het model wordt gestuurd en de output daarvan vervolgens door StrOutputParser() gaat. Elk segment in de chain transformeert de data op een bepaalde manier.
Wil je meer weten over interessante use-cases en applicaties die je met LangChain kunt bouwen? Bekijk onze tutorial over Engineering- en data-applicaties.
Het basisidee van agents is het gebruik van een taalmodel om een reeks acties te kiezen.
In tegenstelling tot chains, waar een reeks acties vooraf is bepaald en in de code is vastgelegd, gebruiken agents een taalmodel als beslissingsmechanisme om de juiste acties en hun volgorde te bepalen.
Er zijn drie kernbegrippen in de Agents van LangChain:
Tools vertegenwoordigen functionaliteiten die een agent kan activeren. Twee cruciale aspecten van toolontwerp zijn:
Voor diverse routinetaken heeft een agent een verzameling onderling verbonden tools nodig. Om dit te ondersteunen introduceert LangChain het idee van toolkits. LangChain biedt een breed scala aan toolkits om mee te starten.
Wil je meer leren over Agents? Bekijk dan deze officiële LangChain-gids.
Credits: Sommige voorbeelden in deze blog zijn ontleend aan de officiële LangChain-documentatie.
Door een gestructureerde aanpak te bieden voor het ontwerpen van prompts, vereenvoudigt LangChain niet alleen de interactie met verschillende taalmodellen, maar maximaliseert het ook de efficiëntie en relevantie van hun outputs. Functies zoals PromptTemplate en Memory in LangChain laten een doordachte integratie zien van flexibiliteit en precisie in prompt engineering, toepasbaar op een breed scala aan taken, van simpele vragen tot complexe conversaties.
De geavanceerde mogelijkheden in LangChains Chains en Agents vergroten het potentieel van applicaties die je met LangChain kunt bouwen in slechts een paar regels code, ongeacht de onderliggende keuze van LLM—en er is veel om uit te kiezen.
Of het nu voor eenvoudige taken is of voor ingewikkelde applicaties, de aanpak van LangChain voor prompt engineering is behoorlijk simpel, duidelijk en makkelijk toe te passen.
Meer leren? Bekijk deel 1 van How to Build LLM Applications with LangChain op DataCamp.
Leer meer over LLM’s
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

