Stel je voor dat je werkt met een enorme, ongestructureerde database vol herhaalde, redundante informatie. Elke update of verwijdering kan uitlopen op een ramp, met risico op fouten en inconsistenties. Third normal form (3NF) is een beproefde methode voor database-normalisatie om die chaos te voorkomen. Door 3NF toe te passen ruim je je datastructuur op, zodat die efficiënt, geordend en vrij van onnodige redundantie is.
In dit artikel bekijken we hoe 3NF werkt, waarom het waardevol is en hoe je het in de praktijk brengt. We vergelijken 3NF ook met andere vormen en leren wanneer je welke gebruikt. Iedereen kan baat hebben bij deze kennis, maar het is vooral waardevol als je database-ontwerper of data scientist bent, omdat het je werk aanzienlijk kan vereenvoudigen en je databases betrouwbaar houdt. Ben je geïnteresseerd in databaseontwerp in het algemeen, bekijk dan onze volledige cursus Database Design.
Third normal form is een belangrijk concept binnen database-normalisatie dat ongewenste afhankelijkheden verwijdert. 3NF bouwt voort op first normal form (1NF) en second normal form (2NF), en erft dus hun regels: 1NF vereist atomaire (onverdeelbare) waarden in elke cel, en 2NF verwijdert partiële afhankelijkheden van een samengestelde primaire sleutel. 3NF gaat een stap verder door transitieve afhankelijkheden te verwijderen, een situatie waarin niet-sleutelattributen indirect afhankelijk zijn van de primaire sleutel.
Door hierop te focussen zorgt 3NF ervoor dat elke niet-sleutelkolom in een tabel direct gekoppeld is aan de primaire sleutel en niets anders. Praktisch gezien helpt 3NF redundantie minimaliseren en anomalieën vermijden bij het invoegen, bijwerken of verwijderen van gegevens.
In de jaren 70 introduceerde Edgar F. Codd 3NF om de voorwaarden voor een volledig genormaliseerde databasestructuur te formaliseren. Een herformulering door Carlo Zaniolo een paar jaar later gaf een duidelijker uitleg van het verschil tussen de “klassieke” 3NF en de striktere Boyce-Codd normal form (BCNF). Maak je nog geen zorgen over BCNF; daar komen we verderop op terug.
Wat is er nu precies nodig om 3NF te bereiken? Een tabel moet aan een paar voorwaarden voldoen:
- In 2NF zijn: Dit betekent dat de data al atomair is, zonder herhalende groepen en zonder partiële afhankelijkheden van samengestelde sleutels.
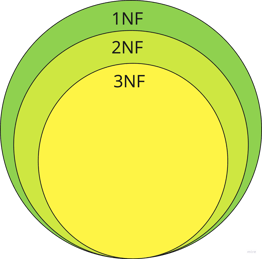
3NF omvat 2NF en 1NF. Afbeelding door de auteur
- Geen transitieve afhankelijkheden: Deze regel is cruciaal. In een 3NF-tabel moet elke kolom die geen primaire sleutel is uitsluitend afhangen van de primaire sleutel, en niet indirect via een andere niet-sleutelkolom.
Laten we bekijken wat dat praktisch betekent.
Tabellen ontleden om 3NF te bereiken
We lopen door het proces van het ontleden van tabellen om 3NF te bereiken. We gebruiken voorbeelddata uit DataCamp-cursussen om elke stap te illustreren.
Stap 1: Transitieve afhankelijkheden identificeren
We beginnen met het zoeken naar attributen in een tabel die indirect afhankelijk zijn van de primaire sleutel. Als vuistregel geldt: als een attribuut afhankelijk is van iets anders dan de primaire sleutel, duidt dat op een transitieve afhankelijkheid. Dat is een teken dat het tijd is om je tabel op te splitsen.
Kijk naar de drie tabellen hieronder. Welke bevat een transitieve afhankelijkheid?
Tabel 1: Course
Tabel 2: Instructor
| Instructor ID | Instructor Name | Expertise |
|---|
| 1 | Sarah Johnson | Data Science |
| 2 | Tom Williams | Machine Learning |
| 3 | Emily Brown | Python |
Tabel 3: Enrollments
Het antwoord is… Tabel 3!
In deze tabel is Course Name afhankelijk van Course ID, maar niet rechtstreeks van Enrollment ID (de primaire sleutel). Deze indirecte afhankelijkheid maakt Course Name een transitieve afhankelijkheid.
Stap 2: Gegevens opsplitsen in nieuwe tabellen
Om de transitieve afhankelijkheid aan te pakken, splitsen we Tabel 1 in twee tabellen. Elke tabel richt zich op direct afhankelijke data.
Aangepaste enrollments-tabel
| Enrollment ID | Student Name | Course ID |
|---|
| 1001 | Alice Smith | 201 |
| 1002 | Bob Green | 202 |
| 1003 | Charlie Blue | 201 |
Courses-tabel
Nu bevat elke tabel alleen informatie die direct afhankelijk is van de primaire sleutel: Course ID is nu de primaire sleutel voor Course Name in de Courses-tabel, en Enrollment ID is de primaire sleutel in de Enrollments-tabel.
Met deze ontleding voldoen de tabellen nu aan de 3NF-vereisten, waardoor redundantie wordt geëlimineerd en elke tabel alleen direct relevante informatie opslaat.
Wil je zelf aan de slag met het maken van databases, bekijk dan onze cursus Creating PostgreSQL Databases. Ben je al wat verder, probeer dan Introduction to Data Modeling in Snowflake, met onderwerpen als entiteit-relatie- en dimensioneel modelleren.
Waarom al die moeite doen om 3NF te bereiken? Dit zijn de belangrijkste voordelen:
- Betere dataintegriteit: Door transitieve afhankelijkheden te elimineren helpt 3NF ervoor te zorgen dat updates en verwijderingen niet leiden tot conflicterende of verouderde data in tabellen.
- Minder redundantie: Minder redundantie betekent dat je database makkelijker te onderhouden is en minder opslagruimte gebruikt.
- Eenvoudiger databeheer: Vergelijkbare informatie in eigen tabellen houden maakt het makkelijker records bij te werken zonder dubbele vermeldingen op te sporen.
Dat gezegd hebbende: hoewel 3NF de nauwkeurigheid ondersteunt, kan het ook leiden tot meer gefragmenteerde data, waardoor complexe queries soms trager worden door extra joins. In situaties waar snelheid zwaarder weegt dan normalisatie, kunnen BCNF of 4NF praktischere opties zijn.
Laten we de verschillen tussen de vormen bekijken.
Hier is een vergelijkingstabel om de vereisten van 1NF, 2NF en 3NF te verduidelijken.
| Feature | 1NF | 2NF | 3NF |
|---|
| Atomic data | ✅ | ✅ | ✅ |
| No partial dependencies | ❌ | ✅ | ✅ |
| No transitive dependencies | ❌ | ❌ | ✅ |
BCNF is een “striktere” vorm van 3NF die verdere anomalieën elimineert bij overlappende kandidaatsleutels. Het is vooral nuttig in complexe gevallen waar 3NF alleen afhankelijkheden niet volledig wegneemt. BCNF is van toepassing wanneer een niet-prime attribuut afhankelijk is van een attribuut dat deel uitmaakt van een samengestelde kandidaatsleutel. Klinkt ingewikkeld? Laten we het verduidelijken met een voorbeeld.
Huidige structuur (in 3NF)
Na ontleding om 3NF te bereiken, hadden we deze twee tabellen:
Enrollments-tabel
| Enrollment ID | Student Name | Course ID |
|---|
| 1001 | Alice Smith | 201 |
| 1002 | Bob Green | 202 |
| 1003 | Charlie Blue | 201 |
Courses-tabel
In deze structuur staat elke tabel in 3NF zonder transitieve afhankelijkheden en is de data goed genormaliseerd.
Een nieuwe vereiste toevoegen
Laten we nu een nieuw attribuut toevoegen aan Courses: het Classroom waarin elke cursus wordt gegeven. Dit nieuwe attribuut kan leiden tot een situatie die BCNF vereist.
Bijgewerkte Courses-tabel (3NF)
Hier is Course ID nog steeds de primaire sleutel en alle andere attributen hangen er direct van af. Stel echter dat er een nieuwe regel is dat elk lokaal maar één vak tegelijk kan huisvesten. Stel ook dat de Course Name "SQL Fundamentals" onder verschillende Course IDs (zoals 201, 204, enz.) kan worden aangeboden als ze op verschillende tijden zijn gepland. In dat geval vindt elke editie van "SQL Fundamentals" nog steeds plaats in "Room 101", ongeacht de specifieke Course ID. Daardoor bepaalt Course Name ook uniek het Classroom.
Dit betekent dat we nu twee kandidaatsleutels hebben:
- Course ID
- Course Name
Met beide kandidaatsleutels hebben we nu een probleem dat 3NF niet adresseert: Classroom hangt af van Course Name in plaats van alleen van Course ID.
BCNF toepassen
Om dit afhankelijkheidsprobleem te elimineren, moeten we de Courses-tabel verder ontleden in twee afzonderlijke tabellen die beter aansluiten op BCNF:
- Een nieuwe Courses-tabel, die alleen Course ID en Course Name bevat.
- Een CourseDetails-tabel, die de relatie tussen Course Name en Classroom opslaat.
Zo ziet dat eruit:
Aangepaste Courses-tabel (BCNF)
CourseDetails-tabel (BCNF)
Met deze nieuwe structuur voldoet elke tabel aan de BCNF-voorwaarden:
- In de Courses-tabel is Course ID de primaire sleutel en hangen alle attributen uitsluitend daarvan af.
- In de CourseDetails-tabel is Course Name de primaire sleutel en hangt Classroom alleen af van Course Name.
Deze opzet verwijdert afhankelijkheidsproblemen door overlappende kandidaatsleutels en zorgt voor een strikt genormaliseerde structuur.
Conclusie
Third normal form is een waardevol hulpmiddel voor databaseontwerpers die data schoon, consistent en vrij van problematische afhankelijkheden willen houden. Met 3NF wordt de dataintegriteit verbeterd, beheer verloopt soepeler en redundantie neemt af. Onthoud dat 3NF in de meeste situaties goed werkt, maar dat complexere databases kunnen profiteren van extra vormen zoals BCNF of 4NF.
Vond je dit artikel nuttig? Zet dan de volgende stap en behaal onze SQL Associate Certification. Het is een mooie manier om je SQL- en databasemanagementvaardigheden te valideren en je expertise te tonen aan potentiële werkgevers!




Stel je voor dat je werkt met een enorme, ongestructureerde database vol herhaalde, redundante informatie. Elke update of verwijdering kan uitlopen op een ramp, met risico op fouten en inconsistenties. Third normal form (3NF) is een beproefde methode voor database-normalisatie om die chaos te voorkomen. Door 3NF toe te passen ruim je je datastructuur op, zodat die efficiënt, geordend en vrij van onnodige redundantie is.
In dit artikel bekijken we hoe 3NF werkt, waarom het waardevol is en hoe je het in de praktijk brengt. We vergelijken 3NF ook met andere vormen en leren wanneer je welke gebruikt. Iedereen kan baat hebben bij deze kennis, maar het is vooral waardevol als je database-ontwerper of data scientist bent, omdat het je werk aanzienlijk kan vereenvoudigen en je databases betrouwbaar houdt. Ben je geïnteresseerd in databaseontwerp in het algemeen, bekijk dan onze volledige cursus Database Design.
Definitie van Third Normal Form (3NF)
Third normal form is een belangrijk concept binnen database-normalisatie dat ongewenste afhankelijkheden verwijdert. 3NF bouwt voort op first normal form (1NF) en second normal form (2NF), en erft dus hun regels: 1NF vereist atomaire (onverdeelbare) waarden in elke cel, en 2NF verwijdert partiële afhankelijkheden van een samengestelde primaire sleutel. 3NF gaat een stap verder door transitieve afhankelijkheden te verwijderen, een situatie waarin niet-sleutelattributen indirect afhankelijk zijn van de primaire sleutel.
Door hierop te focussen zorgt 3NF ervoor dat elke niet-sleutelkolom in een tabel direct gekoppeld is aan de primaire sleutel en niets anders. Praktisch gezien helpt 3NF redundantie minimaliseren en anomalieën vermijden bij het invoegen, bijwerken of verwijderen van gegevens.
In de jaren 70 introduceerde Edgar F. Codd 3NF om de voorwaarden voor een volledig genormaliseerde databasestructuur te formaliseren. Een herformulering door Carlo Zaniolo een paar jaar later gaf een duidelijker uitleg van het verschil tussen de “klassieke” 3NF en de striktere Boyce-Codd normal form (BCNF). Maak je nog geen zorgen over BCNF; daar komen we verderop op terug.
De voorwaarden voor Third Normal Form begrijpen
Wat is er nu precies nodig om 3NF te bereiken? Een tabel moet aan een paar voorwaarden voldoen:
3NF omvat 2NF en 1NF. Afbeelding door de auteur
Laten we bekijken wat dat praktisch betekent.
Tabellen ontleden om 3NF te bereiken
We lopen door het proces van het ontleden van tabellen om 3NF te bereiken. We gebruiken voorbeelddata uit DataCamp-cursussen om elke stap te illustreren.
Stap 1: Transitieve afhankelijkheden identificeren
We beginnen met het zoeken naar attributen in een tabel die indirect afhankelijk zijn van de primaire sleutel. Als vuistregel geldt: als een attribuut afhankelijk is van iets anders dan de primaire sleutel, duidt dat op een transitieve afhankelijkheid. Dat is een teken dat het tijd is om je tabel op te splitsen.
Kijk naar de drie tabellen hieronder. Welke bevat een transitieve afhankelijkheid?
Tabel 1: Course
Tabel 2: Instructor
Tabel 3: Enrollments
Het antwoord is… Tabel 3!
In deze tabel is Course Name afhankelijk van Course ID, maar niet rechtstreeks van Enrollment ID (de primaire sleutel). Deze indirecte afhankelijkheid maakt Course Name een transitieve afhankelijkheid.
Stap 2: Gegevens opsplitsen in nieuwe tabellen
Om de transitieve afhankelijkheid aan te pakken, splitsen we Tabel 1 in twee tabellen. Elke tabel richt zich op direct afhankelijke data.
Aangepaste enrollments-tabel
Courses-tabel
Nu bevat elke tabel alleen informatie die direct afhankelijk is van de primaire sleutel: Course ID is nu de primaire sleutel voor Course Name in de Courses-tabel, en Enrollment ID is de primaire sleutel in de Enrollments-tabel.
Met deze ontleding voldoen de tabellen nu aan de 3NF-vereisten, waardoor redundantie wordt geëlimineerd en elke tabel alleen direct relevante informatie opslaat.
Wil je zelf aan de slag met het maken van databases, bekijk dan onze cursus Creating PostgreSQL Databases. Ben je al wat verder, probeer dan Introduction to Data Modeling in Snowflake, met onderwerpen als entiteit-relatie- en dimensioneel modelleren.
Voordelen en beperkingen van Third Normal Form
Waarom al die moeite doen om 3NF te bereiken? Dit zijn de belangrijkste voordelen:
Dat gezegd hebbende: hoewel 3NF de nauwkeurigheid ondersteunt, kan het ook leiden tot meer gefragmenteerde data, waardoor complexe queries soms trager worden door extra joins. In situaties waar snelheid zwaarder weegt dan normalisatie, kunnen BCNF of 4NF praktischere opties zijn.
Vergelijking: First, Second, Third en BC Normal Forms
Laten we de verschillen tussen de vormen bekijken.
Vergelijkingstabel: first, second en third normal forms
Hier is een vergelijkingstabel om de vereisten van 1NF, 2NF en 3NF te verduidelijken.
BCNF is een “striktere” vorm van 3NF die verdere anomalieën elimineert bij overlappende kandidaatsleutels. Het is vooral nuttig in complexe gevallen waar 3NF alleen afhankelijkheden niet volledig wegneemt. BCNF is van toepassing wanneer een niet-prime attribuut afhankelijk is van een attribuut dat deel uitmaakt van een samengestelde kandidaatsleutel. Klinkt ingewikkeld? Laten we het verduidelijken met een voorbeeld.
Huidige structuur (in 3NF)
Na ontleding om 3NF te bereiken, hadden we deze twee tabellen:
Enrollments-tabel
Courses-tabel
In deze structuur staat elke tabel in 3NF zonder transitieve afhankelijkheden en is de data goed genormaliseerd.
Een nieuwe vereiste toevoegen
Laten we nu een nieuw attribuut toevoegen aan Courses: het Classroom waarin elke cursus wordt gegeven. Dit nieuwe attribuut kan leiden tot een situatie die BCNF vereist.
Bijgewerkte Courses-tabel (3NF)
Hier is Course ID nog steeds de primaire sleutel en alle andere attributen hangen er direct van af. Stel echter dat er een nieuwe regel is dat elk lokaal maar één vak tegelijk kan huisvesten. Stel ook dat de Course Name "SQL Fundamentals" onder verschillende Course IDs (zoals 201, 204, enz.) kan worden aangeboden als ze op verschillende tijden zijn gepland. In dat geval vindt elke editie van "SQL Fundamentals" nog steeds plaats in "Room 101", ongeacht de specifieke Course ID. Daardoor bepaalt Course Name ook uniek het Classroom.
Dit betekent dat we nu twee kandidaatsleutels hebben:
Met beide kandidaatsleutels hebben we nu een probleem dat 3NF niet adresseert: Classroom hangt af van Course Name in plaats van alleen van Course ID.
BCNF toepassen
Om dit afhankelijkheidsprobleem te elimineren, moeten we de Courses-tabel verder ontleden in twee afzonderlijke tabellen die beter aansluiten op BCNF:
Zo ziet dat eruit:
Aangepaste Courses-tabel (BCNF)
CourseDetails-tabel (BCNF)
Deze opzet verwijdert afhankelijkheidsproblemen door overlappende kandidaatsleutels en zorgt voor een strikt genormaliseerde structuur.
Conclusie
Third normal form is een waardevol hulpmiddel voor databaseontwerpers die data schoon, consistent en vrij van problematische afhankelijkheden willen houden. Met 3NF wordt de dataintegriteit verbeterd, beheer verloopt soepeler en redundantie neemt af. Onthoud dat 3NF in de meeste situaties goed werkt, maar dat complexere databases kunnen profiteren van extra vormen zoals BCNF of 4NF.
Vond je dit artikel nuttig? Zet dan de volgende stap en behaal onze SQL Associate Certification. Het is een mooie manier om je SQL- en databasemanagementvaardigheden te valideren en je expertise te tonen aan potentiële werkgevers!