Cursus
Prompt Engineering begrijpen
1 uur
240.6K
Zero-shot prompting is een techniek die de generalisatiecapaciteiten van LLM’s benut om nieuwe taken aan te pakken zonder voorafgaande specifieke training of voorbeelden.
Het maakt gebruik van de uitgebreide pre-training van LLM’s op grote en diverse datasets, waardoor ze hun brede kennis kunnen toepassen op nieuwe taken op basis van alleen duidelijke en beknopte instructies. Hoewel deze techniek zeer effectief kan zijn, hangt het succes af van de complexiteit van de taak en de kwaliteit van de prompt.
Kort gezegd: je beschrijft de taak die je het model wilt laten uitvoeren zonder voorbeelden te geven. Het model gebruikt vervolgens zijn uitgebreide, vooraf getrainde kennis om een relevant antwoord te genereren.
Deze aanpak staat tegenover one-shot of few-shot prompting, waarbij je het model één of enkele voorbeelden geeft om de output te sturen.
Zero-shot prompting laat zien hoe indrukwekkend LLM’s hun begrip kunnen generaliseren over uiteenlopende domeinen. Met alleen een duidelijke instructie kun je de kennisbasis van het model aanboren om creatieve, informatieve of taak-specifieke content te genereren zonder extra training.
Laten we snel een voorbeeld bekijken:
Prompt: Classificeer het dier op basis van zijn kenmerken. Dier: Dit wezen heeft acht poten, spint webben en eet vaak insecten.
Output: Spin.
In dit voorbeeld geeft de prompt geen voorbeelden van hoe je dieren moet classificeren of welke classificaties je moet gebruiken. Ook definieert de prompt de taak duidelijk (classificeer het dier) op basis van de gegeven kenmerken.
Het large language model gebruikt zijn brede kennis over dieren en hun eigenschappen om de classificatie te maken en herkent correct dat het beschreven wezen een spin is op basis van de genoemde kernkenmerken. Het geeft precies de gevraagde classificatie, wat laat zien dat het instructies nauwkeurig kan volgen.
Zero-shot prompting maakt taak-specifieke fine-tuning overbodig, vergroot drastisch het aantal taken dat een model kan uitvoeren en maakt geavanceerde mogelijkheden toegankelijker voor niet-technische gebruikers.
Om te begrijpen hoe zero-shot prompting werkt, moeten twee belangrijke aspecten duidelijk zijn: de pre-training van LLM’s en het concept promptdesign.
LLM’s ondergaan uitgebreide pre-training op enorme datasets, wat de basis vormt voor hun zero-shot-capaciteiten. Het pre-trainingsproces verloopt als volgt:
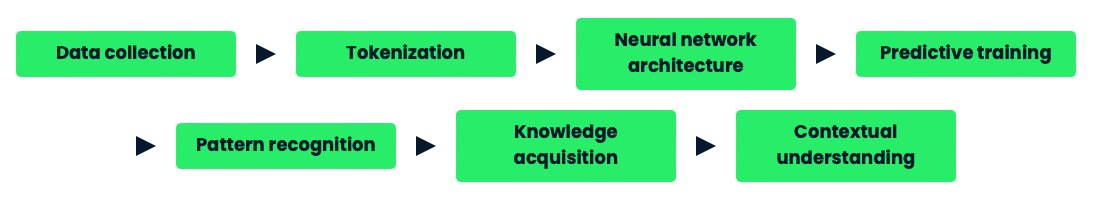
Dit geeft LLM’s de kennis, het begrip en de flexibiliteit die nodig zijn voor zero-shot prompting. Door deze uitgebreide pre-training kunnen deze modellen taken uitvoeren waarvoor ze niet expliciet zijn getraind, simpelweg door natuurlijke taalprompts te begrijpen en erop te reageren.
Effectief promptdesign is cruciaal voor succesvolle zero-shot prompting. Het vormt de brug tussen de intentie van de gebruiker en de capaciteiten van het model. Maar hoe zorgen we ervoor dat onze prompts effectief zijn? Kijk eens naar deze strategieën:
Prompts moeten expliciete, ondubbelzinnige instructies geven die de gewenste taak aan het LLM overbrengen.
Voorbeeld: "Vertaal de volgende Engelse zin naar het Frans:" Deze prompt benoemt duidelijk de taak (vertaling) en specificeert zowel de brontaal (Engels) als de doeltaal (Frans), waardoor er geen ruimte is voor misinterpretatie.
Kader de taak op een manier die de bestaande kennis en capaciteiten van het model benut.
Voorbeeld: "Classificeer de sentiment van deze filmrecensie als positief, negatief of neutraal:" Deze prompt kadert de taak als een classificatieprobleem met specifieke categorieën, wat aansluit bij de training van het model in tekstclassificatie.
Neem relevante context of achtergrondinformatie op om het model te helpen de vereisten en beperkingen van de taak te begrijpen.
Voorbeeld: "Aangezien 'Python' in deze context verwijst naar een programmeertaal, leg uit wat Python is:" Deze prompt biedt cruciale context (Python als programmeertaal, niet als slang) om te zorgen dat het model zich op de relevante informatie richt.
Definieer duidelijk het verwachte formaat van het antwoord.
Voorbeeld: "Noem drie belangrijkste oorzaken van klimaatverandering, elk in een apart opsommingsteken." Deze prompt specificeert zowel het aantal items (drie) als het format (bullet points) voor het antwoord, wat zorgt voor een gestructureerde output.
Gebruik precieze taal en vermijd vage of open instructies die tot misinterpretatie door het model kunnen leiden.
Voorbeeld: "Beschrijf de specifieke stappen in de waterkringloop, beginnend met verdamping." Deze prompt gebruikt precieze taal ("specifieke stappen", "waterkringloop") en geeft een startpunt, waardoor de kans op misinterpretatie kleiner wordt.
Formuleer prompts op een manier die natuurlijk en conversatiegericht aanvoelt.
Voorbeeld: "Stel je voor dat je loopbaanadviseur bent. Welk advies geef je een pas afgestudeerde die zijn of haar eerste baan zoekt?" Deze prompt hanteert een gesprekstoon en schetst een herkenbare situatie, wat een natuurlijker en boeiender antwoord uitlokt.
Als de eerste resultaten tegenvallen, verfijn de prompt dan door meer specificiteit toe te voegen of de formulering aan te passen.
Voorbeeld: Eerste prompt: "Vertel me iets over hernieuwbare energie." Verfijnde prompt: "Leg de drie meest voorkomende soorten hernieuwbare energiebronnen uit, hun voordelen en de huidige uitdagingen bij implementatie." Dit laat zien hoe een brede initiële prompt kan worden verfijnd tot een gerichter en vollediger antwoord.
Zero-shot prompting heeft aanzienlijke voordelen ten opzichte van andere technieken.
Een daarvan is de grote flexibiliteit. Dit stelt LLM’s in staat zich aan te passen aan uiteenlopende taken zonder dat taak-specifieke trainingsdata nodig is. Flexibiliteit is belangrijk omdat één model zo talloze taken kan uitvoeren in verschillende domeinen, van vertalen tot sentimentanalyse en contentcreatie. Het maakt snelle aanpassing aan nieuwe taken mogelijk, zonder tijdrovend hertrainen of fine-tunen.
Ook kunnen zero-shot-modellen nieuwe situaties of taken aan die niet eerder expliciet zijn overwogen. Je kunt het gedrag van het model bovendien afstemmen op specifieke behoeften door de prompt aan te passen, zonder het onderliggende model te wijzigen.
Naarmate de algemene kennis van het model groeit, verbetert zijn vermogen om diverse taken aan te kunnen vanzelf, zonder taak-specifieke ingrepen.
Zero-shot prompting biedt ook aanzienlijke efficiëntievoordelen, vooral qua tijd- en middelenbesparing. Het elimineert de noodzaak voor uitgebreide taak-specifieke datasets, die tijdrovend en duur kunnen zijn om te verzamelen.
Het haalt ook de vereiste voor gelabelde trainingsdata weg, wat kosten en mogelijke vooringenomenheid bij menselijke annotatoren vermindert. Zonder taak-specifieke fine-tuning zijn de rekenkosten aanzienlijk lager. Daardoor kun je nieuwe toepassingen sneller uitrollen, omdat je niet hoeft te wachten op dataverzameling en modeltraining. Één enkel model kan veel taken aan, waardoor je minder gespecialiseerde modellen nodig hebt. Prompt engineering maakt snelle iteraties en verbeteringen mogelijk zonder te hertrainen.
Laten we het traditionele proces vergelijken met zero-shot prompting voor het ontwikkelen van een tool voor sentimentanalyse:
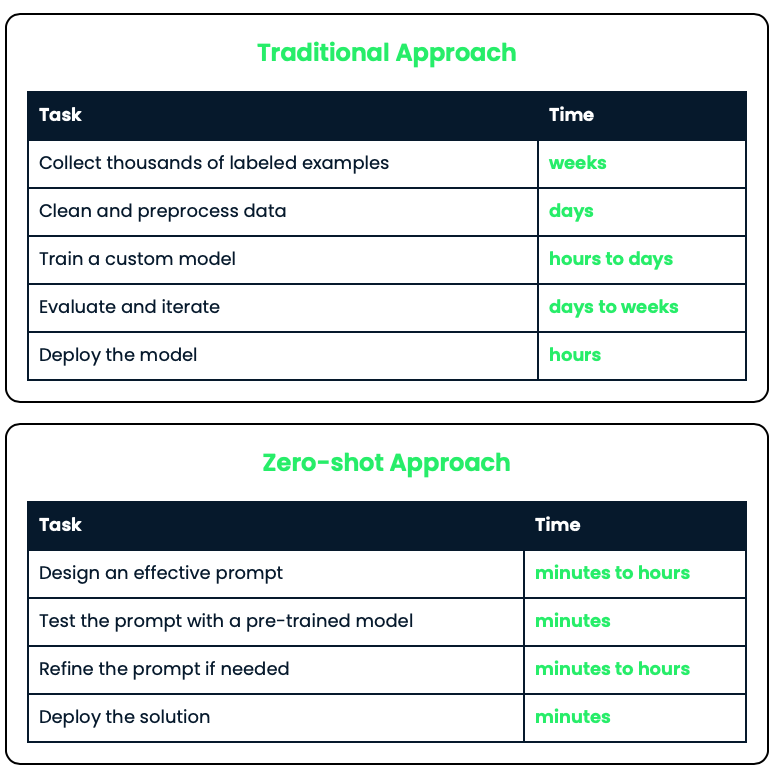
Deze vergelijking laat de aanzienlijke tijd- en middelenbesparing zien die met zero-shot prompting wordt behaald, waardoor snellere ontwikkeling en implementatie van AIoplossingen mogelijk wordt in verschillende sectoren.
Zero-shot prompting heeft geleid tot veel nieuwe toepassingen in verschillende velden. Laten we enkele belangrijke gebieden bekijken waar deze techniek het verschil maakt.
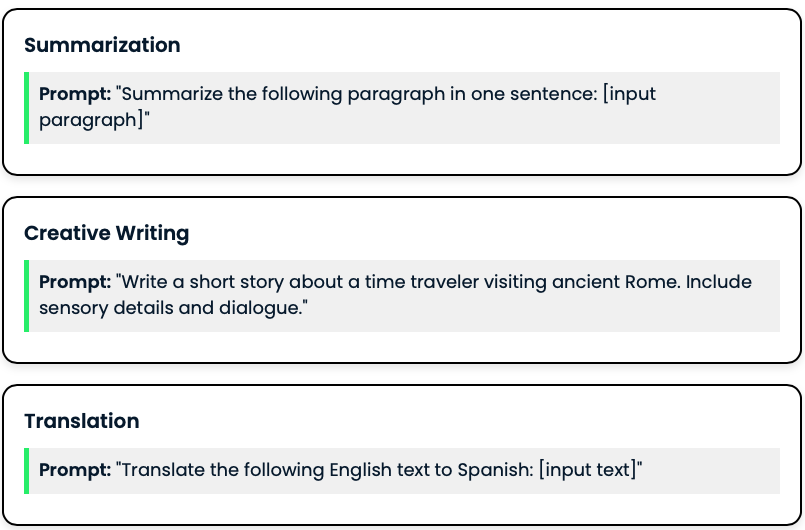
Zero-shot prompting werkt uitstekend voor diverse tekstgeneratietaken, waardoor modellen uiteenlopende soorten content kunnen produceren zonder specifieke training. Denk aan samenvatten, creatief schrijven en vertalen. Hier zijn enkele voorbeelden:
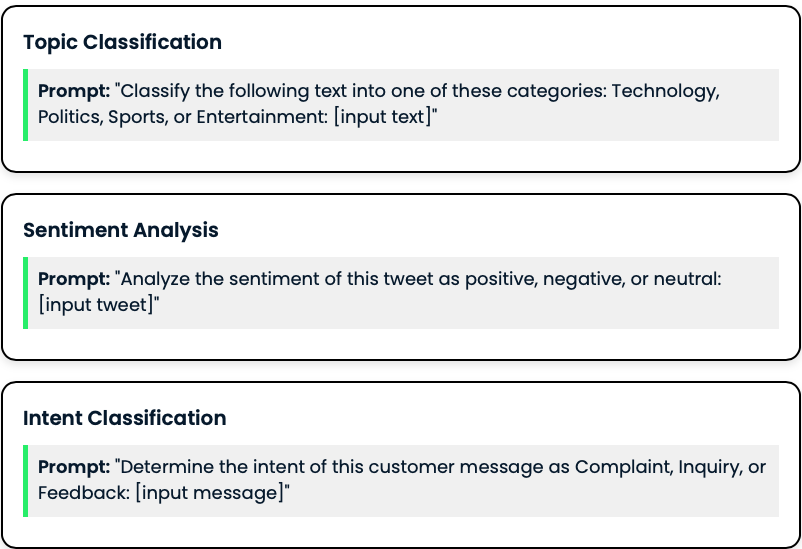
Zero-shot prompting kan worden gebruikt voor verschillende classificatietaken, waaronder onderwerpclassificatie, sentimentanalyse en intentieclassificatie, zonder gelabelde trainingsdata nodig te hebben.
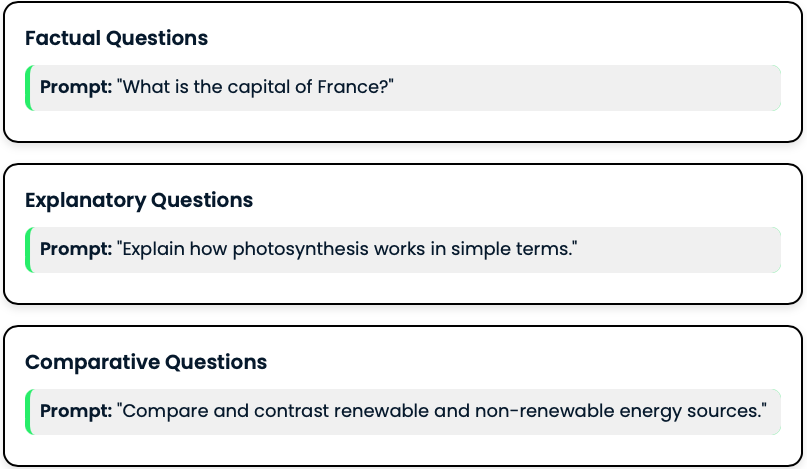
Zero-shot prompting geeft modellen het vermogen om veel verschillende soorten vragen te beantwoorden, zoals feitelijke, verklarende en vergelijkende vragen, op basis van hun algemene kennis en taalbegrip.
Hoewel zero-shot prompting veel kan, is het belangrijk de beperkingen en uitdagingen te begrijpen.
Zero-shot prompting is krachtig, maar niet altijd zo nauwkeurig als modellen die speciaal voor bepaalde taken zijn getraind. Dit komt door verschillende factoren:
De prestaties van zero-shot prompting kunnen sterk afhangen van de bewoording van de prompt.
Laten we een concreet voorbeeld bekijken met een voorbeeldtekst en de outputs per prompt uitleggen. Zo zie je hoe kleine wijzigingen in prompting tot verschillende reacties van het model kunnen leiden.
We gebruiken de volgende voorbeeldtekst:
Voorbeeldtekst: "De Industriële Revolutie, die plaatsvond van de 18e tot de 19e eeuw, was een periode waarin overwegend agrarische, landelijke samenlevingen in Europa en Amerika industrieel en stedelijk werden. Vóór de Industriële Revolutie, die eind 1700 in Groot-Brittannië begon, vond productie vaak thuis plaats met handgereedschap of eenvoudige machines. Industrialisatie markeerde een verschuiving naar aangedreven, speciaal ontworpen machines, fabrieken en massaproductie. De ijzer- en textielindustrie, samen met de ontwikkeling van de stoommachine, speelden een centrale rol in de Industriële Revolutie, die ook verbeteringen zag in systemen voor vervoer, communicatie en bankwezen."
Laten we nu onze drie prompts toepassen:
Prompt 1: "Vat deze tekst samen in één zin:"
Resultaat 1: De Industriële Revolutie was een transformerende periode in de 18e en 19e eeuw die Europese en Amerikaanse samenlevingen van agrarisch naar industrieel deed verschuiven, gekenmerkt door de opkomst van fabrieken, massaproductie en technologische vooruitgang in productie, vervoer en communicatie.
Dit antwoord geeft een beknopte, enkelvoudige zin die de kern van de Industriële Revolutie vangt: tijdsperiode, locatie en belangrijkste kenmerken.
Prompt 2: "Geef een korte samenvatting van het volgende:"
Resultaat 2: De Industriële Revolutie was een belangrijke periode van verandering van de 18e tot de 19e eeuw, die vooral Europa en Amerika trof. Het markeerde een overgang van agrarische, landelijke samenlevingen naar industriële en stedelijke. Vóór dit tijdperk vond productie doorgaans thuis plaats met eenvoudige gereedschappen. De revolutie bracht aangedreven machines, fabrieken en massaproductiemethoden. Sleutelindustrieën zoals ijzer en textiel speelden cruciale rollen, net als de uitvinding van de stoommachine. Deze periode kende ook vooruitgang in vervoers-, communicatie- en banksystemen, wat het economische en sociale landschap fundamenteel veranderde.
Dit antwoord is langer en gedetailleerder dan het eerste. Het behandelt meer aspecten van de Industriële Revolutie, waaronder de impact op specifieke industrieën en bredere maatschappelijke veranderingen. Het model interpreteerde "korte samenvatting" als de ruimte voor meerdere zinnen en een bredere dekking.
Prompt 3: "Wat is het hoofdpunt van deze passage?"
Resultaat 3: Het hoofdpunt van deze passage is de fundamentele verschuiving van agrarische naar industriële samenleving tijdens de Industriële Revolutie, met nadruk op de grote veranderingen in productiemethoden, technologie en stedelijke ontwikkeling die plaatsvonden in Europa en Amerika in de 18e en 19e eeuw.
Dit antwoord focust op het centrale thema of kernidee van de passage in plaats van te proberen alle details samen te vatten. Het benoemt de belangrijkste transformatie (van agrarisch naar industrieel) en noemt brede veranderingsgebieden zonder in te gaan op specificaties zoals de ijzer- en textielindustrie of de stoommachine.
Voorgetrainde modellen die voor zero-shot prompting worden gebruikt, kunnen vooroordelen vertonen die in hun trainingsdata aanwezig zijn, wat tot problematische outputs kan leiden:
Deze beperkingen en uitdagingen begrijpen is essentieel om zero-shot prompting effectief te gebruiken. Het is belangrijk dat je je bewust bent van mogelijke onnauwkeurigheden, het belang van zorgvuldig promptdesign en de noodzaak om outputs kritisch te beoordelen op mogelijke vooroordelen.
Als je hierin bent geïnteresseerd, bekijk dan deze cursus over AI-ethiek.
Leer meer over AI!
Cursus
Cursus
blog
Adel Nehme
15 min

