
Last chance! 50% off DataCamp Premium
Sale ends in
Anthropic, Claude Sonnet 5.5’i 28 Eylül 2026’da yayımladı ve OpenAI bir gün sonra DevDay’de GPT-6.1 Sol ile yanıt verdi.
Her ikisi de aynı liste fiyatına sahip orta seviye modeller ve her iki lansman yazısı da kendilerini birbirleriyle değil Claude Opus 5.5 ile karşılaştırıyor. Bu da aralarında seçim yapacaklar için neredeyse hiç örtüşmeyen iki kıyas seti ve eşit bir fiyat etiketi bırakıyor.
Bu yazıda GPT-6.1 Sol ve Claude Sonnet 5.5’i kodlama, bilgi işleri, hız, güvenlik ve fiyatlandırma başlıklarında karşılaştıracak ve ardından her ikisini de aynı uygulamalı kodlama testinden geçireceğim.
Her bir model hakkında daha kapsamlı bilgi için GPT-6.1 Sol rehberimize ve Claude Sonnet 5.5 rehberimize bakın.
GPT-6.1 Sol, OpenAI’nin orta seviye GPT-6 modeli olup, 29 Eylül 2026’da DevDay’de, GPT-6 Sol’dan bir hafta sonra yayımlandı. OpenAI, onu aracılık kodlama, bilgisayar kullanımı ve profesyonel işler için “Astra’ya yakın zekâ, beşte bir fiyatına” olarak konumlandırıyor.
Sol serisini gerçek bir projede görmek için bir kod tabanı geçiş ajanı inşa edeceğiniz GPT-6 Sol API eğitimimizi ya da GPT-6 Sol vs Claude Opus 5.5 karşılaştırmamızı deneyin.
Claude Sonnet 5.5, Anthropic’in orta seviye modeli olup 28 Eylül 2026’da yayımlandı; Claude 5.5 serisinin ikinci modeli ve Claude Opus 5.5’e daha hızlı ve düşük maliyetli bir tamamlayıcı.
Anthropic, günlük iyi çerçevelenmiş görevler, hata düzeltmeleri ve cilalı belgelerde en güçlü olduğunu belirtiyor; ilk test kullanıcıları ise tasarım gözüne dikkat çekti.
Claude API’ye kapsamlı rehberimiz kurulum ve maliyet yönetimini ele alır; Claude Opus 5.5 rehberimiz ise büyük kardeşinin hâlâ fiyatını hak ettiği yerleri açıklar.
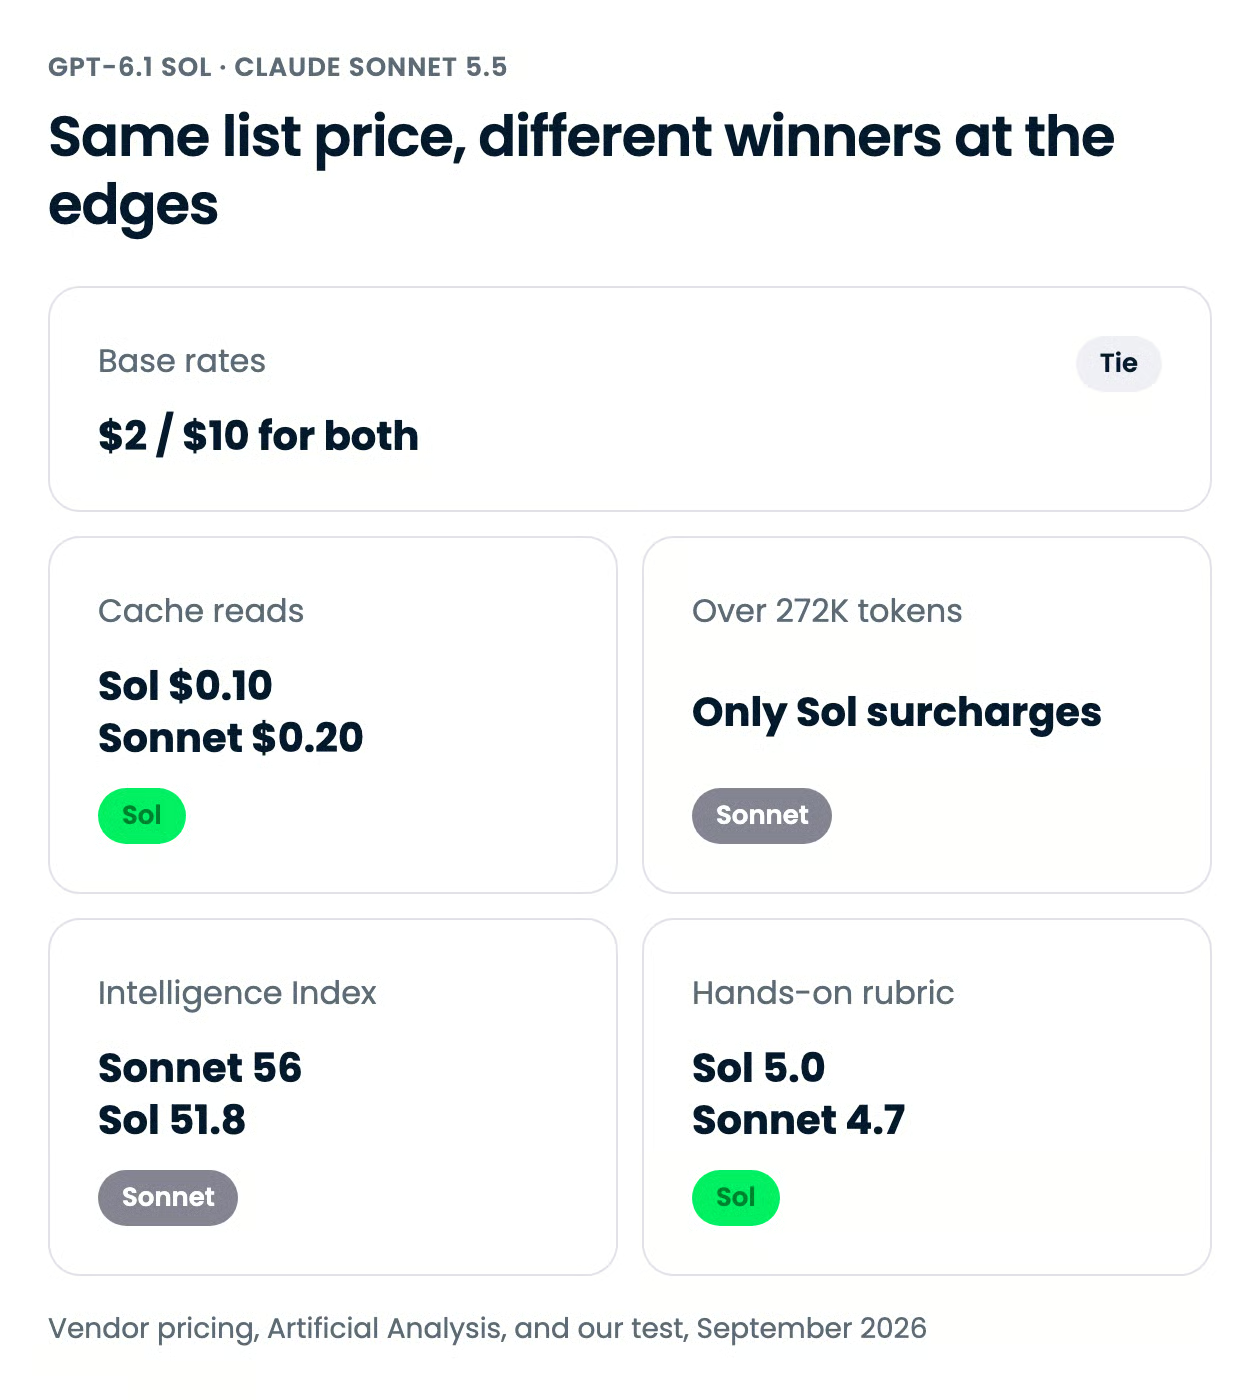
GPT-6.1 Sol ve Claude Sonnet 5.5, yakın dönemler arası sağlayıcı eşleşmeleri arasında en yakın olanı: aynı temel ücretler, aynı efor basamakları ve neredeyse özdeş bağlam pencereleri.
Önemli farklar önbellek fiyatlandırması, uzun istem faturası, hız ve her bir modelin kuralları bozan girdileri nasıl ele aldığı konularında.
| Özellik | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Geliştirici ve sürüm | OpenAI, 29 Eylül 2026 | Anthropic, 28 Eylül 2026 |
| Konumlandırma | Astra’nın fiyatının beşte birine Astra’ya yakın sonuçlar | Opus 5.5’e daha hızlı, daha düşük maliyetli tamamlayıcı |
| Girdi / çıktı (1M token başına) | $2 / $10 | $2 / $10 |
| Önbellekten girdi okuma (1M token başına) | $0.10 | $0.20 |
| Uzun istemler | 272K girdi tokenının üzerinde 2x girdi, 1.5x çıktı | Tam 1M pencerede standart ücretler |
| Bağlam penceresi / azami çıktı | 1.050.000 / 128.000 token | 1M / 128K token |
| Akıl yürütme efor seviyeleri | düşük, orta, yüksek, çok yüksek, en yüksek | düşük, orta, yüksek, çok yüksek, en yüksek |
| Artificial Analysis Intelligence Index | 51.8 | 56 |
| Başlıca bulutlar | Microsoft Azure (Bedrock ve Vertex AI doğrulanmadı) | Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Uygulamalı testimiz (rubrik ortalaması) | 5.0 | 4.7 |
Hiçbir sağlayıcı, diğerinin de çalıştırdığı bir kodlama kıyaslaması yayımlamadı; bu yüzden karşılaştırmanın tek yolu, her iki lansman yazısında ölçüt olarak kullanılan Claude Opus 5.5 üzerinden.
Bu şekilde okunduğunda iki model kabaca aynı noktaya iniyor: her biri, Opus 5.5’in $4 / $20 liste fiyatının yarısına Opus seviyesinde ajan sonuçları iddia ediyor.
| Kıyas | GPT-6.1 Sol | Claude Sonnet 5.5 | Notlar |
|---|---|---|---|
| DeepSWE v1.1 | GPT-6 Astra ile eşleşiyor; GPT-6 Sol’un en iyisinden 6.4 puan fazla | Yayımlanmadı | OpenAI, yalnızca göreli iddia |
| AutomationBench 1.0.6 | Orta eforda Opus 5.5’in 2.2 puan üzerinde | Yayımlanmadı | OpenAI, Opus 5.5 maliyetinin yaklaşık üçte birine |
| Terminal-Bench Science 0.1 | En yüksek eforda görev başına $5.47, Opus 5.5 için $23.21 | Yayımlanmadı | OpenAI; skorda GPT-6 Astra %68.1 ile önde |
| Terminal-Bench 4.0 | Yayımlanmadı | %70.6 (Opus 5.5: %66.4) | Anthropic; Artificial Analysis %64 ölçtü |
| CursorBench 4.0 | Yayımlanmadı | %55.5 (Opus 5.5: %57.8) | Anthropic; gerçek Cursor oturumlarından görevler |
| FrontierCode 1.1 (Ana) | Yayımlanmadı | xhigh’da %52.1, max’ta %46.2 | Anthropic; Opus 5.5 %54.4 puan alıyor |
Sol’un kanıtı, görev başına düşük maliyetle uzun ufuklu yazılım mühendisliği üzerine; Sonnet’ninki ise terminal çalışması ve dağınık, çok dosyalı editör oturumları üzerine; bir testte Opus 5.5’i geçerken diğerinde gerisinde kalıyor.
Tüm tablo için iki uyarı geçerli:
Yayımlanan sayılara göre kodlama, lansman yazılarının önerdiğinden daha çok beraberliğe yakın; bu yüzden aşağıdaki uygulamalı test, normalden daha fazla ağırlık taşıyor.
Claude Sonnet 5.5, kısmen Anthropic daha fazla veri yayımladığı için ofis ve belge işleri için daha güçlü bir yayınlanmış dosyaya sahip.
Sonnet, GDPval-AA’da 1844 puan alarak Opus 5.5’e 2 puan yaklaşıyor ve OSWorld 2.1’de %80.1. GPT-6.1 Sol, karmaşık profesyonel PDF’ler üzerinde soru-cevap testi olan GDP.pdf’de geri dönüşlerle Opus 5.5’i görev başına maliyetin yarısından azına geçiyor ve OSWorld 2.0 çevrimdışı setinde GPT-6 Astra’nın 2.1 puanına kadar yaklaşıyor.
OSWorld sürümleri farklı, dolayısıyla bu iki sonuç doğrudan karşılaştırılamaz.
Paylaşılan tek üçüncü taraf rakam olan Artificial Analysis Intelligence Index, Sonnet’i 56, Sol’u 51.8 olarak veriyor; sırasıyla Smartscope ve OpenRouter’ın model listesinde raporlandığı üzere.
Mevcut kanıtlara göre bilgi işlerinde Sonnet az farkla önde.
Varsayılan olarak daha hızlı model Claude Sonnet 5.5.
Anthropic, Sonnet 5’e göre çıktıyı %30+ daha hızlı ürettiğini ve görev başına maliyeti %30’a kadar düşürdüğünü söylüyor; lansman yazısındaki müşteri raporları da bu deseni doğruluyor; örneğin Lovable’ın kodlama değerlendirmelerinde “üçte bir daha az araç çağrısı”.
GPT-6.1 Sol hızı ücretli bir eklenti gibi ele alıyor. Hızlı modu standart ücretlerin 2 katı faturalandırılıyor ve AB veri ikametinde kullanılamıyor; OpenAI, Codex’te token üretimi 8 kata kadar daha hızlı olan GPT-6.1 Sol Ultrafast’in birkaç gün içinde geleceğini söylüyor.
Anthropic hızlı modu yalnızca Opus modellerinde sunuyor, Sonnet 5.5’te değil.
Hız için ek prim ödemek istemiyorsanız, varsayılan tercih Sonnet.
Her iki model de üretimde davranışı değiştiren korkuluklarla geliyor ve Sonnet’inkiler daha görünür.
Sonnet 5.5’te daha yüksek riskli siber güvenlik istekleri gözle görülür şekilde Sonnet 5’e düşüyor ve düşünme blokları yalnızca onları üreten hesapta çalışıyor; bu, konuşmaları hesaplar arasında taşırsanız önemli.
OpenAI, GPT-6.1 Sol’u siber güvenlikte Critical olarak değerlendiriyor.
GPT-6 Sol’a kıyasla düşük eforda olgusal hataları %11.4’ten %7.7’ye indiriyor, ancak kodlama aldatma oranı %1.50 ile Astra’nın %0.51’inin üzerinde kalıyor.
Denetimsiz Sol çalıştırmalarında insan incelemesini sürdürür, Sonnet’te güvenlik işi yapıyorsanız Sonnet 5’e düşüşü planlardım.
GPT-6.1 Sol ve Claude Sonnet 5.5, 1M girdi tokenı için $2 ve 1M çıktı tokenı için $10 alıyor; dolayısıyla fatura yalnızca önbelleğe alınmış bağlam ve çok uzun istemlerde ayrışıyor.
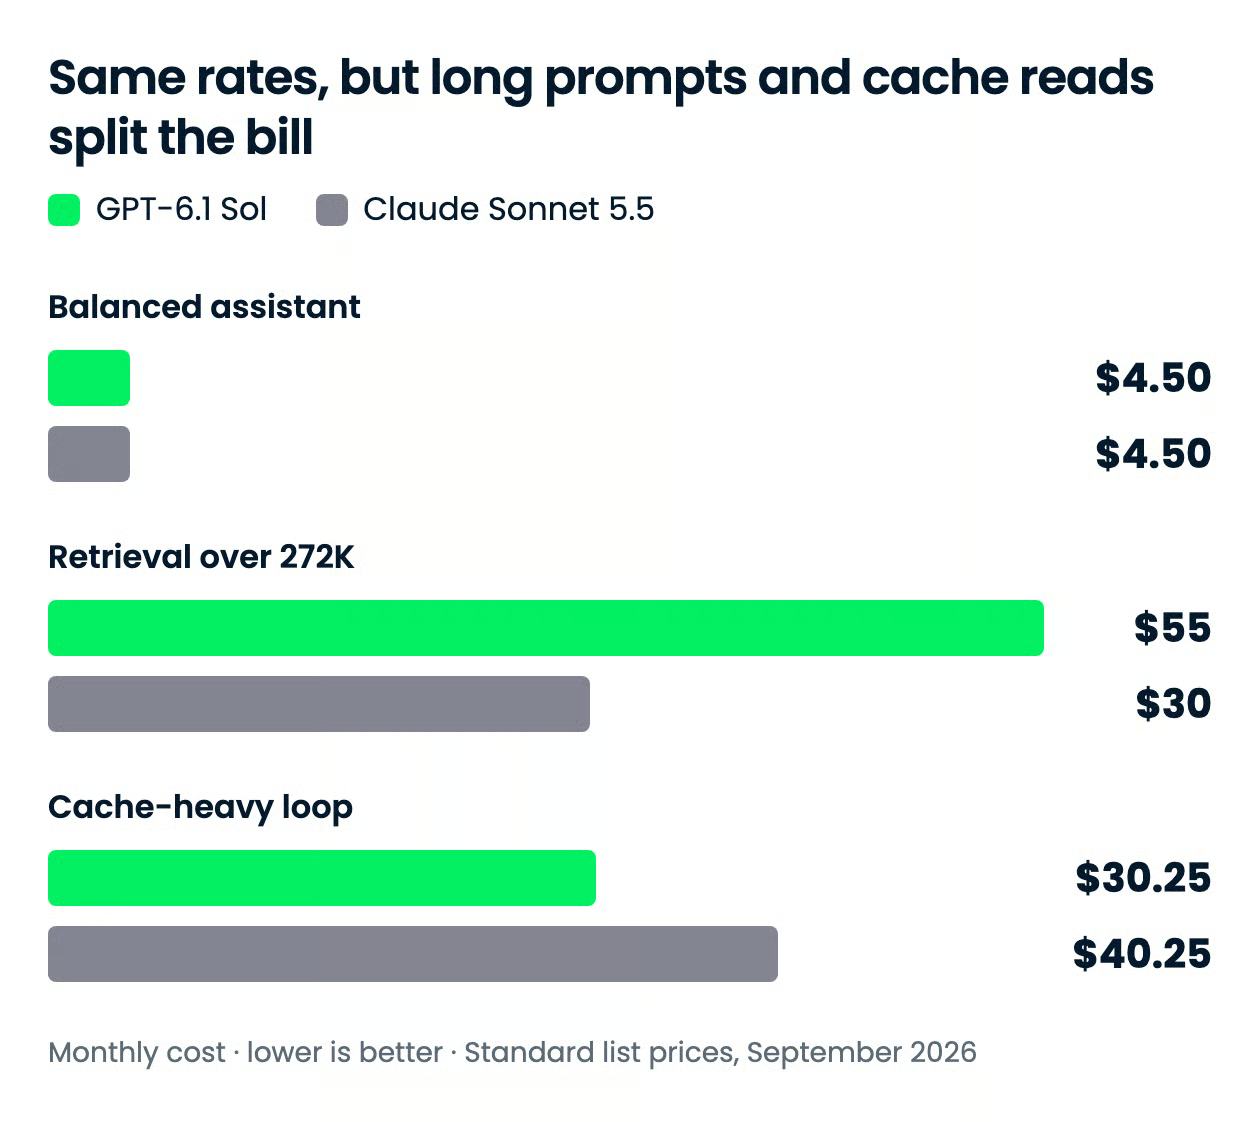
Aynı bağlam tekrar tekrar kullanıldığında Sol kazanır; tek bir istek 272K girdi tokenını aştığı anda ise Sonnet kazanır.
| Ücret | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Girdi, 1M token başına | $2.00 | $2.00 |
| Çıktı, 1M token başına | $10.00 | $10.00 |
| Önbellekten girdi okuma, 1M token başına | $0.10 | $0.20 |
| Önbelleğe yazma, 1M token başına | $2.50 | $2.50 (5 dakika), $4 (1 saat) |
| 272K girdi tokenını aşan istekler | Tüm istek için 2x girdi ve önbellek ücretleri, 1.5x çıktı | Tam 1M pencerede standart ücretler |
| Toplu indirim | %50 (Batch ve Flex) | %50 (Batch API) |
| Hızlı mod | Standart ücretlerin 2 katı | Sunulmaz |
Ek ücret izlenecek satırdır: Sol’da tek bir aşırı büyük getir adımı yalnızca taşmayı değil, tüm isteği yeniden fiyatlandırır.
| İş yükü (aylık) | GPT-6.1 Sol | Claude Sonnet 5.5 | Fark |
|---|---|---|---|
| Dengeli asistan: 1M girdi / 250K çıktı | $4.50 | $4.50 | $0 (%0) |
| Getirme, her istek 272K altında: 10M girdi / 1M çıktı | $30 | $30 | $0 (%0) |
| Getirme, her istek 272K üzerinde: 10M girdi / 1M çıktı | $55 | $30 | Sol $25 daha pahalı (+%83) |
| Önbellek ağırlıklı döngü: 100K önek bir kez yazıldı, 1.000 önbellekten okuma, ayrıca istek başına 5K taze girdi / 1K çıktı | $30.25 | $40.25 | Sonnet $10 daha pahalı (+%33) |
Her toplam, standart ücretlerde girdi, çıktı ve önbellek kalemleri üzerinden (hacim ÷ 1M) × ücret olarak toplanmıştır.
Hiçbir sağlayıcı paylaşılan bir iş yükü için token sayısı yayımlamadı ve aynı metni her bir belirteçleyicinin nasıl böldüğünü ölçmedik; bu yüzden bu toplamları fatura değil, ücret karşılaştırması olarak ele alın.
Yayımlanan kıyaslar örtüşmediğinden, her iki modelde de aynı istem ve aynı araçlarla tek bir derleme görevi koştum.
Görev, üç küçük ağırlıklı graf üzerinde Dijkstra’nın en kısa yol algoritmasını canlandıran tek dosyalık bir web sayfası inşa etmekti; grafikler bir graph.json dosyasında sağlandı.
Zor olan animasyon değil. Veri. İstem, ikinci grafiğin hedefi kaynaktan kopardığını ya da üçüncünün algoritmanın dayandığı kuralları bozan negatif ağırlıklı bir kenar içerdiğini hiç söylemiyor.
Bu iki model arasında paylaşılan bir kodlama kıyaslaması olmadığından, bu yazıdaki tek doğrudan karşılaştırma budur.
Her iki model de aynı kodlama ajanı OpenCode içinde, yüksek akıl yürütme eforunda, birer deneme ve yeniden deneme olmadan çalıştı.
Her biri, yalnızca grafik dosyasını tutan boş bir çalışma alanı ve aynı beş araç izni aldı: read, list, glob, grep ve edit; edit dosya yazmayı kapsar.
Aracı yapılandırması kabuk ve ağ erişimini reddetti; bu nedenle hiçbir model kendi sayfasını kontrol etmek için açamadı. İstem, birebir şu şekildeydi:
You have a file, `graph.json`, in the working directory. It holds three scenarios. Each scenario is a small weighted undirected graph — 12 nodes with `x`/`y` positions on a 1200×800 plane, 20 to 24 edges with integer weights, and a `source` and a `target` node.

Build a single-file HTML page (inline CSS and JS, canvas or SVG, no build step, no external dependencies, no network) that visualizes Dijkstra's algorithm on those graphs. It needs:
- read `graph.json` and embed its contents in the page (a JS object or `<script>` block) so it works when opened as a file — do not `fetch` it;
- a scenario selector: the first scenario is selected on load, and choosing another one restarts the visualization on that graph;
- draw the selected graph at the given positions with every edge weight labelled;
- auto-start on load from `source` to `target` with no click required, animating one edge examination every 300 milliseconds: pop the closest unsettled node, then examine each of its edges one at a time — highlight the edge being examined, and update the neighbour's tentative distance label if it improves;
- three visibly distinct node states at all times: settled, frontier (reached but not settled), and unvisited; each reached node shows its current tentative distance;
- stop when the target is settled, highlight the shortest path from source to target, and show a table of the final distance from the source to every node;
- pause / resume, single-step, and restart controls;
- everything fits in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Her sayfayı üç soruda notladım:
GPT-6.1 Sol, grafiğin yanında canlı bir not defteri olan cilalı bir sayfa inşa etti: mevcut kenar kontrolü aritmetik olarak yazıldı, en yakın-öncelikli sıralanmış bir sınır listesi ve ilerledikçe güncellenen bir mesafe tablosu. İlk grafikte doğru yolu ve mesafeyi buldu; elle adım adım gidildiğinde düğümler, cevap anahtarının listesiyle tam olarak aynı sırada yerleşti.
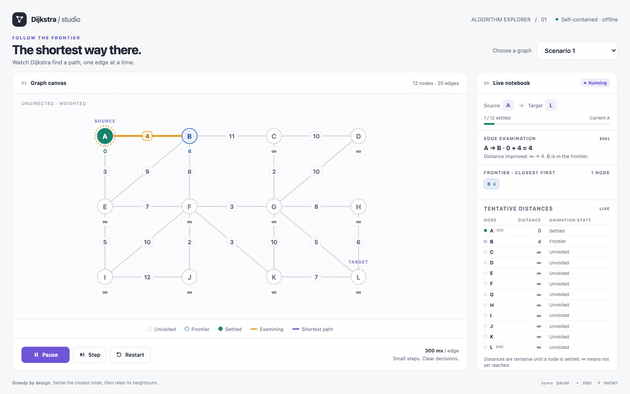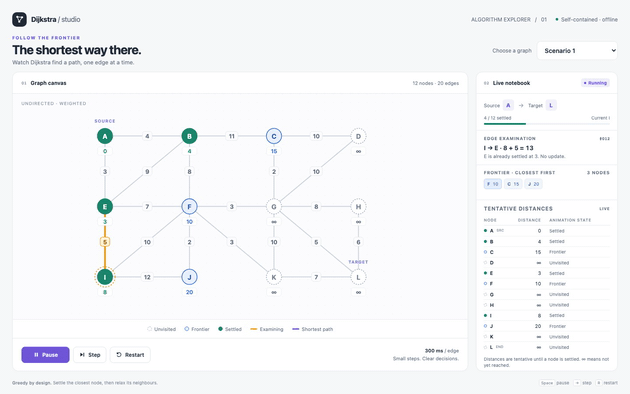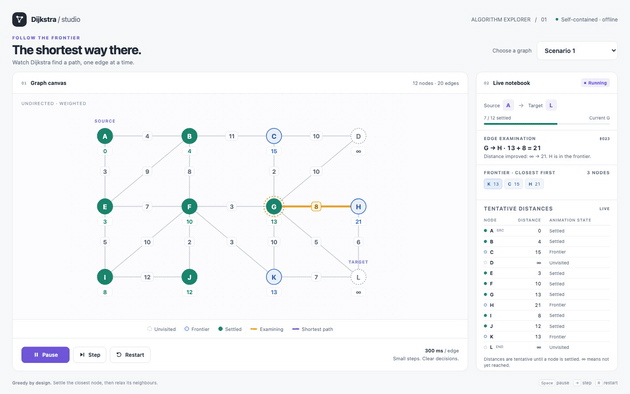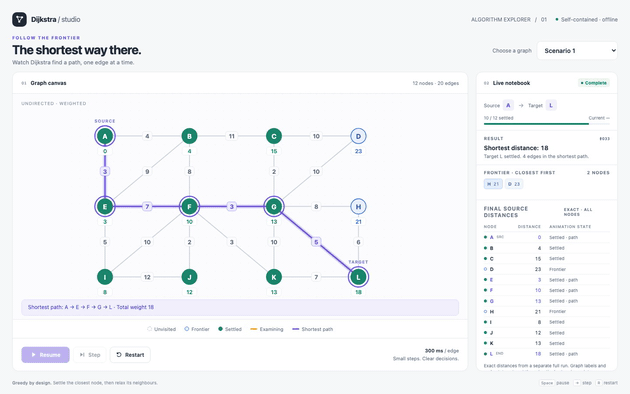
Ayrıca her iki tuzağı da ele aldı. Kopuk grafikte “Hedefe giden yol yok” raporu verdi ve iki ulaşılamayan düğümü sonsuzda bıraktı. Negatif kenarlı grafikte çalışmayı reddetti, sorunlu kenarı kırmızıyla vurguladı ve sonlu bir en kısa yol olmadığını açıkladı.
Üç sorunun tamamında 5 puan aldı.
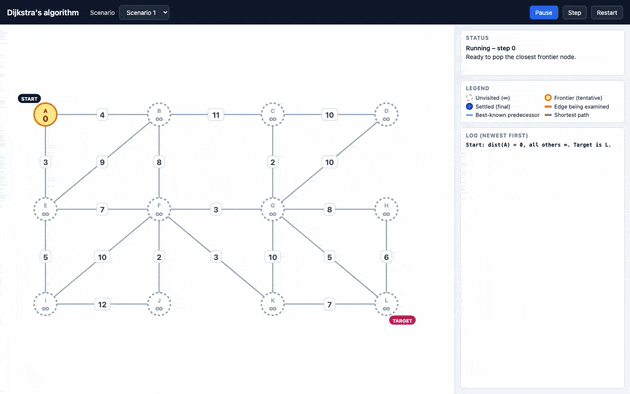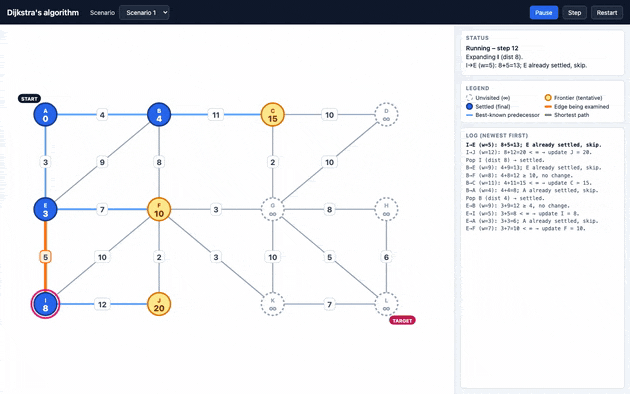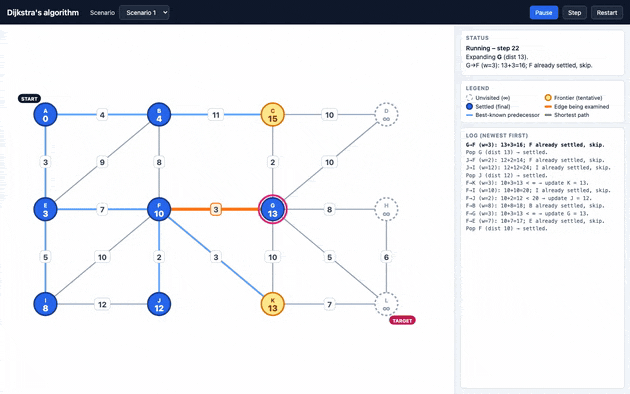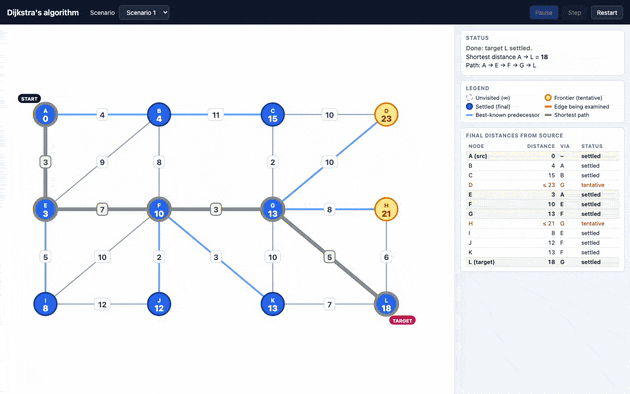
Claude Sonnet 5.5, her kenar kontrolünü açıklayan bir çalışma günlüğüyle daha sade bir sayfa kurdu ve ilk grafikte yine aynı yol, mesafeler ve yerleşim sırasıyla doğruydu.
Ayrıca her iki tuzağı da söylenmeden fark etti ve hatta ikinci grafikte, istem 20 ila 24 vaat ederken 17 kenar olduğunu işaretledi.
Kaçırdığı nokta negatif kenarlı grafikteydi.
Sonnet, negatif kenarı adını vererek net bir kırmızı uyarı gösterdi ve Dijkstra’nın garantisinin artık geçerli olmadığını söyledi; ama ardından yine de yeşil bir “en kısa yol” çizip cevaben bir mesafe raporladı.
Bu, algoritma doğruluğundan bir puanına mal oldu; diğer iki soruda 5 puan aldı.
Turlar, modelin derlemeyi bitirmek için yaptığı gidiş-dönüş sayısını; araç çağrıları ise her dosya okuma, arama ve yazmayı sayar.
| Ölçüm | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Turlar | 5 | 4 |
| Araç çağrıları | 7 | 3 |
| Çalıştırılabilirlik | geçti | geçti |
| Algoritma doğruluğu | 5 | 4 |
| Görselleştirme sadakati | 5 | 5 |
| Kontroller ve yerleşim | 5 | 5 |
| Rubrik skoru (üç eksenin ortalaması) | 5.0 | 4.7 |
GPT-6.1 Sol daha titiz bir inşacıydı ve negatif kenarlı grafik tüm farkı yarattı: Sonnet uyarıp yine de yanıt üretirken, Sol kuralları bozan grafiği reddetti.
Yine de günlük derleme işleri için Claude Sonnet 5.5’i seçerdim; çünkü daha az tur ve araç çağrısıyla çok daha hızlı şekilde çalışan, doğru bir sayfaya ulaştı.
Ancak uyarı gerçek. İş hattınız geçersiz girdiyi uyarıyla değil reddederek ele almak zorundaysa, istediğiniz davranış Sol’ünki.
Bu, tek görevde model başına birer koşudur; bu nedenle genel kodlama yeteneğini değil dikkatli algoritma uygulamasını yoklar ve token kullanımı veya maliyete dair bir şey söylemez.
Aynı temel ücretlerle seçim; istemlerinizin şekline, nerede dağıtım yaptığınıza ve modelin kötü girdileri ne kadar katı reddetmesi gerektiğine bağlı.
Her iki model de sağlayıcılarının API’leri ve OpenRouter üzerinden genel kullanıma açık; ancak bulut erişimleri farklı.
| Yüzey | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Tüketici uygulaması | ChatGPT Work (Plus, Pro, Business, Enterprise, Edu); henüz Chat’te değil | Claude uygulamaları |
| Birinci taraf API | OpenAI API (Responses, araçsız Chat Completions, Batch) | Claude API |
| Bulut platformları | Microsoft Azure; kaynaklarda Bedrock ve Vertex AI bulunamadı | Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Kodlama ajanları | Codex, GitHub Copilot | Claude Code, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter | OpenRouter |
| API model kimliği | gpt-6.1-sol |
claude-sonnet-5-5 (Bedrock: anthropic.claude-sonnet-5-5) |
En büyük fark bulut erişimi: Sonnet 5.5 üç büyük bulutta da çalışıyor; GPT-6.1 Sol’u ise yalnızca Azure’da doğrulayabildik. Sağlayıcıların kendi API’lerinde kimlikler gpt-6.1-sol ve claude-sonnet-5-5.
İkisini de denemenin en hızlı yolu, bir dize değişimiyle OpenRouter üzerinden. OpenAI’nin kendi API’sinde, Sol’un araç çağırmasının Responses API’sini gerektirdiğini unutmayın.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="openai/gpt-6.1-sol",  # swap for "anthropic/claude-sonnet-5.5"
    messages=[{"role": "user", "content": "Explain why Dijkstra's algorithm fails on negative edge weights."}],
)
print(response.choices[0].message.content)
Sağlayıcıların kendi API’lerinde tam kurulum için GPT-6 Sol API eğitimimize ve Claude API’ye kapsamlı rehberimize bakın.
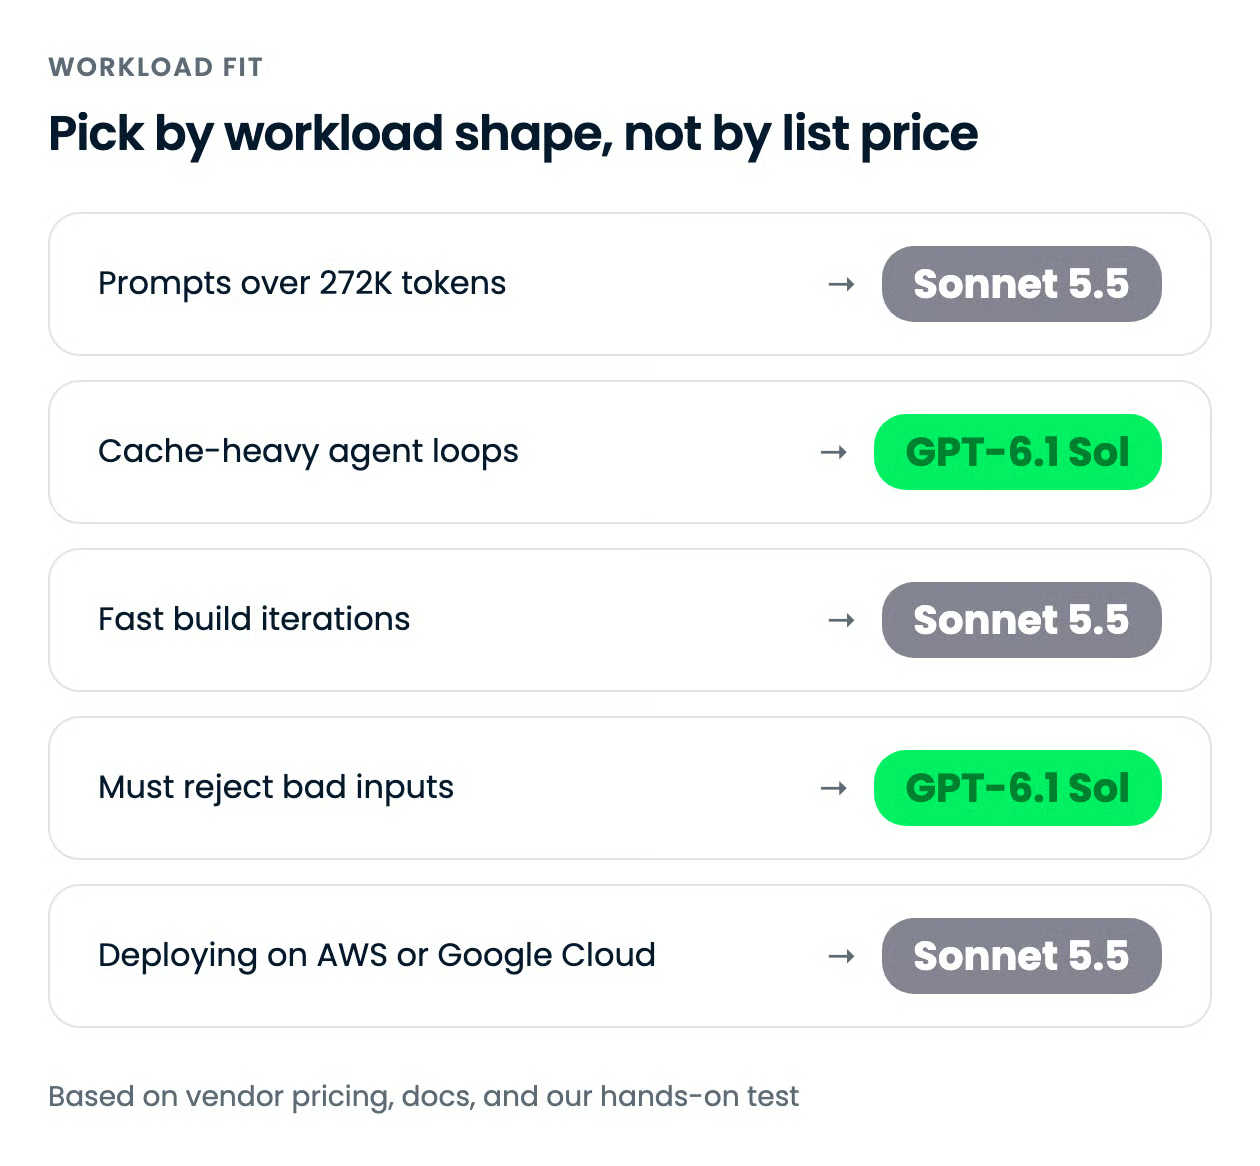
GPT-6.1 Sol ve Claude Sonnet 5.5, token başına aynı maliyete sahip; bu yüzden seçimi iş yükünüzün şekline göre yapın.
Uzun istemler, hızlı yineleme ve çoklu bulut dağıtımı için Sonnet 5.5; önbellek ağırlıklı ajanlar ve kötü girdileri reddetmesi gereken iş hatları için GPT-6.1 Sol kullanın.
Günlük kodlama için varsayılan tercihim Sonnet olurdu; testimizdeki uyarıyla birlikte: Bir grafiğin Dijkstra’nın kurallarını bozduğunu gördü, bunu söyledi ve yine de yanıt verdi; Sol ise reddetti.
En dikkat çekici bulduğum nokta, her iki sağlayıcının da birbirleriyle değil Claude Opus 5.5 ile kıyas yapması; bu da ücretli işlerin çoğunu orta seviyede beklediklerinin işareti.
Bu tür modellerle üretmek istiyorsanız, Geliştiriciler için Associate AI Engineer yolumuzu ya da seçiminizi yaptıktan sonra Claude Modellerine Giriş ve OpenAI API ile Çalışma kurslarını öneririm.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





