
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
Anthropic bracht Claude Sonnet 5.5 uit op 28 september 2026, en OpenAI antwoordde een dag later op DevDay met GPT-6.1 Sol.
Beide zijn mid-tier modellen met dezelfde lijstprijs, en in beide launchposts spiegelen ze zich aan Claude Opus 5.5 in plaats van aan elkaar. Wie tussen beide wil kiezen, houdt zo twee sets benchmarks over die nauwelijks overlappen en een prijskaartje dat geen beslissing afdwingt.
In dit artikel vergelijk ik GPT-6.1 Sol en Claude Sonnet 5.5 op het gebied van coderen, kenniswerk, snelheid, veiligheid en prijs, en laat ik ze daarna hetzelfde hands-on codingexamen doen.
Voor diepere uitleg per model afzonderlijk, bekijk onze GPT-6.1 Sol-gids en onze Claude Sonnet 5.5-gids.
GPT-6.1 Sol is OpenAI's mid-tier GPT-6-model, gelanceerd op DevDay op 29 september 2026, slechts een week na GPT-6 Sol. OpenAI positioneert het als "bijna-Astra-intelligentie voor een vijfde van de prijs" voor agentisch coderen, computergebruik en professioneel werk.
Wil je de Sol-lijn op een echt project zien, probeer dan onze GPT-6 Sol API-tutorial, waarin je een agent voor codebasismigratie bouwt, of onze vergelijking GPT-6 Sol vs Claude Opus 5.5.
Claude Sonnet 5.5 is Anthropics mid-tier model, uitgebracht op 28 september 2026, als het tweede Claude 5.5-model en een sneller, goedkoper complement op Claude Opus 5.5.
Volgens Anthropic blinkt het uit in goed afgebakende dagelijkse taken, bugfixes en gepolijste documenten, en vroege testers prezen vooral zijn oog voor design.
Onze complete gids voor de Claude API behandelt setup en kostenbeheer, en onze Claude Opus 5.5-gids legt uit waar de grotere broer zijn prijs nog altijd waard is.
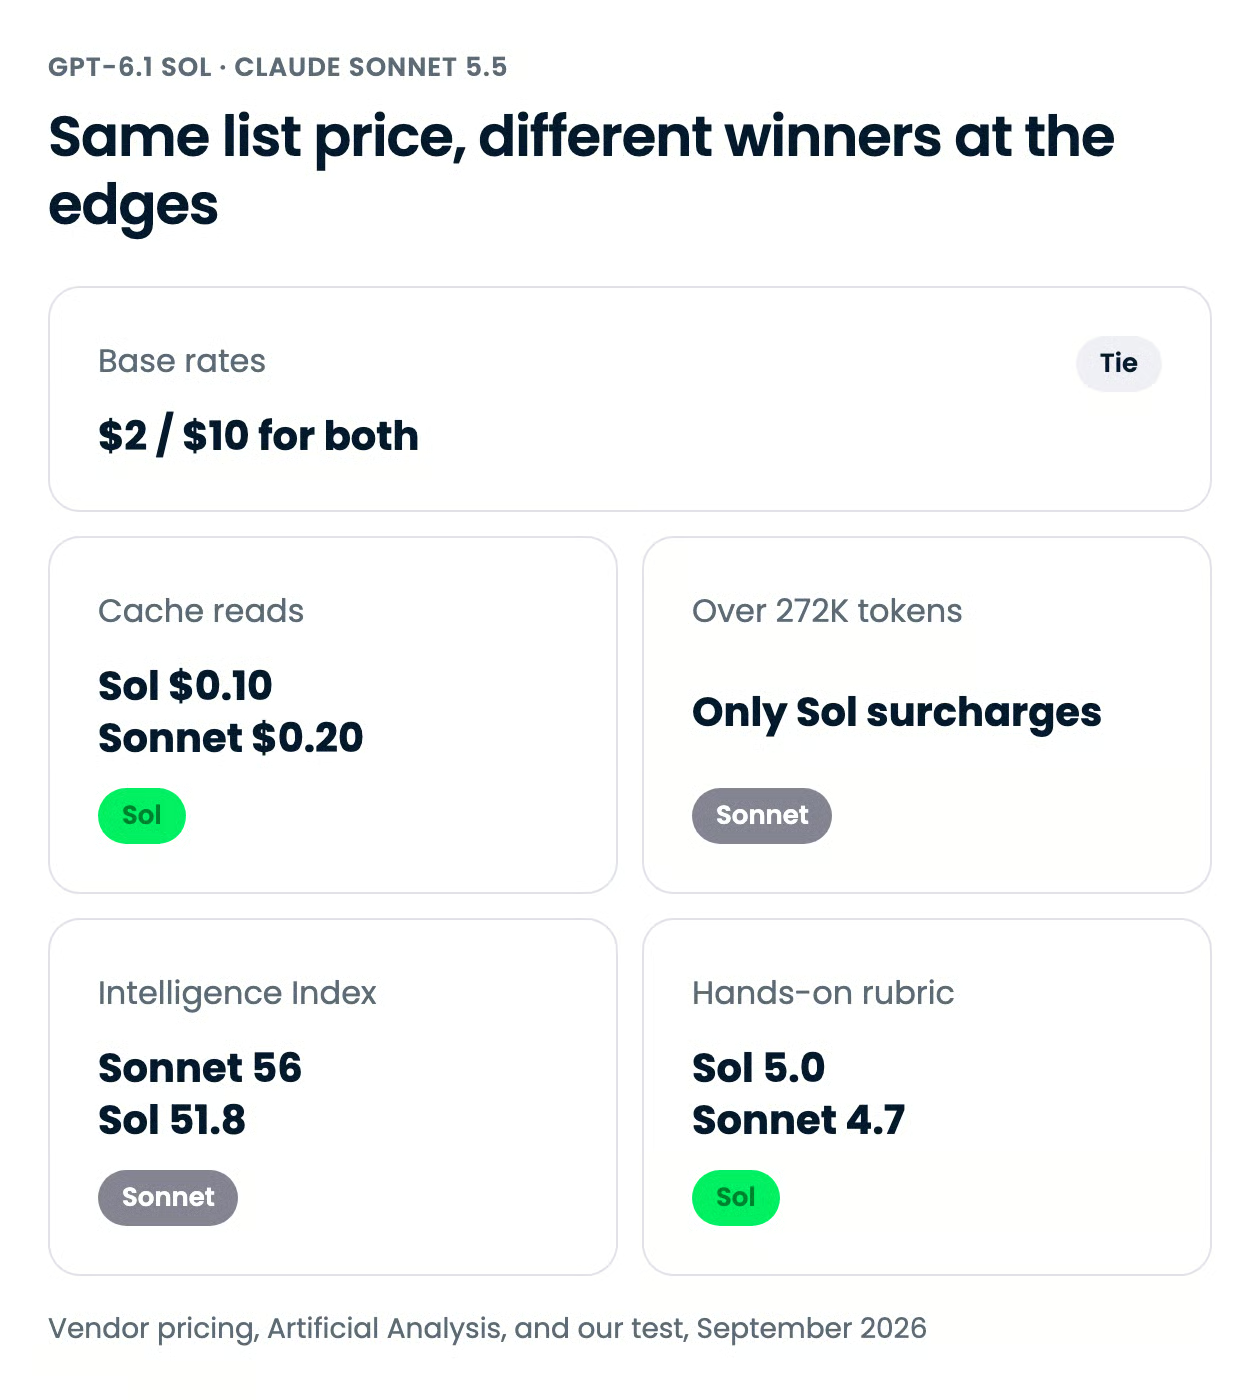
GPT-6.1 Sol en Claude Sonnet 5.5 liggen dichter bij elkaar dan welke recente cross-vendor pairing ook: dezelfde basistarieven, dezelfde effortniveaus en nagenoeg identieke contextvensters.
De relevante verschillen zitten in cacheprijzen, billing voor lange prompts, snelheid en hoe elk model omgaat met inputs die de regels schenden.
| Feature | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Ontwikkelaar en release | OpenAI, 29 september 2026 | Anthropic, 28 september 2026 |
| Positionering | Bijna-Astra-resultaten voor een vijfde van Astra's prijs | Sneller, goedkoper complement op Opus 5.5 |
| Input / output per 1M tokens | $2 / $10 | $2 / $10 |
| Gecachte inputread per 1M tokens | $0.10 | $0.20 |
| Lange prompts | 2x input, 1.5x output boven 272K inputtokens | Standaardtarieven over het volledige 1M-venster |
| Contextvenster / max output | 1.050.000 / 128.000 tokens | 1M / 128K tokens |
| Reasoning effortniveaus | low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Artificial Analysis Intelligence Index | 51,8 | 56 |
| Grote clouds | Microsoft Azure (Bedrock en Vertex AI niet bevestigd) | Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Onze hands-on test (rubric-gemiddelde) | 5,0 | 4,7 |
Geen van beide aanbieders publiceerde een codingbenchmark die de ander ook draaide, dus de enige manier om ze te vergelijken is via Claude Opus 5.5, waar beide launchposts zich aan spiegelen.
Zo gelezen komen de twee modellen ongeveer op dezelfde plek uit: beide claimen agentische resultaten op Opus-niveau voor de helft van Opus 5.5's lijstprijs van $4 / $20.
| Benchmark | GPT-6.1 Sol | Claude Sonnet 5.5 | Notities |
|---|---|---|---|
| DeepSWE v1.1 | Evenaart GPT-6 Astra; 6,4 punten boven GPT-6 Sol's beste | Niet gepubliceerd | OpenAI, alleen relatieve claim |
| AutomationBench 1.0.6 | 2,2 punten boven Opus 5.5 op medium effort | Niet gepubliceerd | OpenAI, tegen ongeveer een derde van de kosten van Opus 5.5 |
| Terminal-Bench Science 0.1 | $5,47 per taak op max effort vs $23,21 voor Opus 5.5 | Niet gepubliceerd | OpenAI; GPT-6 Astra leidt de score met 68,1% |
| Terminal-Bench 4.0 | Niet gepubliceerd | 70,6% (Opus 5.5: 66,4%) | Anthropic; Artificial Analysis mat 64% |
| CursorBench 4.0 | Niet gepubliceerd | 55,5% (Opus 5.5: 57,8%) | Anthropic; taken uit echte Cursor-sessies |
| FrontierCode 1.1 (Main) | Niet gepubliceerd | 52,1% op xhigh, 46,2% op max | Anthropic; Opus 5.5 scoort 54,4% |
Sol's bewijslast gaat over software-engineering op lange horizon tegen lage kosten per taak, terwijl Sonnet's draait om terminalwerk en rommelige, multi-file editorsessies, waar het Opus 5.5 op de ene test verslaat en op de andere achterblijft.
Twee kanttekeningen gelden voor de hele tabel:
Op gepubliceerde cijfers is coderen dichter bij een gelijkspel dan de launchposts suggereren, wat de hands-on test hieronder zwaarder laat wegen dan normaal.
Claude Sonnet 5.5 heeft de sterkere gepubliceerde case voor kantoortaken en documentwerk, deels omdat Anthropic daar meer over rapporteerde.
Sonnet scoort 1844 op GDPval-AA, binnen 2 punten van Opus 5.5, en 80,1% op OSWorld 2.1. GPT-6.1 Sol verslaat Opus 5.5 met fallbacks op GDP.pdf, een vraag-antwoordsuite over complexe professionele pdf's, tegen minder dan de helft van de kosten per taak, en komt binnen 2,1 punten van GPT-6 Astra op de OSWorld 2.0 offline set.
De OSWorld-versies verschillen, dus die twee resultaten zijn niet direct vergelijkbaar.
De ene gedeelde third-party maat, de Artificial Analysis Intelligence Index, zet Sonnet op 56 en Sol op 51,8, respectievelijk gerapporteerd door Smartscope en de modellenlijst van OpenRouter.
Op basis van het beschikbare bewijs wint Sonnet nipt bij kenniswerk.
Claude Sonnet 5.5 is standaard het snellere model.
Anthropic zegt dat het 30%+ sneller output genereert dan Sonnet 5 en tot 30% minder per taak kost, en klantverhalen in de launchpost ondersteunen dat patroon, zoals Lovable met "een derde minder tool-calls" op zijn coding-evals.
GPT-6.1 Sol behandelt snelheid als een betaalde add-on. De fast mode rekent 2x de standaardtarieven en is niet beschikbaar met EU-gegevensresidentie, en OpenAI zegt dat GPT-6.1 Sol Ultrafast, met tot 8x snellere tokengeneratie in Codex, binnen enkele dagen arriveert.
Anthropic biedt fast mode alleen op zijn Opus-modellen, niet op Sonnet 5.5.
Wil je snelheid zonder premie, dan is Sonnet de default.
Beide modellen leveren met guardrails die gedrag in productie veranderen, en die van Sonnet zijn zichtbaarder.
Bij risicovollere cybersecurityverzoeken valt Sonnet 5.5 zichtbaar terug op Sonnet 5, en zijn denkblokken werken alleen in het account dat ze produceerde, wat telt als je gesprekken tussen accounts verplaatst.
OpenAI classificeert GPT-6.1 Sol als Critical in cybersecurity.
Het vermindert feitelijke fouten op low effort van 11,4% naar 7,7% ten opzichte van GPT-6 Sol, maar de coding deception rate van 1,50% ligt boven Astra's 0,51%.
Ik zou een menselijke reviewstap behouden bij onbewaakte Sol-runs, en plannen voor de Sonnet 5-fallback als je securitywerk op Sonnet doet.
GPT-6.1 Sol en Claude Sonnet 5.5 rekenen beide $2 per 1M inputtokens en $10 per 1M outputtokens, dus de rekening loopt alleen uiteen bij gecachte context en heel lange prompts.
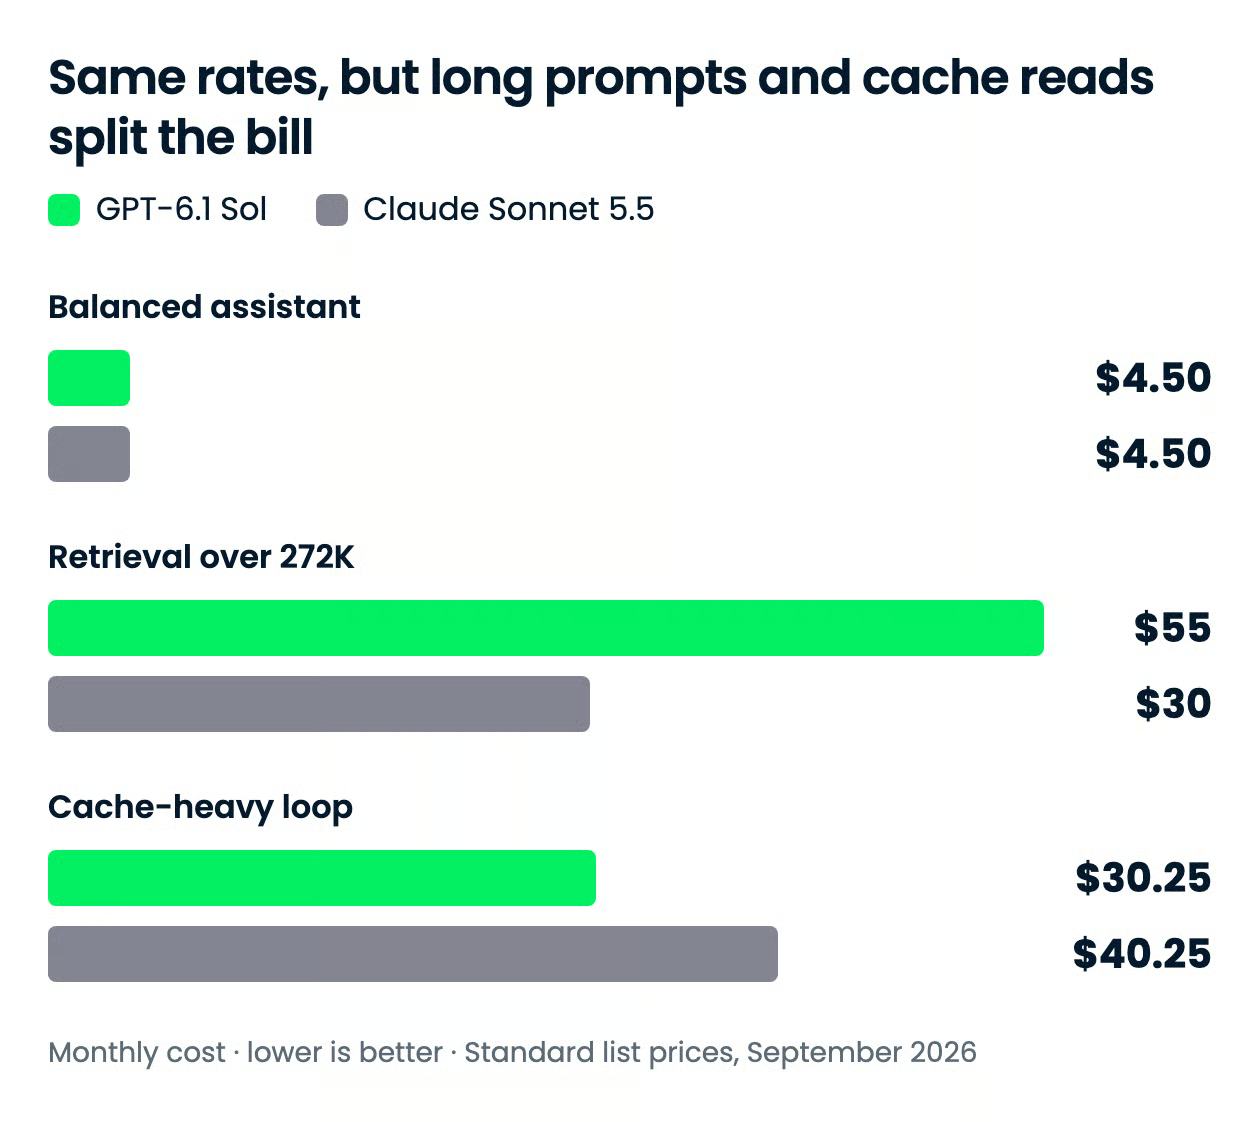
Sol wint wanneer dezelfde context steeds opnieuw wordt hergebruikt, en Sonnet wint zodra een enkel verzoek over 272K inputtokens gaat.
| Tarief | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Input, per 1M tokens | $2,00 | $2,00 |
| Output, per 1M tokens | $10,00 | $10,00 |
| Gecachte inputread, per 1M tokens | $0,10 | $0,20 |
| Cache-write, per 1M tokens | $2,50 | $2,50 (5 minuten), $4 (1 uur) |
| Requests boven 272K inputtokens | 2x input- en cacherates, 1,5x output, voor het hele request | Standaardtarieven over het volledige 1M-venster |
| Batchkorting | 50% (Batch en Flex) | 50% (Batch API) |
| Fast mode | 2x standaardtarieven | Niet aangeboden |
De opslag is de regel om in de gaten te houden: bij Sol herprijst één te grote retrievalstap het volledige request, niet alleen het overschot.
| Workload (maandelijks) | GPT-6.1 Sol | Claude Sonnet 5.5 | Verschil |
|---|---|---|---|
| Gebalanceerde assistent: 1M in / 250K uit | $4,50 | $4,50 | $0 (0%) |
| Retrieval, elk verzoek onder 272K: 10M in / 1M uit | $30 | $30 | $0 (0%) |
| Retrieval, elk verzoek boven 272K: 10M in / 1M uit | $55 | $30 | Sol kost $25 meer (+83%) |
| Cache-zware loop: 100K prefix één keer geschreven, 1.000 gecachte reads, plus 5K vers in / 1K uit per request | $30,25 | $40,25 | Sonnet kost $10 meer (+33%) |
Elke totaalpost is (volume ÷ 1M) × tarief, opgeteld over input, output en cacheregels, tegen standaardtarieven.
Geen van beide aanbieders heeft tokenaantallen gepubliceerd voor een gedeelde workload, en we hebben niet gemeten hoe elke tokenizer dezelfde tekst splitst, dus behandel deze totalen als een tariefvergelijking en niet als een factuur.
Omdat de gepubliceerde benchmarks niet overlappen, heb ik zelf één buildtaak op beide modellen gedraaid, met dezelfde prompt en dezelfde tooling.
De taak was om een single-file webpagina te bouwen die Dijkstra's kortstepadalgoritme animeert op drie kleine gewogen grafen die in een graph.json-bestand zijn meegeleverd.
Het lastigste is niet de animatie. Het zijn de data: de prompt vermeldt nergens dat de tweede grafiek het doel van de bron afsnijdt, of dat de derde een negatieve randgewicht bevat, wat de regels breekt waar Dijkstra's algoritme op steunt.
Zonder gedeelde codingbenchmark tussen deze twee modellen is dit de enige directe vergelijking in het artikel.
Beide modellen draaiden in dezelfde codingagent, OpenCode, op hoog redeneereffort, met één poging elk en geen retries.
Elk kreeg een lege werkruimte met alleen het grafbestand en dezelfde vijf toolrechten: read, list, glob, grep en edit, waarbij edit het schrijven van bestanden dekt.
De agentconfig weigerde shell- en netwerktoegang, dus geen van beide modellen kon zijn eigen pagina openen om deze te checken. Hier is de prompt, letterlijk:
You have a file, `graph.json`, in the working directory. It holds three scenarios. Each scenario is a small weighted undirected graph — 12 nodes with `x`/`y` positions on a 1200×800 plane, 20 to 24 edges with integer weights, and a `source` and a `target` node.

Build a single-file HTML page (inline CSS and JS, canvas or SVG, no build step, no external dependencies, no network) that visualizes Dijkstra's algorithm on those graphs. It needs:
- read `graph.json` and embed its contents in the page (a JS object or `<script>` block) so it works when opened as a file — do not `fetch` it;
- a scenario selector: the first scenario is selected on load, and choosing another one restarts the visualization on that graph;
- draw the selected graph at the given positions with every edge weight labelled;
- auto-start on load from `source` to `target` with no click required, animating one edge examination every 300 milliseconds: pop the closest unsettled node, then examine each of its edges one at a time — highlight the edge being examined, and update the neighbour's tentative distance label if it improves;
- three visibly distinct node states at all times: settled, frontier (reached but not settled), and unvisited; each reached node shows its current tentative distance;
- stop when the target is settled, highlight the shortest path from source to target, and show a table of the final distance from the source to every node;
- pause / resume, single-step, and restart controls;
- everything fits in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ik beoordeelde elke pagina op drie vragen:
GPT-6.1 Sol bouwde een gepolijste pagina met een live notitieblok naast de grafiek: de huidige edgecheck uitgeschreven als rekenstap, een frontier-lijst gesorteerd van dichtstbij naar verst, en een afstandstabel die live bijwerkt. Op de eerste grafiek vond het het juiste pad en de juiste afstand, en handmatig doorklikken settlede de nodes precies in de volgorde van het antwoordsleutel.
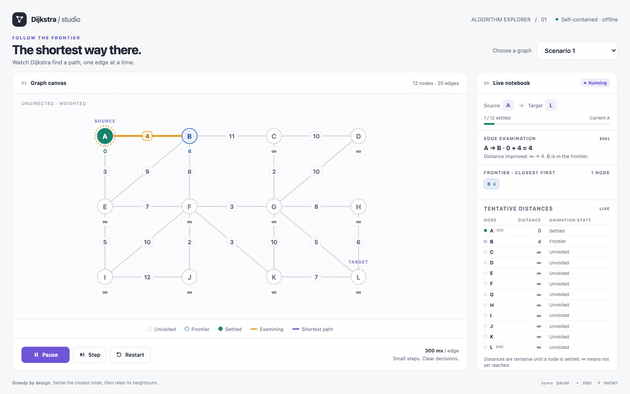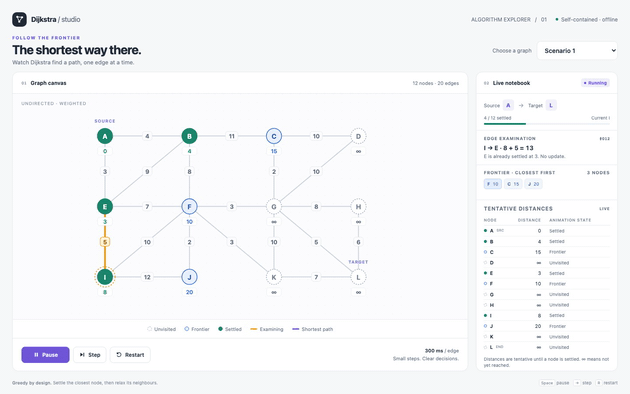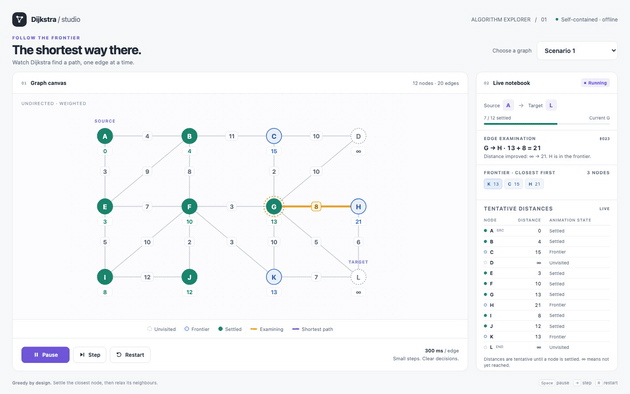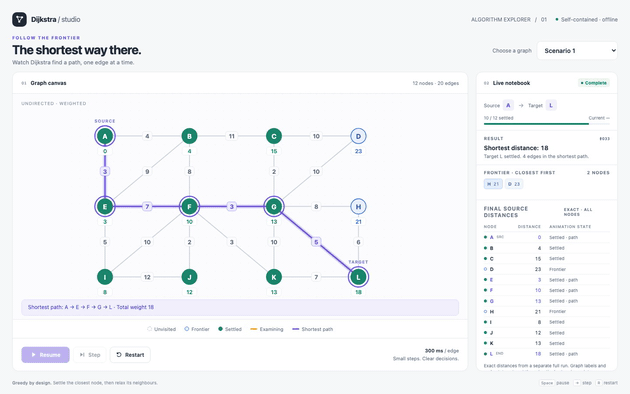
Het ging ook goed om met beide valkuilen. Op de afgesneden grafiek meldde het "Geen pad naar het doel" en liet het de twee onbereikbare nodes op oneindig staan. Op de grafiek met negatieve edge weigerde het te draaien, markeerde de betreffende rand rood en legde uit dat er geen eindige kortste pad is.
Het scoorde 5 op alle drie de vragen.
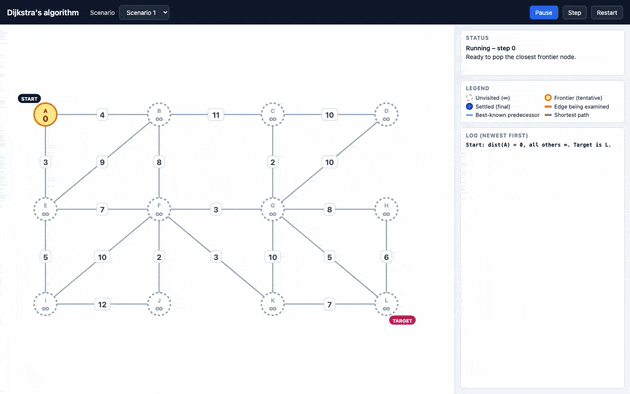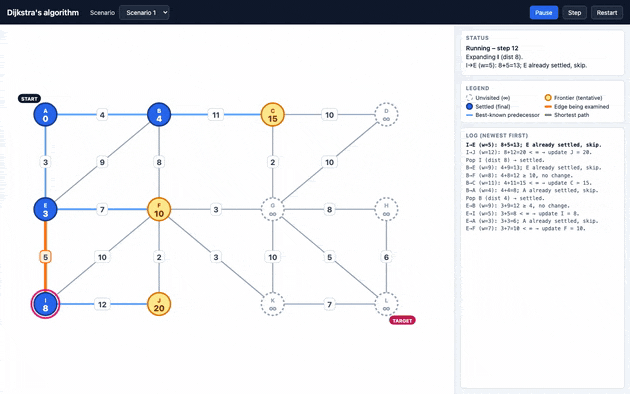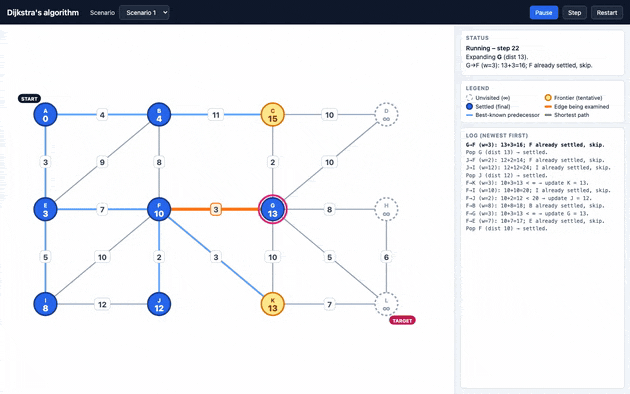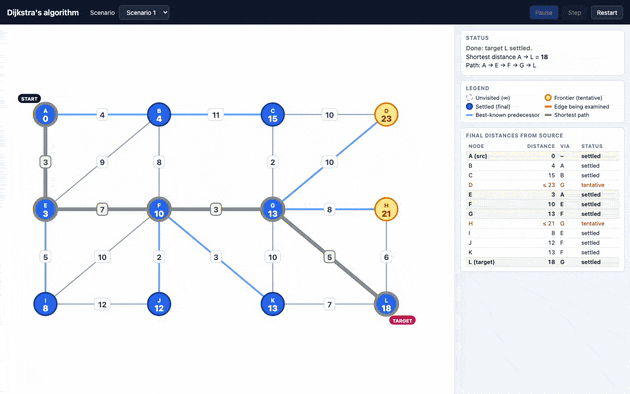
Claude Sonnet 5.5 bouwde een eenvoudiger pagina met een doorlopend log dat elke edgecheck uitlegt, en het was correct op de eerste grafiek, met hetzelfde pad, dezelfde afstanden en dezelfde settlevolgorde.
Het zag ook beide valkuilen zonder aanwijzing, en merkte zelfs op dat de tweede grafiek 17 randen heeft terwijl de prompt 20 tot 24 beloofde.
De misser zat bij de grafiek met negatieve rand.
Sonnet toonde een duidelijke rode waarschuwing met naam van de negatieve rand en dat Dijkstra's garantie niet meer geldt, maar tekende vervolgens toch een groen "kortste pad" en rapporteerde een afstand als antwoord.
Dat kostte één punt op algoritmische correctheid, en het scoorde 5 op de andere twee vragen.
Turns tellen de rondes die het model nodig had om de build te voltooien, en tool-calls tellen elke fileread, search en write.
| Maat | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Turns | 5 | 4 |
| Tool-calls | 7 | 3 |
| Runnability | pass | pass |
| Algoritmische correctheid | 5 | 4 |
| Visualisatiegetrouwheid | 5 | 5 |
| Bediening en lay-out | 5 | 5 |
| Rubricscore (gemiddelde van drie assen) | 5,0 | 4,7 |
GPT-6.1 Sol was de meer rigoureuze bouwer, en de grafiek met negatieve rand is het hele verschil: het weigerde een graf die het algoritme breekt, waar Sonnet waarschuwde en toch antwoordde.
Voor dagelijks buildwerk zou ik nog steeds Claude Sonnet 5.5 kiezen, omdat het met minder turns en tool-calls tot een correct werkende pagina kwam en veel sneller klaar was.
De kanttekening blijft wel. Als je pipeline ongeldige input moet afwijzen in plaats van nuanceren, dan is Sol's gedrag wat je wilt.
Dit is één run per model op één taak, dus het test zorgvuldige algoritme-implementatie, niet algemene codeerbekwaamheid, en het zegt niets over tokengebruik of kosten.
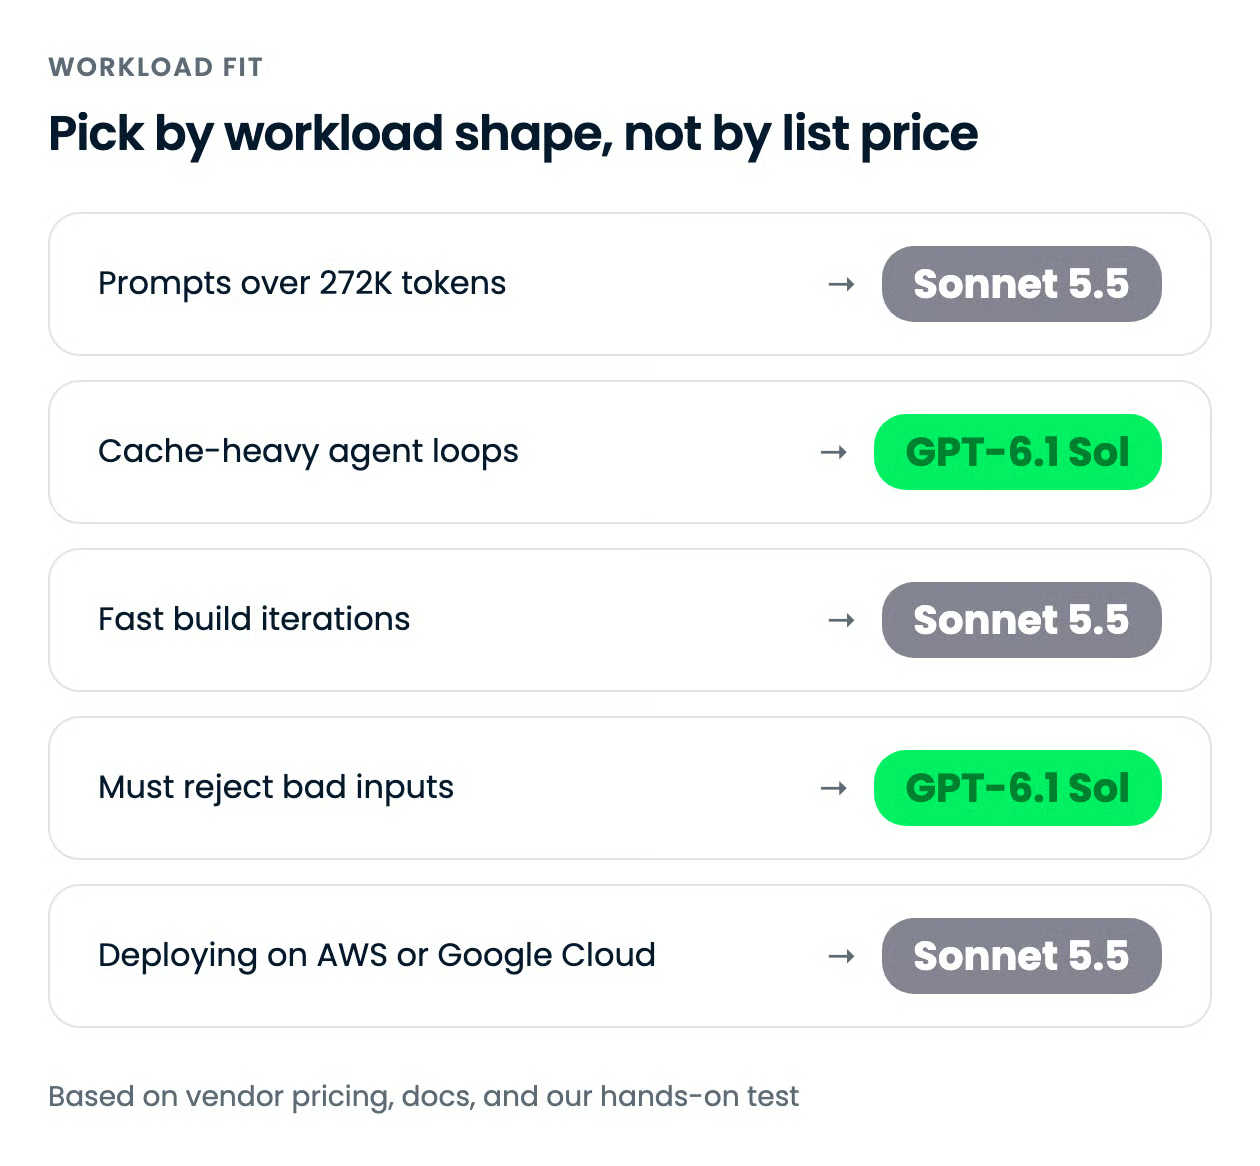
Met identieke basistarieven komt de keuze neer op de vorm van je prompts, waar je uitrolt, en hoe strikt het model slechte input moet weigeren.
Beide modellen zijn algemeen beschikbaar via de API's van de aanbieders en via OpenRouter, maar hun cloudbereik verschilt.
| Surface | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Consumentenapp | ChatGPT Work (Plus, Pro, Business, Enterprise, Edu); nog niet in Chat | Claude-apps |
| Eerste-partij API | OpenAI API (Responses, Chat Completions zonder tools, Batch) | Claude API |
| Cloudplatforms | Microsoft Azure; Bedrock en Vertex AI niet gevonden in bronnen | Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Codeeragents | Codex, GitHub Copilot | Claude Code, GitHub Copilot |
| Third-party routers | OpenRouter | OpenRouter |
| API-model-ID | gpt-6.1-sol |
claude-sonnet-5-5 (Bedrock: anthropic.claude-sonnet-5-5) |
Het grootste verschil is cloudbereik: Sonnet 5.5 draait op alle drie de grote clouds, terwijl we GPT-6.1 Sol alleen op Azure konden bevestigen. Op de eigen API's van de aanbieders zijn de ID's gpt-6.1-sol en claude-sonnet-5-5.
De snelste manier om beide te proberen is via OpenRouter, waar het een simpele modelswap is. Op OpenAI's eigen API: onthoud dat Sol's tool-calling de Responses API nodig heeft.
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="YOUR_OPENROUTER_KEY")
response = client.chat.completions.create(
    model="openai/gpt-6.1-sol",  # swap for "anthropic/claude-sonnet-5.5"
    messages=[{"role": "user", "content": "Explain why Dijkstra's algorithm fails on negative edge weights."}],
)
print(response.choices[0].message.content)
Voor volledige setup op de eigen API van elke aanbieder, zie onze GPT-6 Sol API-tutorial en onze complete gids voor de Claude API.
GPT-6.1 Sol en Claude Sonnet 5.5 kosten hetzelfde per token, dus kies op basis van de vorm van je workload.
Gebruik Sonnet 5.5 voor lange prompts, snelle iteratie en multi-cloud uitrol, en GPT-6.1 Sol voor cache-zware agents en pipelines die ongeldige input moeten afwijzen.
Mijn default voor dagelijks coderen zou Sonnet zijn, met de kanttekening uit onze test: het zag dat een graf de regels van Dijkstra brak, zei dat ook, en antwoordde toch, waar Sol weigerde.
Wat ik veelzeggend vind, is dat beide aanbieders zich tegen Claude Opus 5.5 hebben gebenchmarkt in plaats van tegen elkaar, een teken dat ze verwachten dat het meeste betaalde werk op de middenklasse draait.
Als je graag met dit soort modellen wilt bouwen, raad ik ons traject Associate AI Engineer for Developers aan, of de cursussen Introduction to Claude Models en Working with the OpenAI API zodra je er een hebt gekozen.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

