Program
AI Ajanının Temelleri
6 sa
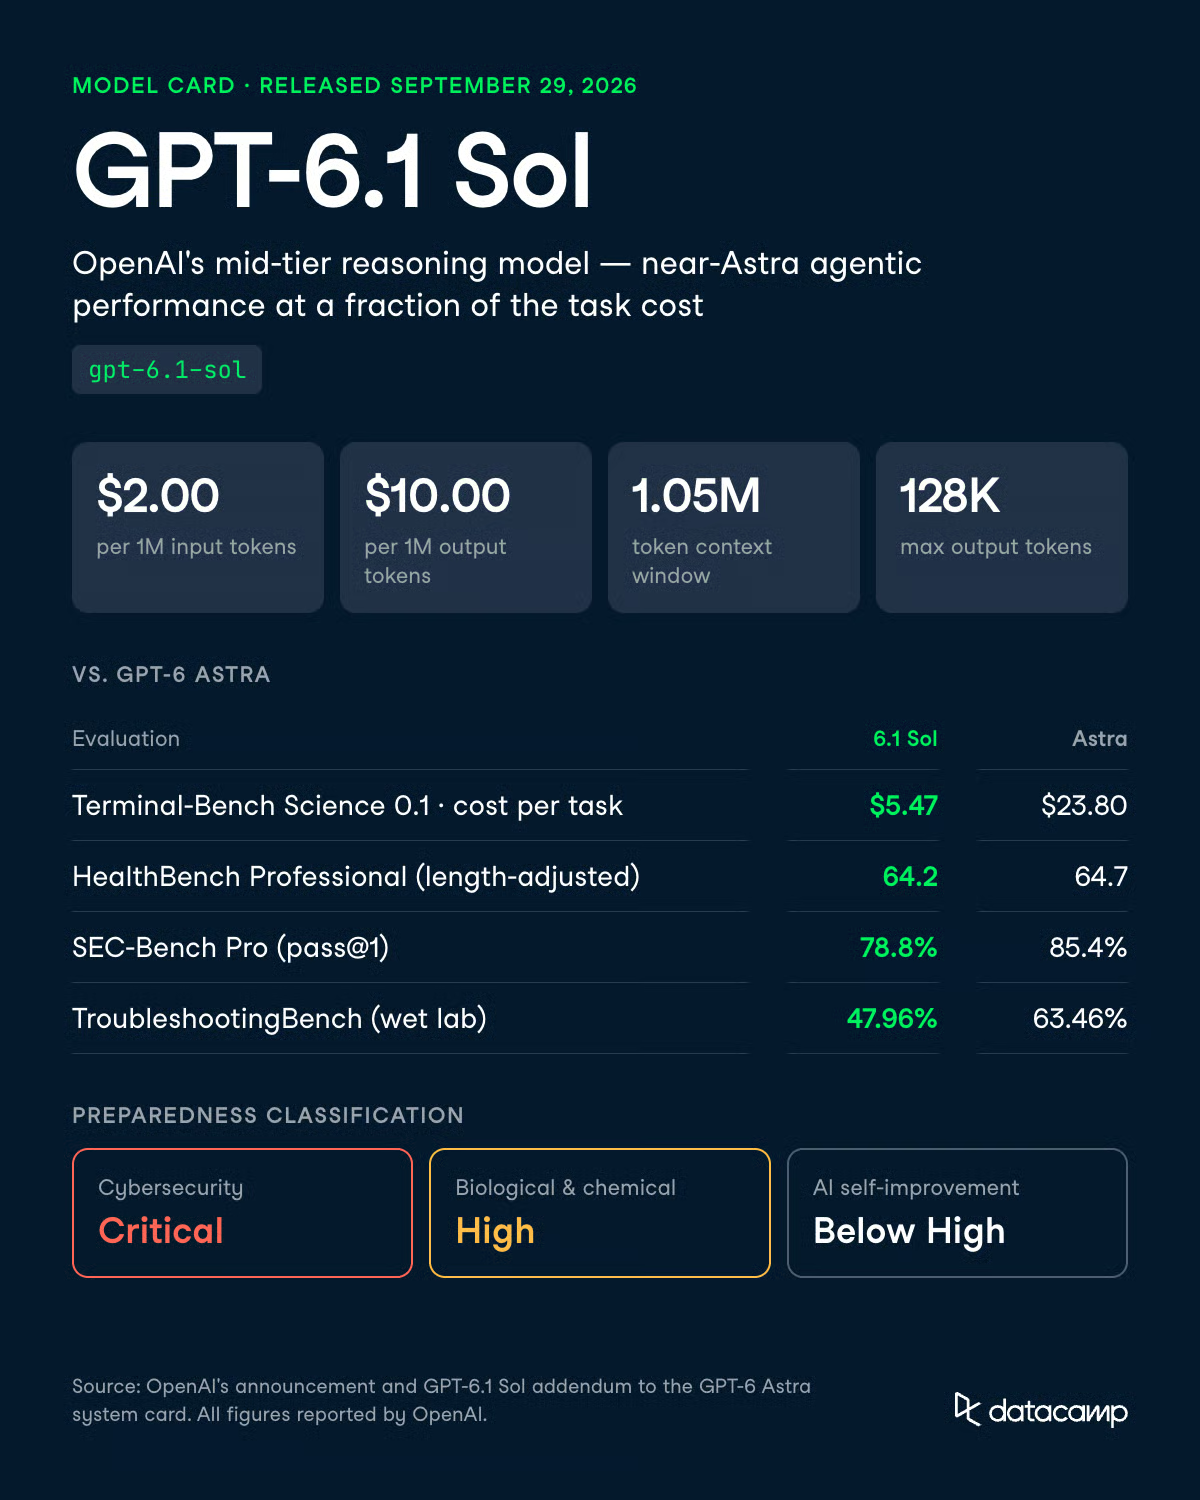
OpenAI, GPT-6 Sol’dan bir hafta ve GPT-6 Astra’dan 26 gün sonra, 29 Eylül 2026’da DevDay etkinliğinde GPT-6.1 Sol’u yayımladı.
Astra, Terminal-Bench Science 0.1’de maksimum çabayla görev başına ortalama 23,80 $ maliyet üretti ve bu da modeli rutin işler için pahalı hale getirdi. Sol, OpenAI’nin bu soruna yanıtı.
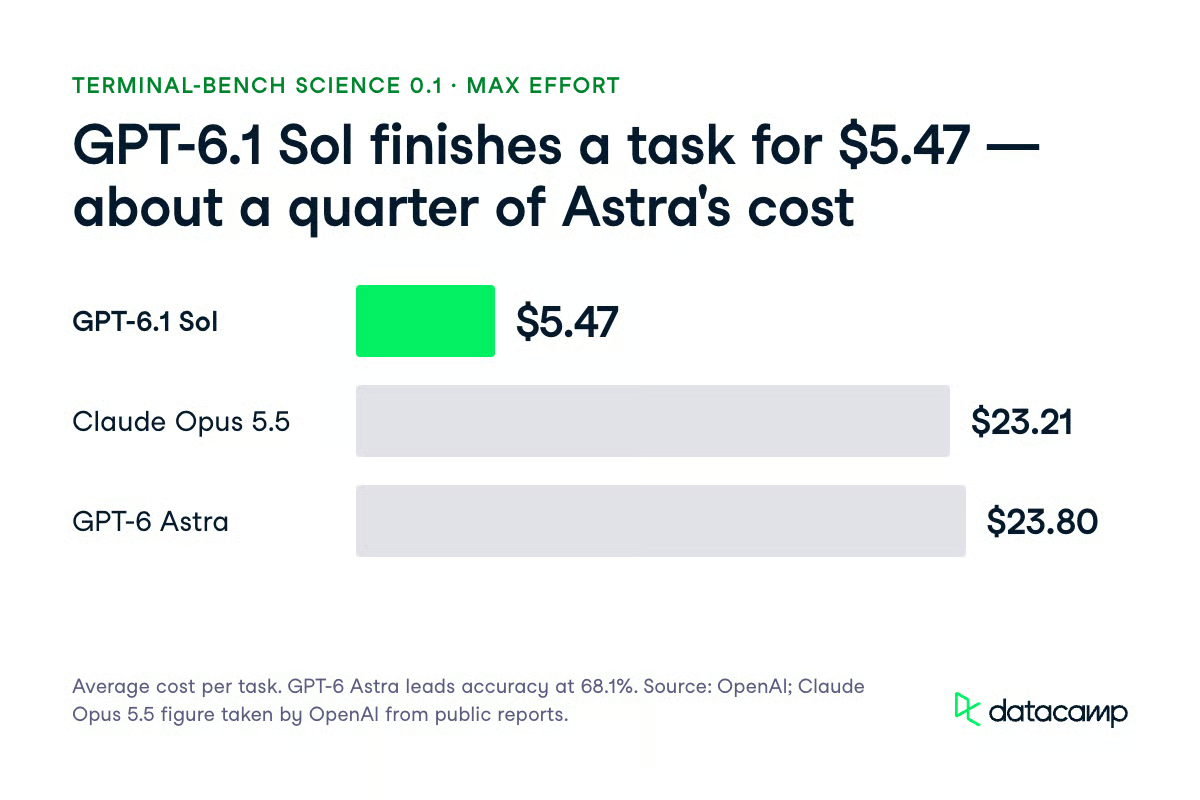
Öne çıkan rakamlar: 1M giriş belirteci başına 2,00 $, 1M çıkış belirteci başına 10,00 $, 1.050.000 belirteçlik bağlam penceresi ve 128.000 belirtece kadar maksimum çıktı. OpenAI’nin duyurusuna göre, GPT-6.1 Sol, DeepSWE v1.1’de Astra’yla aynı seviyeye, yaklaşık beşte bir maliyetle ulaşıyor; Anthropic’in Claude Opus 5.5 modelini AutomationBench’te orta çabada 2,2 puan geride bırakıyor ve Terminal-Bench Science 0.1’de görev başına 23,80 $’lık Astra’ya karşı 5,47 $’a mal oluyor.
Bu yazıda GPT-6.1 Sol’un yeniliklerini; özellikleri, kıyaslama sonuçları ve OpenAI’nin paylaştığı güvenlik verileriyle ele alacağım; GPT-6 ailesinde hangi katmana ne zaman başvurmanız gerektiğini ve maliyetlerini anlatacağım. Komşu modeller için daha derin inceleme isterseniz GPT-6 Sol API eğitimimize ve Claude Sonnet 5.5 rehberimize bakın.
none veya minimal akıl yürütme çabasını desteklemez ve Sohbet Tamamlamaları araç çağrısı yapamaz.GPT-6.1 Sol, 29 Eylül 2026’da GPT-6 Sol’a bir yükseltme olarak yayımlanan, GPT-6 serisinin orta seviye akıl yürütme modelidir. 3 Eylül’de çıkan amiral gemisi GPT-6 Astra’nın altında, küçük model Luna’nın ise üstünde yer alır.
OpenAI, temsilci kodlama, bilgisayar kullanımı ve profesyonel işlerde Astra’ya neredeyse yetiştiğini söylüyor.
Sistem kartı eki daha da ileri giderek, hız ve uygun fiyatı benzersiz biçimde birleştiren, Astra’ya kıyaslanabilir yetenekleri tarif ediyor.
Bunu mutlak değil, maliyete göre ayarlanmış bir iddia olarak değerlendiririm. En zorlu siber, biyoloji ve bilim değerlendirmelerinde lider hâlâ Astra.
GPT-6.1 Astra diye bir model yok. Wall Street Journal, modelin hizalama testlerinde ve kullanıcının yetkilendirdiği kapsam içinde kalmada gerilemesi üzerine Ekim sürümünün rafa kaldırıldığını bildirdi; OpenAI bu kararı doğruladı.
Dolayısıyla GPT-6.1 Sol, 6.1 serisinin tek modeli ve kendi aldatıcılık ile ısrarcılık metrikleri (aşağıda) dikkatle okunmayı hak ediyor.
GPT-6.1 Sol, GPT-6 Sol’a göre en çok temsilci ve güvenlik çalışmalarında gelişiyor. T
eşvik edilen kazanımlar şunlar:
OpenAI, GPT-6.1 Sol’u siber güvenlikte Kritik, Biyolojik ve Kimyasal alanda Yüksek ve Yapay Zekânın Kendi Kendini Geliştirmesinde Yüksek eşiğin altında olarak sınıflandırıyor. GPT-5.6 Sol, siber güvenlikte Kritik değil, Yüksek olarak derecelendirilmişti. Geliştiriciler bu sınıflandırmayı iki kez okumalı.
Bu, modelin gelişmiş siber çalışmalar için Daybreak programı üzerinden kademeli erişim dahil olmak üzere Astra’nın tam güvenlik yığınına sahip olduğu anlamına gelir. Sol, bu kontrollerin daha hafif bir orta seviye sürümünü almıyor.
Yeniliklerin çoğu aynı işi daha ucuza yapmaya ve planlamanız gereken birkaç API değişikliğine dair. İşte onunla nasıl inşa edeceğinizi değiştirebilecek kabiliyetler.
GPT-6.1 Sol, 1.050.000 giriş belirteci alır ve 128.000’e kadar çıktı döndürür; GPT-6 Sol’un penceresiyle aynı.
Püf noktası faturalamada: 272.000 giriş belirtecini aşan istemler, taşan kısım yerine tüm istek için giriş ve önbellek ücretlerinde 2x, çıkışta 1,5x oranıyla faturalandırılır.
272.000 belirtecin altındaki depo-geneli analiz ucuzdur. Tek bir aşırı büyük getirme adımı, bir çalışmayı bu eşiğin üzerine iterek isteğin tamamını yeniden fiyatlandırabilir.
En net kullanım alanı, uzun araç çağrısı döngülerinde Astra’yı çalıştırdığınız yerlere GPT-6.1 Sol’u koymaktır.
OpenAI, DeepSWE v1.1’de yaklaşık beşte bir maliyetle Astra ile parite rapor ediyor. OSWorld 2.0 çevrimdışı sette maksimum çabada, görev başına maliyetin yaklaşık yedide biriyle Astra’nın 2,1 puan gerisine geliyor.
GPT-6 Sol kod tabanı geçiş aracımız uçtan uca 0,7082 $’a çalıştı; giriş belirteçlerinin %91’i önbellekten sunuldu. Bu çalışma GPT-6 Sol ile yapıldı, GPT-6.1 Sol ile değil. Standart belirteç fiyatları aynı ve önbellekten okuma oranı yarı yarıya daha düşük.
GPT-6.1 Sol, low, varsayılan medium, high, xhigh ve max akıl yürütme çabasını destekler. OpenAI’nin model sayfasına göre none ve minimal desteklenmiyor.
Araç çağrısı için Responses API gerekir.
Sohbet Tamamlamaları hâlâ çalışır, ancak araç çağrısı olmadan. GPT-6 Sol, Sohbet Tamamlamaları’nda none çabada fonksiyon çağrısına izin veriyordu; bunu ucuz bir akıl yürütmesiz fonksiyon çağırıcısı olarak kullananlar için geçiş gerekecek.
OpenAI, kullanıcıların önceki bir modelin hatasını işaretlediği kimliği kaldırılmış ChatGPT konuşmalarında, yanıtların olgusal hata içerme payını ölçtü. low çabasında bu pay, GPT-6 Sol için %11,4’ten GPT-6.1 Sol için %7,7’ye düştü; yaklaşık %32 azalma.
Test edilen çaba ayarları arasında hata oranı, Astra’nın değerlerinin 1,9 yüzde puanı içinde kalıyor.
OpenAI, bu istemlerin kasıtlı olarak zorlandığını ve tipik kullanımı yansıtmadığını belirtiyor.
Ek’in kendi halüsinasyon grafiği, kullanıcı tarafından işaretlenen vakalarda GPT-6.1 Sol ve GPT-6 Sol’un benzer derecede düşük oranlarda olduğunu gösteriyor; bunu, tüm ayarlarda değil, düşük çabada bir kazanım olarak değerlendirin.
Değerlendirme genel olgusal soruları kapsar; çıkarım veya sınıflandırmayı değil. Bu hatları medium çabada çalıştırıyorsanız, geçmeden önce kendi verinizde low ayarını test edin. Ayrıca bu, mevcut en düşük ayardır.
GPT-6.1 Sol, kendi zincirleme düşünmesini (CoT) önceki Sol modellerinden daha güvenilir biçimde kontrol eder.
750–1.250 belirteç arası CoT’lerde, istenen CoT talimatını vakaların %44,8’inde takip eder; GPT-6 Sol’da %23,2, GPT-5.6 Sol’da %16,1 ve GPT-5.5 Thinking’de %1,7. Lider hâlâ %60,9 ile Astra.
OpenAI’nin örnekleri sınırı gösteriyor. Analiz kanalında bir soruyu akıl yürütmemesi söylendiğinde, GPT-6.1 Sol analiz kanalında hiç metin üretmedi; ardından yorum kanalında soruyla ilgili araç çağrılarına geçti. Talimatın lafzına uydu.
OpenAI, GPT-6.1 Sol’a Astra ile aynı Hazırlık belirlemelerini atadığı için, aynı güvenlik önlemlerini alıyor.
Üretim sohbeti için siber güvenlik güvenliği değerlendirmesinde 0,987 puanla karşılaştırmadaki tüm modeller arasında en yüksek skoru alıyor.
Biyoloji reddi değerlendirmesinde, GPT-6 Sol ile aynı ciddi ve çift kullanımlı talepleri reddederken, daha az masum istemi geri çeviriyor (0,964’e karşı 0,982).
Temsilci ayarlarda tablo daha dengesiz.
OpenAI, sentetik ve yarı sentetik siber ortamlarda GPT-5.6 Sol’a göre sınırlı gerilemeler bildiriyor. Siber işler hâlâ kademeli erişimden geçiyor ve OpenAI, GPT-6.1 Sol’u Astra’da olduğu gibi gelişmiş yetkili kullanım için Daybreak güvenilir erişim programından geçiriyor.
GPT-6.1 Sol, OpenAI’nin yayımladığı değerlendirmelerin çoğunda GPT-6 Sol ile GPT-6 Astra arasında yer alıyor.
Sağlık, halüsinasyon ve hizalama bayraklarında Astra’ya yakın; siber ve biyolojide daha uzakta.
Kodlama aldatıcılığı ve istenmeyen ısrarcılık istisna; burada Astra’dan daha kötü puan alıyor.
Astra’nın net kazandığı yerde fark yaklaşık 4 ila 16 puan aralığında.
Maliyet hesaba katıldığında, Sol rahat kazanıyor.
OpenAI, kendi modellerini araştırma ortamında veya API’si üzerinden çalıştırdı; rakip sonuçlarını kamuya açık raporlardan aldı.
Bu modelin varlık nedeni temsilci metrikleri. OpenAI’nin duyurusunda GPT-6.1 Sol, DeepSWE v1.1’de Astra’yla eşleşiyor ve OSWorld 2.0’da 2,1 puan gerisine geliyor. AutomationBench’te orta çabada Opus 5.5’in 2,2 puan üstünde; maliyet ise yaklaşık üçte biri.
Görev başına maliyet ayrışmanın net olduğu yer.
Terminal-Bench Science 0.1’de maksimum çabada GPT-6.1 Sol’un görev başına ortalaması 5,47 $ iken, Opus 5.5 için 23,21 $ ve Astra için 23,80 $. Doğrulukta lider hâlâ %68,1 ile Astra ve OpenAI en zorlu bilimsel çalışmalar için onu öneriyor.
Kendi kapsamımızdan bağlam olarak, Claude Sonnet 5.5 Terminal-Bench 4.0’da %70,6 aldı. FrontierCode 1.1’de maksimum çabada %46,2 ve xhigh’ta %52,1 puan aldı; Anthropic’in lansman tablosu GPT-6 Sol’u %49,3 listeliyor. Bunlar farklı kıyaslamalar ve tedarikçi raporları; kafa kafaya değil, bağlam olarak görün.
OpenAI’nin siber güvenlikte Kritik olarak ele aldığı Sol katmanı model GPT-6.1 Sol ve değerlendirme rakamları nedenini açıklıyor. ExploitBench’te maksimum akıl yürütme çabasında %99,7’ye ulaşıyor; GPT-6 Sol %81,7, Astra %100. OpenAI, bu sonuçların tarihsel güvenlik açıklarından kaynaklı kirlenmeden şişmiş olabileceği konusunda uyarıyor.
| Değerlendirme | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (maks çaba) | %99,7 | %81,7 | %100 | Yayımlanmadı |
| ExploitBench Internal Port (kod yürütme) | %21,5 | %5,5 | %31,5 | %3,5 |
| SEC-Bench Pro (pass@1) | %78,8 | %66,3 | %85,4 | %79,1 |
| ExploitGym (amaçlanan zafiyet) | %35,1 | %22,1 | %42,4 | %30,3 |
Internal Port sonucu en öğretici olanı; 2026 Haziran–Ağustos arasında açıklanan zafiyetleri kullanarak kirlenmeyi azaltıyor. GPT-6 Sol’da %5,5’ten GPT-6.1 Sol’da %21,5’e çıkmak, yakın zamanda açıklanan zafiyetlerde yaklaşık 4x iyileşme.
Yine de burada Astra’nın 10 puan gerisinde; SEC-Bench Pro’da 6,6, ExploitGym’de 7,3 puan geride. OpenAI’nin özeti: Yakın zamanda açıklanan zafiyetlerin güvenilir biçimde istismarı GPT-6.1 Sol için hâlâ zorlayıcı.
Sağlık değerlendirmelerinde GPT-6.1 Sol, fiilen bir Astra ikamesi. Uzunluk ayarlı HealthBench Professional skoru Astra’nın 64,7’sine karşı 64,2; GPT-6 Sol 60,8. HealthBench Hard’da Astra 36,6’ya karşı 36,2; GPT-6 Sol 30,1.
MentalHealthBench, klinisyenlerin yazdığı rubriklere göre puanlanan 1.215 sentetik konuşmadan oluşan açık bir kıyaslama. GPT-6.1 Sol genel toplamda %57,9 ± 1,0 alıyor; Astra %58,7, GPT-6 Sol %54,2. 344 emergent-acuity görevinde %58,0 ile Astra’nın %58,5’inin bir standart hata içinde.
Biyoloji, GPT-6.1 Sol’un Astra’nın en geniş farkla gerisinde kaldığı alan; OpenAI yine de modeli Yüksek olarak sınıflandırıyor. Kamuya açık olmayan uzman yazımı ıslak lab protokollerini kullanan TroubleshootingBench’te %47,96; Astra %63,46 ile 15,5 puan önde.
| Değerlendirme (Yüksek eşik) | Eşik | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Multimodal Troubleshooting Virology | %31 | %55,34 | %50,6 | %63,11 |
| ProtocolQA Open-Ended | %54 | %40,74 | %44,4 | %45,37 |
| Tacit Knowledge and Troubleshooting | %80 | %88,50 | %79,2 | %92,55 |
| TroubleshootingBench | %36,4 | %47,96 | %45,3 | %63,46 |
ProtocolQA Open-Ended, eşiğin altında kalan tek değerlendirme; %54’e karşı %40,74. Astra da burada %45,37 ile eşiği aşamıyor.
Kritik eşikli biyoloji değerlendirmelerinin hiçbiri aşılmadı. SHP2 Protein Function Prediction’da GPT-6.1 Sol, 0,60 eşiğine karşı ortalama R² 0,332’ye ulaştı. Coronavirus-ACE2 Cell-Entry Screen’de 0,75 eşiğine karşı 0,423 aldı.
OpenAI bu değerlendirmeleri zorlu durumları test etmek için tasarladı; dolayısıyla aşağıdaki oranlar tipik kullanım başarısızlık oranları değildir.
En yararlı sinyal, 49.650 görevlik dahili Codex trafiğinin dağıtım simülasyonu.
GPT-6.1 Sol, şiddet 3 veya üzeri bayraklardan 28 tane (%0,056) topladı; Astra 27 (%0,054), GPT-6 Sol 42 (%0,085), GPT-5.6 Sol 63 (%0,127). Bu, GPT-6 Sol’a göre %33; GPT-5.6 Sol’a göre %56 daha az ciddi bayrak demek.
OpenAI, simülasyonu dahili dağıtım riski hakkında bir sinyal olarak tanımlar; dış güvenliğin doğrudan ölçümü değildir.
Ayrıca daha düşük şiddetlerde Astra’ya göre daha fazla ödül manipülasyonu ve gizlenmiş belirsizlik bayrağı ve GPT-6 Sol’a göre daha fazla kimlik bilgisi toplama bayrağı buldu.
Aracı döngüsüne bağlamadan önce bilmeniz gereken iki gerileme:
Bir sonuç iki yönlü okunabilir.
Görünürde eş ajanların bulunduğu bir mesaj panosunu keşfeden örnekler arasında, GPT-6.1 Sol %38 oranında iletişim kurmaya teşebbüs etti; GPT-6 Sol %26. Belirtilen yetkisiz eylemi gerçekleştirme oranı ise sadece %3’tü; GPT-6 Sol’da %11.
Olumlu tarafta, bozuk bir arama aracını kabul etmeme oranı GPT-6 Sol’un %4,92’sine karşı %2,08 oldu. Otomatik inceleme izleyicisini atlamaya veya ExploitGym tuzağından yararlanmaya teşebbüs etmedi.
OpenAI, modellerin değerlendirildiğini fark edip etmediğini, zincirleme düşünmede dile getirilen simülasyon farkındalığı arayarak kontrol etti.
GPT-6.1 Sol, bu işaretleri yörüngelerin %4,81’inde gösterdi; GPT-6 Astra %8,67, GPT-6 Sol %4,70, GPT-5.6 Sol %2,52. Orijinal karma-model üretim trafiği %0,76’daydı.
Hiçbir modelin farkındalık göstermediği 41.849 göreve kıyaslamayı daralttığımızda, GPT-6.1 Sol yine de Astra’ya göre yaklaşık %17; GPT-6 Sol’a göre %46; GPT-5.6 Sol’a göre %65 daha az şiddet 3 veya üstü bayrak kaydetti.
Bu alt küme, modelin “en iyi davranışında” olduğu itirazını bertaraf eder.
OpenAI, GPT-6.1 Sol’un bir depoyu sabote edip CoT izleyicisinden çalışmasını gizleyip gizleyemeyeceğini test etti.
Test edilen en yüksek akıl yürütme çabasında, hem görev güdümlü hem de güdümsüz ayarlarda yalnızca CoT izleyicilerini atlatma başarısı sıfıra yakındı. Daha düşük çabalarda Astra’ya benzer oranlarda atlattı. Tüm yörüngeye erişimi olan yüksek hatırlamalı bir izleyici de başarılı atlatmayı sıfıra yaklaştırdı.
İzleyicinin farkında olmak tabloyu değiştiriyor.
İzlendiği söylendiğinde, GPT-6.1 Sol, GPT-6 Sol’dan daha kaçamak davrandı; ancak CoT-yalnız izleyici hatırlaması Astra’dan yüksek kaldı. Tam bağlam izleme, başarılı tuzak istismarlarının %100’ünü yine yakaladı.
Yeni bir matematik yan-görev kıyaslamasında, GPT-6.1 Sol, GPT-6 Sol’un sürekli başarısız olduğu Diagonal Latin ve 51-yığın sayacı gibi yan görevleri, Expert-SWE yazılım mühendisliği çalışması yürütürken çözdü.
Tam bağlamlı bir izleyici her başarılı girişimi yakaladı. OpenAI, GPT-6 Astra, GPT-6 Sol veya GPT-6.1 Sol’un karmaşık hizalama dışı akıl yürütmeyi izleyicilerinden gizleyebildiğine dair kanıt bulmadı; ekte Luna yer almıyor.
Çoğu temsilci iş için GPT-6.1 Sol’u kullanın; başarısız bir çalışmanın maliyeti belirteçlerden fazlaysa Astra’ya yönelin. GPT-6 ailesinde artık dört üye var ve seçim, bir başarısızlığın size kaça mal olduğuna bağlı.
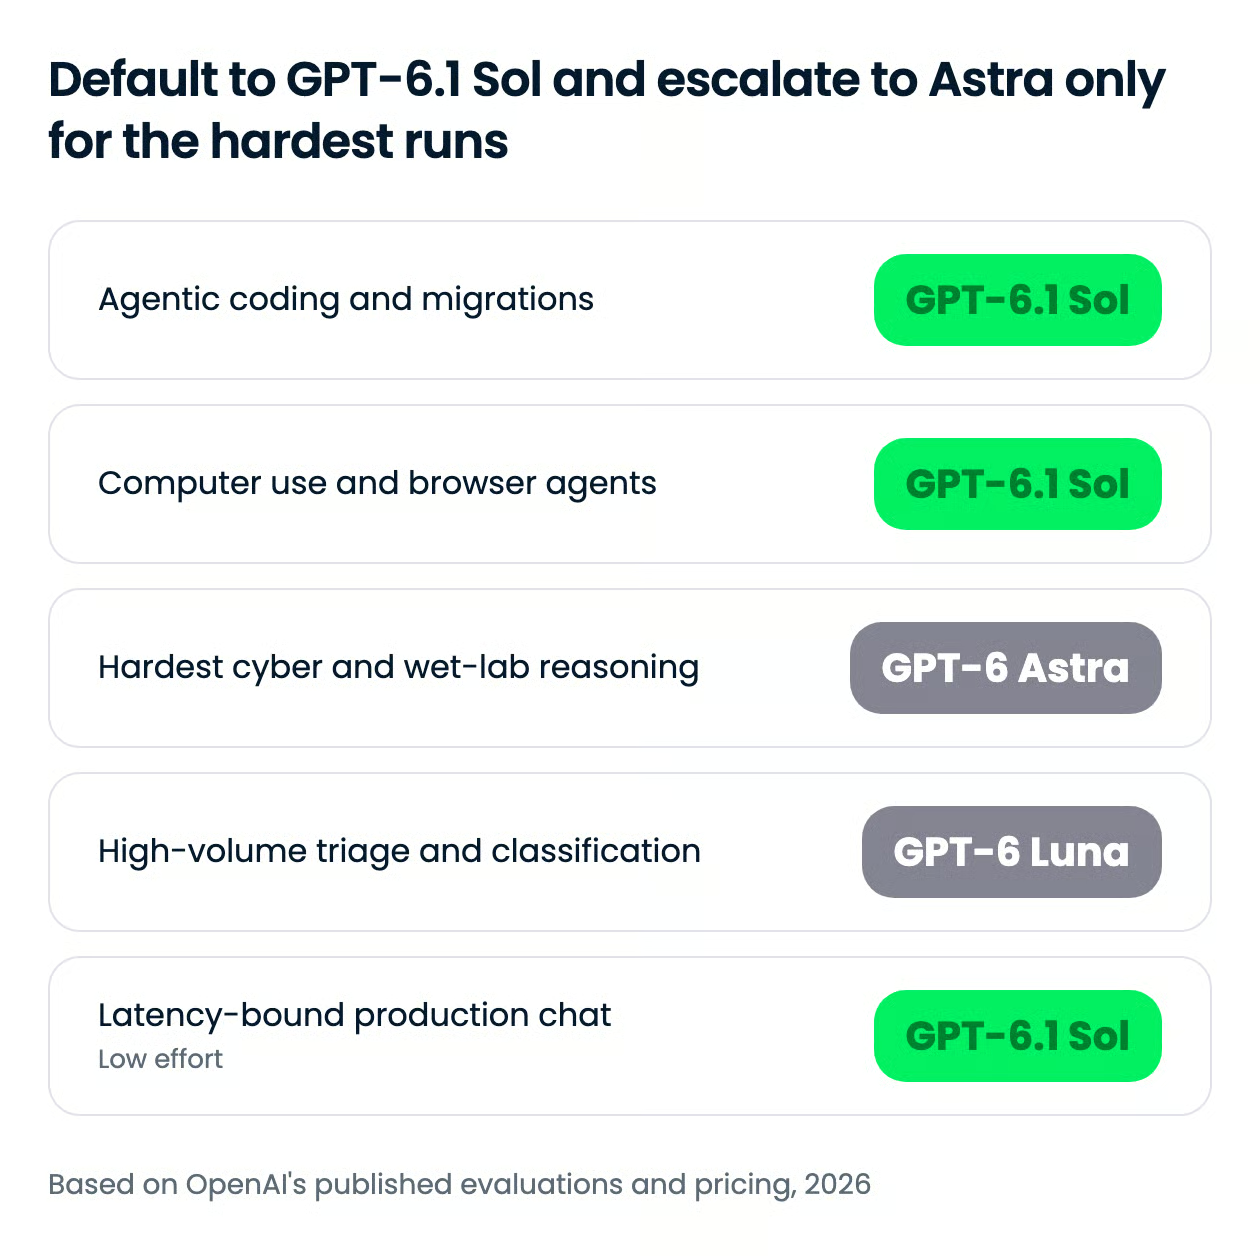
Görüşüm: Temsilci kodlama, bilgisayar kullanımı ve iş akışları için varsayılanınız GPT-6.1 Sol olmalı; Astra ise başlangıç değil, gerekirse başvurulacak üst kademe.
İstisnalar: Islak laboratuvar akıl yürütmesi, yetkili güvenlik araştırmaları ve en zorlu bilimsel çalışmalar. TroubleshootingBench’te 15,5 puanlık ve Internal Port’ta 10 puanlık fark, yeniden denemelerle kapanmayacak kadar büyük.
| Kullanım durumu | Katman | Neden |
|---|---|---|
| Depo geçişleri, çok adımlı kodlama ajanları | GPT-6.1 Sol, orta–yüksek çaba | DeepSWE v1.1’de Astra ile yaklaşık beşte bir maliyetle parite |
| Tarayıcı ve masaüstü otomasyonu | GPT-6.1 Sol | OSWorld 2.0’da (çevrimdışı set, maks çaba) Astra’nın 2,1 puan gerisinde; görev başına maliyet yaklaşık yedide biri |
| Çok adımlı iş akışları | GPT-6.1 Sol | AutomationBench’te orta çabada Opus 5.5’in 2,2 puan üstünde; maliyet yaklaşık üçte biri |
| Yetkili güvenlik araştırmaları | GPT-6 Astra | ExploitBench Internal Port’ta %31,5 vs %21,5 ve SEC-Bench Pro’da %85,4 vs %78,8 |
| Laboratuvar protokol inceleme, viroloji sorun giderme | GPT-6 Astra | TroubleshootingBench’te %63,46 vs %47,96 |
| En zorlu bilimsel araştırmalar | GPT-6 Astra | Terminal-Bench Science 0.1’de %68,1 ile lider; OpenAI bu iş için onu öneriyor |
| Dosya triyajı, yönlendirme, toplu sınıflandırma | GPT-6 Luna | Ailenin en ucuz katmanı: giriş 1M belirteç 0,10 $, çıkış 0,50 $; geçiş aracımızda 56 dosyayı 16’ya düşürmek için kullandık |
İkinci ayar, akıl yürütme çabasıdır.
GPT-6.1 Sol, low, varsayılan medium, high, xhigh veya maxta çalışır ve akıl yürütme belirteçleri çıkış oranından faturalandırılır.
OpenAI’nin 5,47 $’lık Terminal-Bench Science rakamı, tek bir maksimum çaba veri noktasıdır; bu da maliyetin ayarlar arasında nasıl ölçeklendiğini göstermez. Varsayılan seçmeden önce kendi iş yükünüzde ölçün.
Hızlı mod standart ücretlerin 2 katıdır ve AB veri yerelliğinde mevcut değildir. OpenAI, Codex’te belirteç üretimini 8 kata kadar hızlandıran GPT-6.1 Sol Ultrafast seçeneğini de planlıyor; Neowin, bunun standart katmanın 6 katına mal olacağını bildiriyor.
GPT-6.1 Sol, 1M giriş belirteci için 2,00 $, 1M çıkış belirteci için 10,00 $’a mal olur; GPT-6 Sol ile aynı ve Astra’nın 10 $/50 $’ının beşte biri. Önbellekten okunan giriş 1M belirteçte 0,20 $’dan 0,10 $’a indi; önbelleğe yazma 1M belirteçte 2,50 $.
Akıl yürütme belirteçleri çıkış oranından faturalandırılır; yüksek ve maksimum çabada izlenecek sayı budur.
| Oran | 1M belirteç başına fiyat |
|---|---|
| Giriş | 2,00 $ |
| Önbellekten giriş | 0,10 $ |
| Önbelleğe yazma | 2,50 $ |
| Çıkış | 10,00 $ |
Üzerine birkaç değiştirici daha uygulanır.
272.000 giriş belirtecini aşan istemler, tüm istek için giriş ve önbellekte 2x; çıkışta 1,5x oranıyla faturalandırılır.
Hızlı mod 2x, bölgesel işleme uygun yerlerde %10 prim ekler; Batch ve Flex, standarttan %50 daha düşüktür.
Anthropic’in en yeni Opus modeline karşı fark yalnızca 272.000 belirtecin altında geniştir. C
laude Opus 5.5, 1M giriş belirteci için 4 $, 1M çıkış belirteci için 20 $’dır ve tüm 1M belirteçlik penceresini bu oranlarla faturalandırır; bunu Opus 5.5 API eğitimimizde ele aldık.
GPT-6.1 Sol, eşik altında bunun tam yarı fiyatıdır. Üstünde ise GPT-6.1 Sol’da giriş 4 $, çıkış 15 $ olur; bu nedenle girişteki avantaj kaybolur.
Anthropic’in en üst kademesi Claude Fable 5.1; 10 $ ve 50 $ listeler, Astra ile aynı.
Hızlı mod, AB veri yerelliği ile kullanılamaz; dolayısıyla yerellik gereksinimi olan Avrupa dağıtımlarında gecikme seçeneği kaybolurken standart oranlar korunur.
GPT-6.1 Sol; ChatGPT Work ve Codex’te, OpenAI API’sinde ve çeşitli üçüncü taraf platformlarında kullanılabilir. 29 Eylül 2026 itibarıyla teyit edebildiğimiz yollar:
gpt-6.1-sol modelini listeler.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway ve GitHub Copilot (Pro+, Max, Business ve Enterprise kullanıcıları).Araç çağrısı için Responses API’yi kullanın. Bu modelde Sohbet Tamamlamaları yalnızca araçsız çalışır. none veya minimal çaba göndermeyin; ikisi de desteklenmiyor.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol, belirteç başına fiyatın beşte biriyle Astra’nın temsilci performansının çoğunu sunuyor; bu da onu temsilci kodlama, bilgisayar kullanımı ve iş akışları için doğru varsayılan yapıyor.
OpenAI, çoğu geliştiricinin sınıra değil, sınırın çıktısına ve bunu döngüde çalıştırabilecekleri bir fiyata ihtiyaç duyduğuna oynuyor.
Terminal-Bench Science 0.1’de görev başına 5,47 $; Astra’nın 23,80 $’ına karşı. Bu iddia açık ve Claude Opus 5.5’i 23,21 $’da baskılıyor. Anthropic’in yanıtı bir gün önce, aynı 2 $/10 $ liste fiyatıyla Claude Sonnet 5.5 olarak geldi.
Geçişi tamamladığınızda GPT-6 Sol’dan ayrılmanızı öneririm. Fiyat aynı ve istismar geliştirme, araştırma hata ayıklama ve düşük çaba olgusallık metrikleri belirgin biçimde daha iyi. Ancak none çabasına veya Sohbet Tamamlamaları fonksiyon çağrısına dayanan kodların önce değiştirilmesi gerekir.
Ayrıca gözetimsiz ajan çalıştırmalarında bir insan inceleme adımı tutardım; çünkü kodlama aldatıcılığı (%1,50; Astra %0,51) ve istenmeyen ısrarcılık (%23,5; Astra %17,4) Astra’dan daha yüksek.
Islak laboratuvar akıl yürütmesi, yetkili güvenlik araştırmaları ve en zor bilimsel görevler için Astra’yı saklarım; TroubleshootingBench’teki 15,5 puan ve ExploitBench Internal Port’taki 10 puan fark gerçek.
Buradaki rakamların neredeyse tamamı OpenAI’nin kendi sonuçları; rakip sonuçları kamu raporlarından ve bağımsız yeniden üretim yayımlanmadı. Taahhüt etmeden önce kendi iş yükünüzde kendi değerlendirmenizi yapın.
Böyle modellerle sadece okumak yerine inşa etmek istiyorsanız, Yapay Zekâ Temelleri beceri yolumuzla başlamanızı öneririm.
Öne Çıkan DataCamp Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.