Sıradaki parça ön izlemesi tetrominonun harfini — O, I, T, S, Z — şekli çizmek yerine gösteriyor. Gösterimi öğrendikten sonra okunabiliyor, ancak her bakışta bir an kaybettiriyor; hızda bu önemlidir. Hiçbir modelden ön izleme istenmemişti; bu Sol’un kendi önerdiği ve biraz eksik inşa ettiği bir tercih oldu. Daha cilalı kurulumun daha az okunabilir olduğu tek yer burası.
Claude Opus 5.5 ne üretti
Opus 5.5, 3 tur ve 2 araç çağrısına (bir glob ve bir yazma) ihtiyaç duydu; “Flip Tetris” adlı 19 KB’lık bir index.html gönderdi. Üstbilgi yorumunda iki modelden daha dikkatli bir teknik şartname var: sabit tohum üzerinde 7-torba rastgeleleştirici, duvar tekmeleriyle döndürme, yığına göre satır çökertme ve yerçekimi tersine döndüğünde düşmekte olan parçanın yalnızca yön değiştirdiğine dair bir not.
Oyun tarif edildiği gibi ve Sol’unki kadar stabil çalışıyor; hayalet parça var ve her tersine dönüşten önce kırmızıya dönen bir geri sayım çubuğu bulunuyor. Sıradaki parça ön izlemesi gerçek şekli çiziyor; bu, ilk bakışta Sol’dan daha iyi yaptığı tek şey ve doğru tercih.
Ayrıca kimseden istenmeyen bir seviye sayacı eklemiş; bunu artı değil, başa baş sayarım: seviyeler o kadar yavaş artıyor ki, bu kurulumların gerçekçi olarak oynanacağından çok daha derine inene kadar fark yaratmıyor. Opus’un kaybettiği yer mantık değil hissiyat: yerleşim Sol’unkinden daha sade ve yumuşak düşürme daha az akıcı; bu yüzden görsel kaliteden bir, tamamlıktan bir puan düşüyor.
Sonuçlar
| Ölçüm | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Turlar | 6 | 3 |
| Araç çağrıları | 9 | 2 |
| Maliyet | $0,26 | $0,87 |
| Toplam token | 120.226 | 107.958 |
| Muhakeme tokenları | 8.123 | 22.551 |
| Çalıştırılabilirlik | geçti | geçti |
| Tersine dönüş mekaniği | 5 | 5 |
| Oyun tamamlığı | 5 | 4 |
| Görsel kalite ve hissiyat | 5 | 4 |
| Rubrik skoru (üç eksenin ortalaması) | 5 | 4,3 |
GPT-6 Sol bu testi kazanıyor, ama kıl payıyla ve zor kısımda değil. İkisi de yerçekimi tersini doğru yaptı; fark zanaatte ortaya çıktı ve Sol’un duyarlılığı ile görsel cilası ona Opus’a karşı bir avantaj sağladı.
Onları daha belirgin ayıran şey, koşuların maliyeti. Opus 5.5, Sol’un $0,26’sına karşı $0,87 harcadı; üç kattan fazla. Üstelik bunu daha az toplam tokenla yaptı: 120 bin karşısında 108 bin. Fark muhakemede: Opus tur başına kabaca üç kat daha fazla düşündü, doğru kurulu yarı turda yakaladı ve durdu. Sol ise dosyada yinelemeye gitti, ucuza, ve hissiyatta hafifçe öne çıktı.
Bu, tek bir çaba ayarında tek bir görevin tek koşusudur; çok dosyalı, uzun ufuklu depo işini değil, tek dosyada oyun döngüsü mantığını yoklar. Maliyet rakamları her biri birer veri noktasıdır, ortalama değildir.
GPT-6 Sol’u ve Claude Opus 5.5’i Ne Zaman Seçmeli
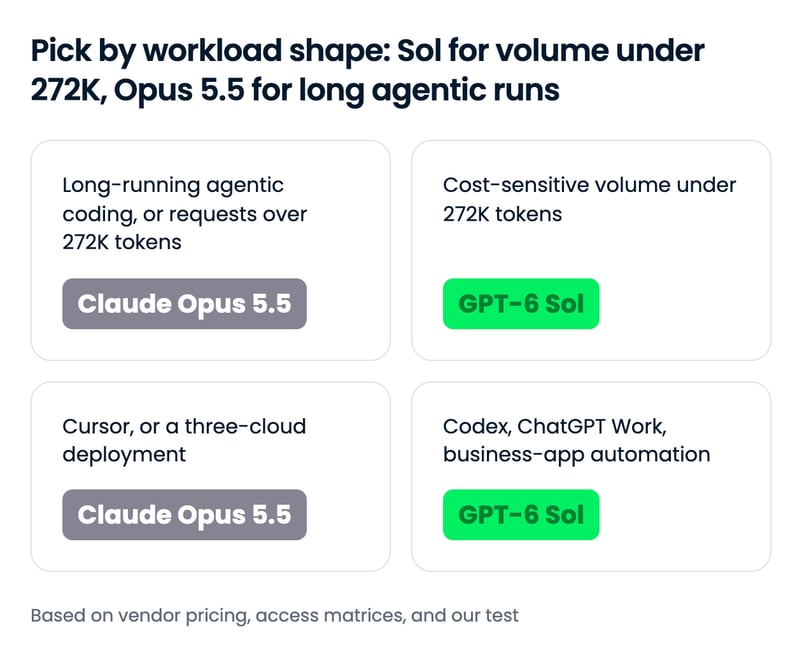
Ayrım, ham yetenekten çok istek boyutu ve iş yükü şeklidir: istek başına 272K token altındaysa Sol’un indirimi gerçektir; üstünde veya önbellek ağırlıklı döngülerde iki fatura yakınsar ve Opus 5.5’in yayımlanmış ajan işindeki üstünlüğü ödediğiniz şey olur.
Şunlar varsa GPT-6 Sol’u seçin...
- Her isteği uzun bağlam eşiğinin altında kalan yüksek hacimli ajanlar çalıştırıyorsanız. Liste fiyatında yarı yarıya olmak milyonlarca istekte bileşik etki yapar ve önbellek okuma oranı zaten aynıdır.
- Ekibiniz zaten Codex veya ChatGPT Work içinde çalışıyorsa. Sol, tüm ücretli planlarda orada mevcuttur ve Codex, OpenAI’ın onu ayarladığı koşumdur.
- Bütçeyle iş akışlarını otomatikleştiriyorsanız. Sol’un AutomationBench koşusu görev başına $0,27 tuttu ve OpenAI’ın görev başına maliyet iddiaları en güçlü argümanıdır.
- En aşağıya kadar inen bir çaba merdiveni istiyorsanız. Sol’un
noneayarı ve önbellek güvenli çaba değişimleri, bir ajanın ucuz takipler çalıştırıp yalnızca zor adımlarda tırmanmasına izin verir.
Şunlar varsa Claude Opus 5.5’i seçin...
- İşiniz uzun süreli ajan-kodlama ise: geçişler, denetimler ve çoklu depo görevleri. Opus 5.5, raporladığı her ajan-kodlama kıyaslamasında daha güçlü puanlar yayımlar ve test edenlerin anekdotları saatler süren işlerdir.
- İstekleriniz rutin olarak Sol’un uzun bağlam eşiğini aşıyorsa. Anthropic, tam 1M pencereyi standart oranlarda faturalandırır ve Sol’un ek ücreti bu boyutta fiyat farkının çoğunu kapatır.
- Modeli bugün Cursor’da veya üç hiperbüyük bulutun tamamında istiyorsanız. Opus 5.5, Cursor ile Bedrock, Vertex AI ve Microsoft Foundry’de listelidir; Sol, Cursor ve Vertex AI’da mevcut değildir.
- Ajanları gözetimsiz çalıştırıyor ve daha muhafazakâr modeli istiyorsanız. Anthropic’in sınırlama değerlendirmesi ve Fable sınıfı korumaları tam buna yöneliktir; işiniz siber güvenlik değilse.
GPT-6 Sol ve Claude Opus 5.5 ile Başlarken
| Yüzey | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tüketici uygulaması | ChatGPT Work ve Codex: Plus, Pro, Business, Enterprise ve Edu planlarında; henüz ChatGPT’nin Sohbet’inde değil | Claude uygulamaları; lansmanda Pro, Max, Team ve Enterprise planlarında kullanım limitleri artırıldı |
| Birinci taraf API | Evet, OpenAI API (Responses API önerilir) | Evet, Claude API |
| Bulut platformları | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Kodlama ajanları | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Üçüncü taraf yönlendiriciler | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API model kimliği | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 ilk günde üç büyük bulutta ve Cursor’da çıktı; Sol iki bulutta var ve Cursor’un model listesinde yok. API’lerde dizgiler gpt-6-sol ve claude-opus-5-5.
GPT-6 Sol ve Claude Opus 5.5’i bir kodlama ajanında kullanma
Her model, kendi sağlayıcısının ajanında gelir: Sol için Codex, Opus 5.5 için Claude Code; ikisi de GitHub Copilot’ta seçilebilir. Her ikisi için tek bir koşum istiyorsanız, OpenCode gibi bir yönlendirici destekli ajan, onlara OpenRouter üzerinden openai/gpt-6-sol ve anthropic/claude-opus-5.5 olarak ulaşır; testimiz onları aynı araçlarla böyle çalıştırdı.
Doğrudan API çağrıları farklı SDK’lar kullanır; bu yüzden değişim tek satır değil, bir istemci ve model dizgisidir:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Tam ajan kurulumları için Codex CLI eğitimi ve Claude Code eğitimi kurulum ve iş akışlarını kapsar; Codex vs Claude Code karşılaştırmamız ise koşumların kendilerini tartar.
Son Söz
İş yükünüz uzun, ajan tabanlı kodlama ise veya istekleriniz uzun bağlam eşiğini aşıyorsa Claude Opus 5.5’i kullanın: ajan işinde daha güçlü sayılar yayımlar ve fiyatlandırması büyük istekleri cezalandırmaz. Bu eşik altında hacim çalıştırıyorsanız, Codex veya ChatGPT Work içinde yaşıyorsanız ya da bütçeyle iş uygulamaları otomasyonu yapıyorsanız GPT-6 Sol’u kullanın ve aradaki farkı cebe koyun.
En ilginç bulduğum şey, hiçbir sağlayıcının diğerinin yeni modelini tablosuna koyamamış olması ve onları kendimiz karşılaştırabildiğimiz tek yerde, kendi kendine yeten bir kurulumda, daha ucuz modelin cilada öne çıkmış olması.
Her iki modelle de geliştirmeye hevesliyseniz, Working with the OpenAI API ve Introduction to Claude Models kurslarımızı öneririm.
SSS
Claude Opus 5.5 yerine GPT-6 Sol’u ne zaman kullanmalıyım?
İstekleriniz 272K girdi tokenının altında kalıyor ve hacim önemliyse GPT-6 Sol’u kullanın: 1M girdi tokenı için $2 ve 1M çıktı tokenı için $10 olarak listelenir; bu, Claude Opus 5.5’in $4 ve $20’sinin yarısıdır. Ekibiniz Codex veya ChatGPT Work’te çalışıyorsa da doğal tercihtir. Uzun süreli ajan-kodlama, 272K token üzeri istekler veya modeli Cursor’da ya da üç büyük bulutta birden gerektiğinde Opus 5.5’i seçin.
GPT-6 Sol, Claude Opus 5.5’ten ne kadar daha ucuz?
Liste fiyatında, Claude Opus 5.5 girdi için GPT-6 Sol’un tam iki katına ($4 vs $2, 1M token başına), çıktı için ($20 vs $10) ve önbelleğe yazma için ($5 vs $2,50) mal olur. Önbellekten okuma her ikisinde de 1M token başına $0,20’dir. Sol, 272K girdi tokenını aşan herhangi bir istekte girişte 2x ve çıkışta 1,5x uygular; Anthropic ise tam 1M bağlamı standart oranlarda faturalandırır; bu nedenle uzun bağlamlı getirmede fark yaklaşık %8’e, önbellek ağırlıklı ajan döngülerinde yaklaşık %33’e iner.
GPT-6 Sol ve Claude Opus 5.5 için API model kimlikleri nelerdir?
OpenAI API’de GPT-6 Sol gpt-6-sol’dur. Claude API’de Claude Opus 5.5 claude-opus-5-5, Amazon Bedrock’ta anthropic.claude-opus-5-5’tir. OpenRouter üzerinden ikisi openai/gpt-6-sol ve anthropic/claude-opus-5.5 olarak geçer.
GPT-6 Sol ve Claude Opus 5.5’e nereden erişebilirim?
GPT-6 Sol; ChatGPT Work ve Codex’te Plus, Pro, Business, Enterprise ve Edu kullanıcılarına, OpenAI API üzerinden, Azure AI Foundry ve AWS Bedrock’ta, GitHub Copilot’ta ve OpenRouter aracılığıyla mevcuttur; henüz ChatGPT’nin tüketici sohbetinde değildir. Claude Opus 5.5; Claude uygulamalarında, Claude API üzerinden, AWS Bedrock, Google Cloud Vertex AI ve Microsoft Foundry’de ve Claude Code, Cursor ve GitHub Copilot’ta mevcuttur.
Kodlama için hangisi daha iyi, GPT-6 Sol mu Claude Opus 5.5 mi?
Yayımlanan kıyaslamalarda Claude Opus 5.5 önde: Anthropic, Terminal-Bench 4.0’da %66,4 ve FrontierCode’da %54,4 rapor ederken, OpenAI, GPT-6 Sol’un FrontierCode’da Claude Fable 5.1’i eşleştirdiğini söylüyor; Anthropic, Fable 5.1’i %50,3 olarak puanlıyor. Uygulamalı testimizde, yerçekimi tersine sahip tek dosyalık bir Tetris klonunda, her iki model de mantığı doğru yaptı ve GPT-6 Sol, cila ve hissiyat açısından Opus 5.5’e karşı 5,0’a 4,3 skorla öne çıktı.




Anthropic’in yeni modeline gösterilen ilgi, daha verimli ve uygun maliyetli sınır modelleri yarışında yaklaşık bir saat sürdü.
Claude Opus 5.5, Claude 5.5 ailesindeki ilk model; Opus 5’ten daha düşük çalıştırma maliyetinde Fable 5.1 düzeyinde performans vaat ediyor.
OpenAI çok hızlı yanıt verdi ve GPT-6 ailesinin orta segmenti olarak GPT-6 Sol’u yayımladı; amiral gemisi GPT-6 Astra ile aynı yöntemlerle eğitildi ve selefi GPT-5.6 Sol’un API fiyatının yarısına sunuldu.
Bu yazıda, GPT-6 Sol ve Claude Opus 5.5’i çok sayıda performans kategorisi, güvenlik şeritleri ve fiyatlandırma açısından karşılaştıracağım ve ikisi üzerinde çalıştırdığım bir uygulamalı kurulum testini de ekleyeceğim.
Özet
GPT-6 Sol Nedir?
GPT-6 Sol, OpenAI’ın orta segment GPT-6 modeli; 22 Eylül 2026’da GPT-6 Luna ile birlikte yayımlandı ve amiral gemisi GPT-6 Astra’nın altında konumlanıyor.
Öne çıkan yanı, Astra’nın eğitim tarifesini GPT-5.6 Sol’un API fiyatının yarısına sunması ve muhakeme çabası veya araçlar konuşma ortasında değişse bile ayakta kalan komut önbelleğidir.
GPT-6 Sol ve Luna rehberimiz lansmanı kapsıyor; GPT-6 Astra API eğitimi ise ailenin eşzamanlı olmayan araçlarını ve yönlendirmeyi adım adım anlatıyor.
Claude Opus 5.5 Nedir?
Claude Opus 5.5, Anthropic’in Claude 5.5 ailesindeki ilk modelidir; 22 Eylül 2026’da yayımlandı ve uzun süreli ajan-kodlama ile bilgi işlerinde şirketin yeni önde gelen modeli olarak konumlandı.
Öne çıkan yanı, Opus fiyatına Fable sınıfı sonuçlar: Anthropic, çoğu işte Claude Fable 5.1’i yakaladığını ve Fable sınıfı siber güvenlik ve biyoloji korumalarıyla geldiğini söylüyor.
Opus 5.5 rehberimiz lansmanı kapsıyor; Claude Opus 5 API eğitimi ise önceki neslin API’sini anlatıyor.
GPT-6 Sol vs Claude Opus 5.5: Bire Bir Karşılaştırma
Yayın zamanlamalarının yakınlığı nedeniyle, hiçbir sağlayıcı lansman tablosunda diğerinin yeni modelini listelemedi; bu yüzden iki model sadece iki kıyaslamada çakışıyor ve her ikisinde de Opus 5.5 önde. Sol’un gerekçesi fiyat ve kendi testimizde nasıl dayandığı.
none’danmax’a kadar çaba; GPT-5.6 Sol’dan daha az yanıltıcı kodlama iddiasıKodlama ve ajan iş akışları
Opus 5.5 daha güçlü ajan-kodlama sayılarını yayımlıyor ve Sol’un gönderisi bunları doğrudan tartışmıyor. Anthropic, Opus 5.5’i Terminal-Bench 4.0, FrontierCode ve CursorBench üzerinde raporluyor; OpenAI, Sol’u DeepSWE üzerinde raporluyor ve FrontierCode sonucunu yalnızca xhigh çabada Claude Fable 5.1 ile eşleşiyor diye tanımlıyor. Anthropic, Fable 5.1’i FrontierCode’da %50,3, Opus 5.5’i %54,4 olarak veriyor; her iki iddia da doğruysa, iki satıcının da andığı tek kodlama kıyaslamasında Sol, Opus 5.5’in yaklaşık dört puan gerisinde duruyor.
İki sağlayıcı da paylaşılan puanlar yerine uzun ufuklu anekdotlara yaslanıyor. Anthropic’in C’den Rust’a HAProxy yeniden yazımı, Opus 5.5’in Fable 5.1’e göre %51 daha düşük maliyetle 9,5 saatte bitirdiğini bildiriyor (Fable 12 saatte). OpenAI’ın argümanı ise görev başına maliyet: Sol, Fable 5’in DeepSWE skorunun yaklaşık bir puan yakınına, yaklaşık %80 daha düşük maliyetle iniyor.
Bu tabloları temkinle okumanız için iki neden:
Kağıt üzerinde Opus 5.5 daha güçlü bir kodlama modeli; aşağıdaki tek kurulum testimizde bu fark görünmedi.
İş iş akışları ve bilgisayar kullanımı
Opus 5.5, iki modelin paylaştığı iki kıyaslamanın ikisinde de önde ve AutomationBench farkı bu yazıdaki en temiz sayı: 47 iş aracında çalışan ajanların Zapier testinde Opus 5.5 %40,0, Sol %33,2.
Sol’un karşı argümanı fatura: OpenAI, Sol’u Claude Opus 5’e göre görev başına maliyetin %9’una indi diye çerçeveliyor; ancak bu karşılaştırma önceki Opus’la, bununla değil.
Puan bazında daha güçlü ajan Opus 5.5; her bilete koşabileceğiniz model ise Sol.
Bilgi işi ve olgusal güvenilirlik
Burada çapraz sağlayıcı tek sayı Opus 5.5’te: GDPval-AA v2.1’de 1846 Elo; Anthropic’in tablosunda GPT-6 Astra ve GPT-5.6 Sol’un önünde; Sol’un kendisi listelenmiyor. Anthropic’in rapor yazma testinde, uydurulan herhangi bir rakam koşuyu başarısız saydırıyor; Opus 5.5’in 18 raporundan 16’sı geçti, Fable 5.1 ve Opus 5 hiç geçemedi.
Sol’un kanıtı kendi selefine karşı: OpenAI’ın iç olgusallık setinde, Sol, GPT-5.6 Sol’a kıyasla yaklaşık yarı yarıya daha az hata yapıyor. Artificial Analysis’in AA-Omniscience testi de aynı fikirde, ama bir notla: Sol’un halüsinasyon oranı %92’den %60’a düşerken, soruların yalnızca %83’ünü yanıtladı; selefi %99’u yanıtlıyordu.
Her ikisi de seleflerine göre daha dikkatli; rakibe karşı bunu gösteren yalnızca Opus 5.5.
Güvenlik şeritleri ve API kısıtları
Sol daha az kısıtlı bir API, Opus 5.5 ise daha fazla gözetimli.
Opus 5.5’te düşünme kapatılamaz, zorunlu araç kullanımı reddedilir ve düşünme blokları, onları üreten model ve konuşmaya bağlanır; bu nedenle düzenlenmiş bağlam 31 Ağustos 2026’dan sonra açılmış hesaplarda 400 hatası verir. Çoğu siber güvenlik görevi Siber Doğrulama Programı dışında Opus 4.8’e yönlendirilir ve biyoloji çalışmaları için Yaşam Bilimleri Doğrulama Programı gerekir.
Sol’un merdiveni
none’danmax’a uzanır, çaba konuşma ortasında önbelleği bozmadan değiştirilebilir ve OpenAI, kodlama işi hakkında GPT-5.6 Sol’a kıyasla daha az yanıltıcı iddia raporlar.Bu değiş tokuş bilinçli: Opus 5.5, gözetimsiz ajanlar için önemli olan, sınırları ihlal etmeye Opus 5’e kıyasla yaklaşık %85 daha az yeltendi.
Fiyatlandırma: gerçekte ne ödersiniz
Manşet oranlarda Opus 5.5 tam olarak Sol’un iki katına mal oluyor; ancak ajanların gerçekte ücret ödediği iki mekanizma deseni bozar: önbellekten okuma aynı fiyatta ve Sol, Anthropic’in koymadığı 272K token üzeri bir ek ücret uygular.
Token oranları yan yana
Prim, girdi, çıktı ve önbelleğe yazmada düz; bu da önbellek veya uzun bağlam devreye girene kadar her iş yükü biçimini eşit etkiler. Önbellekten okumalar istisnadır ve Anthropic, ajan ve kodlama işlerinin maliyetinin çoğunu bunların oluşturduğunu söylüyor. Hiçbir sağlayıcı muhakeme tokenları için ayrı oran yayımlamıyor; bu yüzden bunları çıktı oranından bütçeleyin.
Gerçek bir iş yükü kaça patlar
Eşik üstü satır manşet: Her istek eşiği aştığında, Sol’un ek ücreti faturasını Opus 5.5’in %8 yakınına çıkarıyor; bu yüzden uzun bağlamlı bir getirme hattı Sol’u seçmekten neredeyse hiç indirim görmüyor. Önbellek ağırlıklı döngü ise farklı bir nedenle farkı %33’e daraltıyor: 1.000 önbellek okuması her iki modelde aynı fiyatta, yalnızca taze tokenlar 2x primi taşıyor.
İki model farklı belirteçleyiciler kullanıyor ve hiçbir sağlayıcı paylaşılan bir iş yükü için token sayıları yayımlamadı; bu yüzden bu toplamları fatura değil, oran karşılaştırması olarak değerlendirin. Anthropic, Opus 5.5’in görev başına Opus 5’ten daha az token kullandığını söylüyor, ancak Sol ile karşılaştırması hakkında bilgi yok.
GPT-6 Sol ve Claude Opus 5.5 Nasıl Performans Gösterdi
Birbirinin modelini test etmeyen iki sağlayıcının kıyaslamaları bir yere kadar; bu yüzden ikisine de aynı istem ve aynı araçlarla tek bir kurulum görevi koştum.
Test
İkisine de 12×24 tahtada tek dosyalık bir Tetris klonu yapmalarını istedim, bir bükülmeyle: yerçekimi her 20 saniyede bir tersine dönüyor. Bunu zor yapan iki talep var: Tersine döndükten sonra parçalar tavana doğru düşmeli ve orada oluşmuş ikinci bir yığına kilitlenmeli; her iki yığındaki dolu satırlar temizlenmeli ve kilitlenmiş hücreler asla hareket etmemeli.
Her iki model de OpenCode içinde, aynı sabitlenmiş araç yüzeyiyle çalıştı: yalnızca dosya okuma, arama ve düzenleme; kabuk yok, ağ yok. İkisi de
highmuhakeme çabasında, birer deneme, yeniden deneme yok ve istem, baytına kadar aynı olacak şekilde taze bir oturuma verildi.Aklınızda tutmanız gereken bir asimetri:
highher iki merdivende de tavandan iki basamak aşağıda, ancak Sol’un merdiveninde altta fazladan birnonebasamağı var; dolayısıylahigh, Sol’da altı ayarın dördüncüsü, Opus 5.5’te beş ayarın üçüncüsü.İstem şuydu:
Maliyeti kaydettim ve ikisini de aşağıdaki üç rubriğe göre 1’den 5’e puanladım:
GPT-6 Sol ne üretti
Sol, 6 tur ve 9 araç çağrısı yaptı: boş çalışma alanını listeledi, aradı ve okudu; ardından 22 KB’lık bir
index.htmlyazdı ve bir kez daha yamadı. Ortaya çıkan dosyada kendi markalaması var: “Fall / Rise, a game of shifting ground”; tersine dönüşte kehribar tonundan camgöbeğine dönen bir yerçekimi paneli, bir sonraki tersine dönüşe geri sayım ve kenarda bir kural kartı.Gerekeni yapıyor ve düzgün, stabil çalışıyor: ters çevirmede zemin yığını yerinde kalıyor, parçalar yükselip tavana kilitleniyor, her iki yığında da satırlar temizleniyor ve yumuşak düşürme duyarlı hissettiriyor; bu da oynamayı ikisinden daha eğlenceli kıldı.