在从事人工智能(AI)或机器学习(ML)并需要文本转语音引擎时,开源方案往往是不二之选。下面我们来了解文本转语音(TTS)引擎的工作原理,以及一些优秀的开源选项。
在这份简明指南中,我将介绍 TTS 引擎,并列出一些值得考虑的优选方案。
什么是文本转语音(TTS)引擎?
在开始列举之前,先快速明确一下文本转语音引擎的概念。
文本转语音引擎是一种将书面文本转换为口语的软件。它利用自然语言处理(NLP)来分析和理解文本内容,并使用语音合成器生成类人语音。
TTS 引擎常见于虚拟助手、导航系统和无障碍辅助工具等应用中。
对 NLP 感兴趣?DataCamp 的Python 自然语言处理技能路径可帮助您快速提升技术能力。
什么是开源文本转语音(TTS)引擎?
开源文本转语音(TTS)引擎是将书面文本转换为口语的有用工具,可用于无障碍辅助、自动语音应答、虚拟助手等诸多场景。
这类项目通常由开发者社区共同维护,并以开源许可发布,任何人都可自由使用、修改并分发软件。
7 款最佳开源文本转语音(TTS)引擎
以下是一些知名的开源 TTS 引擎:
1. MaryTTS(多模态交互架构)
一个灵活、模块化的 TTS 系统架构,包含用于从录制的音频数据生成新声音的语音构建工具。
下图是该引擎背后的架构概览:
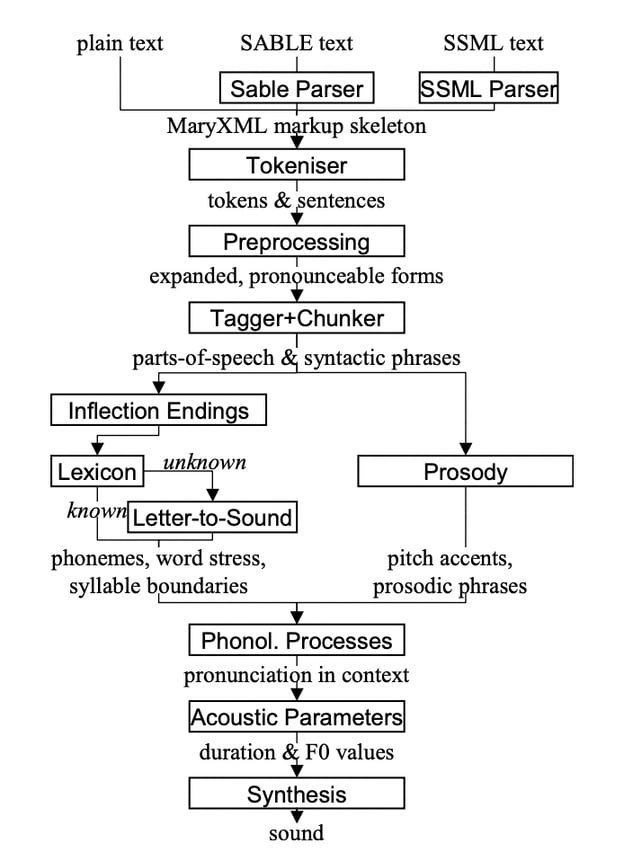
来源:MaryTTS GitHub
该架构包含一些基础组件,例如:
- 标记语言解析器:读取并解释文本字段所用标记语言的组件。
- 处理器:接收解析后文本并执行必要操作的组件,例如将其转换为语音或生成可视化输出。
- 合成器:负责生成最终输出(音频或可视化)的组件。它有助于添加语调、重音等语音特性,使输出更自然。
优点:MaryTTS 架构高度可定制,开发者可根据特定需求自行构建解析器、处理器和合成器,便于集成到不同平台和应用中。
缺点:由于可定制性强,对于不熟悉标记语言和文本转语音技术的开发者而言,上手存在一定难度。
链接:GitHub
2. eSpeak
 一款紧凑的开源语音合成器,支持英语及多种语言,能产生清晰易懂的语音,以简洁和占用资源少而著称。
eSpeak 可运行于 Windows、Linux、macOS 和 Android 等多种平台。
优点:易用,支持多种语言和声音。
缺点:功能与定制选项有限,且以 C 语言编写。
链接:GitHub
3. Festival 语音合成系统
由爱丁堡大学开发,Festival 提供了构建语音合成系统的一般框架,并包含多种模块示例,广泛用于科研和教学。
下图展示了 Festival 的一般话语结构。它采用树形结构,节点之间通过关系链接。
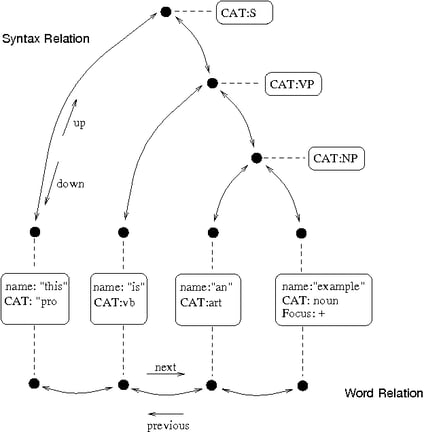
来源:Semanticscholar
优点:高度可定制,适合科研用途。
缺点:对初学者不友好,需要一定编码基础。
链接:GitHub
4. Mimic
来源:Mimic
由 Mycroft AI 开发,Mimic 能产生高度自然的语音。它包含基于 Festival 的 Mimic 1,以及使用深度神经网络进行语音合成的 Mimic 2。
优点:同时提供传统与现代的语音合成方法,支持多种语言。
缺点:文档有限。
链接:GitHub
5. Mozilla TTS
一款基于深度学习的 TTS 引擎,旨在生成更自然、更接近人声的合成语音。它采用现代神经网络架构,尤其是序列到序列模型。
优点:利用先进技术生成更自然的语音,且免费可用。
缺点:语言支持有限。
链接:GitHub
6. Tacotron 2(NVIDIA)
尽管本身并非引擎,Tacotron 2 是用于生成自然语音的神经网络模型架构。其开源实现已广泛可得,并推动了语音合成技术的诸多进展。
该系统允许用户仅凭原始文本,无需额外韵律信息,即可进行语音合成。
优点:由 NVIDIA 开发,适合作为神经网络模型使用。
缺点:实现需要一定技术背景。
虽然该引擎的技术门槛较高,您仍可通过在线资源熟悉相关的神经网络模型,例如我们的神经网络指南或神经网络教程。
链接:GitHub
7. ESPnet-TTS
作为 ESPnet 项目的一部分,该 TTS 引擎面向端到端语音处理,涵盖语音识别与合成。它使用现代深度学习技术进行语音生成。
优点:现代灵活,支持多种语言。
缺点:实现需要一定技术背景。
链接:GitHub
8. Coqui TTS
Coqui TTS 是一款现代开源文本转语音框架,提供覆盖多种语言与口音的预训练模型。其构建基于 TensorFlow,支持 Tacotron 2、FastSpeech 等神经网络 TTS 模型。
优点:
- 提供预训练模型,便于快速部署。
- 高度模块化,便于尝试不同的神经 TTS 架构。
- 活跃维护,社区强大,文档详尽。
缺点:
- 需要熟悉 TensorFlow 或 PyTorch 等深度学习框架。
- 训练自定义模型的资源消耗较大。
链接:GitHub
9. Larynx
Larynx 由 Mycroft AI 团队开发,是一款高级 TTS 系统,支持多语言并提供高质量语音合成。它基于 Tacotron 2 和 WaveGlow,能够生成自然的语音。
优点:
缺点:
-
训练与推理需要较高的计算资源。
-
与部分引擎相比,自定义选项有限。
链接:GitHub
开源 TTS 引擎对比
| TTS 系统 | 架构 | 优点 | 缺点 | 使用场景 |
|---|
| MaryTTS | 模块化架构 | 高度可定制,集成灵活 | 对开发者有学习曲线 | 适合为无障碍等项目打造定制 TTS 应用的开发者与研究人员。 |
| eSpeak | 紧凑型开源合成器 | 简洁,支持多语言 | 功能与定制有限 | 适用于需广泛语言支持且系统资源占用低的应用。 |
| Festival | 通用框架,包含模块示例 | 高度可定制,适合研究 | 对初学者不友好,需要编码 | 最适合需要深度定制与实验的学术研究与开发项目。 |
| Mimic | 传统与神经网络合成 | 语音自然,支持多语言 | 文档有限 | 适合虚拟助手、多媒体应用等高质量语音合成项目。 |
| Mozilla TTS | 基于深度学习的序列到序列模型 | 先进技术带来自然语音,免费 | 语言支持有限 | 适合采用前沿深度学习技术进行自然 TTS 的开发者。 |
| Tacotron 2 | 用于语音生成的神经网络模型 | 作为神经网络模型表现良好 | 需要技术背景 | 非常适合神经网络语音合成的研发。 |
| ESPnet-TTS | 端到端语音处理 | 现代、灵活,支持多语言 | 需要技术背景 | 面向从事高级语音合成与识别项目的开发者与研究人员。 |
| Coqui TTS | 带预训练模型的神经 TTS | 预训练模型、模块化、社区支持强 | 需要熟悉深度学习 | 适合高级定制,支持口音与多语言,面向 ML 从业者。 |
| Larynx | Tacotron 2 与 WaveGlow | 高质量、类人化语音合成 | 资源消耗大、定制受限 | 适合自然语音助手、配音或无障碍应用。 |
TTS 引擎的应用
以下是上述 TTS 引擎的一些使用方式:
1. 虚拟助手
借助上述文本转语音引擎,可以构建虚拟助手,类似企业级语音助手 Siri 和 Alexa。
其中一些还能为视障用户提供无障碍辅助,让他们以“听”的方式获取原本需要“读”的文字信息。
2. AI 语音的自动语音应答
TTS 引擎也用于自动应答系统,如电话或聊天机器人助手。这些引擎可根据特定提示与交互朗读回复,为用户提供更接近人类的体验。
3. 视频与图像配音
文本转语音技术还能为视频或图像生成配音,使内容更生动、更具吸引力。
例如,eSpeak 引擎可为不同语言的视频添加配音,从而提升可访问性并吸引更广泛的受众。
这在营销、在线学习和娱乐等行业尤其有用。
使用开源 TTS 引擎的挑战
选择开源方案具有成本效益且便于定制,但也会遇到一些挑战:
1. 语言支持有限
与商用方案相比,许多开源 TTS 引擎的语言支持较为有限。
对于需要小众语言 TTS 的用户而言,这可能成为障碍。
2. 定制与落地实施
大多数开源 TTS 引擎的定制与实施需要一定编码能力,普通业务干系人若无技术支持会较难使用。
这对缺乏技术专长的个人或组织而言是一项挑战。
3. 成本考量
尽管开源引擎可免费使用,但定制与实施可能需要额外资源与时间。
此外,还需招聘或培养具备相关 TTS 知识的工程师或分析师。
因此,在某些情况下,从长期看商用方案可能更具成本效益。
4. 支持与文档
由于资源有限且以社区驱动为主,开源项目并不总能提供完善的支持与文档。
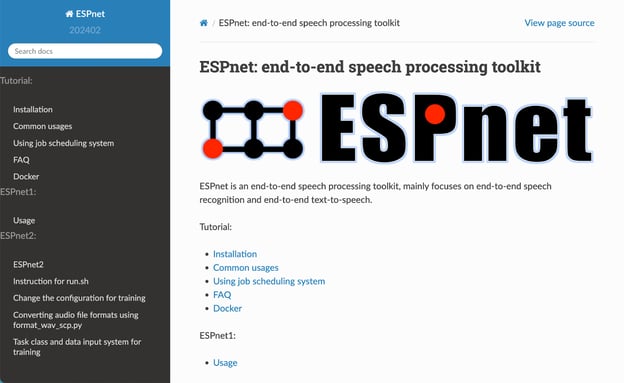
来源:ESPnet 文档
这会给问题排查与高效上手带来困难。
不过,随着这些引擎的普及以及更多开发者的参与,这一问题有望逐步缓解。
5. 安全与性能
由于开源引擎由社区开发与维护,安全与性能方面可能存在顾虑。
然而,通过对引擎代码与更新进行充分审查与监控,可在很大程度上降低风险。
此外,选择可靠、口碑良好的开源项目也有助于缓解这些担忧。
为 TTS 集成选择最佳引擎
接下来讨论如何为您的文本转语音模型选择合适的引擎。
请考虑以下因素:
1. 目的与使用场景
首先明确具体使用场景与使用 TTS 的目的。了解项目所需的功能与定制选项,再据此选择引擎。
2. 语言支持
若您需要特定语言或多语言支持,请确保选择具备相应能力的引擎。
在这种情况下,选择 eSpeak 也许更适合您。
3. 成本与预算
在选择引擎前评估预算与可用资源。虽然开源选项从长期看可能更省成本,但定制与实施会带来额外投入。
4. 技术能力
评估团队或您自身在使用 TTS 引擎时的技能水平。若缺乏技术能力,可考虑选择具备友好界面与支持的商用方案。
5. 性能与质量
确保所选引擎能提供高质量、自然的语音输出。您也可对不同引擎进行试用,找出最符合预期表现的那一款。
结语
文本转语音技术在逼近自然、类人语音方面已取得长足进步。随着众多开源方案的出现,将 TTS 集成到各类应用中变得更易获得、也更具成本效益。
但在做出决定前,您仍需预期使用开源引擎所带来的局限与挑战。希望本指南能帮助您更好地理解 TTS 引擎,并选出最符合需求的方案。
想要反向完成这一流程?欢迎查看我们的Python 口语处理课程。


在从事人工智能(AI)或机器学习(ML)并需要文本转语音引擎时,开源方案往往是不二之选。下面我们来了解文本转语音(TTS)引擎的工作原理,以及一些优秀的开源选项。
在这份简明指南中,我将介绍 TTS 引擎,并列出一些值得考虑的优选方案。
什么是文本转语音(TTS)引擎?
在开始列举之前,先快速明确一下文本转语音引擎的概念。
文本转语音引擎是一种将书面文本转换为口语的软件。它利用自然语言处理(NLP)来分析和理解文本内容,并使用语音合成器生成类人语音。
TTS 引擎常见于虚拟助手、导航系统和无障碍辅助工具等应用中。
对 NLP 感兴趣?DataCamp 的Python 自然语言处理技能路径可帮助您快速提升技术能力。
什么是开源文本转语音(TTS)引擎?
开源文本转语音(TTS)引擎是将书面文本转换为口语的有用工具,可用于无障碍辅助、自动语音应答、虚拟助手等诸多场景。
这类项目通常由开发者社区共同维护,并以开源许可发布,任何人都可自由使用、修改并分发软件。
7 款最佳开源文本转语音(TTS)引擎
以下是一些知名的开源 TTS 引擎:
1. MaryTTS(多模态交互架构)
一个灵活、模块化的 TTS 系统架构,包含用于从录制的音频数据生成新声音的语音构建工具。
下图是该引擎背后的架构概览:
来源:MaryTTS GitHub
该架构包含一些基础组件,例如:
优点:MaryTTS 架构高度可定制,开发者可根据特定需求自行构建解析器、处理器和合成器,便于集成到不同平台和应用中。
缺点:由于可定制性强,对于不熟悉标记语言和文本转语音技术的开发者而言,上手存在一定难度。
链接:GitHub
2. eSpeak
eSpeak 可运行于 Windows、Linux、macOS 和 Android 等多种平台。
优点:易用,支持多种语言和声音。
缺点:功能与定制选项有限,且以 C 语言编写。
链接:GitHub
3. Festival 语音合成系统
由爱丁堡大学开发,Festival 提供了构建语音合成系统的一般框架,并包含多种模块示例,广泛用于科研和教学。
下图展示了 Festival 的一般话语结构。它采用树形结构,节点之间通过关系链接。
来源:Semanticscholar
优点:高度可定制,适合科研用途。
缺点:对初学者不友好,需要一定编码基础。
链接:GitHub
4. Mimic
来源:Mimic
由 Mycroft AI 开发,Mimic 能产生高度自然的语音。它包含基于 Festival 的 Mimic 1,以及使用深度神经网络进行语音合成的 Mimic 2。
优点:同时提供传统与现代的语音合成方法,支持多种语言。
缺点:文档有限。
链接:GitHub
5. Mozilla TTS
一款基于深度学习的 TTS 引擎,旨在生成更自然、更接近人声的合成语音。它采用现代神经网络架构,尤其是序列到序列模型。
优点:利用先进技术生成更自然的语音,且免费可用。
缺点:语言支持有限。
链接:GitHub
6. Tacotron 2(NVIDIA)
尽管本身并非引擎,Tacotron 2 是用于生成自然语音的神经网络模型架构。其开源实现已广泛可得,并推动了语音合成技术的诸多进展。
该系统允许用户仅凭原始文本,无需额外韵律信息,即可进行语音合成。
优点:由 NVIDIA 开发,适合作为神经网络模型使用。
缺点:实现需要一定技术背景。
虽然该引擎的技术门槛较高,您仍可通过在线资源熟悉相关的神经网络模型,例如我们的神经网络指南或神经网络教程。
链接:GitHub
7. ESPnet-TTS
作为 ESPnet 项目的一部分,该 TTS 引擎面向端到端语音处理,涵盖语音识别与合成。它使用现代深度学习技术进行语音生成。
优点:现代灵活,支持多种语言。
缺点:实现需要一定技术背景。
链接:GitHub
8. Coqui TTS
Coqui TTS 是一款现代开源文本转语音框架,提供覆盖多种语言与口音的预训练模型。其构建基于 TensorFlow,支持 Tacotron 2、FastSpeech 等神经网络 TTS 模型。
优点:
缺点:
链接:GitHub
9. Larynx
Larynx 由 Mycroft AI 团队开发,是一款高级 TTS 系统,支持多语言并提供高质量语音合成。它基于 Tacotron 2 和 WaveGlow,能够生成自然的语音。
优点:
生成逼真、类人化的语音。
开箱即用地支持多种语言和声音。
与其他神经 TTS 引擎相比,设置与使用更为简便。
缺点:
训练与推理需要较高的计算资源。
与部分引擎相比,自定义选项有限。
链接:GitHub
开源 TTS 引擎对比
TTS 引擎的应用
以下是上述 TTS 引擎的一些使用方式:
1. 虚拟助手
借助上述文本转语音引擎,可以构建虚拟助手,类似企业级语音助手 Siri 和 Alexa。
其中一些还能为视障用户提供无障碍辅助,让他们以“听”的方式获取原本需要“读”的文字信息。
2. AI 语音的自动语音应答
TTS 引擎也用于自动应答系统,如电话或聊天机器人助手。这些引擎可根据特定提示与交互朗读回复,为用户提供更接近人类的体验。
3. 视频与图像配音
文本转语音技术还能为视频或图像生成配音,使内容更生动、更具吸引力。
例如,eSpeak 引擎可为不同语言的视频添加配音,从而提升可访问性并吸引更广泛的受众。
这在营销、在线学习和娱乐等行业尤其有用。
使用开源 TTS 引擎的挑战
选择开源方案具有成本效益且便于定制,但也会遇到一些挑战:
1. 语言支持有限
与商用方案相比,许多开源 TTS 引擎的语言支持较为有限。
对于需要小众语言 TTS 的用户而言,这可能成为障碍。
2. 定制与落地实施
大多数开源 TTS 引擎的定制与实施需要一定编码能力,普通业务干系人若无技术支持会较难使用。
这对缺乏技术专长的个人或组织而言是一项挑战。
3. 成本考量
尽管开源引擎可免费使用,但定制与实施可能需要额外资源与时间。
此外,还需招聘或培养具备相关 TTS 知识的工程师或分析师。
因此,在某些情况下,从长期看商用方案可能更具成本效益。
4. 支持与文档
由于资源有限且以社区驱动为主,开源项目并不总能提供完善的支持与文档。
来源:ESPnet 文档
这会给问题排查与高效上手带来困难。
不过,随着这些引擎的普及以及更多开发者的参与,这一问题有望逐步缓解。
5. 安全与性能
由于开源引擎由社区开发与维护,安全与性能方面可能存在顾虑。
然而,通过对引擎代码与更新进行充分审查与监控,可在很大程度上降低风险。
此外,选择可靠、口碑良好的开源项目也有助于缓解这些担忧。
为 TTS 集成选择最佳引擎
接下来讨论如何为您的文本转语音模型选择合适的引擎。
请考虑以下因素:
1. 目的与使用场景
首先明确具体使用场景与使用 TTS 的目的。了解项目所需的功能与定制选项,再据此选择引擎。
2. 语言支持
若您需要特定语言或多语言支持,请确保选择具备相应能力的引擎。
在这种情况下,选择 eSpeak 也许更适合您。
3. 成本与预算
在选择引擎前评估预算与可用资源。虽然开源选项从长期看可能更省成本,但定制与实施会带来额外投入。
4. 技术能力
评估团队或您自身在使用 TTS 引擎时的技能水平。若缺乏技术能力,可考虑选择具备友好界面与支持的商用方案。
5. 性能与质量
确保所选引擎能提供高质量、自然的语音输出。您也可对不同引擎进行试用,找出最符合预期表现的那一款。
结语
文本转语音技术在逼近自然、类人语音方面已取得长足进步。随着众多开源方案的出现,将 TTS 集成到各类应用中变得更易获得、也更具成本效益。
但在做出决定前,您仍需预期使用开源引擎所带来的局限与挑战。希望本指南能帮助您更好地理解 TTS 引擎,并选出最符合需求的方案。
想要反向完成这一流程?欢迎查看我们的Python 口语处理课程。