

Corso
Feature Engineering per NLP in Python
4 ore
29.8K
Pratica and corso your progress.
Continua Con GoogleLavori con l'intelligenza artificiale (AI) o il machine learning (ML) e ti serve un motore di sintesi vocale? In tal caso, ti servirà una soluzione open source. Vediamo come funzionano i motori di text-to-speech (TTS) e alcune delle migliori opzioni open source.
In questa semplice guida, ti racconterò di più sui motori TTS e ti elencherò alcune delle migliori opzioni disponibili.
Prima di iniziare con l'elenco, definiamo rapidamente che cos'è un motore di sintesi vocale.
Un motore di text-to-speech è un software che converte il testo scritto in parole pronunciate. Utilizza il natural language processing (NLP) per analizzare e interpretare il testo scritto e poi usa un sintetizzatore vocale per generare un parlato simile a quello umano.
I motori TTS sono comunemente usati in applicazioni come assistenti virtuali, sistemi di navigazione e strumenti per l'accessibilità.
Ti interessa lavorare con l'NLP? Il percorso di competenze di DataCamp Natural Language Processing in Python ti aiuterà a metterti al passo dal punto di vista tecnico.
I motori Text-to-Speech (TTS) open source sono strumenti preziosi per convertire il testo scritto in parole pronunciate, abilitando applicazioni in ambiti come accessibilità, risposte vocali automatiche e assistenti virtuali, tra gli altri.
Sono di solito sviluppati da una comunità di sviluppatori e rilasciati con licenza open source, consentendo a chiunque di usare, modificare e distribuire liberamente il software.
Ecco alcuni motori TTS open source molto conosciuti:
Un'architettura flessibile e modulare per costruire sistemi TTS, che include uno strumento per la creazione di voci in grado di generare nuove voci da dati audio registrati.
Ecco un diagramma panoramico dell'architettura alla base di questo motore:
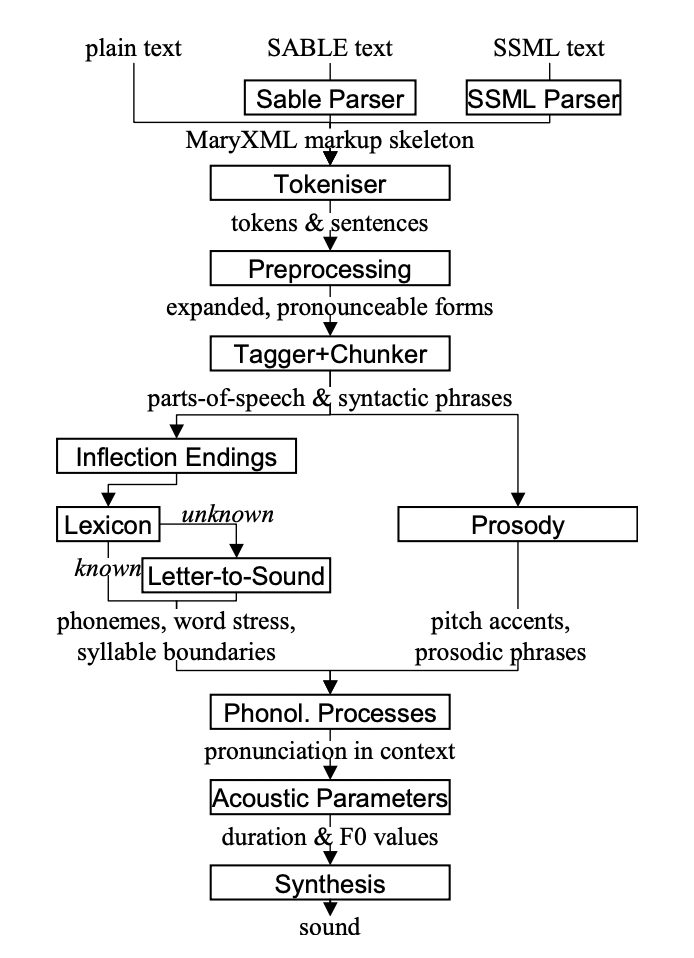
Fonte: MaryTTS GitHub
Questa architettura include alcuni componenti di base come:
Pro: L'architettura di MaryTTS è altamente personalizzabile, permettendo agli sviluppatori di creare i propri parser, processori e sintetizzatori per soddisfare esigenze specifiche. Questo consente anche flessibilità nell'integrazione del software su diverse piattaforme e applicazioni.
Contro: A causa dell'elevata personalizzazione, potrebbe esserci una curva di apprendimento per gli sviluppatori che non hanno familiarità con il linguaggio di markup e la tecnologia TTS.
Link: GitHub
 Un sintetizzatore vocale open source compatto per l'inglese e altre lingue, eSpeak produce un parlato chiaro e comprensibile in una vasta gamma di lingue. È noto per la sua semplicità e l'impronta ridotta.
eSpeak può essere eseguito su varie piattaforme, tra cui Windows, Linux, macOS e Android.
Pro: Facile da usare, supporta molte lingue e voci.
Contro: Funzionalità e opzioni di personalizzazione limitate, ed è scritto in C.
Link: GitHub
Sviluppato dall'Università di Edimburgo, Festival offre un framework generale per costruire sistemi di sintesi vocale e include esempi di vari moduli. È ampiamente usato per scopi di ricerca e formazione.
La figura seguente mostra la struttura generale dell'enunciato in Festival. Si tratta di una forma ad albero con collegamenti tra nodi che mostrano una relazione.
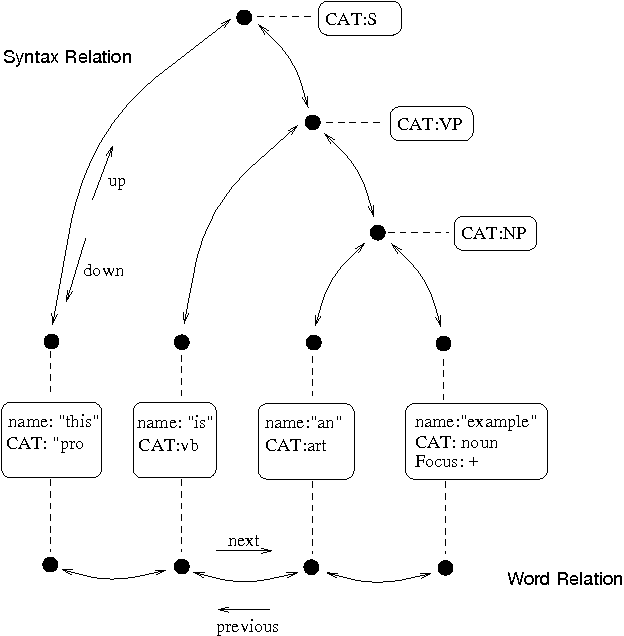
Fonte: Semanticscholar
Pro: Altamente personalizzabile, adatto alla ricerca.
Contro: Difficile per chi è alle prime armi, richiede conoscenze di programmazione.
Link: GitHub
4. Mimic
Fonte: Mimic
Sviluppato da Mycroft AI, Mimic è in grado di produrre un parlato dal suono molto naturale. Include Mimic 1, basato sul Festival Speech Synthesis System, e Mimic 2, che utilizza reti neurali profonde per la sintesi vocale.
Pro: Offre sia metodi di sintesi tradizionali sia moderni e supporta più lingue.
Contro: Documentazione limitata.
Link: GitHub
Un motore TTS basato sul deep learning che mira a creare una sintesi vocale più naturale e simile a quella umana. Sfrutta architetture di reti neurali moderne, in particolare modelli sequence-to-sequence.
Pro: Usa tecnologie avanzate per un parlato più naturale ed è gratuito.
Contro: Supporto linguistico limitato.
Link: GitHub
Sebbene non sia un motore in sé, Tacotron 2 è un'architettura di modello a rete neurale per generare parlato naturale. Sono disponibili implementazioni open source di Tacotron 2 e ha ispirato molti sviluppi nella tecnologia di sintesi vocale.
Questo sistema consente di sintetizzare il parlato usando trascrizioni grezze senza informazioni aggiuntive sulla prosodia.
Pro: Sviluppato da NVIDIA, valido da usare come modello di rete neurale.
Contro: Richiede una certa competenza tecnica per l'implementazione.
Anche se questo motore può essere piuttosto complesso da padroneggiare, puoi sempre familiarizzare con modelli di reti neurali correlati tramite risorse online. Un esempio sono la nostra guida alle reti neurali o il nostro tutorial sulle reti neurali.
Link: GitHub
Parte del progetto ESPnet, questo motore TTS è progettato per l'elaborazione vocale end-to-end, includendo sia il riconoscimento sia la sintesi del parlato. Usa tecniche moderne di deep learning per generare il parlato.
Pro: Moderno e flessibile, supporta più lingue.
Contro: Richiede competenze tecniche per l'implementazione.
Link: GitHub
Coqui TTS è un moderno framework open source per la sintesi vocale che offre una serie di modelli preaddestrati per varie lingue e accenti. Costruito su TensorFlow, supporta modelli TTS basati su reti neurali come Tacotron 2, FastSpeech e altri.
Pro:
Contro:
Link: GitHub
Larynx, sviluppato dal team di Mycroft AI, è un sistema TTS avanzato che offre una sintesi vocale di alta qualità con supporto per più lingue. Si basa su Tacotron 2 e WaveGlow per una generazione del parlato dal suono naturale.
Pro:
Produce una sintesi vocale realistica e simile a quella umana.
Supporta un'ampia gamma di lingue e voci subito pronte all'uso.
Semplice da configurare e usare rispetto ad altri motori TTS neurali.
Contro:
Richiede risorse computazionali significative per addestramento e inferenza.
Opzioni di personalizzazione limitate rispetto ad alcuni altri motori.
Link: GitHub
| Sistema TTS | Architettura | Pro | Contro | Casi d'uso |
|---|---|---|---|---|
| MaryTTS | Architettura modulare | Altamente personalizzabile, integrazione flessibile | Curva di apprendimento per gli sviluppatori | Ideale per sviluppatori e ricercatori che creano applicazioni TTS personalizzate, soprattutto in progetti di accessibilità. |
| eSpeak | Sintetizzatore open source compatto | Semplice, supporta molte lingue | Funzionalità e personalizzazione limitate | Adatto ad applicazioni che richiedono ampio supporto linguistico e minime risorse di sistema. |
| Festival | Framework generale con esempi di moduli | Altamente personalizzabile, adatto alla ricerca | Difficile per principianti, richiede programmazione | Ottimo per ricerca accademica e progetti di sviluppo che necessitano profonda personalizzazione e sperimentazione. |
| Mimic | Sintesi tradizionale e a rete neurale | Parlato naturale, supporta più lingue | Documentazione limitata | Indicato per progetti di sintesi vocale di alta qualità, come assistenti virtuali o app multimediali. |
| Mozilla TTS | Basato su deep learning, modelli seq-to-seq | Tecnologia avanzata per parlato naturale, gratuito | Supporto linguistico limitato | Ideale per sviluppatori che usano tecniche di deep learning all'avanguardia per TTS dal suono naturale. |
| Tacotron 2 | Modello a rete neurale per generazione del parlato | Valido come modello di rete neurale | Richieste competenze tecniche | Perfetto per ricerca e sviluppo nella sintesi vocale basata su reti neurali. |
| ESPnet-TTS | Elaborazione vocale end-to-end | Moderno e flessibile, supporta più lingue | Richieste competenze tecniche | Pensato per sviluppatori e ricercatori che lavorano su progetti avanzati di sintesi e riconoscimento vocale. |
| Coqui TTS | TTS neurale con modelli preaddestrati | Modelli preaddestrati, modulare, forte supporto della community | Richiede familiarità con il deep learning | Ottimo per personalizzazione avanzata, supporto ad accenti e lingue, adatto a professionisti del ML. |
| Larynx | Tacotron 2 e WaveGlow | Sintesi vocale di alta qualità, simile all'umano | Intensivo in risorse, personalizzazione limitata | Ideale per assistenti vocali dal suono naturale, voiceover o applicazioni di accessibilità. |
Ecco alcuni modi in cui è possibile usare i motori TTS sopra citati:
Attraverso l'uso di motori di text-to-speech come quelli menzionati, si possono creare assistenti virtuali. Questi assistenti possono essere simili ad assistenti vocali enterprise come Siri e Alexa.
Alcuni possono persino essere usati per l'assistenza all'accessibilità per utenti con disabilità visive, consentendo loro di ascoltare il testo scritto invece di leggerlo.
I motori TTS sono usati anche in sistemi di risposta automatica, come assistenti telefonici o chatbot. Questi motori possono leggere risposte basate su prompt e interazioni specifiche, offrendo un'esperienza più simile a quella umana.
La tecnologia di sintesi vocale può anche generare voiceover per video o immagini, consentendo contenuti più dinamici e coinvolgenti.
Ad esempio, il motore eSpeak può essere usato per aggiungere voiceover ai video in diverse lingue, rendendoli più accessibili e interessanti per un pubblico più ampio.
Ciò è particolarmente utile in applicazioni nei settori marketing, e-learning e intrattenimento.
Usare un'opzione open source può essere conveniente e offrire maggiore flessibilità di personalizzazione. Tuttavia, ci sono alcune sfide legate all'uso di questi motori:
Molti motori TTS open source hanno un supporto linguistico limitato rispetto alle soluzioni commerciali.
Questa limitazione può rappresentare un ostacolo per chi ha bisogno del TTS in lingue meno diffuse.
La maggior parte dei motori TTS open source richiede competenze di programmazione per personalizzazione e implementazione. Questo rende difficile per i normali stakeholder aziendali usarli senza supporto tecnico.
Può quindi essere una sfida per persone o organizzazioni senza competenze tecniche.
Sebbene i motori open source siano gratuiti, possono richiedere risorse e tempo aggiuntivi per personalizzazione e implementazione.
Inoltre, è necessario assumere o formare un ingegnere o un analista con il know-how pertinente sui motori TTS.
Pertanto, in alcuni casi, le soluzioni commerciali possono risultare più convenienti nel lungo periodo.
Avendo risorse limitate ed essendo guidati dalla community, i progetti open source potrebbero non avere sempre supporto e documentazione estesi.
Fonte: Documentazione ESPnet
Ciò può rendere difficile per gli utenti risolvere problemi o imparare a usare efficacemente il motore.
Tuttavia, man mano che questi motori acquistano popolarità e sempre più sviluppatori vi contribuiscono, questa sfida potrebbe attenuarsi nel tempo.
Poiché i motori open source sono sviluppati e mantenuti da una comunità, possono sorgere preoccupazioni su sicurezza e prestazioni.
Tuttavia, questi rischi possono essere mitigati tramite un'adeguata verifica e monitoraggio del codice e degli aggiornamenti del motore.
Inoltre, scegliere progetti open source affidabili e di buona reputazione può aiutare ad alleviare queste preoccupazioni.
Parliamo ora di come selezionare il motore giusto per il tuo modello di sintesi vocale.
Ecco alcuni fattori da considerare:
Inizia identificando il tuo caso d'uso specifico e lo scopo dell'utilizzo del TTS. Comprendi quali funzionalità e opzioni di personalizzazione sono necessarie per il tuo progetto e scegli di conseguenza un motore.
Se ti serve il supporto per una lingua specifica o per più lingue, assicurati di selezionare un motore che offra tali capacità.
In tal caso, optare per il motore eSpeak potrebbe essere un'opzione migliore per te.
Considera budget e risorse prima di selezionare un motore. Sebbene le opzioni open source possano risultare convenienti nel lungo periodo, potrebbero richiedere risorse aggiuntive per personalizzazione e implementazione.
Valuta il livello di competenza del tuo team o il tuo quando lavori con i motori TTS. Se non hai competenze tecniche, considera una soluzione commerciale che offra interfacce user-friendly e supporto.
Assicurati che il motore scelto fornisca un output vocale di alta qualità e dal suono naturale. Potresti anche testare motori diversi per vedere quale corrisponde meglio al livello di prestazioni desiderato.
La tecnologia di sintesi vocale ha compiuto grandi passi nel fornire un output più naturale e simile a quello umano. Con le numerose opzioni open source disponibili, integrare il TTS in varie applicazioni è ora più accessibile e conveniente.
Tuttavia, prima di prendere una decisione, dovrai anche considerare alcune limitazioni e sfide legate all'uso di motori open source. Spero che questa guida ti abbia fornito una migliore comprensione dei motori TTS e ti abbia aiutato a scegliere quello più adatto alle tue esigenze.
Stai cercando modi per fare il processo inverso? Dai un'occhiata al nostro corso Spoken Language Processing in Python.
Approfondisci l'NLP con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



