
Kursus
Rekayasa Fitur untuk NLP di Python
4 jam
29.7K
Bekerja dengan kecerdasan buatan (AI) atau pembelajaran mesin (ML) dan membutuhkan mesin teks-ke-ucapan? Jika demikian, Anda memerlukan solusi open source. Mari kita telusuri cara kerja mesin teks-ke-ucapan (TTS) dan beberapa opsi open source terbaik.
Dalam panduan sederhana ini, saya akan berbagi lebih banyak tentang mesin TTS dan mencantumkan beberapa opsi terbaik yang tersedia.
Sebelum kita mulai dengan daftarnya, mari kita definisikan secara singkat apa sebenarnya mesin teks-ke-ucapan.
Mesin teks-ke-ucapan adalah perangkat lunak yang mengonversi teks tertulis menjadi kata-kata yang diucapkan. Ini memanfaatkan pemrosesan bahasa alami (NLP) untuk menganalisis dan menafsirkan teks tertulis lalu menggunakan penyintesis ucapan untuk menghasilkan ucapan yang menyerupai manusia.
Mesin TTS umum digunakan dalam aplikasi seperti asisten virtual, sistem navigasi, dan alat aksesibilitas.
Tertarik bekerja dengan NLP? Jalur keterampilan DataCamp Natural Language Processing in Python akan membantu Anda mengejar ketertinggalan kemampuan teknis Anda.
Mesin Teks-ke-Ucapan (TTS) open source adalah alat berharga untuk mengonversi teks tertulis menjadi kata-kata yang diucapkan, memungkinkan penerapan dalam aksesibilitas, respons suara otomatis, dan asisten virtual, di antara bidang lainnya.
Biasanya dikembangkan oleh komunitas pengembang dan dirilis di bawah lisensi open source, sehingga siapa pun dapat menggunakan, memodifikasi, dan mendistribusikan perangkat lunak tersebut secara bebas.
Berikut beberapa mesin TTS open source yang terkenal:
Arsitektur yang fleksibel dan modular untuk membangun sistem TTS, termasuk alat pembuat suara untuk menghasilkan suara baru dari data audio yang direkam.
Berikut adalah diagram ikhtisar arsitektur di balik mesin ini:
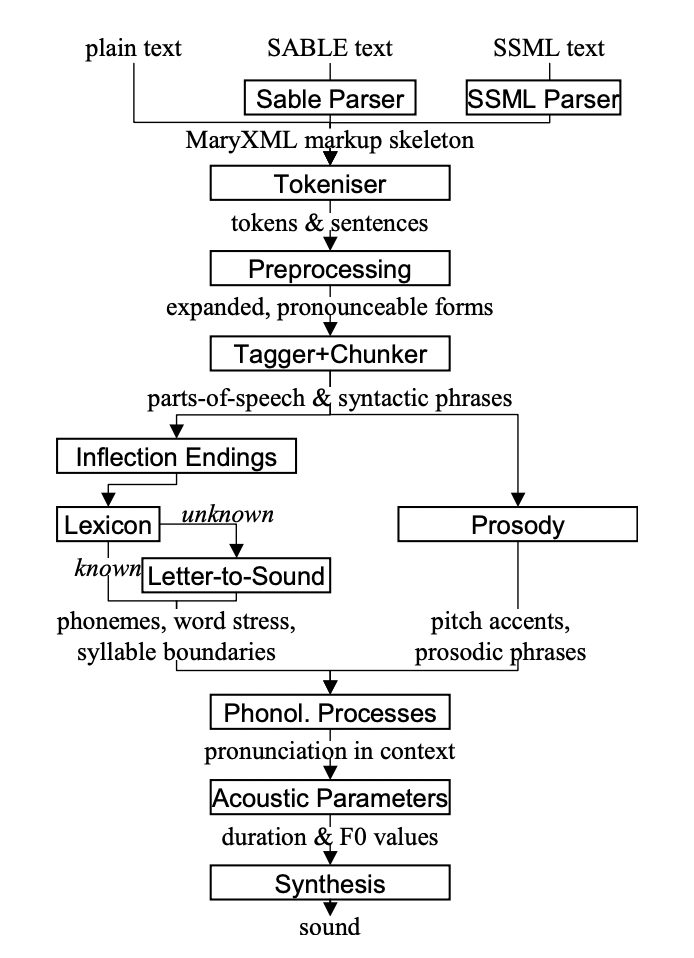
Sumber: MaryTTS GitHub
Arsitektur ini mencakup beberapa komponen dasar seperti:
Kelebihan: Arsitektur MaryTTS sangat dapat dikustomisasi, memungkinkan pengembang membuat parser, prosesor, dan penyintesis mereka sendiri agar sesuai dengan kebutuhan spesifik. Ini juga memungkinkan fleksibilitas dalam mengintegrasikan perangkat lunak ke berbagai platform dan aplikasi.
Kekurangan: Karena sifatnya yang sangat dapat dikustomisasi, mungkin ada kurva pembelajaran bagi pengembang yang tidak terbiasa dengan bahasa markup dan teknologi teks-ke-ucapan.
Tautan: GitHub
 Sintesis ucapan perangkat lunak open source yang ringkas untuk bahasa Inggris dan bahasa lain, eSpeak menghasilkan ucapan yang jelas dan mudah dipahami di berbagai bahasa. Dikenal karena kesederhanaan dan jejak yang kecil.
eSpeak dapat dijalankan di berbagai platform, termasuk Windows, Linux, macOS, dan Android.
Kelebihan: Mudah digunakan, mendukung banyak bahasa dan suara.
Kekurangan: Fitur dan opsi kustomisasi terbatas, dan ditulis dalam C.
Tautan: GitHub
Dikembangkan oleh University of Edinburgh, Festival menawarkan kerangka umum untuk membangun sistem sintesis ucapan sekaligus menyertakan contoh berbagai modul. Banyak digunakan untuk penelitian dan tujuan pendidikan.
Gambar di bawah menunjukkan struktur ujaran umum Festival. Ini melibatkan bentuk pohon dengan tautan antar node yang menunjukkan relasi.
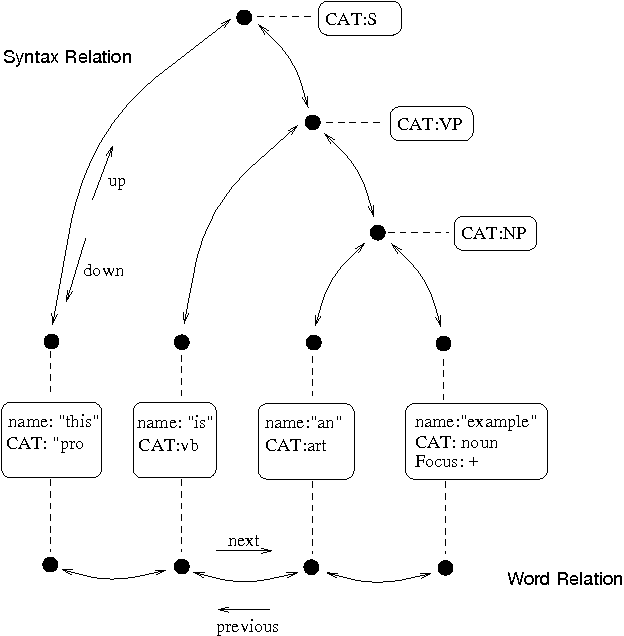
Sumber: Semanticscholar
Kelebihan: Sangat dapat dikustomisasi, cocok untuk penelitian.
Kekurangan: Sulit digunakan untuk pemula, memerlukan pengetahuan pemrograman.
Tautan: GitHub
4. Mimic
Sumber: Mimic
Dikembangkan oleh Mycroft AI, Mimic mampu menghasilkan ucapan yang sangat natural. Termasuk Mimic 1, yang berbasis pada Festival Speech Synthesis System, dan Mimic 2, yang menggunakan jaringan saraf dalam untuk sintesis suara.
Kelebihan: Menawarkan metode sintesis suara tradisional dan modern serta mendukung banyak bahasa.
Kekurangan: Dokumentasi terbatas.
Tautan: GitHub
Mesin TTS berbasis pembelajaran mendalam yang bertujuan menciptakan sintesis ucapan yang lebih natural dan menyerupai manusia. Memanfaatkan arsitektur jaringan saraf modern, khususnya model sequence-to-sequence.
Kelebihan: Menggunakan teknologi canggih untuk ucapan yang lebih natural dan gratis digunakan.
Kekurangan: Dukungan bahasa terbatas.
Tautan: GitHub
Meskipun bukan mesin pada hakikatnya, Tacotron 2 adalah arsitektur model jaringan saraf untuk menghasilkan ucapan natural. Implementasi open source dari Tacotron 2 tersedia, dan model ini menginspirasi banyak pengembangan dalam teknologi sintesis ucapan.
Sistem ini memungkinkan pengguna menyintesis ucapan menggunakan transkrip mentah tanpa informasi prozodi tambahan.
Kelebihan: Dikembangkan oleh NVIDIA, baik digunakan sebagai model jaringan saraf.
Kekurangan: Memerlukan pengetahuan teknis untuk mengimplementasikan.
Meski mesin ini bisa cukup sulit dikuasai secara teknis, Anda selalu dapat membiasakan diri dengan model jaringan saraf terkait melalui sumber daya online. Salah satunya adalah panduan jaringan saraf kami atau tutorial tentang jaringan saraf kami.
Tautan: GitHub
Bagian dari proyek ESPnet, mesin TTS ini dirancang untuk pemrosesan ucapan end-to-end, termasuk pengenalan dan sintesis ucapan. Menggunakan teknik deep learning modern untuk menghasilkan ucapan.
Kelebihan: Modern dan fleksibel, mendukung banyak bahasa.
Kekurangan: Memerlukan pengetahuan teknis untuk mengimplementasikan.
Tautan: GitHub
Coqui TTS adalah kerangka kerja teks-ke-ucapan open source modern yang menyediakan beragam model pra-latih untuk berbagai bahasa dan aksen. Dibangun di atas TensorFlow, kerangka ini mendukung model TTS berbasis jaringan saraf seperti Tacotron 2, FastSpeech, dan lainnya.
Kelebihan:
Kekurangan:
Tautan: GitHub
Larynx, dikembangkan oleh tim Mycroft AI, adalah sistem TTS canggih yang menawarkan sintesis suara berkualitas tinggi dengan dukungan untuk banyak bahasa. Sistem ini berbasis pada Tacotron 2 dan WaveGlow untuk menghasilkan ucapan yang terdengar natural.
Kelebihan:
Menghasilkan sintesis suara yang realistis dan menyerupai manusia.
Mendukung berbagai bahasa dan suara secara langsung.
Lebih mudah disiapkan dan digunakan dibandingkan mesin TTS neural lainnya.
Kekurangan:
Memerlukan sumber daya komputasi yang signifikan untuk pelatihan dan inferensi.
Opsi kustomisasi terbatas dibandingkan beberapa mesin lain.
Tautan: GitHub
| Sistem TTS | Arsitektur | Kelebihan | Kekurangan | Kasus penggunaan |
|---|---|---|---|---|
| MaryTTS | Arsitektur modular | Sangat dapat dikustomisasi, integrasi fleksibel | Kurva pembelajaran bagi pengembang | Ideal bagi pengembang dan peneliti yang membuat aplikasi TTS khusus, terutama pada proyek aksesibilitas. |
| eSpeak | Penyintesis open source yang ringkas | Sederhana, mendukung banyak bahasa | Fitur dan kustomisasi terbatas | Cocok untuk aplikasi yang memerlukan dukungan bahasa luas dan sumber daya sistem minimal. |
| Festival | Kerangka umum dengan contoh modul | Sangat dapat dikustomisasi, cocok untuk penelitian | Sulit untuk pemula, memerlukan pengkodean | Terbaik untuk penelitian akademis dan proyek pengembangan yang membutuhkan kustomisasi mendalam dan eksperimen. |
| Mimic | Sintesis tradisional dan jaringan saraf | Ucapan terdengar natural, mendukung banyak bahasa | Dokumentasi terbatas | Sangat cocok untuk proyek sintesis suara berkualitas tinggi, seperti asisten virtual atau aplikasi multimedia. |
| Mozilla TTS | Berbasis pembelajaran mendalam, model seq-to-seq | Teknologi canggih untuk ucapan natural, gratis digunakan | Dukungan bahasa terbatas | Ideal bagi pengembang yang menggunakan teknik deep learning mutakhir untuk TTS yang terdengar natural. |
| Tacotron 2 | Model jaringan saraf untuk generasi ucapan | Baik sebagai model jaringan saraf | Memerlukan pengetahuan teknis | Sempurna untuk penelitian dan pengembangan sintesis ucapan berbasis jaringan saraf. |
| ESPnet-TTS | Pemrosesan ucapan end-to-end | Modern dan fleksibel, mendukung banyak bahasa | Memerlukan pengetahuan teknis | Ditujukan bagi pengembang dan peneliti yang mengerjakan proyek sintesis dan pengenalan ucapan tingkat lanjut. |
| Coqui TTS | Neural TTS dengan model pra-latih | Model pra-latih, modular, dukungan komunitas kuat | Memerlukan familiaritas dengan deep learning | Hebat untuk kustomisasi tingkat lanjut, mendukung aksen dan bahasa, cocok bagi praktisi ML. |
| Larynx | Tacotron 2 dan WaveGlow | Sintesis suara berkualitas tinggi, menyerupai manusia | Intensif sumber daya, kustomisasi terbatas | Ideal untuk asisten suara yang terdengar natural, voice-over, atau aplikasi aksesibilitas. |
Berikut beberapa cara mesin TTS di atas dapat digunakan:
Melalui penggunaan mesin teks-ke-ucapan seperti yang disebutkan di atas, asisten virtual dapat dibuat. Asisten virtual ini bisa serupa dengan asisten suara perusahaan seperti Siri dan Alexa.
Beberapa di antaranya bahkan dapat digunakan untuk bantuan aksesibilitas bagi pengguna dengan gangguan penglihatan, memungkinkan mereka mendengar teks tertulis alih-alih membacanya.
Mesin TTS juga digunakan dalam sistem respons otomatis, seperti asisten telepon atau chatbot. Mesin ini dapat membacakan respons berdasarkan prompt dan interaksi tertentu, memberikan pengalaman yang lebih menyerupai manusia bagi pengguna.
Teknologi teks-ke-ucapan juga dapat menghasilkan voice-over untuk video atau gambar, memungkinkan konten yang lebih dinamis dan menarik.
Misalnya, mesin eSpeak dapat digunakan untuk menambahkan voice-over ke video dalam berbagai bahasa, membuatnya lebih mudah diakses dan menarik bagi audiens yang lebih luas.
Ini sangat berguna untuk aplikasi di industri pemasaran, e-learning, dan hiburan.
Menggunakan opsi open source bisa hemat biaya dan menawarkan lebih banyak fleksibilitas untuk kustomisasi. Namun, ada beberapa tantangan yang muncul saat menggunakan mesin ini:
Banyak mesin TTS open source memiliki dukungan bahasa terbatas dibandingkan solusi komersial.
Keterbatasan ini bisa menjadi hambatan bagi pengguna yang membutuhkan TTS dalam bahasa yang kurang umum digunakan.
Sebagian besar mesin TTS open source memerlukan pengetahuan pengkodean untuk dikustomisasi dan diimplementasikan. Hal ini menyulitkan pemangku kepentingan bisnis pada umumnya untuk menggunakannya tanpa dukungan teknis.
Ini bisa menjadi tantangan bagi individu atau organisasi tanpa keahlian teknis.
Meskipun mesin open source gratis digunakan, mungkin diperlukan sumber daya dan waktu tambahan untuk kustomisasi dan implementasi.
Selain itu, seorang engineer atau analis dengan pengetahuan terkait mesin TTS harus direkrut atau dilatih.
Karena itu, dalam beberapa kasus, solusi komersial mungkin lebih hemat biaya dalam jangka panjang.
Karena sumber daya terbatas dan digerakkan oleh komunitas, proyek open source mungkin tidak selalu memiliki dukungan dan dokumentasi yang luas.
Sumber: Dokumentasi ESPnet
Ini dapat menyulitkan pengguna untuk memecahkan masalah atau mempelajari cara menggunakan mesin secara efektif.
Namun, seiring mesin ini semakin populer dan lebih banyak pengembang berkontribusi, tantangan ini dapat berkurang seiring waktu.
Karena mesin open source dikembangkan dan dipelihara oleh komunitas, mungkin ada kekhawatiran tentang keamanan dan kinerja.
Namun, risiko ini dapat diminimalkan melalui pemeriksaan dan pemantauan yang tepat terhadap kode dan pembaruan mesin.
Selain itu, memilih proyek open source yang andal dan bereputasi baik dapat membantu mengurangi kekhawatiran ini.
Sekarang mari kita bahas cara memilih mesin yang tepat untuk model teks-ke-ucapan Anda.
Berikut beberapa faktor yang perlu dipertimbangkan:
Mulailah dengan mengidentifikasi kasus penggunaan spesifik Anda dan tujuan menggunakan TTS. Pahami fitur dan opsi kustomisasi apa yang diperlukan untuk proyek Anda, lalu pilih mesin yang sesuai.
Jika Anda membutuhkan dukungan untuk bahasa tertentu atau banyak bahasa, pastikan memilih mesin yang menawarkan kemampuan tersebut.
Dalam hal ini, memilih mesin eSpeak mungkin menjadi opsi yang lebih baik bagi Anda.
Pertimbangkan anggaran dan sumber daya Anda sebelum memilih mesin. Meskipun opsi open source mungkin hemat biaya dalam jangka panjang, opsi tersebut dapat memerlukan sumber daya tambahan untuk kustomisasi dan implementasi.
Evaluasi tingkat keterampilan tim Anda atau diri Anda sendiri saat bekerja dengan mesin TTS. Jika Anda tidak memiliki keahlian teknis, pertimbangkan untuk memilih solusi komersial yang menawarkan antarmuka yang ramah pengguna dan dukungan.
Pastikan mesin yang Anda pilih memberikan keluaran ucapan yang berkualitas tinggi dan terdengar natural. Anda juga mungkin ingin menguji berbagai mesin untuk melihat mana yang paling sesuai dengan tingkat kinerja yang diinginkan.
Teknologi teks-ke-ucapan telah berkembang pesat dalam menyediakan keluaran ucapan yang lebih natural dan menyerupai manusia. Dengan banyaknya opsi open source yang tersedia, kini integrasi TTS ke berbagai aplikasi menjadi lebih mudah diakses dan hemat biaya.
Namun, Anda juga harus mengantisipasi beberapa keterbatasan dan tantangan yang menyertai penggunaan mesin open source sebelum mengambil keputusan. Saya berharap panduan ini memberikan pemahaman yang lebih baik tentang mesin TTS dan membantu Anda memilih yang terbaik untuk kebutuhan Anda.
Mencari cara untuk melakukan proses ini secara terbalik? Lihat kursus Spoken Language Processing in Python kami.
Pelajari lebih lanjut tentang NLP dengan kursus-kursus ini!
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



