本文聚焦于现代软件开发中的应用容器化与云服务商提供的容器编排。通过容器编排,我们可以以可重复、可维护、可观测且高可用的方式,将应用部署并按需动态扩缩容以应对任意工作负载,同时兼顾成本效益与灾难恢复。
简述
- 容器使我们能够将应用打包为与平台无关的轻量镜像,具备极高的启动与复制性能。
- 容器编排引擎使我们可以动态管理不可预测且规模庞大的分布式计算工作负载。
- AWS EKS 是最受欢迎的容器编排器之一,并与众多 AWS 服务深度集成。
- 使用 Helm Chart 只需一条命令即可部署复杂的机器学习或数据科学类 Kubernetes 应用。
为何使用容器?
若不先回答“是什么”,几乎无法解释“为什么”。因此,让我们先从容器要解决的问题以及什么是容器入手,进而回答“为什么”。
传统的软件工程模式是开发者在本地机器上编写代码,然后部署并发布到测试环境,随后再发布到生产环境。此模式的问题在于不同环境之间的不一致性,以及各服务器上运行的依赖与库版本差异。
因此,一个“在我机器上能跑”的应用(套用开发者的经典名言),可能依赖与目标环境截然不同版本的运行时库,导致上线后出现意料之外的行为。
容器通过将已编译代码、库、依赖和运行时打包进一个“镜像”,从而完全抽象了应用层,解决了这一问题。
随后,容器镜像可作为模板,由容器引擎(如 Docker)快速部署并以容器实例形式运行,在任何环境中都具备可预期的行为。
容器接下来解决的问题是可扩展性、可维护性与成本效益。历史上,生产环境通常由大量(昂贵的)硬件资源构成,这些资源会被圈定并保护,以供高并发或关键业务应用独享。这些昂贵的环境需要持续的管理、维护与打补丁。
为此类应用分配的硬件数量通常必须按高峰负载的最大值来配置,但应用的使用模式并不总是稳定、可预测。这导致在非高峰期会有大量硬件处于闲置状态。
解决方案就是容器编排。
由于容器镜像与平台无关,容器计算资源可以按需在任何具备运行容器引擎能力的可用服务器上扩缩容,使底层服务器操作系统的维护与应用解耦。
这对成本效益有着明确的积极影响:如果我们对容器进行良好的管理与编排,使之能够动态匹配当下需求,就能最大化“裸金属”的利用率。
以上只是“高空俯瞰”,我们将在后续章节深入探讨。在此之前,先看一些容器的实际用例。
面向数据科学和机器学习的容器
数据科学与机器学习类应用往往对计算资源要求极高,
其使用模式有时也不可预测,并且需要处理海量数据。
此类应用常常受益于并行化处理,以将问题“分而治之”,然后将结果持久化到数据存储。虽然这是一种极度简化的表述,但不难看出,这类应用与容器及容器编排可谓天作之合!
既然已经掌握了这些背景知识,让我们来看看“如何做”。在本文末尾,我们会在讨论 Helm 时再次回到数据科学与机器学习应用的主题,了解如何以最少的工作量与配置,将复杂应用以容器形式部署在容器编排引擎中并运行。
市面上有许多容器引擎,但本文将使用最流行的 Docker。您可通过我们的Docker 入门教程熟悉该平台。
虚拟机(VM)与容器
虚拟机对物理硬件进行抽象,通过虚拟机管理程序将一台服务器变成多台,使多个 VM 共享同一宿主机。每个 VM 都有自己的客户操作系统(OS)。
容器是在应用层进行抽象。安装了容器引擎的服务器可以同时运行多个容器,这些容器共享底层操作系统。您可以在我们的容器化教程中进一步了解容器。
关键区别在于,容器使用宿主机的操作系统,不像 VM 那样自带一个 OS。这使其在复制、运行和销毁方面更加轻量且快速,同时仍能在容器之间提供安全隔离与容错(某个容器崩溃不会影响其他容器)。
这也意味着资源利用率更高:在相当的底层硬件规格下,单个 Docker 引擎上能运行的容器数量通常多于虚拟机管理程序上能运行的 VM 数量。
Docker 镜像与容器
Docker 镜像打包了配置、代码、依赖以及运行时引擎。镜像充当模板,用于在 Docker 中复制并运行容器实例。容器可以在任何支持 Docker 的平台上运行。
容器编排
既然我们已了解容器,还需要一种方式来管理它们。可选的编排器有多种,但本文将聚焦于运行在 AWS 云上的 Kubernetes,即 Elastic Kubernetes Service(EKS)。
EKS 管理的一些关键任务包括:
AWS 服务
在开始讲解 EKS 前,我们需要了解一些支撑 EKS 的 AWS 云服务。
CloudWatch
监控与可观测性服务,用于收集日志、指标与事件等数据。
VPC
虚拟私有云是在每个 AWS 账户下逻辑隔离、受安全保护和管理的网络。
ELB
弹性负载均衡器是一种高可用的网络组件,可在多个目标之间分发流量。
IAM
身份与访问管理,为 AWS 账户提供细粒度的访问控制。
ECR
弹性容器镜像服务,是一个全托管的 Docker 镜像仓库。
EC2
弹性云计算(因包含两个 C 而缩写为 EC2)是众多 AWS 服务的核心基石。它允许租用虚拟服务器,客户可在其上运行应用。
Region
物理位置,用于聚合集群化的数据中心,例如 EU-WEST-1(爱尔兰)与 EU-WEST-2(伦敦)。
AZ
可用区由一个或多个独立数据中心构成,具备各自冗余的供电、网络与连接。一个 Region 由多个 AZ 组成。
Route53
高可用的 DNS 服务。
WAF
Web 应用防火墙,帮助保护应用免受常见漏洞与机器人攻击的影响,这些攻击可能影响可用性、危及安全或过度消耗资源。
Kubernetes 基础
Kubernetes 有时被称作 K8s,这是因为在单词 Kubernetes 中,字母 K 与字母 S 之间有 8 个字母。
集群
EKS 会提供一个托管的 K8s 集群。这是最高层组件,充当所有服务、节点与 Pod 的容器。
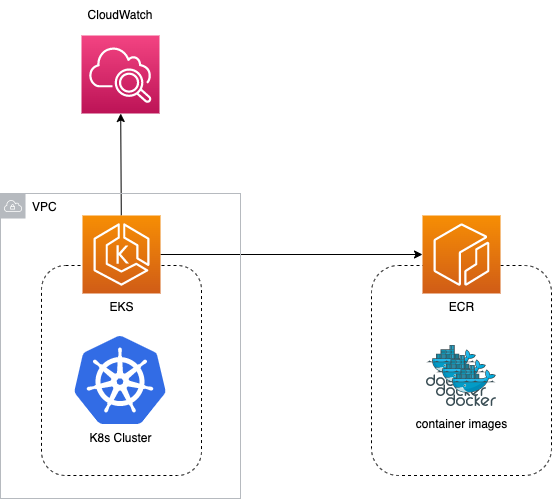
EKS 与 CloudWatch、Elastic Container Repository(ECR)、IAM、API Gateway、弹性负载均衡(ELB)、CodePipeline、Secrets Manager 等紧密集成。
以最基础的示例来说,我们可以将容器镜像存储在 ECR 中,由 EKS 管理并运行我们的应用;EKS 部署在跨多个可用区的 VPC 内,所有系统与应用日志发布到 CloudWatch。
主节点/控制平面
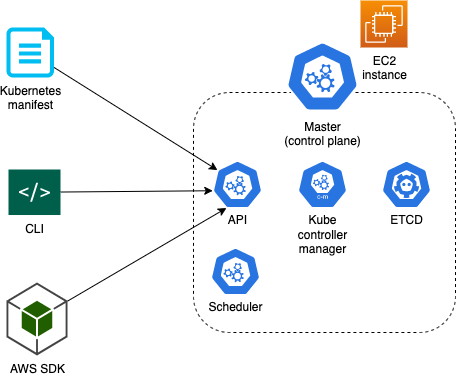
主节点是 K8s 的核心,负责管理、监控、调度与规划节点。其内部包含多个子组件。
ETCD
键值存储,用于持久化所有关键的集群数据。
Kube scheduler
调度器将容器部署到各节点上。
Kube controller manager
确保集群组件处于正确状态,保证期望的工作负载与实际工作负载一致。
API
集群外部的所有交互均通过 K8s API 进行。
节点(工作节点)
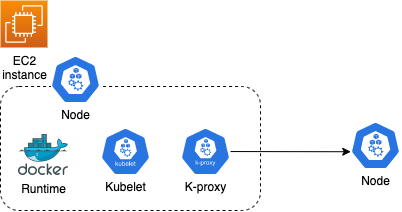
EKS 工作节点是一个 EC2 实例。每个节点安装有用于运行容器的 docker runtime,负责与主节点通信的 Kubelet agent,以及用于节点间通信的 K-proxy。
为使节点与 CloudWatch 集成,节点的 IAM 角色需要包含 CloudWatchLogsFullAccess 策略。
Pod
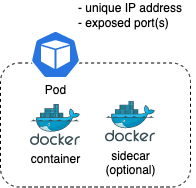
Pod 是最小的可部署单元。它运行一个应用容器,以及可能需要的任意边车(sidecar)容器。每个 Pod 都是短暂的,并拥有唯一的 IP 地址。
部署与副本集
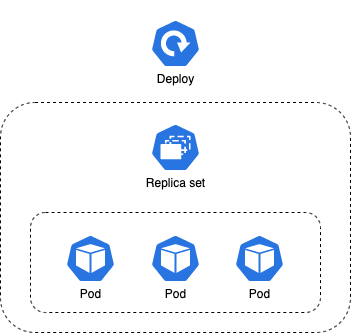
副本集通过标签管理一组 Pod,并确保针对指定工作负载始终有一组稳定运行的 Pod。如果某个 Pod 宕掉,副本集会负责将其恢复。
部署(Deployment)管理副本集。如果某个副本集宕掉,则由部署负责恢复。部署可以配置为滚动、渐进、重建或金丝雀等策略(具体类型超出本文范围)。
服务
在本文语境中,我们可以将服务直接视作 AWS 的 应用型负载均衡器(ALB,属于 ELB 的一种)。虽不止于此,但理解 ALB 能带来的部分优势十分重要:
- 关联 DNS 名称
- 健康检查
- 跨多个 AZ 的高可用
- WAF
- 访问日志
服务的主要功能是在节点/Pod 之间分发流量。
容器扩缩容
ASG 与 EC2
EC2 的核心组件之一是 Auto Scaling Group(ASG,自动伸缩组)。该 AWS 组件会在一个 Region 的多个 AZ 内,通常在负载均衡器之后,按期望工作负载维持一组 EC2 实例。
CloudWatch 指标提供向外扩或向内缩的触发条件。
这种扩缩方式被称为水平扩缩容,因为应用服务器集群可“水平”扩展与收缩以满足流量需求。一个示例扩缩策略是将所有实例的 CPU 利用率维持在 50% 以下。通常情况下,ASG 会被配置为在每个 AZ 内维持相同数量的 EC2 实例,但也有其他配置(超出本文范围)。
HPA
需要明确区分 EC2 层面的扩缩容与 Pod 层面的扩缩容。Horizontal Pod Autoscaler(水平 Pod 自动伸缩,HPA)负责在每个节点内扩缩 Pod。HPA 使用通过 Metrics Server 采集的 K8s 指标(该组件需在集群内安装,EKS 默认集群部署不包含)并基于节点指标扩缩 Pod。示例扩缩策略可以是将 vCPU 使用率目标设为 50%。
EKS 集群自动伸缩器
集群自动伸缩需要安装开源的 EKS 集群自动伸缩器。它负责在 AWS 的 ASG 配合下,对 K8s 服务进行扩缩容,而 ASG 则管理为集群预置的物理实例扩缩。
当某个节点按照 HPA 的扩缩策略达到最大容量时,集群自动伸缩器会创建另一台 EC2 实例并将其加入 ASG。
全景示意
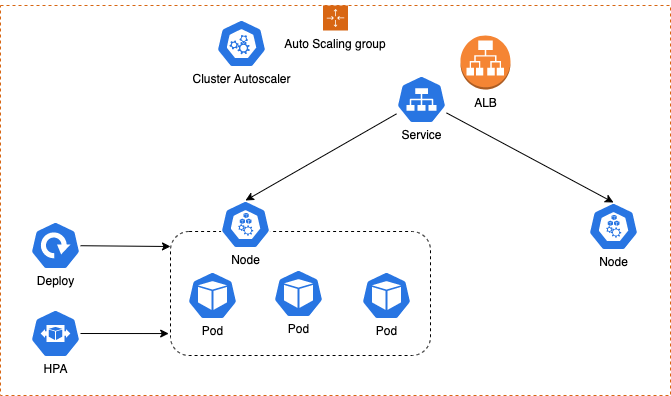
扩缩策略高度灵活、可定制、可配置,但通常会设置一个冷却期(cool-down),以避免因流量短时波动而发生不必要的缩容/收缩。
需要注意的是,如果 Pod 超出其 vCPU 上限,Kubernetes 会对该 Pod 内运行的应用进行限流;但如果 Pod 超出其内存上限,Kubernetes 会重启该容器。
成本优化
以下示例演示如何在实例内限制 Pod(以 m5.large 实例类型为例):
2 * vCPU = 2000m(millicore)
8 GiB 内存
Pod 资源限制:
- 预留 vCPU 数量,例如 500m
- vCPU 上限,例如 1000m
- 预留内存,例如 256Mi
- 内存上限,例如 512Mi
可观测性
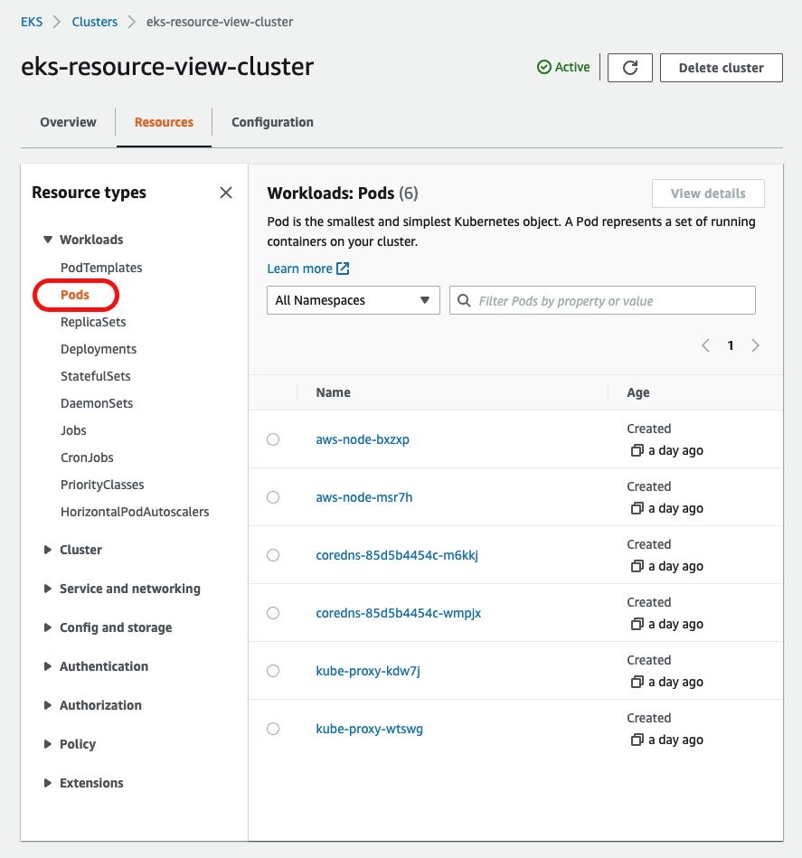
EKS Resource View
展示集群上运行的所有资源。
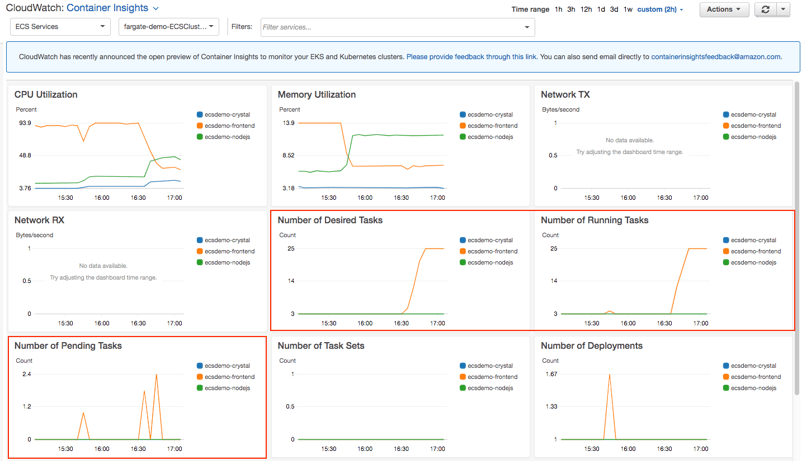
CloudWatch Container Insights
- 监控
- 告警
- 触发 Lambda 函数
- 预置的仪表板与指标
- 一键安装
Helm
Helm 是 Kubernetes 的包管理器,可自动化应用的打包、配置与部署。借助 Helm Chart,您可以创建、共享、管理版本并发布复杂的 Kubernetes 应用。
数据科学与机器学习领域的一些有趣 Chart 示例包括:
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
这些 K8s 应用可以通过 Helm 一条命令部署到您的 EKS 集群!
结论
在这份全面指南中,我们探讨了使用 AWS Elastic Kubernetes Service(EKS)进行容器编排的基础。从理解容器的基本概念及其在数据科学与机器学习中的实际应用,到深入剖析 AWS 服务与 Kubernetes 组件的细节,我们覆盖了大量内容。容器编排的世界虽复杂,却极具回报,能够带来可扩展性、可维护性与成本效益。
无论您是开发者、数据科学家还是 IT 专业人士,掌握容器编排无疑将成为您技能库中的重要一环。随着企业持续迁移到云端并采用微服务架构,对这方面专业人才的需求只会不断增长。
准备好将所学付诸实践了吗?DataCamp 提供多门课程,帮助您加深对 Kubernetes、Docker 与云计算的理解。从入门到高级,您都能找到交互式课程、真实世界挑战与专家主导的教程,全面提升技能。
实用链接
- Kubectl 速查表,包含最常用的命令
- HPA 教程,解释 HPA 并演示如何在受管扩缩容下运行应用
- 集群自动伸缩器 教程,搭建并运行带集群自动伸缩的简易应用
- Helm Chart
- AWS 价格计算器


本文聚焦于现代软件开发中的应用容器化与云服务商提供的容器编排。通过容器编排,我们可以以可重复、可维护、可观测且高可用的方式,将应用部署并按需动态扩缩容以应对任意工作负载,同时兼顾成本效益与灾难恢复。
简述
为何使用容器?
若不先回答“是什么”,几乎无法解释“为什么”。因此,让我们先从容器要解决的问题以及什么是容器入手,进而回答“为什么”。
传统的软件工程模式是开发者在本地机器上编写代码,然后部署并发布到测试环境,随后再发布到生产环境。此模式的问题在于不同环境之间的不一致性,以及各服务器上运行的依赖与库版本差异。
因此,一个“在我机器上能跑”的应用(套用开发者的经典名言),可能依赖与目标环境截然不同版本的运行时库,导致上线后出现意料之外的行为。
容器通过将已编译代码、库、依赖和运行时打包进一个“镜像”,从而完全抽象了应用层,解决了这一问题。
随后,容器镜像可作为模板,由容器引擎(如 Docker)快速部署并以容器实例形式运行,在任何环境中都具备可预期的行为。
容器接下来解决的问题是可扩展性、可维护性与成本效益。历史上,生产环境通常由大量(昂贵的)硬件资源构成,这些资源会被圈定并保护,以供高并发或关键业务应用独享。这些昂贵的环境需要持续的管理、维护与打补丁。
为此类应用分配的硬件数量通常必须按高峰负载的最大值来配置,但应用的使用模式并不总是稳定、可预测。这导致在非高峰期会有大量硬件处于闲置状态。
解决方案就是容器编排。
由于容器镜像与平台无关,容器计算资源可以按需在任何具备运行容器引擎能力的可用服务器上扩缩容,使底层服务器操作系统的维护与应用解耦。
这对成本效益有着明确的积极影响:如果我们对容器进行良好的管理与编排,使之能够动态匹配当下需求,就能最大化“裸金属”的利用率。
以上只是“高空俯瞰”,我们将在后续章节深入探讨。在此之前,先看一些容器的实际用例。
面向数据科学和机器学习的容器
数据科学与机器学习类应用往往对计算资源要求极高,
其使用模式有时也不可预测,并且需要处理海量数据。
此类应用常常受益于并行化处理,以将问题“分而治之”,然后将结果持久化到数据存储。虽然这是一种极度简化的表述,但不难看出,这类应用与容器及容器编排可谓天作之合!
既然已经掌握了这些背景知识,让我们来看看“如何做”。在本文末尾,我们会在讨论 Helm 时再次回到数据科学与机器学习应用的主题,了解如何以最少的工作量与配置,将复杂应用以容器形式部署在容器编排引擎中并运行。
市面上有许多容器引擎,但本文将使用最流行的 Docker。您可通过我们的Docker 入门教程熟悉该平台。
虚拟机(VM)与容器
虚拟机对物理硬件进行抽象,通过虚拟机管理程序将一台服务器变成多台,使多个 VM 共享同一宿主机。每个 VM 都有自己的客户操作系统(OS)。
容器是在应用层进行抽象。安装了容器引擎的服务器可以同时运行多个容器,这些容器共享底层操作系统。您可以在我们的容器化教程中进一步了解容器。
关键区别在于,容器使用宿主机的操作系统,不像 VM 那样自带一个 OS。这使其在复制、运行和销毁方面更加轻量且快速,同时仍能在容器之间提供安全隔离与容错(某个容器崩溃不会影响其他容器)。
这也意味着资源利用率更高:在相当的底层硬件规格下,单个 Docker 引擎上能运行的容器数量通常多于虚拟机管理程序上能运行的 VM 数量。
Docker 镜像与容器
Docker 镜像打包了配置、代码、依赖以及运行时引擎。镜像充当模板,用于在 Docker 中复制并运行容器实例。容器可以在任何支持 Docker 的平台上运行。
容器编排
既然我们已了解容器,还需要一种方式来管理它们。可选的编排器有多种,但本文将聚焦于运行在 AWS 云上的 Kubernetes,即 Elastic Kubernetes Service(EKS)。
EKS 管理的一些关键任务包括:
AWS 服务
在开始讲解 EKS 前,我们需要了解一些支撑 EKS 的 AWS 云服务。
CloudWatch
监控与可观测性服务,用于收集日志、指标与事件等数据。
VPC
虚拟私有云是在每个 AWS 账户下逻辑隔离、受安全保护和管理的网络。
ELB
弹性负载均衡器是一种高可用的网络组件,可在多个目标之间分发流量。
IAM
身份与访问管理,为 AWS 账户提供细粒度的访问控制。
ECR
弹性容器镜像服务,是一个全托管的 Docker 镜像仓库。
EC2
弹性云计算(因包含两个 C 而缩写为 EC2)是众多 AWS 服务的核心基石。它允许租用虚拟服务器,客户可在其上运行应用。
Region
物理位置,用于聚合集群化的数据中心,例如 EU-WEST-1(爱尔兰)与 EU-WEST-2(伦敦)。
AZ
可用区由一个或多个独立数据中心构成,具备各自冗余的供电、网络与连接。一个 Region 由多个 AZ 组成。
Route53
高可用的 DNS 服务。
WAF
Web 应用防火墙,帮助保护应用免受常见漏洞与机器人攻击的影响,这些攻击可能影响可用性、危及安全或过度消耗资源。
Kubernetes 基础
Kubernetes 有时被称作 K8s,这是因为在单词 Kubernetes 中,字母 K 与字母 S 之间有 8 个字母。
集群
EKS 会提供一个托管的 K8s 集群。这是最高层组件,充当所有服务、节点与 Pod 的容器。
EKS 与 CloudWatch、Elastic Container Repository(ECR)、IAM、API Gateway、弹性负载均衡(ELB)、CodePipeline、Secrets Manager 等紧密集成。
以最基础的示例来说,我们可以将容器镜像存储在 ECR 中,由 EKS 管理并运行我们的应用;EKS 部署在跨多个可用区的 VPC 内,所有系统与应用日志发布到 CloudWatch。
主节点/控制平面
主节点是 K8s 的核心,负责管理、监控、调度与规划节点。其内部包含多个子组件。
ETCD
键值存储,用于持久化所有关键的集群数据。
Kube scheduler
调度器将容器部署到各节点上。
Kube controller manager
确保集群组件处于正确状态,保证期望的工作负载与实际工作负载一致。
API
集群外部的所有交互均通过 K8s API 进行。
节点(工作节点)
EKS 工作节点是一个 EC2 实例。每个节点安装有用于运行容器的 docker runtime,负责与主节点通信的 Kubelet agent,以及用于节点间通信的 K-proxy。
为使节点与 CloudWatch 集成,节点的 IAM 角色需要包含 CloudWatchLogsFullAccess 策略。
Pod
Pod 是最小的可部署单元。它运行一个应用容器,以及可能需要的任意边车(sidecar)容器。每个 Pod 都是短暂的,并拥有唯一的 IP 地址。
部署与副本集
副本集通过标签管理一组 Pod,并确保针对指定工作负载始终有一组稳定运行的 Pod。如果某个 Pod 宕掉,副本集会负责将其恢复。
部署(Deployment)管理副本集。如果某个副本集宕掉,则由部署负责恢复。部署可以配置为滚动、渐进、重建或金丝雀等策略(具体类型超出本文范围)。
服务
在本文语境中,我们可以将服务直接视作 AWS 的 应用型负载均衡器(ALB,属于 ELB 的一种)。虽不止于此,但理解 ALB 能带来的部分优势十分重要:
服务的主要功能是在节点/Pod 之间分发流量。
容器扩缩容
ASG 与 EC2
EC2 的核心组件之一是 Auto Scaling Group(ASG,自动伸缩组)。该 AWS 组件会在一个 Region 的多个 AZ 内,通常在负载均衡器之后,按期望工作负载维持一组 EC2 实例。
CloudWatch 指标提供向外扩或向内缩的触发条件。
这种扩缩方式被称为水平扩缩容,因为应用服务器集群可“水平”扩展与收缩以满足流量需求。一个示例扩缩策略是将所有实例的 CPU 利用率维持在 50% 以下。通常情况下,ASG 会被配置为在每个 AZ 内维持相同数量的 EC2 实例,但也有其他配置(超出本文范围)。
HPA
需要明确区分 EC2 层面的扩缩容与 Pod 层面的扩缩容。Horizontal Pod Autoscaler(水平 Pod 自动伸缩,HPA)负责在每个节点内扩缩 Pod。HPA 使用通过 Metrics Server 采集的 K8s 指标(该组件需在集群内安装,EKS 默认集群部署不包含)并基于节点指标扩缩 Pod。示例扩缩策略可以是将 vCPU 使用率目标设为 50%。
EKS 集群自动伸缩器
集群自动伸缩需要安装开源的 EKS 集群自动伸缩器。它负责在 AWS 的 ASG 配合下,对 K8s 服务进行扩缩容,而 ASG 则管理为集群预置的物理实例扩缩。
当某个节点按照 HPA 的扩缩策略达到最大容量时,集群自动伸缩器会创建另一台 EC2 实例并将其加入 ASG。
全景示意
扩缩策略高度灵活、可定制、可配置,但通常会设置一个冷却期(cool-down),以避免因流量短时波动而发生不必要的缩容/收缩。
需要注意的是,如果 Pod 超出其 vCPU 上限,Kubernetes 会对该 Pod 内运行的应用进行限流;但如果 Pod 超出其内存上限,Kubernetes 会重启该容器。
成本优化
以下示例演示如何在实例内限制 Pod(以 m5.large 实例类型为例):
2 * vCPU = 2000m(millicore)
8 GiB 内存
Pod 资源限制:
可观测性
EKS Resource View
展示集群上运行的所有资源。
CloudWatch Container Insights
Helm
Helm 是 Kubernetes 的包管理器,可自动化应用的打包、配置与部署。借助 Helm Chart,您可以创建、共享、管理版本并发布复杂的 Kubernetes 应用。
数据科学与机器学习领域的一些有趣 Chart 示例包括:
这些 K8s 应用可以通过 Helm 一条命令部署到您的 EKS 集群!
结论
在这份全面指南中,我们探讨了使用 AWS Elastic Kubernetes Service(EKS)进行容器编排的基础。从理解容器的基本概念及其在数据科学与机器学习中的实际应用,到深入剖析 AWS 服务与 Kubernetes 组件的细节,我们覆盖了大量内容。容器编排的世界虽复杂,却极具回报,能够带来可扩展性、可维护性与成本效益。
无论您是开发者、数据科学家还是 IT 专业人士,掌握容器编排无疑将成为您技能库中的重要一环。随着企业持续迁移到云端并采用微服务架构,对这方面专业人才的需求只会不断增长。
准备好将所学付诸实践了吗?DataCamp 提供多门课程,帮助您加深对 Kubernetes、Docker 与云计算的理解。从入门到高级,您都能找到交互式课程、真实世界挑战与专家主导的教程,全面提升技能。
实用链接