Cet article met l’accent sur la conteneurisation des applications dans le développement logiciel moderne et sur l’orchestration de conteneurs proposée par les fournisseurs cloud. Elle nous permet de déployer et de faire évoluer dynamiquement nos applications pour répondre à toute variation de charge, avec répétabilité, maintenabilité, observabilité et haute disponibilité, tout en optimisant les coûts et en assurant la reprise après sinistre.
En bref
- Les conteneurs nous permettent d’emballer nos applications, indépendamment de la plateforme, sous forme d’images légères, très rapides à lancer et à répliquer.
- Les moteurs d’orchestration de conteneurs nous aident à gérer dynamiquement des charges de calcul distribuées, volumineuses et imprévisibles.
- AWS EKS est l’un des orchestrateurs de conteneurs les plus populaires et s’intègre finement à de nombreux services AWS.
- Utilisez des charts Helm pour déployer d’un seul coup des applications Kubernetes complexes de machine learning ou de data science.
Pourquoi des conteneurs ?
Difficile d’expliquer le « pourquoi » sans d’abord clarifier le « quoi ». Commençons donc par les problèmes que les conteneurs résoudent et par ce qu’est un conteneur, afin de mieux comprendre le « pourquoi ».
Dans l’ancien modèle de l’ingénierie logicielle, les développeurs écrivaient du code sur leur machine locale, puis le déployaient dans un environnement de test avant la mise en production. Le problème venait des incohérences entre environnements, ainsi que des différences de dépendances et de bibliothèques présentes sur les serveurs.
Ainsi, une application qui « marche sur ma machine » (pour reprendre une réplique bien connue) pouvait dépendre de bibliothèques d’exécution de versions différentes de celles de l’environnement cible, entraînant des comportements inattendus une fois déployée.
Les conteneurs résolvent ce problème en abstraisant totalement la couche applicative : ils empaquettent code compilé, bibliothèques, dépendances et runtimes dans une « image ».
Une image de conteneur peut ensuite servir de modèle qu’un moteur de conteneurs, comme Docker, déploiera et exécutera rapidement sous forme d’instance de conteneur, avec un comportement prévisible quel que soit l’environnement.
Les autres problèmes résolus par les conteneurs concernent l’évolutivité, la maintenabilité et la maîtrise des coûts. Historiquement, les environnements de production s’appuyaient sur d’importantes ressources matérielles (coûteuses), dédiées à des applications à fort volume ou critiques pour l’entreprise. Ces environnements exigeaient une gestion, une maintenance et des correctifs constants.
Les ressources matérielles allouées à ces applications devaient être dimensionnées pour le pic de charge, alors que l’usage n’est pas toujours régulier et prévisible. Résultat : une partie du matériel reste inutilisée en période creuse.
La réponse, c’est l’orchestration de conteneurs.
Puisqu’une image de conteneur est indépendante de la plateforme, les ressources de calcul peuvent être augmentées ou réduites à la demande depuis n’importe quel serveur en capacité d’exécuter un moteur de conteneurs, la maintenance du système d’exploitation sous-jacent étant découplée de l’application.
L’impact sur les coûts est évident : en pilotant nos conteneurs pour répondre dynamiquement à la demande, on maximise l’usage du matériel.
Ce tour d’horizon reste à très haut niveau ; nous entrerons dans le détail ensuite. Mais avant cela, voyons quelques usages concrets des conteneurs.
Conteneurs pour la data science et le machine learning
Les applications de data science et de machine learning sont souvent très gourmandes en calcul
avec des schémas d’usage parfois imprévisibles, et elles traitent des volumes de données considérables.
Elles tirent fréquemment parti de la parallélisation pour diviser le problème, le résoudre en morceaux, puis persister les résultats dans un stockage. C’est une forte simplification, mais on voit d’emblée que ces applications sont idéales pour les conteneurs et leur orchestration !
Forts de ces éléments, passons au « comment ». En fin d’article, nous reviendrons sur le lien avec les applications de data science et de machine learning en abordant Helm, et la façon de déployer des applications complexes sous forme de conteneurs au sein d’un moteur d’orchestration, avec un minimum d’efforts et de configuration.
Il existe de nombreux moteurs de conteneurs, mais nous utiliserons ici le plus populaire : Docker. Vous pouvez vous familiariser avec la plateforme dans notre tutoriel Introduction to Docker.
Machines virtuelles (VM) vs conteneurs
Les machines virtuelles abstraient le matériel physique : un hyperviseur transforme un serveur en plusieurs, permettant à plusieurs VM de partager le même hôte. Chaque VM embarque son propre système d’exploitation (OS).
Les conteneurs opèrent une abstraction à la couche applicative. Un serveur doté d’un moteur de conteneurs peut exécuter simultanément plusieurs conteneurs partageant le même OS sous-jacent. Pour en savoir plus, consultez notre tutoriel sur la conteneurisation.
La différence clé est que les conteneurs utilisent l’OS de l’hôte et n’embarquent pas le leur, contrairement aux VM. Ils sont donc bien plus légers et rapides à répliquer, exécuter et détruire, tout en assurant l’isolation et la tolérance aux pannes entre conteneurs (la chute d’un conteneur n’impacte pas les autres).
Cela permet également une meilleure utilisation des ressources : on peut exécuter davantage de conteneurs sur un moteur Docker qu’on ne pourrait lancer de VM sur un hyperviseur à matériel équivalent.
Image Docker vs conteneur
Une image Docker regroupe configuration, code, dépendances et runtime. Les images servent de modèles à partir desquels répliquer et exécuter des instances de conteneurs dans Docker. Un conteneur peut tourner sur toute plateforme compatible Docker.
Orchestration de conteneurs
Maintenant que nous maîtrisons les bases des conteneurs, il nous faut un moyen de les gérer. Plusieurs orchestrateurs existent, mais nous nous concentrerons ici sur Kubernetes exécuté dans le cloud AWS via Elastic Kubernetes Service (EKS).
Parmi les tâches clés gérées par EKS :
- Déploiement
- Montée en charge
- Équilibrage de charge
- Supervision
- Discovery de services
- Auto-guérison
Services AWS
Avant d’expliquer EKS, il faut comprendre certains services AWS qui le sous-tendent.
CloudWatch
Service de supervision et d’observabilité qui collecte journaux, métriques et événements.
VPC
Un Virtual Private Cloud est un réseau isolé logiquement, sécurisé et géré à l’échelle d’un compte AWS.
ELB
Un Elastic Load Balancer est un composant réseau hautement disponible qui répartit le trafic entre plusieurs cibles.
IAM
Identity and Access Management fournit un contrôle d’accès fin pour les comptes AWS.
ECR
Elastic Container Registry est un registre d’images Docker entièrement managé.
EC2
Elastic Cloud Compute (abrégé en raison des 2 « C ») est un service central d’AWS sur lequel reposent de nombreux autres. Il permet de louer des serveurs virtuels pour y exécuter ses applications.
Région
Une localisation physique autour de laquelle des centres de données sont regroupés, par exemple EU-WEST-1 (Irlande) et EU-WEST-2 (Londres).
AZ
Une zone de disponibilité correspond à un ou plusieurs centres de données distincts, dotés de leur propre alimentation, réseau et connectivité redondants. Une région comprend plusieurs AZ.
Route53
Un service DNS hautement disponible.
WAF
Un pare-feu pour applications web qui aide à protéger contre les attaques courantes et les bots pouvant affecter la disponibilité, compromettre la sécurité ou consommer excessivement des ressources.
Fondamentaux de Kubernetes
Kubernetes est parfois abrégé en K8s, car huit lettres séparent le « K » du « S » dans Kubernetes.
Cluster
EKS provisionne un cluster K8s managé. C’est le composant de plus haut niveau, qui englobe tous les services, nœuds et pods.
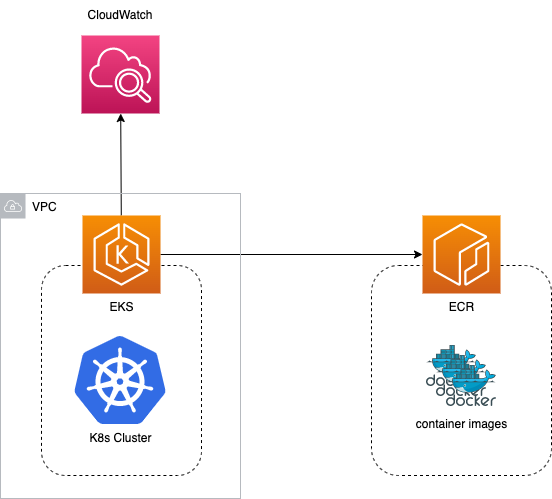
EKS s’intègre finement à CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager, et plus encore.
Dans l’exemple le plus simple, on peut stocker des images de conteneurs dans ECR et faire gérer et exécuter notre application par EKS, déployé dans un VPC à travers plusieurs zones de disponibilité, avec les journaux système et applicatifs publiés dans CloudWatch.
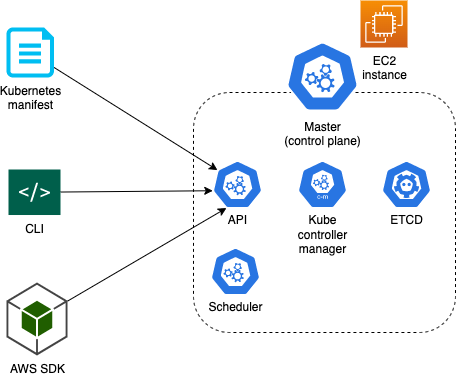
Plan de contrôle (master)
Le nœud maître est le cœur de K8s : il gère, supervise, planifie et ordonne les nœuds. Il comprend plusieurs sous-composants.
ETCD
Magasin clé-valeur qui persiste toutes les données critiques du cluster.
Kube scheduler
Le planificateur déploie les conteneurs sur les nœuds.
Kube controller manager
Il garantit l’état souhaité des composants du cluster, en veillant à ce que la charge demandée corresponde à la charge réelle.
API
Toutes les interactions externes au cluster passent par l’API K8s.
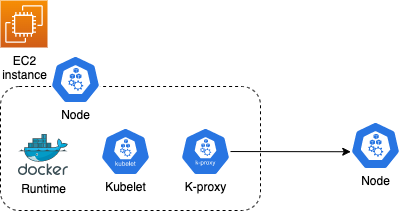
Nœuds (worker nodes)
Un nœud EKS est une instance EC2. Chaque nœud dispose du runtime Docker pour exécuter les conteneurs, de l’agent Kubelet qui gère les communications avec le master, et du K-proxy, qui permet la communication entre nœuds.
Pour intégrer les nœuds à CloudWatch, le rôle IAM du nœud doit inclure la politique CloudWatchLogsFullAccess.
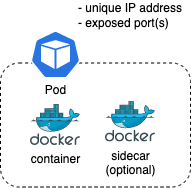
Pod
Un pod est la plus petite unité déployable. Il exécute un conteneur applicatif unique, plus éventuellement des conteneurs « sidecar » nécessaires. Chaque pod est éphémère et possède une adresse IP unique.
Déploiements et jeux de réplicas
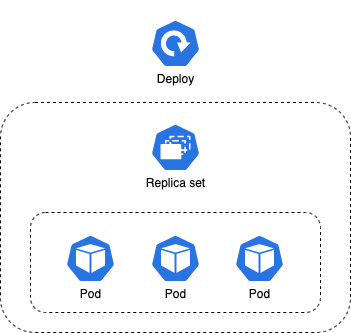
Un jeu de réplicas gère un ensemble de pods via des labels et garantit un nombre stable de pods en cours d’exécution pour une charge donnée. Si un pod tombe, le jeu de réplicas le restaure.
Les déploiements gèrent les jeux de réplicas. Si un jeu de réplicas tombe, le déploiement le restaure. Les déploiements peuvent être configurés en rolling, ramped, re-create ou canary (les détails dépassent le cadre de cet article).
Services
Dans le cadre de cet article, on peut assimiler un service à un Application Load Balancer (ALB) d’AWS, un type d’ELB. Il y a quelques subtilités, mais l’essentiel est de comprendre les avantages qu’un ALB apporte :
- Association d’un nom DNS
- Vérifications d’état
- Haute disponibilité sur plusieurs AZ
- WAF
- Journaux d’accès
La fonction première d’un service est de répartir le trafic entre nœuds/pods.
Mise à l’échelle des conteneurs
ASG et EC2
Un composant clé d’EC2 est l’Auto Scaling Group (ASG). Cet élément AWS maintient, au niveau souhaité, un parc d’instances EC2 réparties sur plusieurs AZ dans une région, généralement derrière un équilibreur de charge.
Les métriques CloudWatch servent de déclencheurs pour l’extension ou la réduction.
On parle ici de mise à l’échelle horizontale : la flotte de serveurs d’applications s’étend ou se contracte « horizontalement » pour répondre à la demande. Par exemple, une stratégie peut viser à maintenir toutes les instances sous 50 % d’utilisation CPU. L’ASG est souvent configuré pour gérer un nombre égal d’instances EC2 par AZ, mais d’autres options existent, hors du scope de cet article.
HPA
Il est essentiel de distinguer la mise à l’échelle au niveau EC2 de celle au niveau des pods. L’Horizontal Pod Autoscaler (HPA) gère la mise à l’échelle des pods au sein de chaque nœud. L’HPA utilise les métriques K8s collectées via le Metrics Server (à installer dans le cluster, il n’est pas présent par défaut sur EKS) et ajuste le nombre de pods selon les métriques. Par exemple, viser 50 % d’usage vCPU.
Cluster autoscaler EKS
L’auto-scaling du cluster nécessite l’installation du cluster autoscaler open source d’EKS, chargé d’ajuster le service K8s en conjonction avec un ASG AWS, qui gère la mise à l’échelle des instances physiques provisionnées pour le cluster.
Quand un nœud atteint sa capacité maximale selon la politique HPA, le cluster autoscaler crée une nouvelle instance EC2 et l’ajoute à l’ASG.
Vue d’ensemble
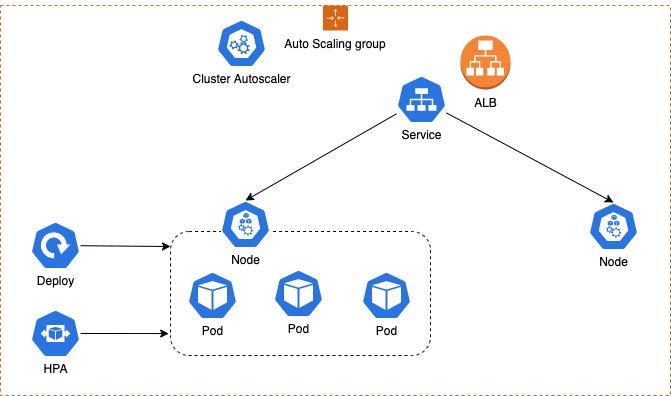
Les politiques de mise à l’échelle sont très flexibles, personnalisables et configurables, mais prévoient généralement une période de refroidissement avant une réduction, pour éviter des oscillations inutiles dues à un trafic erratique.
Notez que si un pod dépasse sa limite de vCPU, Kubernetes limite le débit de l’application dans ce pod. En revanche, s’il dépasse sa limite mémoire, Kubernetes redémarre le conteneur.
Optimisation des coûts
Exemple de limitation des pods dans des instances de type m5.large :
2 * vCPU = 2000m (millicores)
8 GiB de mémoire
Contraintes de ressources par pod :
- vCPU réservés, p. ex. 500m
- Limite de vCPU, p. ex. 1000m
- Mémoire réservée, p. ex. 256Mi
- Limite de mémoire, p. ex. 512Mi
Observabilité
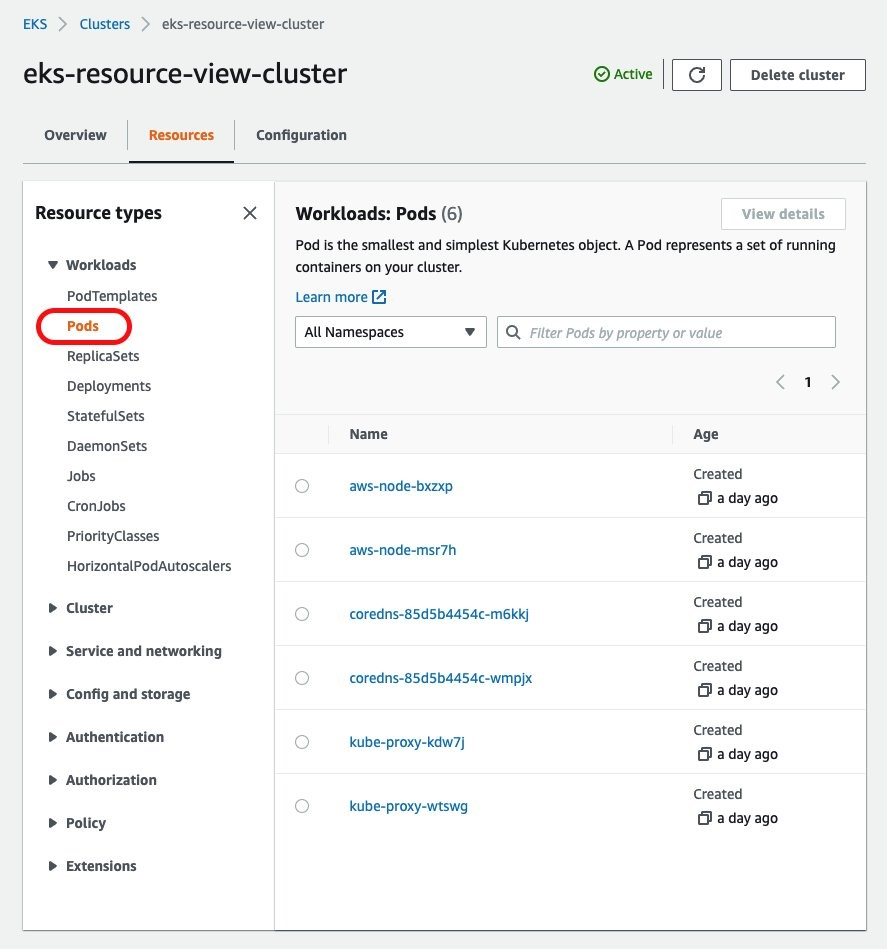
EKS Resource View
Affiche l’ensemble des ressources en cours d’exécution sur le cluster.
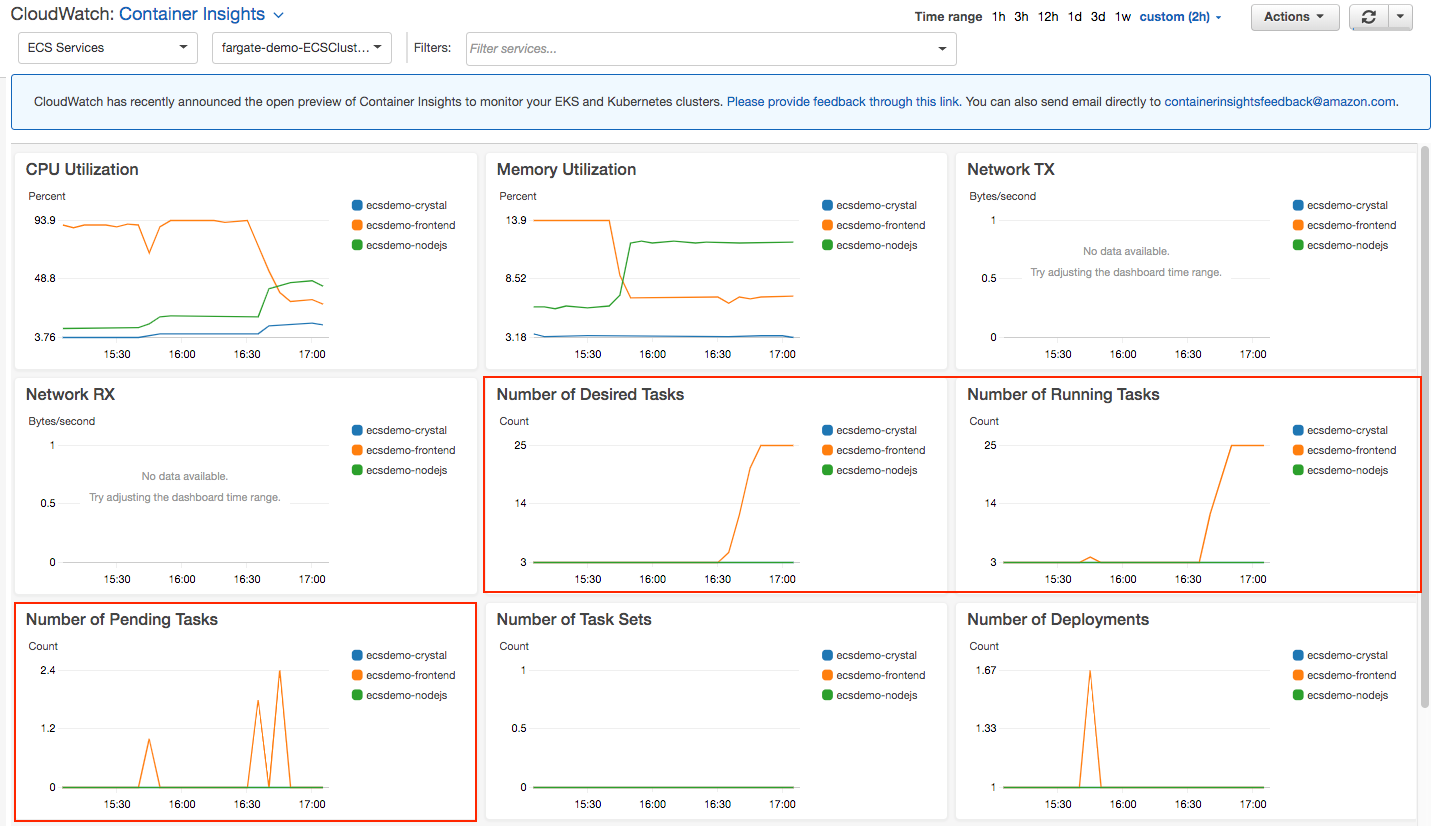
CloudWatch Container Insights
- Supervision
- Alarmes
- Déclenchement de fonctions Lambda
- Tableaux de bord et métriques préconfigurés
- Installation en un clic
Helm
Helm est un gestionnaire de paquets pour Kubernetes qui automatise l’empaquetage, la configuration et le déploiement des applications. Les charts Helm permettent de créer, partager, versionner et publier des applications Kubernetes complexes.
Quelques charts intéressants pour la data science et le machine learning :
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
Ces applications K8s peuvent être déployées sur votre cluster EKS via Helm avec une seule commande !
Conclusion
Dans ce guide complet, nous avons passé en revue les fondamentaux de l’orchestration de conteneurs avec AWS Elastic Kubernetes Service (EKS). Des bases des conteneurs et de leurs usages concrets en data science et machine learning, jusqu’aux mécanismes des services AWS et des composants Kubernetes, nous avons couvert l’essentiel. L’orchestration de conteneurs est un domaine exigeant mais très gratifiant, offrant évolutivité, maintenabilité et optimisation des coûts.
Que vous soyez développeur, data scientist ou professionnel IT, maîtriser l’orchestration de conteneurs sera un atout majeur. Alors que les entreprises migrent vers le cloud et adoptent les architectures microservices, la demande d’expertises dans ces domaines ne cessera d’augmenter.
Prêt à passer à la pratique ? DataCamp propose une sélection de cours pour approfondir Kubernetes, Docker et le cloud computing. Du niveau débutant à avancé, vous y trouverez des leçons interactives, des défis concrets et des tutoriels animés par des experts pour accélérer vos compétences.
- Introduction to Docker
- Machine Learning, Pipelines, Deployment and MLOps Tutorial
- AWS Cloud Concepts Course
Liens utiles
- Fiche mémo kubectl avec les commandes les plus courantes
- Tutoriel HPA expliquant le fonctionnement de l’HPA et la mise à l’échelle gérée d’une application
- Tutoriel cluster autoscaler pour configurer et exécuter une application simple avec auto-scaling de cluster
- Charts Helm
- Calculateur de tarification AWS