Questo articolo si concentra sulla containerizzazione delle applicazioni nello sviluppo software moderno con l'orchestrazione dei container dei provider cloud, che ci consente di distribuire e scalare dinamicamente le applicazioni in base a qualsiasi richiesta di carico di lavoro, garantendo ripetibilità, manutenibilità, osservabilità e alta disponibilità, il tutto in modo conveniente e con funzionalità di disaster recovery.
In breve
- I container ci permettono di impacchettare le applicazioni in immagini leggere, indipendenti dalla piattaforma, che si avviano e si replicano con alte prestazioni.
- I motori di orchestrazione dei container ci permettono di gestire dinamicamente carichi di lavoro distribuiti, ampi e imprevedibili.
- AWS EKS è uno degli orchestratori di container più popolari e offre un'integrazione stretta con numerosi servizi AWS.
- Usa le chart Helm per distribuire applicazioni Kubernetes complesse di machine learning o data science con un singolo comando.
Perché i container?
È quasi impossibile rispondere al “perché” senza il “che cosa”, quindi partiamo dai problemi che i container mirano a risolvere e da cosa sia un container, per arrivare al “perché”.
Nel vecchio modello di ingegneria del software gli sviluppatori scrivevano codice sulle loro macchine locali, che poi veniva distribuito e inviato a un ambiente di test, per poi passare alla produzione. Il problema di questo modello erano le incoerenze tra gli ambienti e tra le dipendenze e librerie in esecuzione sui vari server.
Così, un'applicazione che “funziona sulla mia macchina” (per citare un classico degli sviluppatori) potrebbe dipendere da librerie runtime di versioni molto diverse rispetto a quelle dell'ambiente di destinazione, portando a comportamenti inattesi una volta distribuita.
I container risolvono questo problema astraendo completamente il livello applicativo, impacchettando codice compilato, librerie, dipendenze e runtime in un’“immagine”.
Un'immagine di container può poi essere usata come template che un motore di container, come Docker, può distribuire e avviare rapidamente come istanza di container, con un comportamento prevedibile in qualsiasi ambiente.
I successivi problemi che i container risolvono sono scalabilità, manutenibilità ed economicità. Storicamente, gli ambienti di produzione erano composti da un grande quantitativo di risorse hardware (costose) riservate e protette per l'uso esclusivo di applicazioni ad alto volume o critiche per il business. Questi ambienti costosi richiedevano gestione, manutenzione e patching continui.
La quantità di hardware allocata a tali applicazioni doveva essere la massima per soddisfare il carico di picco, ma le applicazioni non hanno sempre pattern di utilizzo coerenti e prevedibili. Questo fatto porta a grandi quantità di hardware che restano inattive durante i periodi di bassa attività.
La soluzione è l'orchestrazione dei container.
Poiché un'immagine di container è indipendente dalla piattaforma, le risorse di calcolo per i container possono essere scalate su e giù a richiesta usando qualsiasi server disponibile che abbia la capacità di eseguire un motore di container, lasciando la manutenzione del sistema operativo sottostante disaccoppiata dall'applicazione.
Questo ha un impatto evidente sull'economicità: se gestiamo i container e li orchestriamo in modo da soddisfare dinamicamente la domanda corrente, allora massimizziamo l'uso dell'hardware.
Questa spiegazione è una vista “da 10.000 metri”; scenderemo nei dettagli nelle sezioni successive, ma prima vediamo alcuni usi pratici dei container.
Container per Data Science e Machine Learning
Le applicazioni per data science e machine learning tendono a essere altamente compute-intensive
con pattern di utilizzo a volte imprevedibili e gestiscono enormi quantità di dati.
Tali applicazioni traggono spesso vantaggio dalla parallelizzazione per dividere e conquistare un problema, per poi salvare i risultati in un data store. È un'enorme semplificazione, ma è subito chiaro che queste applicazioni sono perfette per i container e la loro orchestrazione!
Con tutte queste informazioni, passiamo al “come”. Poi, alla fine dell'articolo, torneremo sul legame tra applicazioni di data science e machine learning quando parleremo di Helm e di come possiamo eseguire applicazioni complesse distribuite come container all'interno di un motore di orchestrazione con il minimo sforzo e configurazione.
Esistono molti motori di container, ma in questo articolo useremo il più popolare, Docker. Puoi familiarizzare con la piattaforma nella nostra guida Introduzione a Docker.
Macchine virtuali (VM) vs container
Le macchine virtuali astraggono l'hardware fisico, trasformando un server in molti tramite un hypervisor, consentendo a più VM di condividere lo stesso host. Ogni VM ha un sistema operativo (OS) guest.
I container sono un'astrazione a livello applicativo. Un server con un motore di container installato può eseguire più container contemporaneamente, tutti condividendo l'OS sottostante. Puoi saperne di più sui container nel nostro tutorial sulla containerizzazione.
La differenza chiave è che i container usano l'OS host e non sono forniti con un proprio OS, a differenza delle VM. Questo li rende molto più leggeri e veloci da replicare, eseguire e distruggere, pur offrendo isolamento di sicurezza e tolleranza ai guasti tra container (se un container va in crash, non ha impatto sugli altri in esecuzione).
Significa anche un miglior utilizzo delle risorse: su un singolo motore Docker possono girare più container di quante VM si possano eseguire su un hypervisor, a parità di specifiche hardware sottostanti.
Immagine Docker vs container
Un'immagine Docker impacchetta configurazione, codice, dipendenze e il runtime engine. Le immagini agiscono come template da cui replicare ed eseguire istanze di container in Docker. Un container può essere eseguito su qualsiasi piattaforma che supporti Docker.
Orchestrazione dei container
Ora che conosciamo i container, ci serve un modo per gestirli. Esistono diversi orchestratori, ma in questo articolo ci concentreremo su Kubernetes in esecuzione nel cloud AWS tramite Elastic Kubernetes Service (EKS).
Alcuni dei compiti chiave gestiti da EKS sono:
- Deployment
- Scalabilità
- Load balancing
- Monitoraggio
- Service discovery
- Self-healing
Servizi AWS
Prima di iniziare a spiegare EKS, dobbiamo comprendere alcuni servizi cloud AWS che lo sostengono.
CloudWatch
Servizio di monitoraggio e osservabilità che raccoglie dati sotto forma di log, metriche ed eventi.
VPC
Una Virtual Private Cloud è una rete logicamente isolata, protetta e gestita in modo sicuro per ogni account AWS.
ELB
Un elastic load balancer è un componente di rete altamente disponibile che può distribuire il traffico su più target.
IAM
Identity and Access Management fornisce controllo degli accessi granulare per gli account AWS.
ECR
Elastic Container Registry è un registry di immagini Docker completamente gestito.
EC2
Elastic Cloud Compute (abbreviazione dovuta alle 2 C) è un servizio core di AWS che sostiene numerosi altri. Consente il noleggio di server virtuali su cui i clienti possono eseguire le loro applicazioni.
Regione
Una posizione fisica attorno alla quale possono essere raggruppati data center, ad esempio EU-WEST-1 (Irlanda) e EU-WEST-2 (Londra).
AZ
Una availability zone è composta da uno o più data center distinti con alimentazione, rete e connettività ridondanti. Una regione è costituita da più AZ.
Route53
Un servizio DNS altamente disponibile.
WAF
Web Application Firewall che aiuta a proteggere le applicazioni da exploit e bot comuni che potrebbero influire sulla disponibilità, compromettere la sicurezza o consumare risorse eccessive.
Fondamenti di Kubernetes
Kubernetes viene talvolta indicato come K8s. Questo perché ci sono otto lettere tra la K e la S in Kubernetes.
Cluster
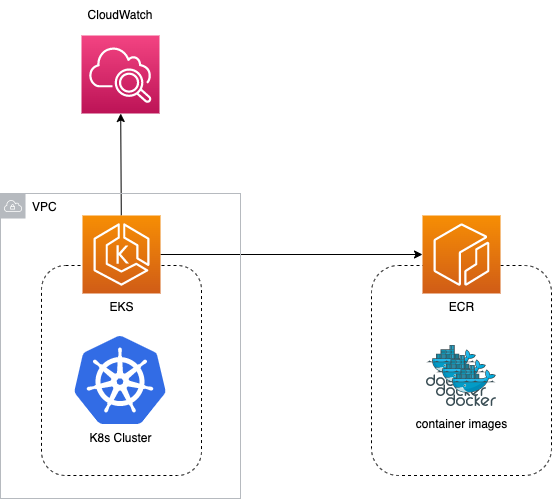
EKS effettua il provisioning di un cluster K8s gestito. Questo è il componente di livello più alto e funge da contenitore per tutti i servizi, i nodi e i pod.
EKS ha un'integrazione stretta con CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager e altri.
Prendendo l'esempio più semplice, possiamo archiviare le immagini dei container in ECR ed eseguire e gestire la nostra applicazione con EKS, distribuito in una VPC su più availability zone, con tutti i log di sistema e applicativi pubblicati su CloudWatch.
Master/control plane
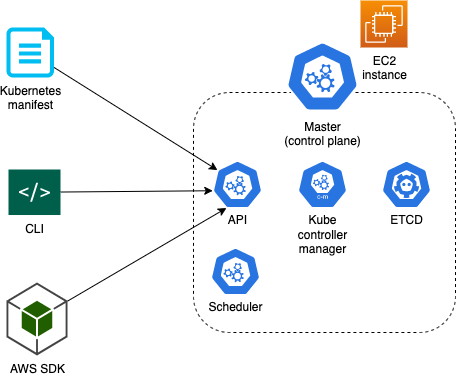
Il nodo master è il cuore di K8s e aiuta a gestire, monitorare, schedulare e pianificare i nodi. Include diversi sottocomponenti.
ETCD
Un key-value store che persiste tutti i dati critici del cluster
Kube scheduler
Lo scheduler distribuisce i container nei nodi
Kube controller manager
Garantisce il corretto stato dei componenti del cluster, assicurando che il carico di lavoro desiderato corrisponda a quello effettivo.
API
Tutte le interazioni dall'esterno del cluster passano tramite le API di K8s.
Nodi (worker node)
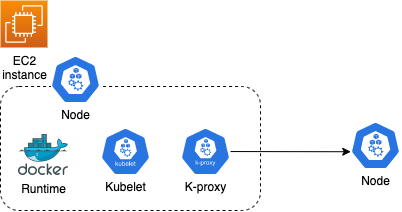
Un worker node EKS è un'istanza EC2. Ogni nodo ha installato il runtime docker per eseguire i container, l'agente Kubelet che gestisce tutte le comunicazioni da e verso il master e il K-proxy, che consente la comunicazione tra nodi.
Per integrare i nodi con CloudWatch, il ruolo IAM del nodo deve includere la policy CloudWatchLogsFullAccess.
Pod
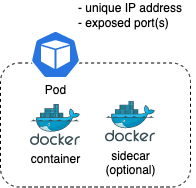
Un pod è la più piccola unità distribuibile. Esegue un singolo container applicativo più eventuali sidecar container necessari. Ogni pod è effimero e avrà un indirizzo IP univoco.
Deployment e Replica set
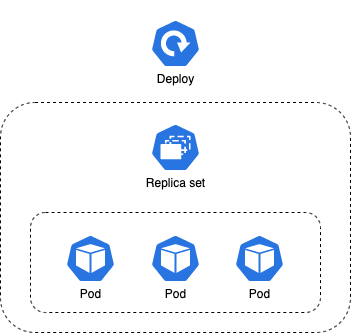
Un replica set gestisce un insieme di pod per etichette e garantisce che ci sia sempre un set stabile di pod in esecuzione per un determinato carico di lavoro. Se un pod si interrompe, è compito del replica set ripristinarlo.
I deployment gestiscono i replica set. Se un replica set si interrompe, è compito del deployment ripristinarlo. I deployment possono essere configurati come rolling, ramped, re-create o canary (i dettagli sui tipi di deployment sono fuori dallo scopo di questo articolo).
Service
Ai fini di questo articolo, possiamo considerare un service come una mappatura diretta a un Application Load Balancer (ALB) di AWS, che è un tipo di ELB. C'è dell'altro, ma è importante capire alcuni dei vantaggi che un ALB può offrire:
- Associare un nome DNS
- Health check
- Alta disponibilità su più AZ
- WAF
- Access log
La funzione principale di un service è distribuire il traffico tra nodi/pod.
Scalabilità dei container
ASG ed EC2
Un componente fondamentale di EC2 è l'Auto Scaling Group (ASG). Questo componente AWS mantiene un parco di istanze EC2 a un carico di lavoro desiderato su più AZ all'interno di una regione, di solito dietro un load balancer.
Le metriche di CloudWatch forniscono i trigger per scalare in o out.
Questo tipo di scalabilità è detta orizzontale poiché il parco server applicativi può espandersi e contrarsi “orizzontalmente” per soddisfare le richieste di traffico. Un esempio di policy di scaling potrebbe essere mantenere tutte le istanze sotto il 50% di utilizzo CPU. A questo livello, l'ASG è normalmente configurato per gestire un numero uguale di istanze EC2 per AZ, ma esistono altre configurazioni oltre lo scopo di questo articolo.
HPA
È molto importante distinguere tra scalabilità a livello EC2 e a livello pod. L'Horizontal Pod Autoscaler è responsabile della scalabilità dei pod all'interno di ciascun nodo. L'HPA usa le metriche di K8s raccolte tramite il Metrics Server (deve essere installato nel cluster e non fa parte del deployment predefinito di EKS) e scala i pod in base alle metriche del nodo. Un esempio di policy di scaling potrebbe essere un target di utilizzo vCPU al 50%.
EKS Cluster autoscaler
Il cluster autoscaling richiede l'installazione dell'open-source EKS cluster autoscaler, responsabile della scalabilità del servizio K8s insieme a un AWS ASG, che a sua volta gestisce la scalabilità delle istanze fisiche effettuate per il cluster.
Quando un nodo raggiunge la capacità massima in base alla policy di scaling HPA, il cluster autoscaler creerà un'altra istanza EC2 e la aggiungerà all'ASG.
Il quadro completo
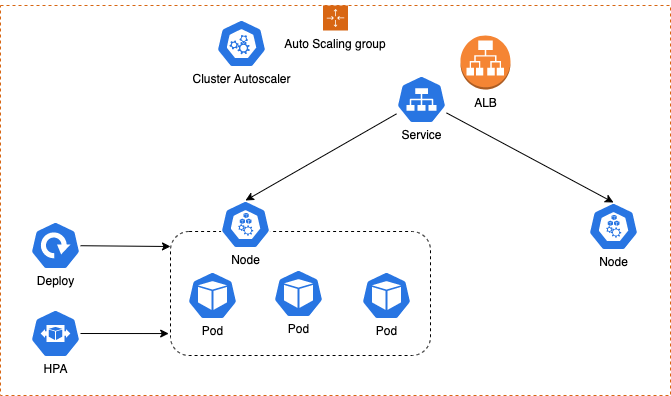
Le policy di scalabilità sono altamente flessibili, personalizzabili e configurabili, ma di norma includono un periodo di raffreddamento prima di ridurre/contrarre per evitare scalate inutili dovute a richieste di traffico irregolari e fluttuanti.
È importante notare che se un pod supera il limite di vCPU, Kubernetes effettuerà il throttling dell'applicazione in esecuzione in quel pod; se invece un pod supera i limiti di memoria, Kubernetes riavvierà il container.
Ottimizzazione dei costi
Esempio di come limitare i pod all'interno di istanze usando un'istanza di tipo m5.large:
2 * vCPU = 2000m (millicore)
8 GiB di memoria
Restrizioni di risorse del pod:
- vCPU riservate, ad es. 500m
- Limite di vCPU, ad es. 1000m
- Memoria riservata, ad es. 256Mi
- Limite di memoria, ad es. 512Mi
Osservabilità
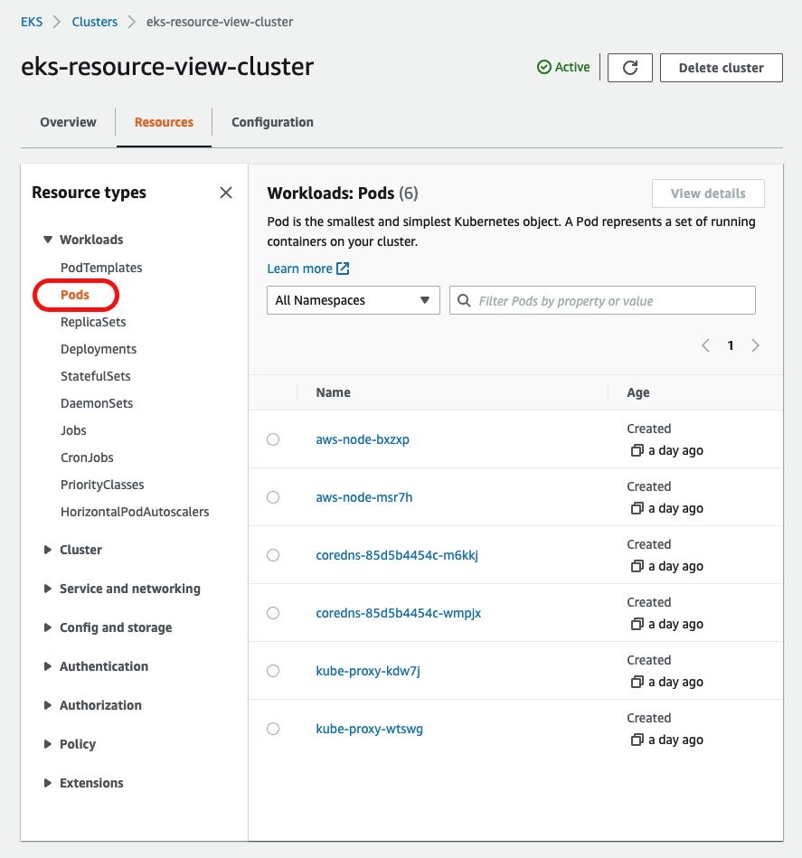
EKS Resource View
Mostra tutte le risorse in esecuzione sul cluster.
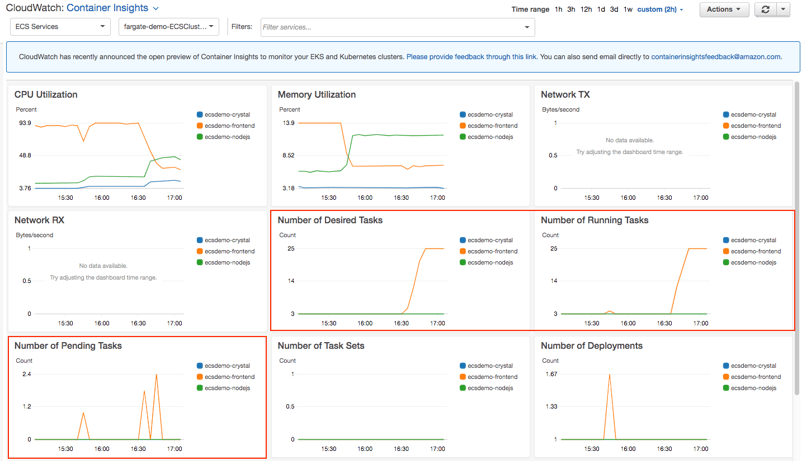
CloudWatch Container Insights
- Monitor
- Allarmi
- Trigger per funzioni Lambda
- Dashboard e metriche predefiniti
- Installazione con un clic
Helm
Helm è un gestore di pacchetti per Kubernetes che automatizza il packaging, la configurazione e la distribuzione delle applicazioni. Le chart Helm ti consentono di creare, condividere, versionare e pubblicare applicazioni Kubernetes complesse.
Alcuni esempi interessanti di chart nell'ambito della data science e del machine learning sono:
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
Queste applicazioni K8s possono essere distribuite sul tuo cluster EKS tramite Helm con un singolo comando!
Conclusione
In questa guida completa abbiamo esplorato i fondamenti dell'orchestrazione dei container con AWS Elastic Kubernetes Service (EKS). Dalla comprensione delle basi dei container e delle loro applicazioni reali in data science e machine learning, fino all'approfondimento dei servizi AWS e dei componenti di Kubernetes, abbiamo coperto molti aspetti. Il mondo dell'orchestrazione dei container è complesso ma estremamente gratificante, offrendo scalabilità, manutenibilità ed economicità.
Che tu sia uno sviluppatore, un data scientist o un professionista IT, padroneggiare l'orchestrazione dei container sarà senza dubbio una competenza preziosa nel tuo toolkit. Man mano che le aziende continuano a migrare a soluzioni cloud e ad adottare architetture a microservizi, la domanda di professionisti con competenze in questi ambiti è destinata a crescere.
Pronto a mettere in pratica le tue conoscenze? DataCamp offre una gamma di corsi che possono aiutarti ad approfondire Kubernetes, Docker e il cloud computing. Dai livelli per principianti a quelli avanzati, troverai lezioni interattive, sfide reali e tutorial guidati da esperti per migliorare le tue competenze.
Link utili
- Kubectl cheat sheet con i comandi più usati
- Il tutorial su HPA spiega l'HPA e ti guida attraverso un'applicazione con scalabilità gestita
- Il tutorial sul cluster autoscaler per configurare ed eseguire una semplice applicazione con scalabilità del cluster
- Le chart di Helm
- Il calcolatore prezzi AWS


 Tim Lu · 12 min

 Abid Ali Awan · 15 min

Questo articolo si concentra sulla containerizzazione delle applicazioni nello sviluppo software moderno con l'orchestrazione dei container dei provider cloud, che ci consente di distribuire e scalare dinamicamente le applicazioni in base a qualsiasi richiesta di carico di lavoro, garantendo ripetibilità, manutenibilità, osservabilità e alta disponibilità, il tutto in modo conveniente e con funzionalità di disaster recovery.
In breve
Perché i container?
È quasi impossibile rispondere al “perché” senza il “che cosa”, quindi partiamo dai problemi che i container mirano a risolvere e da cosa sia un container, per arrivare al “perché”.
Nel vecchio modello di ingegneria del software gli sviluppatori scrivevano codice sulle loro macchine locali, che poi veniva distribuito e inviato a un ambiente di test, per poi passare alla produzione. Il problema di questo modello erano le incoerenze tra gli ambienti e tra le dipendenze e librerie in esecuzione sui vari server.
Così, un'applicazione che “funziona sulla mia macchina” (per citare un classico degli sviluppatori) potrebbe dipendere da librerie runtime di versioni molto diverse rispetto a quelle dell'ambiente di destinazione, portando a comportamenti inattesi una volta distribuita.
I container risolvono questo problema astraendo completamente il livello applicativo, impacchettando codice compilato, librerie, dipendenze e runtime in un’“immagine”.
Un'immagine di container può poi essere usata come template che un motore di container, come Docker, può distribuire e avviare rapidamente come istanza di container, con un comportamento prevedibile in qualsiasi ambiente.
I successivi problemi che i container risolvono sono scalabilità, manutenibilità ed economicità. Storicamente, gli ambienti di produzione erano composti da un grande quantitativo di risorse hardware (costose) riservate e protette per l'uso esclusivo di applicazioni ad alto volume o critiche per il business. Questi ambienti costosi richiedevano gestione, manutenzione e patching continui.
La quantità di hardware allocata a tali applicazioni doveva essere la massima per soddisfare il carico di picco, ma le applicazioni non hanno sempre pattern di utilizzo coerenti e prevedibili. Questo fatto porta a grandi quantità di hardware che restano inattive durante i periodi di bassa attività.
La soluzione è l'orchestrazione dei container.
Poiché un'immagine di container è indipendente dalla piattaforma, le risorse di calcolo per i container possono essere scalate su e giù a richiesta usando qualsiasi server disponibile che abbia la capacità di eseguire un motore di container, lasciando la manutenzione del sistema operativo sottostante disaccoppiata dall'applicazione.
Questo ha un impatto evidente sull'economicità: se gestiamo i container e li orchestriamo in modo da soddisfare dinamicamente la domanda corrente, allora massimizziamo l'uso dell'hardware.
Questa spiegazione è una vista “da 10.000 metri”; scenderemo nei dettagli nelle sezioni successive, ma prima vediamo alcuni usi pratici dei container.
Container per Data Science e Machine Learning
Le applicazioni per data science e machine learning tendono a essere altamente compute-intensive
con pattern di utilizzo a volte imprevedibili e gestiscono enormi quantità di dati.
Tali applicazioni traggono spesso vantaggio dalla parallelizzazione per dividere e conquistare un problema, per poi salvare i risultati in un data store. È un'enorme semplificazione, ma è subito chiaro che queste applicazioni sono perfette per i container e la loro orchestrazione!
Con tutte queste informazioni, passiamo al “come”. Poi, alla fine dell'articolo, torneremo sul legame tra applicazioni di data science e machine learning quando parleremo di Helm e di come possiamo eseguire applicazioni complesse distribuite come container all'interno di un motore di orchestrazione con il minimo sforzo e configurazione.
Esistono molti motori di container, ma in questo articolo useremo il più popolare, Docker. Puoi familiarizzare con la piattaforma nella nostra guida Introduzione a Docker.
Macchine virtuali (VM) vs container
Le macchine virtuali astraggono l'hardware fisico, trasformando un server in molti tramite un hypervisor, consentendo a più VM di condividere lo stesso host. Ogni VM ha un sistema operativo (OS) guest.
I container sono un'astrazione a livello applicativo. Un server con un motore di container installato può eseguire più container contemporaneamente, tutti condividendo l'OS sottostante. Puoi saperne di più sui container nel nostro tutorial sulla containerizzazione.
La differenza chiave è che i container usano l'OS host e non sono forniti con un proprio OS, a differenza delle VM. Questo li rende molto più leggeri e veloci da replicare, eseguire e distruggere, pur offrendo isolamento di sicurezza e tolleranza ai guasti tra container (se un container va in crash, non ha impatto sugli altri in esecuzione).
Significa anche un miglior utilizzo delle risorse: su un singolo motore Docker possono girare più container di quante VM si possano eseguire su un hypervisor, a parità di specifiche hardware sottostanti.
Immagine Docker vs container
Un'immagine Docker impacchetta configurazione, codice, dipendenze e il runtime engine. Le immagini agiscono come template da cui replicare ed eseguire istanze di container in Docker. Un container può essere eseguito su qualsiasi piattaforma che supporti Docker.
Orchestrazione dei container
Ora che conosciamo i container, ci serve un modo per gestirli. Esistono diversi orchestratori, ma in questo articolo ci concentreremo su Kubernetes in esecuzione nel cloud AWS tramite Elastic Kubernetes Service (EKS).
Alcuni dei compiti chiave gestiti da EKS sono:
Servizi AWS
Prima di iniziare a spiegare EKS, dobbiamo comprendere alcuni servizi cloud AWS che lo sostengono.
CloudWatch
Servizio di monitoraggio e osservabilità che raccoglie dati sotto forma di log, metriche ed eventi.
VPC
Una Virtual Private Cloud è una rete logicamente isolata, protetta e gestita in modo sicuro per ogni account AWS.
ELB
Un elastic load balancer è un componente di rete altamente disponibile che può distribuire il traffico su più target.
IAM
Identity and Access Management fornisce controllo degli accessi granulare per gli account AWS.
ECR
Elastic Container Registry è un registry di immagini Docker completamente gestito.
EC2
Elastic Cloud Compute (abbreviazione dovuta alle 2 C) è un servizio core di AWS che sostiene numerosi altri. Consente il noleggio di server virtuali su cui i clienti possono eseguire le loro applicazioni.
Regione
Una posizione fisica attorno alla quale possono essere raggruppati data center, ad esempio EU-WEST-1 (Irlanda) e EU-WEST-2 (Londra).
AZ
Una availability zone è composta da uno o più data center distinti con alimentazione, rete e connettività ridondanti. Una regione è costituita da più AZ.
Route53
Un servizio DNS altamente disponibile.
WAF
Web Application Firewall che aiuta a proteggere le applicazioni da exploit e bot comuni che potrebbero influire sulla disponibilità, compromettere la sicurezza o consumare risorse eccessive.
Fondamenti di Kubernetes
Kubernetes viene talvolta indicato come K8s. Questo perché ci sono otto lettere tra la K e la S in Kubernetes.
Cluster
EKS effettua il provisioning di un cluster K8s gestito. Questo è il componente di livello più alto e funge da contenitore per tutti i servizi, i nodi e i pod.
EKS ha un'integrazione stretta con CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager e altri.
Prendendo l'esempio più semplice, possiamo archiviare le immagini dei container in ECR ed eseguire e gestire la nostra applicazione con EKS, distribuito in una VPC su più availability zone, con tutti i log di sistema e applicativi pubblicati su CloudWatch.
Master/control plane
Il nodo master è il cuore di K8s e aiuta a gestire, monitorare, schedulare e pianificare i nodi. Include diversi sottocomponenti.
ETCD
Un key-value store che persiste tutti i dati critici del cluster
Kube scheduler
Lo scheduler distribuisce i container nei nodi
Kube controller manager
Garantisce il corretto stato dei componenti del cluster, assicurando che il carico di lavoro desiderato corrisponda a quello effettivo.
API
Tutte le interazioni dall'esterno del cluster passano tramite le API di K8s.
Nodi (worker node)
Un worker node EKS è un'istanza EC2. Ogni nodo ha installato il runtime docker per eseguire i container, l'agente Kubelet che gestisce tutte le comunicazioni da e verso il master e il K-proxy, che consente la comunicazione tra nodi.
Per integrare i nodi con CloudWatch, il ruolo IAM del nodo deve includere la policy CloudWatchLogsFullAccess.
Pod
Un pod è la più piccola unità distribuibile. Esegue un singolo container applicativo più eventuali sidecar container necessari. Ogni pod è effimero e avrà un indirizzo IP univoco.
Deployment e Replica set
Un replica set gestisce un insieme di pod per etichette e garantisce che ci sia sempre un set stabile di pod in esecuzione per un determinato carico di lavoro. Se un pod si interrompe, è compito del replica set ripristinarlo.
I deployment gestiscono i replica set. Se un replica set si interrompe, è compito del deployment ripristinarlo. I deployment possono essere configurati come rolling, ramped, re-create o canary (i dettagli sui tipi di deployment sono fuori dallo scopo di questo articolo).
Service
Ai fini di questo articolo, possiamo considerare un service come una mappatura diretta a un Application Load Balancer (ALB) di AWS, che è un tipo di ELB. C'è dell'altro, ma è importante capire alcuni dei vantaggi che un ALB può offrire:
La funzione principale di un service è distribuire il traffico tra nodi/pod.
Scalabilità dei container
ASG ed EC2
Un componente fondamentale di EC2 è l'Auto Scaling Group (ASG). Questo componente AWS mantiene un parco di istanze EC2 a un carico di lavoro desiderato su più AZ all'interno di una regione, di solito dietro un load balancer.
Le metriche di CloudWatch forniscono i trigger per scalare in o out.
Questo tipo di scalabilità è detta orizzontale poiché il parco server applicativi può espandersi e contrarsi “orizzontalmente” per soddisfare le richieste di traffico. Un esempio di policy di scaling potrebbe essere mantenere tutte le istanze sotto il 50% di utilizzo CPU. A questo livello, l'ASG è normalmente configurato per gestire un numero uguale di istanze EC2 per AZ, ma esistono altre configurazioni oltre lo scopo di questo articolo.
HPA
È molto importante distinguere tra scalabilità a livello EC2 e a livello pod. L'Horizontal Pod Autoscaler è responsabile della scalabilità dei pod all'interno di ciascun nodo. L'HPA usa le metriche di K8s raccolte tramite il Metrics Server (deve essere installato nel cluster e non fa parte del deployment predefinito di EKS) e scala i pod in base alle metriche del nodo. Un esempio di policy di scaling potrebbe essere un target di utilizzo vCPU al 50%.
EKS Cluster autoscaler
Il cluster autoscaling richiede l'installazione dell'open-source EKS cluster autoscaler, responsabile della scalabilità del servizio K8s insieme a un AWS ASG, che a sua volta gestisce la scalabilità delle istanze fisiche effettuate per il cluster.
Quando un nodo raggiunge la capacità massima in base alla policy di scaling HPA, il cluster autoscaler creerà un'altra istanza EC2 e la aggiungerà all'ASG.
Il quadro completo
Le policy di scalabilità sono altamente flessibili, personalizzabili e configurabili, ma di norma includono un periodo di raffreddamento prima di ridurre/contrarre per evitare scalate inutili dovute a richieste di traffico irregolari e fluttuanti.
È importante notare che se un pod supera il limite di vCPU, Kubernetes effettuerà il throttling dell'applicazione in esecuzione in quel pod; se invece un pod supera i limiti di memoria, Kubernetes riavvierà il container.
Ottimizzazione dei costi
Esempio di come limitare i pod all'interno di istanze usando un'istanza di tipo m5.large:
2 * vCPU = 2000m (millicore)
8 GiB di memoria
Restrizioni di risorse del pod:
Osservabilità
EKS Resource View
Mostra tutte le risorse in esecuzione sul cluster.
CloudWatch Container Insights
Helm
Helm è un gestore di pacchetti per Kubernetes che automatizza il packaging, la configurazione e la distribuzione delle applicazioni. Le chart Helm ti consentono di creare, condividere, versionare e pubblicare applicazioni Kubernetes complesse.
Alcuni esempi interessanti di chart nell'ambito della data science e del machine learning sono:
Queste applicazioni K8s possono essere distribuite sul tuo cluster EKS tramite Helm con un singolo comando!
Conclusione
In questa guida completa abbiamo esplorato i fondamenti dell'orchestrazione dei container con AWS Elastic Kubernetes Service (EKS). Dalla comprensione delle basi dei container e delle loro applicazioni reali in data science e machine learning, fino all'approfondimento dei servizi AWS e dei componenti di Kubernetes, abbiamo coperto molti aspetti. Il mondo dell'orchestrazione dei container è complesso ma estremamente gratificante, offrendo scalabilità, manutenibilità ed economicità.
Che tu sia uno sviluppatore, un data scientist o un professionista IT, padroneggiare l'orchestrazione dei container sarà senza dubbio una competenza preziosa nel tuo toolkit. Man mano che le aziende continuano a migrare a soluzioni cloud e ad adottare architetture a microservizi, la domanda di professionisti con competenze in questi ambiti è destinata a crescere.
Pronto a mettere in pratica le tue conoscenze? DataCamp offre una gamma di corsi che possono aiutarti ad approfondire Kubernetes, Docker e il cloud computing. Dai livelli per principianti a quelli avanzati, troverai lezioni interattive, sfide reali e tutorial guidati da esperti per migliorare le tue competenze.
Link utili