Este artículo se centra en la contenedorización de aplicaciones en el desarrollo de software moderno con la orquestación de contenedores de un proveedor cloud, que nos permite desplegar y escalar dinámicamente nuestras aplicaciones para ajustarse a cualquier demanda de carga con repetibilidad, mantenibilidad, observabilidad y alta disponibilidad, todo ello optimizando costes y facilitando la recuperación ante desastres.
En breve
- Los contenedores nos permiten empaquetar nuestras aplicaciones como imágenes ligeras independientes de la plataforma, muy rápidas de iniciar y replicar.
- Los motores de orquestación de contenedores nos permiten gestionar de forma dinámica cargas de trabajo distribuidas, grandes e impredecibles.
- AWS EKS es uno de los orquestadores de contenedores más populares y ofrece una integración estrecha con numerosos servicios de AWS.
- Usa charts de Helm para desplegar aplicaciones complejas de machine learning o data science en Kubernetes con un solo comando.
¿Por qué contenedores?
Es casi imposible responder al "por qué" sin el "qué", así que empecemos por los problemas que pretenden resolver los contenedores y qué es un contenedor para poder responder al "por qué".
En el modelo tradicional de ingeniería de software, los desarrolladores escribían código en sus máquinas locales, que luego se desplegaba en un entorno de pruebas y, posteriormente, se publicaba en producción. El problema de este modelo eran las inconsistencias entre entornos y las dependencias y librerías que se ejecutaban en los distintos servidores.
Así, una aplicación que "en mi máquina funciona" (como dice la clásica frase de desarrollador) podría depender de librerías de tiempo de ejecución con versiones muy diferentes a las del entorno de destino, lo que puede provocar comportamientos inesperados al desplegarla.
Los contenedores resuelven esto abstrayendo por completo la capa de la aplicación al empaquetar código compilado, librerías, dependencias y runtimes en una "imagen".
Una imagen de contenedor puede utilizarse como plantilla que un motor de contenedores, como Docker, puede desplegar y ejecutar rápidamente como instancia de contenedor con un comportamiento predecible en cualquier entorno.
Los siguientes problemas que resuelven los contenedores son la escalabilidad, la mantenibilidad y la optimización de costes. Históricamente, los entornos de producción se componían de una gran cantidad de hardware (caro) reservado y protegido para uso exclusivo de aplicaciones de gran volumen o críticas para el negocio. Estos entornos costosos requerían gestión, mantenimiento y parcheo constantes.
La cantidad de hardware asignado a estas aplicaciones debía ser la máxima necesaria para cubrir el pico de carga, pero las aplicaciones no siempre tienen patrones de uso consistentes y predecibles. Esto provoca grandes cantidades de hardware inactivo en horas valle.
La solución es la orquestación de contenedores.
Dado que una imagen de contenedor es independiente de la plataforma, los recursos de cómputo para contenedores pueden escalarse hacia arriba o hacia abajo bajo demanda usando cualquier servidor disponible que tenga capacidad para ejecutar un motor de contenedores, dejando el mantenimiento del sistema operativo del servidor subyacente desacoplado de la aplicación.
Esto impacta directamente en la optimización de costes: si gestionamos nuestros contenedores y los orquestamos de forma que se ajusten dinámicamente a la demanda actual, maximizamos el uso del bare metal.
Esta explicación es una vista "a vuelo de pájaro"; entraremos en detalle en las siguientes secciones, pero antes, hablemos de usos prácticos de los contenedores.
Contenedores para data science y machine learning
Las aplicaciones de data science y machine learning suelen ser muy intensivas en cómputo
con patrones de uso a veces impredecibles y manejan volúmenes de datos enormes.
Con frecuencia, estas aplicaciones se benefician de la paralelización para dividir el problema y conquistarlo antes de persistir resultados en un almacén de datos. Es una gran simplificación, pero salta a la vista que este tipo de aplicaciones encaja a la perfección con los contenedores y su orquestación.
Con todo esto claro, pasemos al "cómo". Al final del artículo retomaremos el vínculo entre aplicaciones de data science y machine learning cuando hablemos de Helm y de cómo ejecutar aplicaciones complejas desplegadas como contenedores dentro de un motor de orquestación con un esfuerzo y una configuración mínimos.
Existen muchos motores de contenedores, pero en este artículo usaremos el más popular, Docker. Puedes familiarizarte con la plataforma en nuestro tutorial Introduction to Docker.
Máquinas virtuales (VM) vs contenedores
Las máquinas virtuales abstraen el hardware físico, convirtiendo un servidor en muchos mediante un hipervisor, lo que permite que múltiples VM compartan el mismo host. Cada VM tiene su propio sistema operativo (SO) invitado.
Los contenedores son una abstracción a nivel de aplicación. Un servidor con un motor de contenedores instalado puede ejecutar varios contenedores a la vez compartiendo el SO subyacente. Puedes aprender más sobre contenedores en nuestro tutorial de contenedorización.
La diferencia clave es que los contenedores usan el SO del host y no incluyen uno propio, a diferencia de una VM. Esto los hace mucho más ligeros y rápidos de replicar, ejecutar y destruir, a la vez que proporcionan aislamiento de seguridad y tolerancia a fallos entre contenedores (si un contenedor se cae, no afecta a los demás en ejecución).
También implica un mejor aprovechamiento de recursos, por lo que pueden ejecutarse más contenedores en un único motor de Docker que VMs en un hipervisor con especificaciones de hardware comparables.
Imagen de Docker vs contenedor
Una imagen de Docker empaqueta configuración, código, dependencias y el motor de ejecución. Las imágenes actúan como plantilla a partir de la cual replicar y ejecutar instancias de contenedor en Docker. Un contenedor puede ejecutarse en cualquier plataforma que soporte Docker.
Orquestación de contenedores
Ahora que ya sabemos qué son los contenedores, necesitamos una forma de gestionarlos. Hay varios orquestadores, pero en este artículo nos centraremos en Kubernetes ejecutándose en la nube de AWS mediante Elastic Kubernetes Service (EKS).
Algunas de las tareas clave que gestiona EKS son:
- Despliegue
- Escalado
- Balanceo de carga
- Monitorización
- Descubrimiento de servicios
- Autorreparación
Servicios de AWS
Antes de explicar EKS, necesitamos entender algunos servicios de AWS que lo sustentan.
CloudWatch
Servicio de monitorización y observabilidad que recopila datos en forma de logs, métricas y eventos.
VPC
Una nube virtual privada es una red lógicamente aislada, protegida y gestionada de forma segura por cuenta de AWS.
ELB
Un balanceador de carga elástico es un componente de red altamente disponible que puede distribuir tráfico entre múltiples destinos.
IAM
Identity and Access Management proporciona control de acceso de grano fino para cuentas de AWS.
ECR
Elastic Container Registry es un registro de imágenes de Docker totalmente gestionado.
EC2
Elastic Cloud Compute (abreviado por las 2 C) es un servicio central de AWS que sustenta muchos otros. Permite alquilar servidores virtuales sobre los que los clientes pueden ejecutar sus aplicaciones.
Región
Una ubicación física alrededor de la cual se agrupan centros de datos, por ejemplo, EU-WEST-1 (Irlanda) y EU-WEST-2 (Londres).
AZ
Una zona de disponibilidad es uno o más centros de datos independientes con alimentación, red y conectividad redundantes. Una región consta de varias AZ.
Route53
Un servicio DNS altamente disponible.
WAF
Web Application Firewall que ayuda a proteger aplicaciones frente a exploits y bots comunes que podrían afectar a la disponibilidad, comprometer la seguridad o consumir recursos en exceso.
Fundamentos de Kubernetes
A Kubernetes a veces se le llama K8s. Es porque hay ocho letras entre la K y la S en Kubernetes.
Cluster
EKS aprovisionará un clúster de K8s gestionado. Es el componente de más alto nivel y actúa como contenedor de todos los servicios, nodos y pods.
EKS se integra estrechamente con CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager y más.
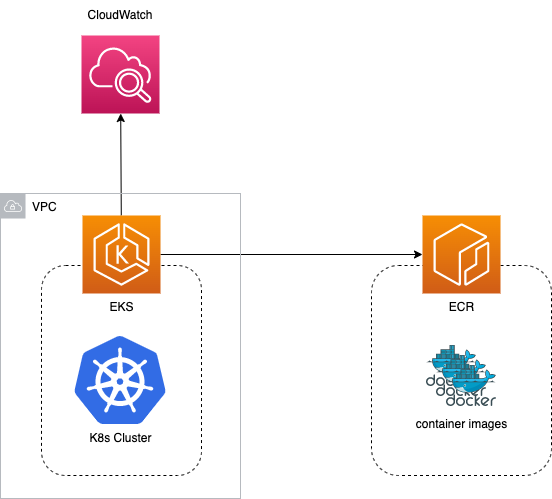
En el ejemplo más básico, podemos almacenar imágenes de contenedor en ECR y hacer que nuestra aplicación sea gestionada y ejecutada por EKS, desplegado en una VPC a través de múltiples zonas de disponibilidad, con todos los logs del sistema y de la aplicación publicados en CloudWatch.
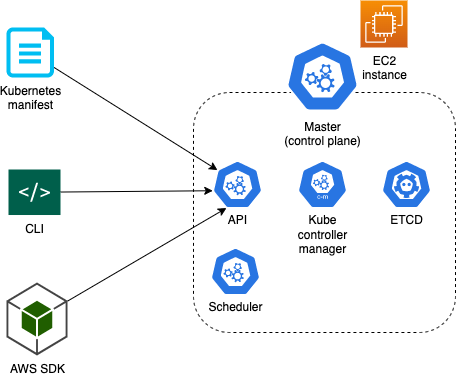
Master/control plane
El nodo maestro es el corazón de K8s y ayuda a gestionar, monitorizar, planificar y programar nodos. Tiene varios subcomponentes.
ETCD
Es un almacén clave-valor que persiste todos los datos críticos del clúster.
Kube scheduler
El planificador despliega contenedores en los nodos.
Kube controller manager
Garantiza el estado correcto de los componentes del clúster, asegurando que la carga de trabajo deseada coincida con la real.
API
Todas las interacciones desde fuera del clúster pasan por la API de K8s.
Nodos (worker nodes)
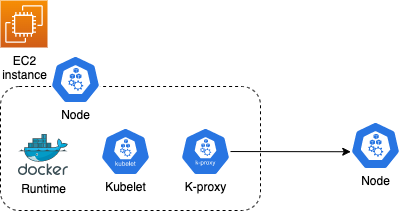
Un nodo de trabajo de EKS es una instancia de EC2. Cada nodo tiene el docker runtime instalado para ejecutar contenedores, el agente Kubelet que gestiona todas las comunicaciones con el master, y el K-proxy, que permite la comunicación entre nodos.
Para que los nodos se integren con CloudWatch, el rol de IAM del nodo debe incluir la política CloudWatchLogsFullAccess.
Pod
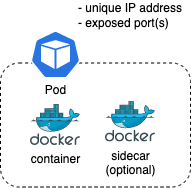
Un pod es la unidad desplegable más pequeña. Ejecuta un único contenedor de aplicación más cualquier contenedor sidecar que pueda ser necesario. Cada pod es efímero y tendrá una dirección IP única.
Deployments y replica sets
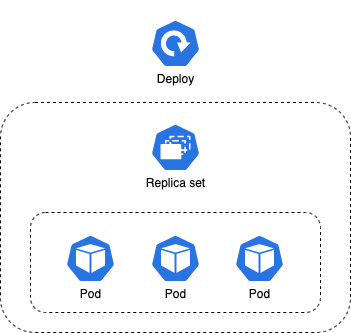
Un replica set gestiona un conjunto de pods por etiqueta y garantiza que siempre haya un conjunto estable de pods en ejecución para una carga de trabajo específica. Si un pod cae, el replica set se encarga de restaurarlo.
Los deployments gestionan replica sets. Si un replica set cae, el deployment se encarga de restaurarlo. Los deployments pueden configurarse como rolling, ramped, re-create o canary (los detalles de estos tipos de despliegue quedan fuera del alcance de este artículo).
Servicios
A efectos de este artículo, podemos considerar que un servicio se corresponde directamente con un Application Load Balancer (ALB) de AWS, que es un tipo de ELB. Hay algún matiz más, pero es importante entender algunas de las ventajas que aporta ALB:
- Asociar un nombre DNS
- Health checks
- Alta disponibilidad entre múltiples AZ
- WAF
- Access logs
La función principal de un servicio es distribuir el tráfico entre nodos/pods.
Escalado de contenedores
ASG y EC2
Un componente clave de EC2 es el Auto Scaling Group (ASG). Este componente de AWS mantiene una flota de instancias de EC2 al nivel de carga deseado a través de múltiples AZ dentro de una región, normalmente detrás de un balanceador de carga.
Las métricas de CloudWatch proporcionan los disparadores para escalar hacia dentro o hacia fuera.
Este tipo de escalado se conoce como escalado horizontal porque la flota de servidores de aplicaciones puede expandirse y contraerse "horizontalmente" para atender la demanda de tráfico. Una política de escalado de ejemplo podría ser mantener todas las instancias por debajo del 50% de uso de CPU. En este nivel, el ASG suele configurarse para gestionar un número igual de instancias de EC2 por AZ, aunque existen otras configuraciones que quedan fuera del alcance de este artículo.
HPA
Es muy importante distinguir entre el escalado a nivel de EC2 y a nivel de pod. El Horizontal Pod Autoscaler es responsable de escalar pods dentro de cada nodo. El HPA utiliza métricas de K8s recopiladas mediante el Metrics Server (debe instalarse en el clúster; no forma parte del despliegue por defecto de EKS) y escala pods en función de las métricas del nodo. Una política de ejemplo podría ser fijar el uso de vCPU en el 50%.
EKS Cluster autoscaler
El escalado del clúster requiere instalar el autoscaler de clúster de EKS (open source), responsable de escalar el servicio de K8s junto con un ASG de AWS, que a su vez gestiona el escalado de las instancias físicas aprovisionadas para el clúster.
Cuando un nodo alcanza su capacidad máxima según la política de HPA, el autoscaler del clúster creará otra instancia de EC2 y la añadirá al ASG.
La visión completa
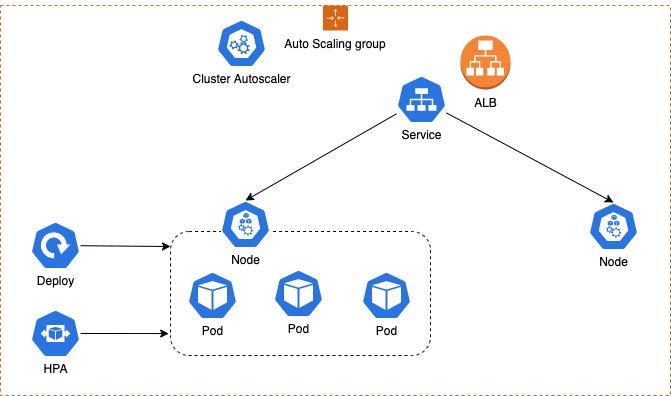
Las políticas de escalado son muy flexibles, personalizables y configurables, pero normalmente incluyen un periodo de enfriamiento antes de escalar hacia abajo/entrar para evitar escalados innecesarios por demandas de tráfico erráticas y fluctuantes.
Es importante señalar que si un pod supera su límite de vCPU, Kubernetes reducirá el ritmo de la aplicación que se ejecuta en ese pod; pero si un pod supera sus límites de memoria, Kubernetes reiniciará el contenedor.
Optimización de costes
Un ejemplo de cómo restringir pods dentro de instancias usando un tipo m5.large:
2 * vCPU = 2000m (millicore)
8 GiB de memoria
Restricciones de recursos por pod:
- vCPU reservado, p. ej., 500m
- Límite de vCPU, p. ej., 1000m
- Memoria reservada, p. ej., 256Mi
- Límite de memoria, p. ej., 512Mi
Observabilidad
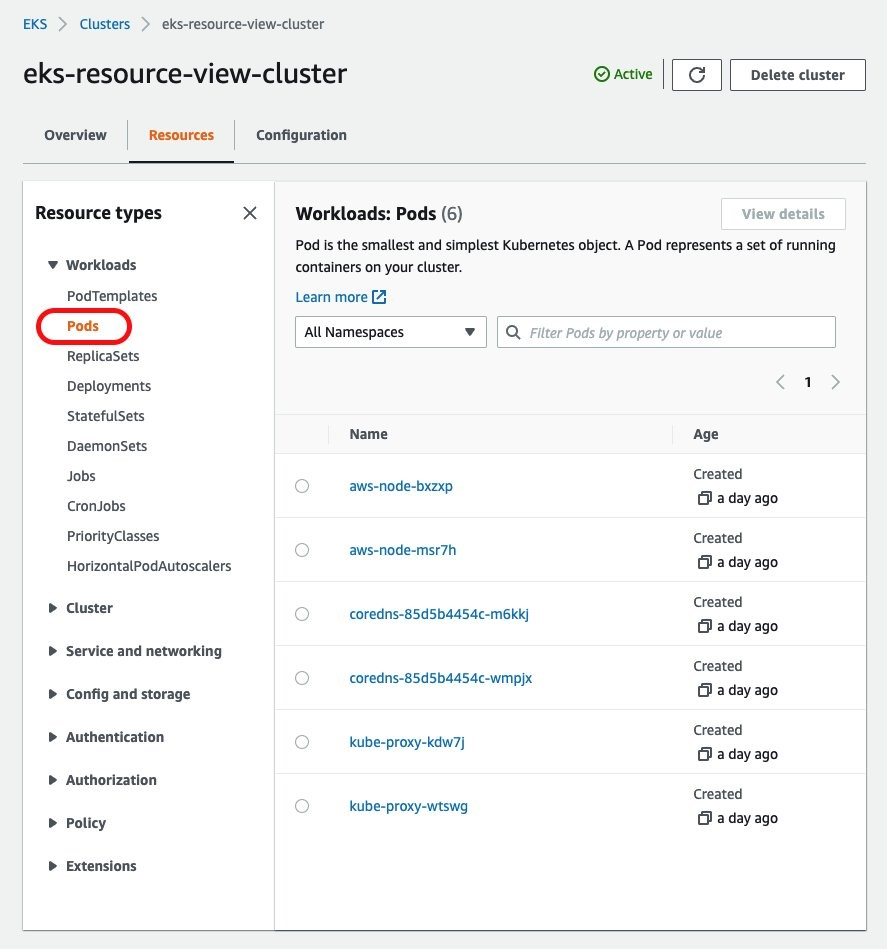
EKS Resource View
Muestra todos los recursos que se ejecutan en el clúster.
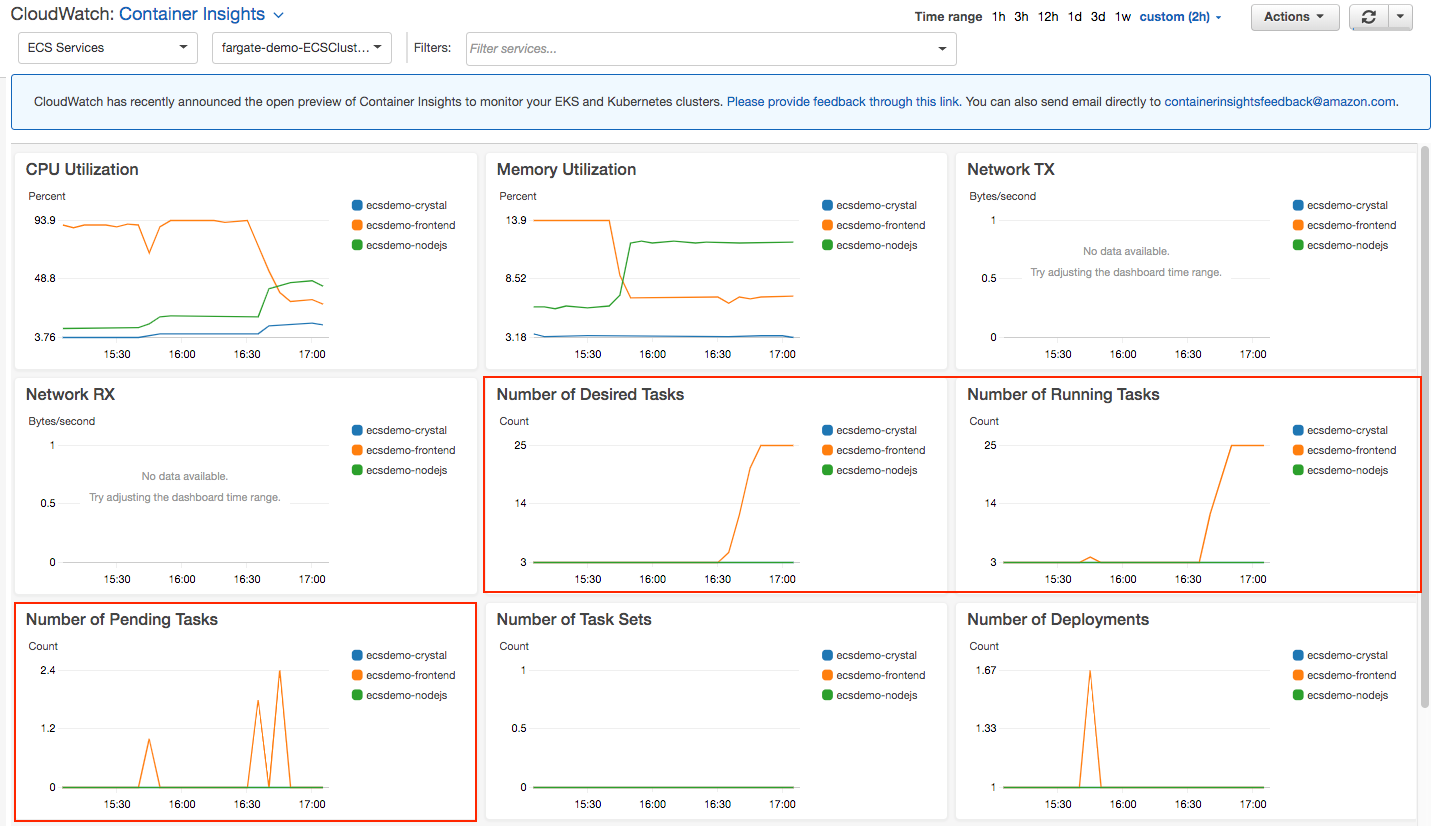
CloudWatch Container Insights
- Monitorización
- Alarmas
- Disparar funciones lambda
- Dashboards y métricas precreadas
- Instalación con un clic
Helm
Helm es un gestor de paquetes para Kubernetes que automatiza el empaquetado, la configuración y el despliegue de aplicaciones. Los charts de Helm te permiten crear, compartir, versionar y publicar aplicaciones complejas de Kubernetes.
Algunos charts interesantes en el ámbito de data science y machine learning son:
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
¡Estas aplicaciones de K8s pueden desplegarse en tu clúster de EKS mediante Helm con un solo comando!
Conclusión
En esta guía completa hemos visto los fundamentos de la orquestación de contenedores con AWS Elastic Kubernetes Service (EKS). Desde los conceptos básicos de los contenedores y sus aplicaciones en el mundo real para data science y machine learning, hasta los entresijos de los servicios de AWS y los componentes de Kubernetes, hemos cubierto mucho terreno. El mundo de la orquestación de contenedores es complejo pero muy gratificante: ofrece escalabilidad, mantenibilidad y optimización de costes.
Tanto si eres desarrollador, data scientist o profesional de IT, dominar la orquestación de contenedores será sin duda una habilidad valiosa en tu kit de herramientas. A medida que las empresas migran a soluciones en la nube y adoptan arquitecturas de microservicios, la demanda de profesionales con experiencia en estas áreas no hará más que crecer.
¿Listo para poner en práctica lo que has aprendido? DataCamp ofrece una variedad de cursos para profundizar en Kubernetes, Docker y computación en la nube. Desde nivel inicial hasta avanzado, encontrarás lecciones interactivas, retos reales y tutoriales impartidos por expertos para impulsar tus habilidades.
- Introduction to Docker
- Machine Learning, Pipelines, Deployment and MLOps Tutorial
- AWS Cloud Concepts Course
Enlaces útiles
- Kubectl cheat sheet con los comandos más usados
- Tutorial de HPA que explica el HPA y te guía por una aplicación con escalado gestionado
- Tutorial de cluster autoscaler para configurar y ejecutar una aplicación sencilla con escalado de clúster
- Charts de Helm
- Calculadora de precios de AWS