Dit artikel richt zich op applicatie-containerisatie in moderne softwareontwikkeling met containerorchestratie van cloudproviders. Daarmee kunnen we onze applicaties uitrollen en dynamisch schalen naar elke werklastvraag, met herhaalbaarheid, onderhoudbaarheid, observability en hoge beschikbaarheid, terwijl we kosten beheersbaar houden en disaster recovery mogelijk maken.
In het kort
- Containers stellen ons in staat om onze applicaties platformonafhankelijk te verpakken als lichtgewicht images die razendsnel opstarten en te repliceren zijn.
- Engines voor containerorchestratie maken het mogelijk om onvoorspelbare en grote, gedistribueerde rekenwerklasten dynamisch te beheren.
- AWS EKS is een van de populairste containerorchestrators en biedt nauwe integratie met tal van AWS-diensten.
- Gebruik Helm-charts om complexe machine learning- of data science-Kubernetes-applicaties met één commando te deployen.
Waarom containers?
Het is bijna onmogelijk om de “waarom” te beantwoorden zonder de “wat”. Laten we daarom beginnen met welke problemen containers oplossen en wat een container is, om zo de “waarom” te beantwoorden.
In het oude model van software-engineering schreven ontwikkelaars code op hun lokale machines, die vervolgens werd uitgerold naar een testomgeving, waarna een release naar productie volgde. Het probleem hierbij waren de inconsistenties tussen omgevingen en de afhankelijkheden en libraries die op verschillende servers draaiden.
Een applicatie die “op mijn machine werkt” (om een klassieke ontwikkelaarsquote te gebruiken) kan afhankelijk zijn van runtime-libraries met heel andere versies dan in de doelsituatie, wat na deployment tot onverwacht gedrag kan leiden.
Containers lossen dit op door de applicatielaag volledig te abstraheren: gecompileerde code, libraries, dependencies en runtimes worden verpakt in een “image”.
Een containerimage kan vervolgens dienen als sjabloon dat een containerengine, zoals Docker, snel kan deployen en uitvoeren als een containerinstantie met voorspelbaar gedrag in elke omgeving.
De volgende problemen die containers oplossen zijn schaalbaarheid, onderhoudbaarheid en kostenefficiëntie. Productieomgevingen bestonden historisch uit een grote hoeveelheid (dure) hardwarebronnen die werden afgeschermd voor exclusief gebruik door applicaties met hoog volume of bedrijfskritische applicaties. Deze dure omgevingen vereisten voortdurend beheer, onderhoud en patching.
De hoeveelheid hardware die aan zulke applicaties werd toegewezen, moest het maximum zijn om de piekbelasting aan te kunnen, maar applicaties hebben niet altijd een consistent, voorspelbaar gebruikspatroon. Dit leidt ertoe dat veel hardware tijdens daluren ongebruikt blijft.
De oplossing is containerorchestratie.
Omdat een containerimage platformonafhankelijk is, kunnen compute-resources voor containers on demand worden opgeschaald en afgeschaald op elke beschikbare server met de capaciteit om een containerengine te draaien, waarbij het onderhoud van het onderliggende besturingssysteem losstaat van de applicatie.
Dit heeft een duidelijke impact op de kosten: als we onze containers zo orkestreren dat ze dynamisch aan de actuele vraag voldoen, benutten we de bare metal maximaal.
Dit is een uitleg op hoog niveau; we duiken in de volgende secties dieper de inhoud in. Maar eerst bekijken we enkele praktische toepassingen van containers.
Containers voor data science en machine learning
Applicaties voor data science en machine learning zijn vaak zeer rekenintensief
met soms onvoorspelbare gebruikspatronen en ze verwerken enorme hoeveelheden data.
Dergelijke applicaties profiteren vaak van parallelisatie om een probleem te verdelen en te veroveren, waarna resultaten worden opgeslagen in een datastore. Dit is een forse simplificatie, maar het is meteen duidelijk dat zulke applicaties perfect passen bij containers en containerorchestratie!
Gewapend met die kennis gaan we nu in op de “hoe”. Aan het einde van dit artikel komen we terug op de link met data science- en machine learning-applicaties wanneer we het hebben over Helm en hoe we met minimale inspanning en configuratie complexe applicaties als containers binnen een containerorchestratie-engine kunnen draaien.
Er zijn veel containerengines, maar in dit artikel gebruiken we de populairste: Docker. Je kunt het platform leren kennen in onze tutorial Inleiding tot Docker.
Virtuele machines (VM’s) vs. containers
Virtuele machines abstraheren fysieke hardware en veranderen één server in meerdere via een hypervisor, zodat meerdere VM’s dezelfde host kunnen delen. Elke VM heeft een guest-besturingssysteem (OS).
Containers zijn een abstractie op de applicatielaag. Een server met een geïnstalleerde containerengine kan meerdere containers tegelijk draaien, die allemaal hetzelfde onderliggende OS delen. Je kunt meer leren over containers in onze containerisatietutorial.
Het belangrijkste verschil is dat containers het host-OS gebruiken en niet, zoals een VM, met een eigen OS worden geleverd. Daardoor zijn ze veel lichter en sneller te repliceren, te draaien en te verwijderen, terwijl ze nog steeds zorgen voor beveiligingsisolatie en fouttolerantie tussen containers (als een container crasht, heeft dat geen impact op andere containers).
Het betekent ook een betere resourcebenutting, zodat op één Docker-engine meer containers kunnen draaien dan VM’s op een hypervisor, gegeven vergelijkbare onderliggende hardwarespecificaties.
Docker-image vs. container
Een Docker-image verpakt configuratie, code, dependencies en de runtime-engine. Images fungeren als sjabloon om containerinstanties binnen Docker te repliceren en te draaien. Een container kan op elk platform draaien dat Docker ondersteunt.
Containerorchestratie
Nu we alles weten over containers, hebben we een manier nodig om ze te beheren. Er zijn verschillende orchestrators, maar in dit artikel focussen we op Kubernetes in de AWS-cloud via Elastic Kubernetes Service (EKS).
Enkele kerntaken die door EKS worden beheerd:
- Deployment
- Schaling
- Load balancing
- Monitoring
- Service discovery
- Self-healing
AWS-services
Voordat we EKS uitleggen, moeten we enkele AWS-clouddiensten begrijpen die onder EKS liggen.
CloudWatch
Monitoring- en observabilityservice die data verzamelt in de vorm van logs, metrics en events.
VPC
Een Virtual Private Cloud is een logisch geïsoleerd netwerk dat per AWS-account veilig wordt beheerd.
ELB
Een Elastic Load Balancer is een zeer beschikbare netwerkcomponent die verkeer over meerdere targets kan verdelen.
IAM
Identity and Access Management biedt fijnmazige toegangscontrole voor AWS-accounts.
ECR
De Elastic Container Registry is een volledig beheerde container registry voor Docker-images.
EC2
Elastic Cloud Compute (afgekort vanwege de 2 C’s) is een kernservice van AWS die vele andere ondersteunt. Hiermee kun je virtuele servers huren waarop je je applicaties kunt draaien.
Region
Een fysieke locatie waar datacenters kunnen worden geclusterd, bijvoorbeeld EU-WEST-1 (Ierland) en EU-WEST-2 (Londen).
AZ
Een Availability Zone is één of meer afzonderlijke datacenters met eigen redundante stroom, netwerk en connectiviteit. Een regio bestaat uit meerdere AZ’s.
Route53
Een zeer beschikbare DNS-service.
WAF
Web Application Firewall die helpt applicaties te beschermen tegen veelvoorkomende exploits en bots die beschikbaarheid kunnen beïnvloeden, beveiliging kunnen compromitteren of buitensporige resources kunnen verbruiken.
Kubernetes-basisbegrippen
Kubernetes wordt soms K8s genoemd. Dat komt omdat er acht letters zitten tussen de K en de S in Kubernetes.
Cluster
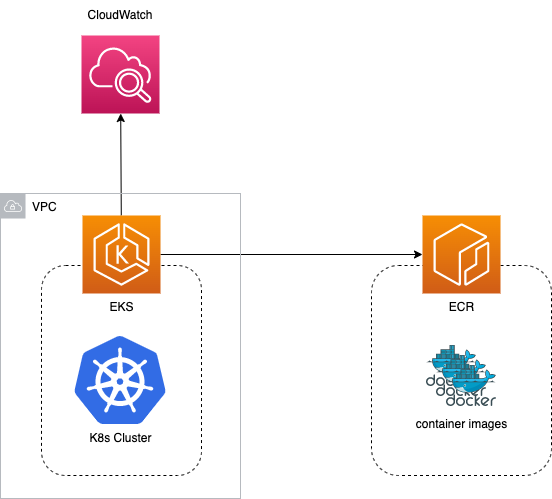
EKS voorziet in een beheerd K8s-cluster. Dit is de component op het hoogste niveau en fungeert als container voor alle services, nodes en pods.
EKS integreert nauw met CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager en meer.
In het meest basale voorbeeld slaan we containerimages op in ECR en laten we onze applicatie beheren en draaien door EKS, dat in een VPC over meerdere availability zones wordt uitgerold, met alle systeem- en applicatielogs die naar CloudWatch worden gepubliceerd.
Master/control plane
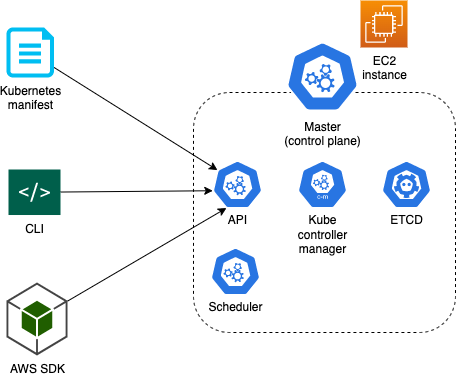
De master node is het hart van K8s en helpt nodes te beheren, te monitoren, te plannen en in te delen. Deze heeft verschillende subcomponenten.
ETCD
Dit is een keyvaluestore die alle kritieke clusterdata bewaart
Kube scheduler
De scheduler deployt containers naar nodes
Kube controller manager
Dit zorgt voor de juiste status van clustercomponenten en bewaakt dat de gewenste werklast overeenkomt met de daadwerkelijke werklast.
API
Alle interacties van buiten het cluster verlopen via de K8s-API.
Nodes (workernodes)
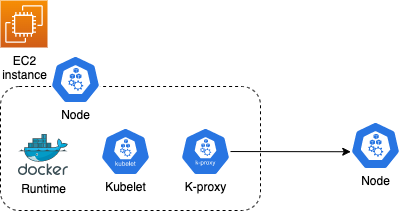
Een EKS-workernode is een EC2-instantie. Elke node heeft de docker runtime geïnstalleerd om containers te draaien, de Kubelet-agent die alle communicatie van en naar de master afhandelt, en de K-proxy, die communicatie tussen nodes mogelijk maakt.
Om nodes met CloudWatch te integreren, moet de IAM-rol voor de node het beleid CloudWatchLogsFullAccess bevatten.
Pod
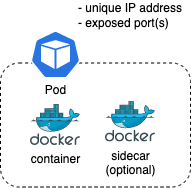
Een pod is de kleinste deploybare eenheid. Hij draait één applicatiecontainer plus eventuele sidecarcontainers die nodig zijn. Elke pod is vluchtig en heeft een uniek IP-adres.
Deployments en ReplicaSets
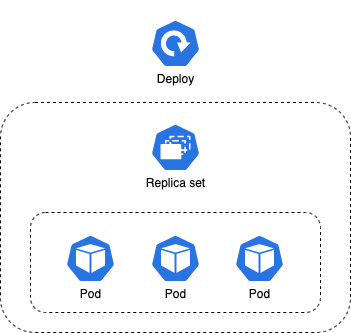
Een ReplicaSet beheert een set pods op basis van een label en zorgt ervoor dat er altijd een stabiele set draaiende pods is voor een bepaalde werklast. Als een pod uitvalt, is het de taak van de ReplicaSet om die pod te herstellen.
Deployments beheren ReplicaSets. Als een ReplicaSet uitvalt, is het de taak van de Deployment om deze te herstellen. Deployments kunnen worden geconfigureerd als rolling, ramped, re-create of canary (details over deploymenttypes vallen buiten de scope van dit artikel).
Services
Voor dit artikel kun je een service zien als een directe mapping naar een AWS Application Load Balancer (ALB), een type ELB. Er komt iets meer bij kijken, maar het is belangrijk om enkele voordelen van een ALB te begrijpen:
- Een DNS-naam koppelen
- Health checks
- Hoge beschikbaarheid over meerdere AZ’s
- WAF
- Access logs
De primaire functie van een service is het verdelen van verkeer tussen nodes/pods.
Container schalen
ASG en EC2
Een kernonderdeel van EC2 is de Auto Scaling Group (ASG). Deze AWS-component houdt een vloot EC2-instanties op een gewenste werklast over meerdere AZ’s binnen een regio, meestal achter een load balancer.
CloudWatch-metrics leveren de triggers om in of uit te schalen.
Dit type schaling staat bekend als horizontale schaling, omdat de vloot applicatieservers zich “horizontaal” kan uitbreiden en inkrimpen om aan de verkeersvraag te voldoen. Een voorbeeld van een schaalbeleid is om alle instanties onder 50% CPU-gebruik te houden. Op dit niveau wordt de ASG doorgaans geconfigureerd om een gelijk aantal EC2-instanties per AZ te beheren, maar er zijn andere configuraties mogelijk die buiten de scope van dit artikel vallen.
HPA
Het is heel belangrijk onderscheid te maken tussen schalen op EC2-niveau en op podniveau. De Horizontal Pod Autoscaler is verantwoordelijk voor het schalen van pods binnen elke node. De HPA gebruikt K8s-metrics die worden verzameld via de Metrics Server (die moet binnen het cluster geïnstalleerd worden en geen onderdeel is van de standaard EKS-clusterdeployment) en schaalt pods op basis van nodemetrics. Een voorbeeldschaalbeleid kan zijn om vCPU-gebruik te richten op 50%.
EKS Cluster Autoscaler
Clusterschaling vereist de installatie van de open-source EKS Cluster Autoscaler, die verantwoordelijk is voor het schalen van de K8s-service naast een AWS ASG, die op zijn beurt het schalen van de fysieke instanties beheert die voor het cluster zijn ingericht.
Wanneer een node zijn maximale capaciteit bereikt op basis van het HPA-schaalbeleid, maakt de Cluster Autoscaler een extra EC2-instantie aan en voegt die toe aan de ASG.
Het complete plaatje
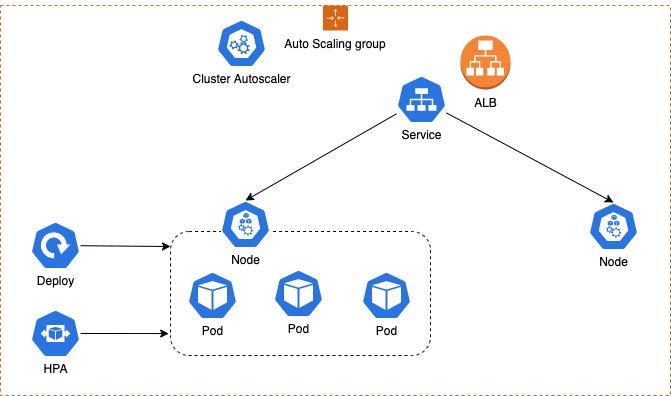
Schaalbeleid is zeer flexibel, aanpasbaar en configureerbaar, maar heeft normaal gesproken een cool-downperiode voordat er wordt afgeschaald om onnodige schaling door grillige, fluctuerende verkeersvraag te voorkomen.
Belangrijk om te weten: als een pod zijn vCPU-limiet overschrijdt, zal Kubernetes de applicatie in die pod throttlen. Als een pod echter zijn geheugenlimiet overschrijdt, zal Kubernetes de container herstarten.
Kostenoptimalisatie
Een voorbeeld van het beperken van pods binnen instanties met een m5.large-instantietype:
2 * vCPU = 2000m (millicore)
8 GiB geheugen
Resourcebeperkingen voor pods:
- Gereserveerde hoeveelheid vCPU, bijv. 500m
- Limiet van vCPU, bijv. 1000m
- Gereserveerde hoeveelheid geheugen, bijv. 256Mi
- Limiet van geheugen, bijv. 512Mi
Observability
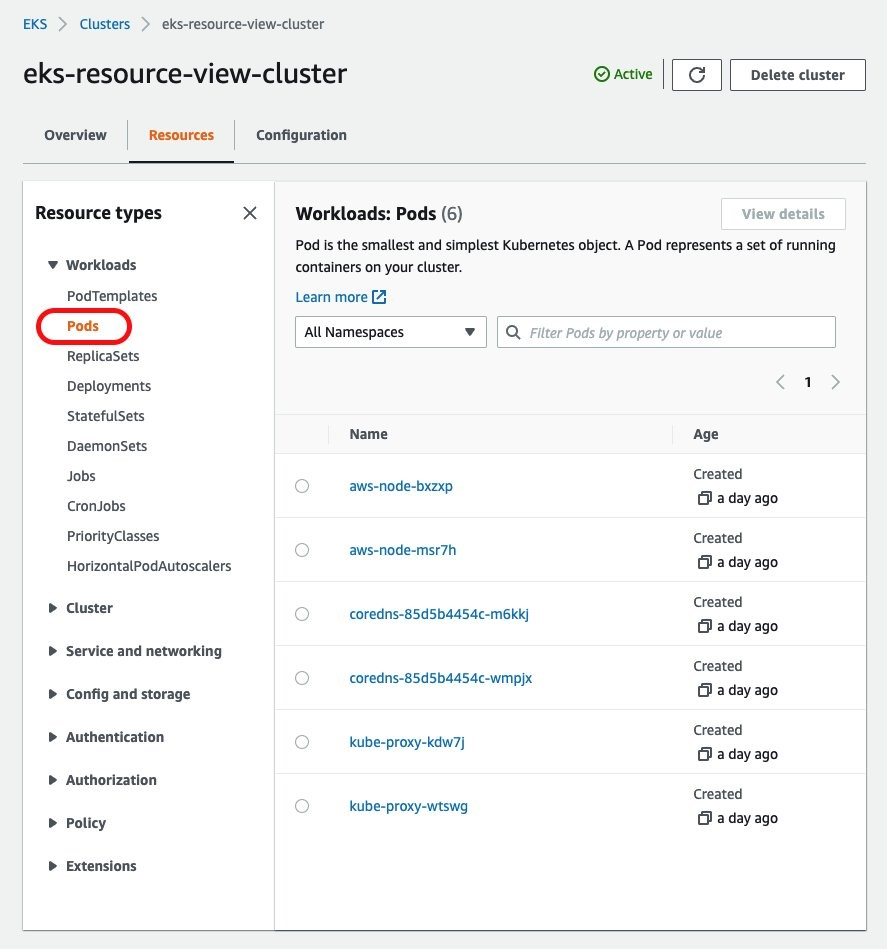
EKS Resource View
Toont alle resources die op het cluster draaien.
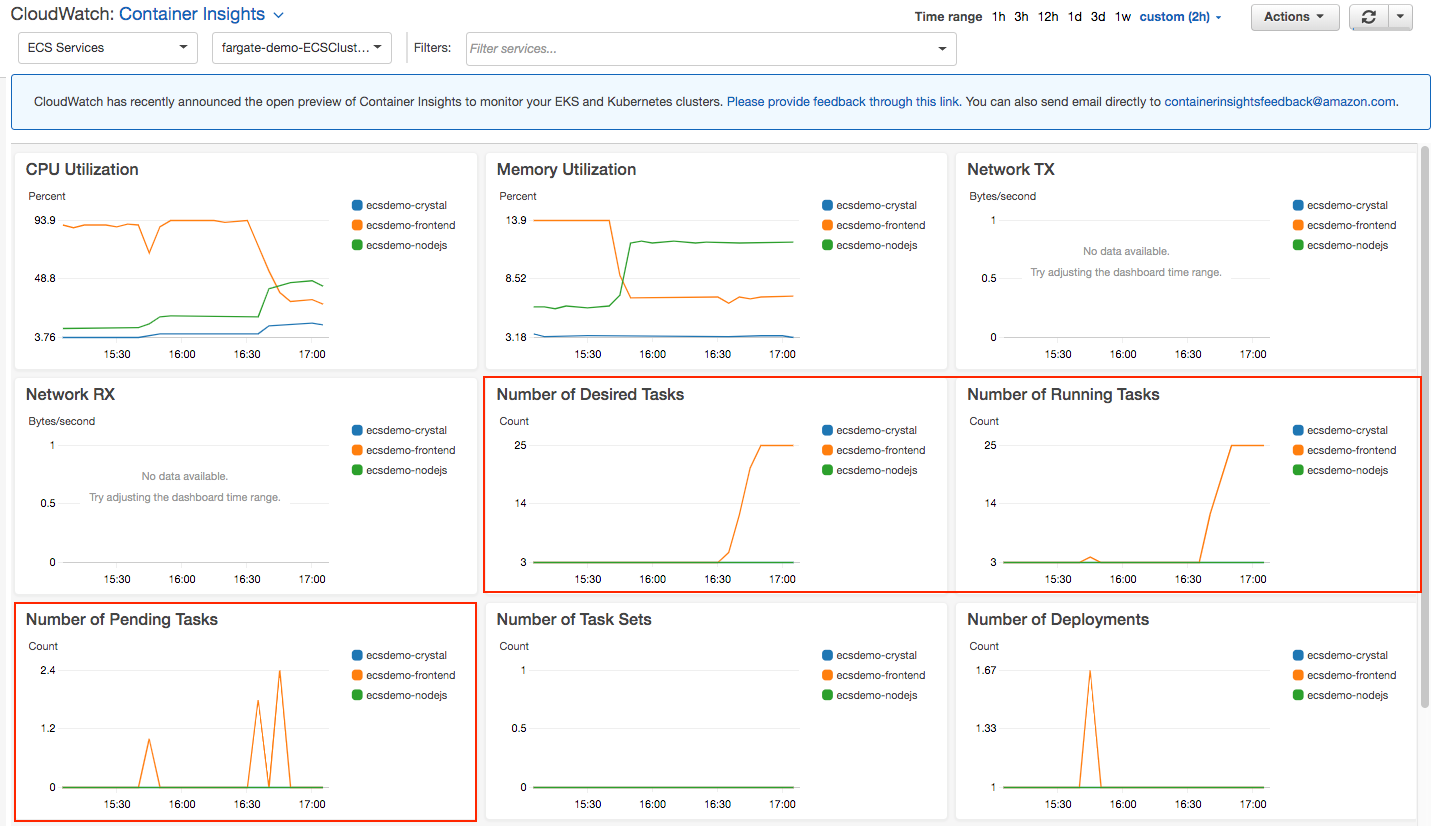
CloudWatch Container Insights
- Monitors
- Alarms
- Lambda-functies triggeren
- Vooraf gemaakte dashboards en metrics
- Installatie met één klik
Helm
Helm is een pakketmanager voor Kubernetes die het verpakken, configureren en deployen van applicaties automatiseert. Met Helm-charts kun je complexe Kubernetes-applicaties maken, delen, versies beheren en publiceren.
Enkele interessante chartexamples binnen data science en machine learning zijn:
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
Deze K8s-applicaties kun je met één enkel commando via Helm naar je EKS-cluster deployen!
Conclusie
In deze uitgebreide gids hebben we de basisprincipes van containerorchestratie met AWS Elastic Kubernetes Service (EKS) verkend. Van het begrijpen van de essentie van containers en hun praktijktoepassingen in data science en machine learning, tot het verdiepen in de finesses van AWS-services en Kubernetes-componenten: we hebben veel behandeld. De wereld van containerorchestratie is complex maar enorm waardevol, met voordelen op het gebied van schaalbaarheid, onderhoudbaarheid en kosten.
Of je nu ontwikkelaar, data scientist of IT-professional bent, het beheersen van containerorchestratie is ongetwijfeld een waardevolle skill in je toolkit. Nu bedrijven blijven migreren naar cloudoplossingen en microservices-architecturen omarmen, groeit de vraag naar professionals met expertise in deze gebieden alleen maar.
Klaar om je kennis in de praktijk te brengen? DataCamp biedt een reeks cursussen om je begrip van Kubernetes, Docker en cloud computing te verdiepen. Van beginner tot gevorderd: je vindt interactieve lessen, realistische uitdagingen en tutorials onder leiding van experts om je skills te versterken.
- Inleiding tot Docker
- Machine Learning, Pipelines, Deployment en MLOps-tutorial
- Cursus AWS Cloud Concepts
Handige links
- Kubectl spiekbrief met de meestgebruikte commando’s
- HPA tutorial legt de HPA uit en gidst je door een applicatie met beheerde schaling
- Cluster Autoscaler tutorial om een eenvoudige applicatie met clusterschaling op te zetten en te draaien
- Helm charts
- AWS prijscalculator