Dieser Artikel beleuchtet die Containerisierung von Anwendungen in der modernen Softwareentwicklung mithilfe der Container-Orchestrierung von Cloud-Providern. So lassen sich Anwendungen mit Wiederholbarkeit, Wartbarkeit, Observability und hoher Verfügbarkeit bereitstellen und dynamisch auf jede Lastanforderung skalieren – kosteneffizient und mit Disaster-Recovery.
Kurz und knapp
- Container erlauben es, Anwendungen plattformunabhängig als leichtgewichtige Images zu paketieren, die sich extrem performant starten und replizieren lassen.
- Engines zur Container-Orchestrierung ermöglichen das dynamische Management unvorhersehbarer, großer verteilter Rechenlasten.
- AWS EKS ist einer der beliebtesten Orchestratoren und bietet eine enge Integration in zahlreiche AWS-Services.
- Nutze Helm-Charts, um komplexe Machine-Learning- oder Data-Science-Anwendungen für Kubernetes mit einem einzigen Befehl zu deployen.
Warum Container?
Die Frage nach dem „Warum“ lässt sich kaum ohne das „Was“ beantworten. Also beginnen wir damit, welche Probleme Container lösen sollen und was ein Container ist – dann ergibt sich das „Warum“ fast von selbst.
Früher schrieben Entwickler Code lokal, der dann in eine Testumgebung und anschließend in die Produktion ausgerollt wurde. Das Problem: Unterschiede zwischen Umgebungen sowie abweichende Abhängigkeiten und Libraries auf den jeweiligen Servern.
Eine Anwendung, die „auf meinem Rechner läuft“ (ein Klassiker), könnte auf Runtime-Libraries in ganz anderen Versionen angewiesen sein als in der Zielumgebung – mit unerwartetem Verhalten nach dem Deployment.
Container lösen das, indem sie die Anwendungsschicht komplett abstrahieren: Kompilierter Code, Libraries, Abhängigkeiten und Runtimes werden in einem „Image“ gebündelt.
Ein Container-Image dient dann als Vorlage, die eine Engine wie Docker blitzschnell als Container-Instanz ausrollt – mit vorhersehbarem Verhalten in jeder Umgebung.
Die nächsten Punkte, die Container adressieren: Skalierbarkeit, Wartbarkeit und Kosten. Produktionsumgebungen bestanden traditionell aus viel (teurer) Hardware, die für geschäftskritische oder hochvolumige Anwendungen reserviert war. Diese Umgebungen brauchten ständiges Management, Wartung und Patching.
Um Lastspitzen abzufangen, musste entsprechend viel Hardware fest zugewiesen werden – obwohl Nutzungsmuster oft schwanken. Das führte außerhalb der Peak-Zeiten zu viel ungenutzter Kapazität.
Die Lösung heißt Container-Orchestrierung.
Weil ein Container-Image plattformunabhängig ist, lassen sich Rechenressourcen für Container bei Bedarf über beliebige Server mit Container-Engine hoch- und runterfahren. Die Pflege des zugrunde liegenden Betriebssystems ist damit vom Anwendungsbetrieb entkoppelt.
Das wirkt sich direkt auf die Kosten aus: Orchestrieren wir Container so, dass sie die aktuelle Nachfrage dynamisch bedienen, nutzen wir die vorhandene Hardware maximal aus.
Das war ein Überblick aus großer Höhe. Gleich steigen wir tiefer ein – vorher noch ein Blick auf praxisnahe Einsatzszenarien.
Container für Data Science und Machine Learning
Anwendungen für Data Science und Machine Learning sind häufig extrem rechenintensiv
mit teils unvorhersehbaren Nutzungsmustern und riesigen Datenmengen.
Solche Anwendungen profitieren oft von Parallelisierung, um Probleme aufzuteilen und Ergebnisse anschließend in einem Datenspeicher zu persistieren. Stark vereinfacht – aber sofort wird klar: Dafür eignen sich Container und Orchestrierung perfekt!
Mit diesem Rüstzeug geht es an das „Wie“. Am Ende des Artikels schlagen wir den Bogen zu Data-Science- und ML-Workloads erneut, wenn wir über Helm sprechen – und darüber, wie sich komplexe Anwendungen als Container in einer Orchestrierungs-Engine mit minimalem Aufwand und Konfiguration betreiben lassen.
Es gibt viele Container-Engines, in diesem Artikel nutzen wir den Platzhirsch Docker. Eine Einführung findest du in unserem Tutorial Introduction to Docker.
Virtuelle Maschinen (VMs) vs. Container
Virtuelle Maschinen abstrahieren physische Hardware: Ein Hypervisor macht aus einem Server viele und erlaubt mehreren VMs, sich denselben Host zu teilen. Jede VM hat ein eigenes Gastsystem (OS).
Container abstrahieren auf der Anwendungsschicht. Ein Server mit installierter Container-Engine kann mehrere Container gleichzeitig ausführen, die sich dasselbe zugrunde liegende OS teilen. Mehr dazu in unserem Containerization-Tutorial.
Der zentrale Unterschied: Container bringen im Gegensatz zu VMs kein eigenes OS mit, sondern nutzen das Host-OS. Dadurch sind sie deutlich leichter, schneller zu replizieren, zu starten und zu zerstören – bei gleichzeitigem Nutzen von Isolation und Fehlertoleranz zwischen Containern (stürzt ein Container ab, bleiben die anderen unbeeinflusst).
Zudem verbessert das die Ressourcenausnutzung: Auf einer einzelnen Docker-Engine laufen mehr Container, als VMs auf einem Hypervisor mit vergleichbarer Hardware.
Docker-Image vs. Container
Ein Docker-Image enthält Konfiguration, Code, Abhängigkeiten und die Laufzeit. Images fungieren als Vorlage, aus der in Docker Container-Instanzen repliziert und gestartet werden. Ein Container läuft auf jeder Plattform, die Docker unterstützt.
Container-Orchestrierung
Jetzt, da wir Container kennen, brauchen wir eine Möglichkeit, sie zu verwalten. Es gibt mehrere Orchestratoren; hier konzentrieren wir uns auf Kubernetes in der AWS-Cloud mit dem Elastic Kubernetes Service (EKS).
Zu den zentralen Aufgaben von EKS gehören:
- Deployment
- Skalierung
- Load-Balancing
- Monitoring
- Service Discovery
- Self-Healing
AWS-Services
Bevor wir EKS erklären, lohnt ein Blick auf einige AWS-Services, auf denen EKS aufsetzt.
CloudWatch
Monitoring- und Observability-Service, der Logs, Metriken und Events sammelt.
VPC
Eine Virtual Private Cloud ist ein logisch isoliertes Netzwerk, das pro AWS-Account sicher verwaltet wird.
ELB
Ein Elastic Load Balancer ist eine hochverfügbare Netzwerkkomponente, die Traffic auf mehrere Ziele verteilt.
IAM
Identity and Access Management bietet fein granulierte Zugriffskontrolle für AWS-Accounts.
ECR
Das Elastic Container Registry ist eine voll verwaltete Registry für Docker-Images.
EC2
Elastic Cloud Compute (abgekürzt wegen der zwei C) ist ein Kernservice von AWS und Basis vieler weiterer. Er erlaubt die Miete virtueller Server, auf denen Kunden ihre Anwendungen ausführen.
Region
Ein physischer Standort mit geclusterten Rechenzentren, zum Beispiel EU-WEST-1 (Irland) und EU-WEST-2 (London).
AZ
Eine Availability Zone umfasst ein oder mehrere getrennte Rechenzentren mit eigener redundanter Stromversorgung, Netzwerk und Konnektivität. Eine Region besteht aus mehreren AZs.
Route53
Ein hochverfügbarer DNS-Service.
WAF
Die Web Application Firewall schützt Anwendungen vor gängigen Exploits und Bots, die Verfügbarkeit beeinträchtigen, Sicherheit kompromittieren oder Ressourcen übermäßig beanspruchen könnten.
Kubernetes-Grundlagen
Kubernetes wird häufig als K8s abgekürzt – zwischen K und S stehen acht Buchstaben.
Cluster
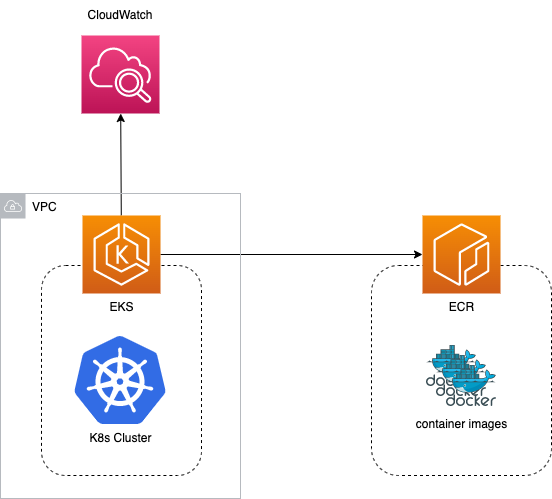
EKS stellt einen verwalteten K8s-Cluster bereit. Er ist die oberste Ebene und umfasst alle Services, Nodes und Pods.
EKS ist eng integriert mit CloudWatch, Elastic Container Repository (ECR), IAM, API Gateway, Elastic Load Balancer (ELB), CodePipeline, Secrets Manager und weiteren.
Im einfachsten Fall legen wir Container-Images in ECR ab und lassen unsere Anwendung von EKS verwalten und ausführen – bereitgestellt in einer VPC über mehrere Availability Zones hinweg, mit allen System- und Anwendungs-Logs in CloudWatch.
Master/Control Plane
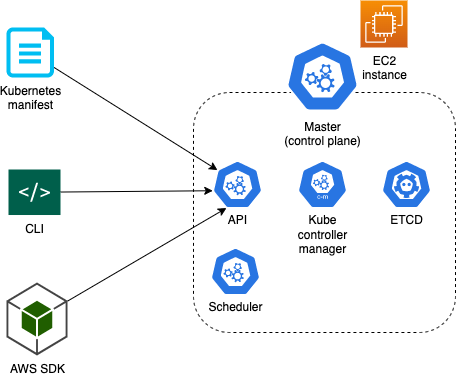
Der Masternode ist das Herz von K8s und übernimmt Management, Monitoring, Scheduling und Planung der Nodes. Er besteht aus mehreren Komponenten.
ETCD
Ein Key-Value-Store, der alle kritischen Cluster-Daten persistiert.
Kube Scheduler
Der Scheduler weist Container den Nodes zu.
Kube Controller Manager
Er stellt den Sollzustand der Cluster-Komponenten sicher und gleicht gewünschte mit tatsächlicher Last ab.
API
Alle Interaktionen von außerhalb des Clusters laufen über die K8s-API.
Nodes (Worker-Nodes)
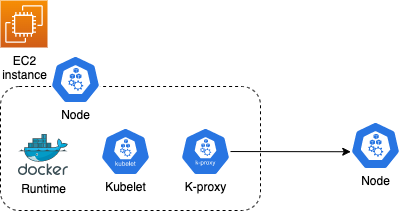
Ein EKS-Worker-Node ist eine EC2-Instanz. Jeder Node hat die Docker-Runtime für Container, den Kubelet-Agent für die Kommunikation mit dem Master und den Kube-Proxy für die Inter-Node-Kommunikation.
Damit Nodes in CloudWatch integrieren können, muss die IAM-Rolle des Nodes die Richtlinie CloudWatchLogsFullAccess enthalten.
Pod
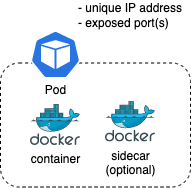
Ein Pod ist die kleinste deploybare Einheit. Er enthält einen einzelnen Anwendungscontainer sowie ggf. Sidecars. Jeder Pod ist kurzlebig und erhält eine eigene IP-Adresse.
Deployments und ReplicaSets
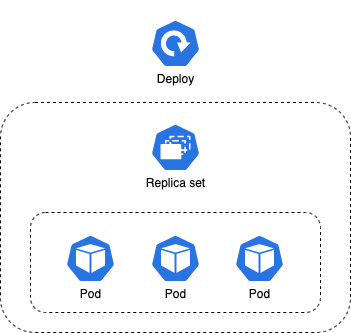
Ein ReplicaSet verwaltet eine Menge von Pods über Labels und stellt sicher, dass für eine bestimmte Last immer eine stabile Anzahl laufender Pods vorhanden ist. Fällt ein Pod aus, stellt das ReplicaSet ihn wieder her.
Deployments verwalten ReplicaSets. Fällt ein ReplicaSet aus, setzt das Deployment es wieder auf. Deployments können als Rolling, Ramped, Re-Create oder Canary konfiguriert werden (Details sprengen hier den Rahmen).
Services
Für diesen Artikel kannst du einen Service gedanklich direkt einem AWS Application Load Balancer (ALB) – einem Typ von ELB – zuordnen. Dahinter steckt mehr, aber wichtig sind die Vorteile, die ein ALB bietet:
- DNS-Namen zuordnen
- Health Checks
- Hohe Verfügbarkeit über mehrere AZs
- WAF
- Zugriffs-Logs
Die Hauptaufgabe eines Service ist die Verteilung von Traffic zwischen Nodes/Pods.
Container-Skalierung
ASG und EC2
Ein Kernelement von EC2 ist die Auto Scaling Group (ASG). Sie hält eine Flotte von EC2-Instanzen mit der gewünschten Last über mehrere AZs einer Region hinweg aufrecht, meist hinter einem Load Balancer.
CloudWatch-Metriken liefern die Trigger für Scale-in oder Scale-out.
Das ist horizontale Skalierung: Die Serverflotte fährt „horizontal“ hoch und runter, um Traffic-Bedarf zu decken. Eine Beispielrichtlinie: Alle Instanzen unter 50% CPU-Auslastung halten. In der Regel verwaltet die ASG dabei eine gleiche Anzahl Instanzen pro AZ, weitere Konfigurationen sind möglich.
HPA
Wichtig ist die Unterscheidung zwischen Skalierung auf EC2-Ebene und Pod-Ebene. Der Horizontal Pod Autoscaler skaliert Pods innerhalb eines Nodes. Die HPA nutzt K8s-Metriken über den Metrics Server (muss im Cluster installiert werden, gehört bei EKS nicht zur Standardinstallation) und skaliert Pods anhand von Node-Metriken. Beispiel: Ziel-vCPU-Auslastung 50%.
EKS Cluster Autoscaler
Für Cluster-Skalierung wird der Open-Source-Cluster-Autoscaler für EKS installiert. Er skaliert den K8s-Dienst zusammen mit einer AWS-ASG, die wiederum die physischen Instanzen für den Cluster bereitstellt.
Erreicht ein Node gemäß HPA-Policy seine Maximal-Kapazität, startet der Cluster Autoscaler eine weitere EC2-Instanz und fügt sie der ASG hinzu.
Das Gesamtbild
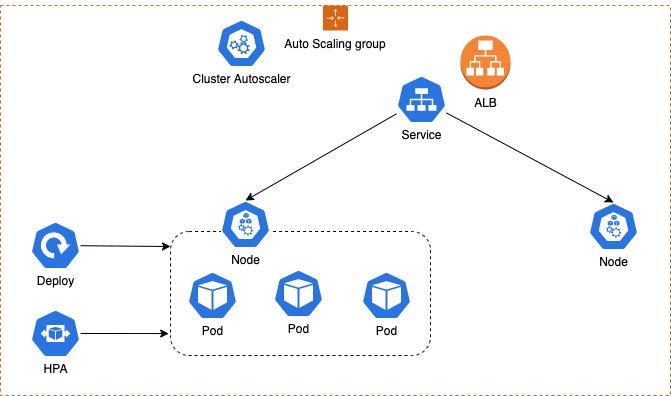
Scaling-Policies sind sehr flexibel und konfigurierbar, enthalten aber üblich eine Cooldown-Periode vor dem Herunterskalieren, um unnötige Aktionen bei sprunghaftem Traffic zu vermeiden.
Wichtig: Überschreitet ein Pod sein vCPU-Limit, drosselt Kubernetes die Anwendung in diesem Pod. Überschreitet er sein Memory-Limit, startet Kubernetes den Container neu.
Kostenoptimierung
Beispiel, um Pods innerhalb von Instanzen vom Typ m5.large zu begrenzen:
2 * vCPU = 2000m (Millicore)
8 GiB Arbeitsspeicher
Ressourcenbeschränkungen pro Pod:
- Reservierte vCPU, z. B. 500m
- vCPU-Limit, z. B. 1000m
- Reservierter Speicher, z. B. 256Mi
- Speicherlimit, z. B. 512Mi
Observability
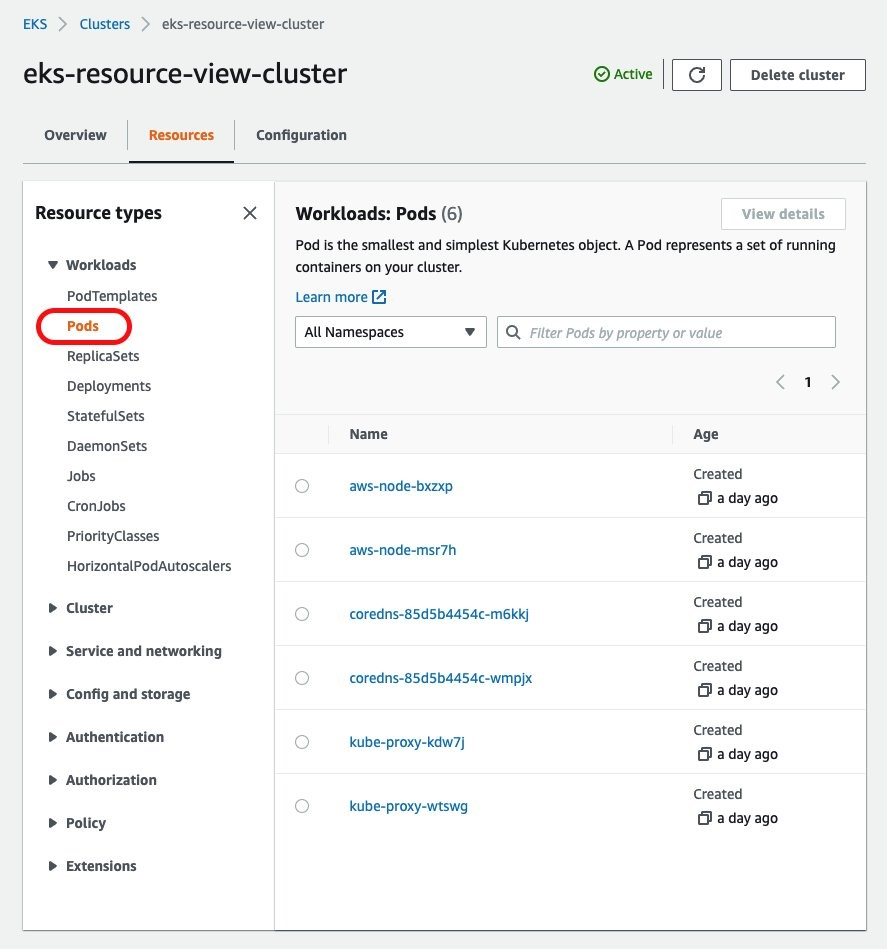
EKS Resource View
Zeigt alle Ressourcen, die im Cluster laufen.
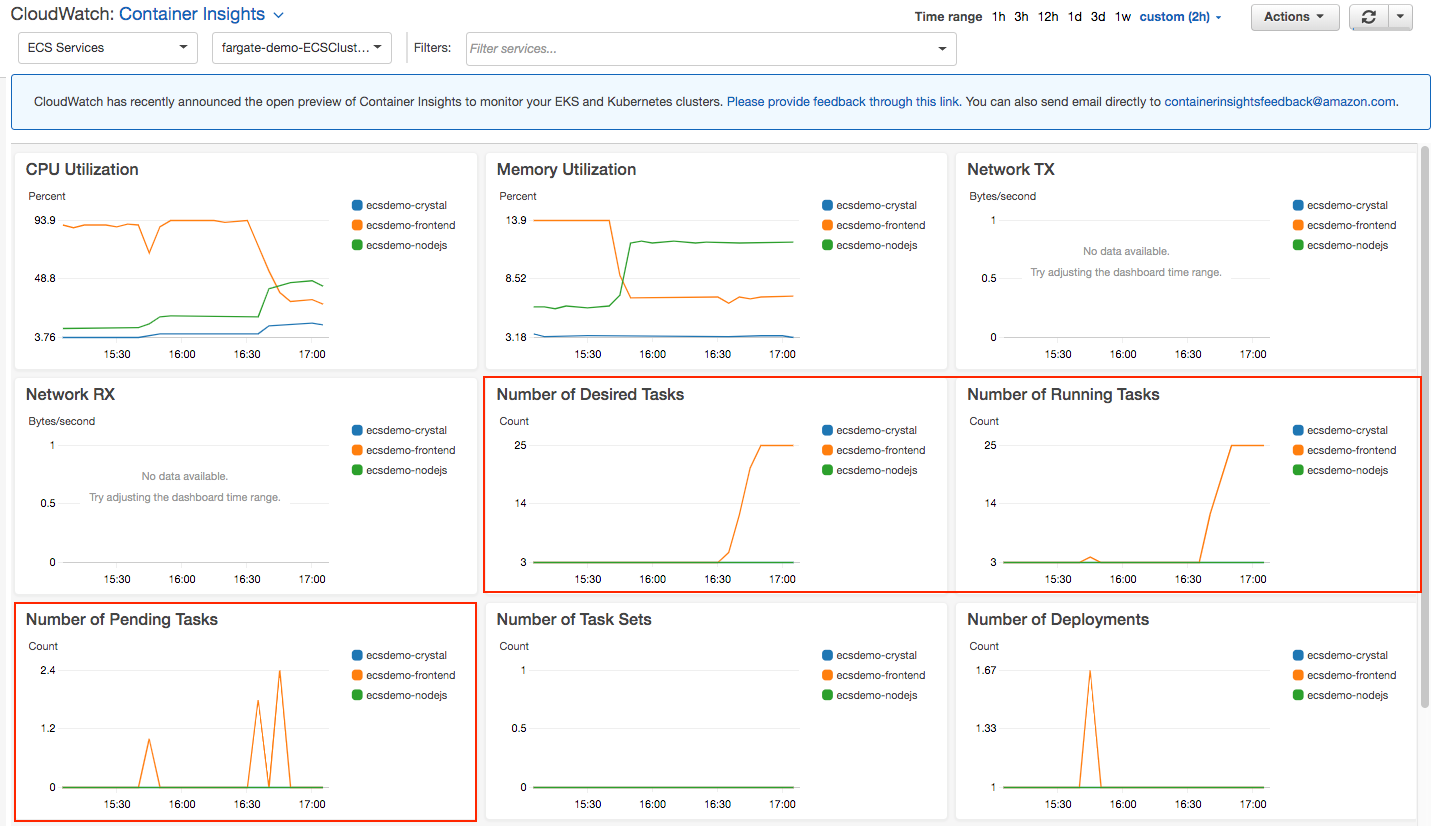
CloudWatch Container Insights
- Monitore
- Alarme
- Lambda-Funktionen auslösen
- Vorkonfigurierte Dashboards und Metriken
- Installation mit einem Klick
Helm
Helm ist ein Paketmanager für Kubernetes, der Paketierung, Konfiguration und Deployment von Anwendungen automatisiert. Helm-Charts ermöglichen es, komplexe Kubernetes-Anwendungen zu erstellen, zu teilen, zu versionieren und zu veröffentlichen.
Interessante Chart-Beispiele aus Data Science und Machine Learning:
- Ml-workspace
- Mlflow
- Tensorflow
- Hive
- Spark
Diese K8s-Anwendungen kannst du mit einem einzigen Befehl per Helm in deinem EKS-Cluster deployen!
Fazit
In diesem umfassenden Leitfaden haben wir die Grundlagen der Container-Orchestrierung mit AWS Elastic Kubernetes Service (EKS) erkundet. Von den Basics der Container und ihren Praxisanwendungen in Data Science und Machine Learning bis hin zu den Feinheiten der AWS-Services und Kubernetes-Komponenten haben wir viel abgedeckt. Container-Orchestrierung ist komplex, aber äußerst lohnend: Sie bietet Skalierbarkeit, Wartbarkeit und Kostenvorteile.
Ob Entwickler, Data Scientist oder IT-Profi – Orchestrierung zu beherrschen, ist eine wertvolle Kompetenz in deinem Werkzeugkasten. Da Unternehmen weiter in die Cloud gehen und Microservices-Architekturen einsetzen, steigt die Nachfrage nach Expertise in diesen Bereichen stetig.
Bereit für den Praxiseinsatz? DataCamp bietet Kurse, mit denen du dein Verständnis für Kubernetes, Docker und Cloud Computing vertiefst. Von Einsteiger bis Fortgeschrittene: Dich erwarten interaktive Lektionen, Aufgaben aus der Praxis und Tutorials von Expertinnen und Experten.
- Introduction to Docker
- Machine Learning, Pipelines, Deployment and MLOps Tutorial
- AWS Cloud Concepts Course
Nützliche Links
- Kubectl Cheat Sheet mit den am häufigsten genutzten Befehlen
- HPA-Tutorial erklärt die HPA und führt dich durch eine Anwendung mit verwalteter Skalierung
- Cluster-Autoscaler-Tutorial zum Einrichten und Betreiben einer einfachen Anwendung mit Cluster-Skalierung
- Helm-Charts
- AWS-Preisrechner