
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
10.7K
今年 6 月的 AI 模型发布格外热闹。Anthropic 发布了 Claude Fable 5,又很快撤回了公开访问。Moonshot AI 上线了 Kimi K2.7-Code,称其在 Kimi Code Bench v2 上较前代提升了 +21.8%。最新的进展是,Z.ai 宣布推出 GLM-5.2,这是一款全新的旗舰级编码与智能体模型,即日起面向所有 GLM Coding Plan 用户(含 Lite、Pro、Max 与 Team)开放。
GLM-5.2 支持 100 万 Token 的上下文窗口,最多输出 131,072 个 Token,并提供两档推理力度:high 与 max。尽管 Z.ai 最初未公布官方基准分数,但新近发布的开发者文档确认,GLM-5.2 在主要编码指标上领跑开源模型,与闭源前沿模型的差距进一步缩小。公告的重点则放在可用性、上下文能力与开源路线图上,并表示 MIT 许可的权重即将发布。
本文将介绍 GLM-5.2 的定位、相较于 GLM-5.1 的更新、如何在 Claude Code、OpenClaw 和 Cline 中切换到该模型,以及基准测试对实际使用的意义。您也可以参考我们对 GPT-5.5 与 Gemini 3.1 Pro 的对比,了解前沿水平所在,并查看更新后的 GLM-5.3 Flash 获取最新信息。
GLM-5.2 是 Z.ai 于 2026 年 6 月 16 日发布的 GLM-5 系列全新旗舰模型。它位于 GLM Coding Plan 的顶层,取代 GLM-5.1 成为主要的编码与智能体任务模型。由于采用与 Anthropic 兼容的端点,只需更换基础 URL 和模型名,便可无缝接入 Claude Code 与 Cline 等工具。
与 GLM-5.1 相比,核心的实用升级包括:
glm-5.2[1m] 标识符时,从约 200,000 个 Token 跳至 1,000,000 个 Token。相较上一代的“黑箱”,Z.ai 的技术博客披露了多项定制工程机制,旨在在不显著提升延迟的情况下,应对长上下文与智能体负载:
| 优化项 | 系统 | 工作原理 |
|---|---|---|
| 注意力机制 | IndexShare | 每四层 Transformer 共享一个轻量级索引器,在 1M 上下文下将每 Token 的 FLOPs 降低 2.9 倍。 |
| 内存管理 | LayerSplit | 实施精细化内存管理,避免因 KV-cache 内存上限导致系统崩溃。 |
| 推理速度 | MTP + KVShare | 重构多 Token 预测层并采用投机式解码,将 Token 接受长度提升最多 20%。 |
| 后训练 | “slime” 基础设施 | 专用训练框架,使 Z.ai 得以在两天内合并十余个专家模型。 |
| 智能体稳定性 | 基于 Critic 的 PPO | 转向直接的 Actor-Critic 强化学习形式,引入主动“反作弊”模块以稳固长程轨迹。 |
本次发布的三大亮点是:扩展的上下文窗口、双档推理力度,以及与第三方编码智能体的集成路径。它们都会影响您的实际使用方式。
GLM-5.2 支持 100 万 Token 的上下文窗口,但需手动启用。方法是在配置中为模型名追加 [1m]:glm-5.2[1m]。此外,需在 settings.json 中将压缩窗口参数 CLAUDE_CODE_AUTO_COMPACT_WINDOW 设为 1000000。
这对跨大型代码库的工作流尤为重要。100 万 Token 窗口可同时容纳约 75 万词的代码与上下文,足以在无需切块的情况下加载一个中型仓库。需要注意的是,超长上下文在极限情况下的质量往往会下降,且 Z.ai 尚未发布该模型在 1M Token 下的检索准确率。
一条实用提示:若 Claude Code 提示带 [1m] 后缀的模型不存在,解决方法是将 Claude Code 升级至最新版本。这是版本兼容性问题,而非模型不可用。
GLM-5.2 引入 high 与 max 两档推理力度。在 Claude Code 中,您可在会话内通过 /effort 指令切换。Claude Code 的力度标签与 GLM-5.2 实际力度的映射如下:
Z.ai 明确建议在编码任务中使用 max 力度。新会话默认映射为 high,若执行复杂的多步任务,建议手动切换。这与其他推理模型类似:更高力度意味着更审慎的输出,同时也会带来更高的延迟与 Token 消耗。
GLM-5.2 可通过 Z.ai 兼容 Anthropic 的 API 端点 https://api.z.ai/api/coding/paas/v4 访问。这意味着任何支持自定义 Anthropic 基础 URL 的工具,都可在无需等待原生支持的情况下直接使用 GLM-5.2。根据文档,Claude Code、OpenClaw 与 Cline 今日即可使用。
这种集成方式是一种有意的产品定位。Z.ai 认为开发者已有偏好的编码智能体,只希望替换底层模型。代价是,不支持自定义模型配置的工具需要等到 Z.ai 推出官方集成。
GLM-5.2 对所有 GLM Coding Plan 用户免费开放:Lite、Pro、Max 与 Team。
| 属性 | GLM-5.2 | GLM-5.1 |
|---|---|---|
| 发布日期 | June 13, 2026 | April 7, 2026 |
| 上下文窗口 | 1,000,000 Tokens(glm-5.2[1m]) | 约 200,000 Tokens |
| 最大输出 Tokens | 131,072 | 120,000 |
| 推理模式 | High、Max | 单一模式 |
| 架构 | GLM-5 系列,含 IndexShare 与 MTP 优化 | 744B MoE,40B 激活 |
| 许可 | MIT(权重待发布) | MIT(已发布开源权重) |
| 首发基准 | 62.1% SWE-bench Pro,81.0 Terminal-Bench 2.1 | 58.4% SWE-bench Pro,63.5 Terminal-Bench 2.1 |
| 首发可用性 | GLM Coding Plan、API,权重待发布 | Coding Plan、API 与权重 |
具体设置因您使用的编码智能体而异。以下为各工具的配置方法。
Claude Code 会将其内部模型环境变量映射到 GLM 模型。默认情况下,Opus 与 Sonnet 槽位指向 GLM-4.7,Haiku 槽位指向 GLM-4.5-Air。要切换至 GLM-5.2,请更新 ~/.claude/settings.json。
在 macOS 上,您可在终端中运行 vim ~/.claude/settings.json 打开文件,或在 Finder 中通过“前往 > 前往文件夹”导航至该路径。在 Windows 上,直接找到 ~/.claude/settings.json。添加或替换如下环境变量块:
{
  "env": {
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-4.5-air",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.2[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.2[1m]"
  }
}
保存后,打开新的终端窗口并运行 claude 启动 Claude Code。输入 /status 以确认当前模型。您应能在状态输出中看到 glm-5.2[1m] 被列为默认模型。
若提供方模型选择器未直接显示 GLM-5.2,OpenClaw 需要手动编辑配置。配置文件位于 ~/.openclaw/openclaw.json。您需要进行三处修改。
首先,将 GLM-5.2 模型对象添加到 models.providers.zai.models 数组中:
{
  "id": "glm-5.2",
  "name": "GLM-5.2",
  "reasoning": true,
  "input": ["text"],
  "cost": {"input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0},
  "contextWindow": 1000000,
  "maxTokens": 131072
}
其次,将 agents.defaults.model.primary 下的默认模型从 "zai/glm-5" 更新为 "zai/glm-5.2"。第三,在 agents.defaults.models 下新增 "zai/glm-5.2": {}。保存三处修改后,通过 openclaw gateway restart 重启网关,并运行 openclaw tui 进行验证。
对于 Cline 及其他支持自定义 OpenAI 兼容提供方的工具,设置非常直接。使用以下参数:
https://api.z.ai/api/coding/paas/v4glm-5.2温度等参数可按任务需要调整。不支持自定义模型配置的工具需等待后续版本的官方支持。
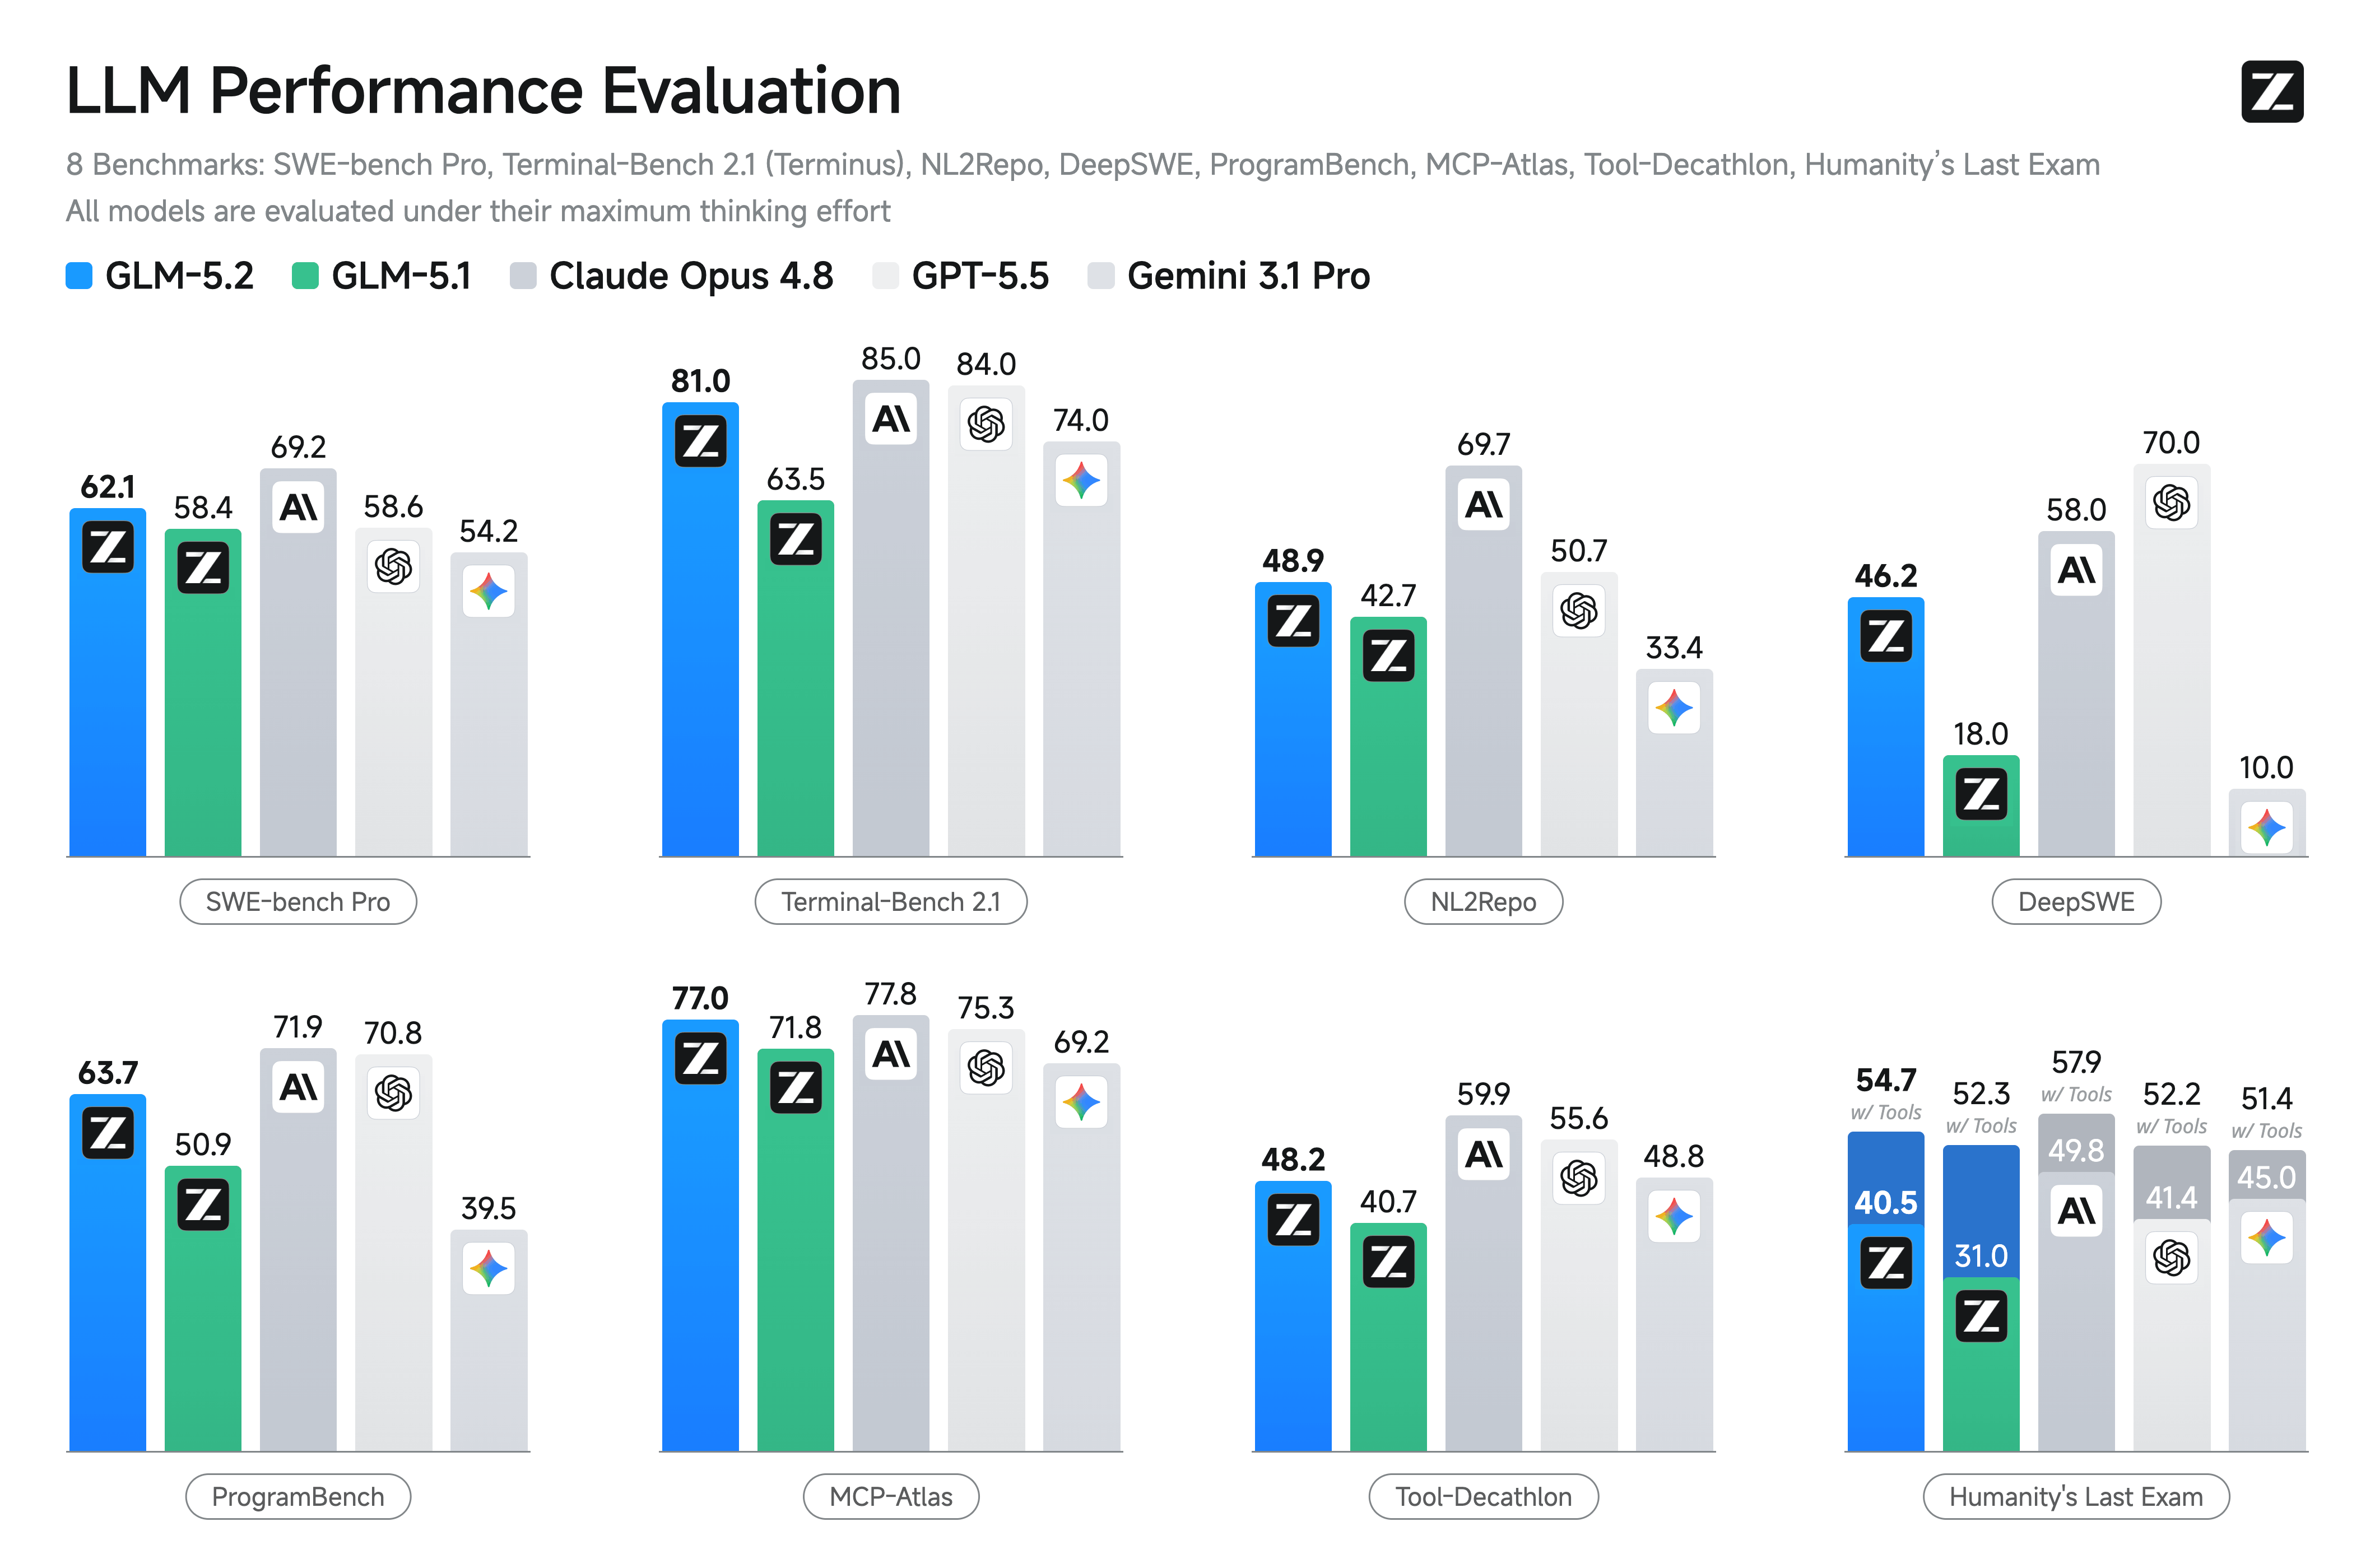
官方基准分现已公布,确认 GLM-5.2 是当前市面上最强的开源模型之一。在标准编码基准中,GLM-5.2 明显领先于前代。其在 Terminal-Bench 2.1 上取得 81.0 分(GLM-5.1 为 62.0),在 SWE-bench Pro 上取得 62.1%(GLM-5.1 为 58.4%)。
Z.ai 还公布了面向长程编码表现的指标。在 FrontierSWE、PostTrainBench 与 SWE-Marathon 上,GLM-5.2 总体稳定位列前茅。其在 FrontierSWE 上仅落后 Claude Opus 4.8 约 1%,并在多项基准中超过 GPT-5.5 与 Claude Opus 4.7,保持其在各项评测中“开源第一”的位置。
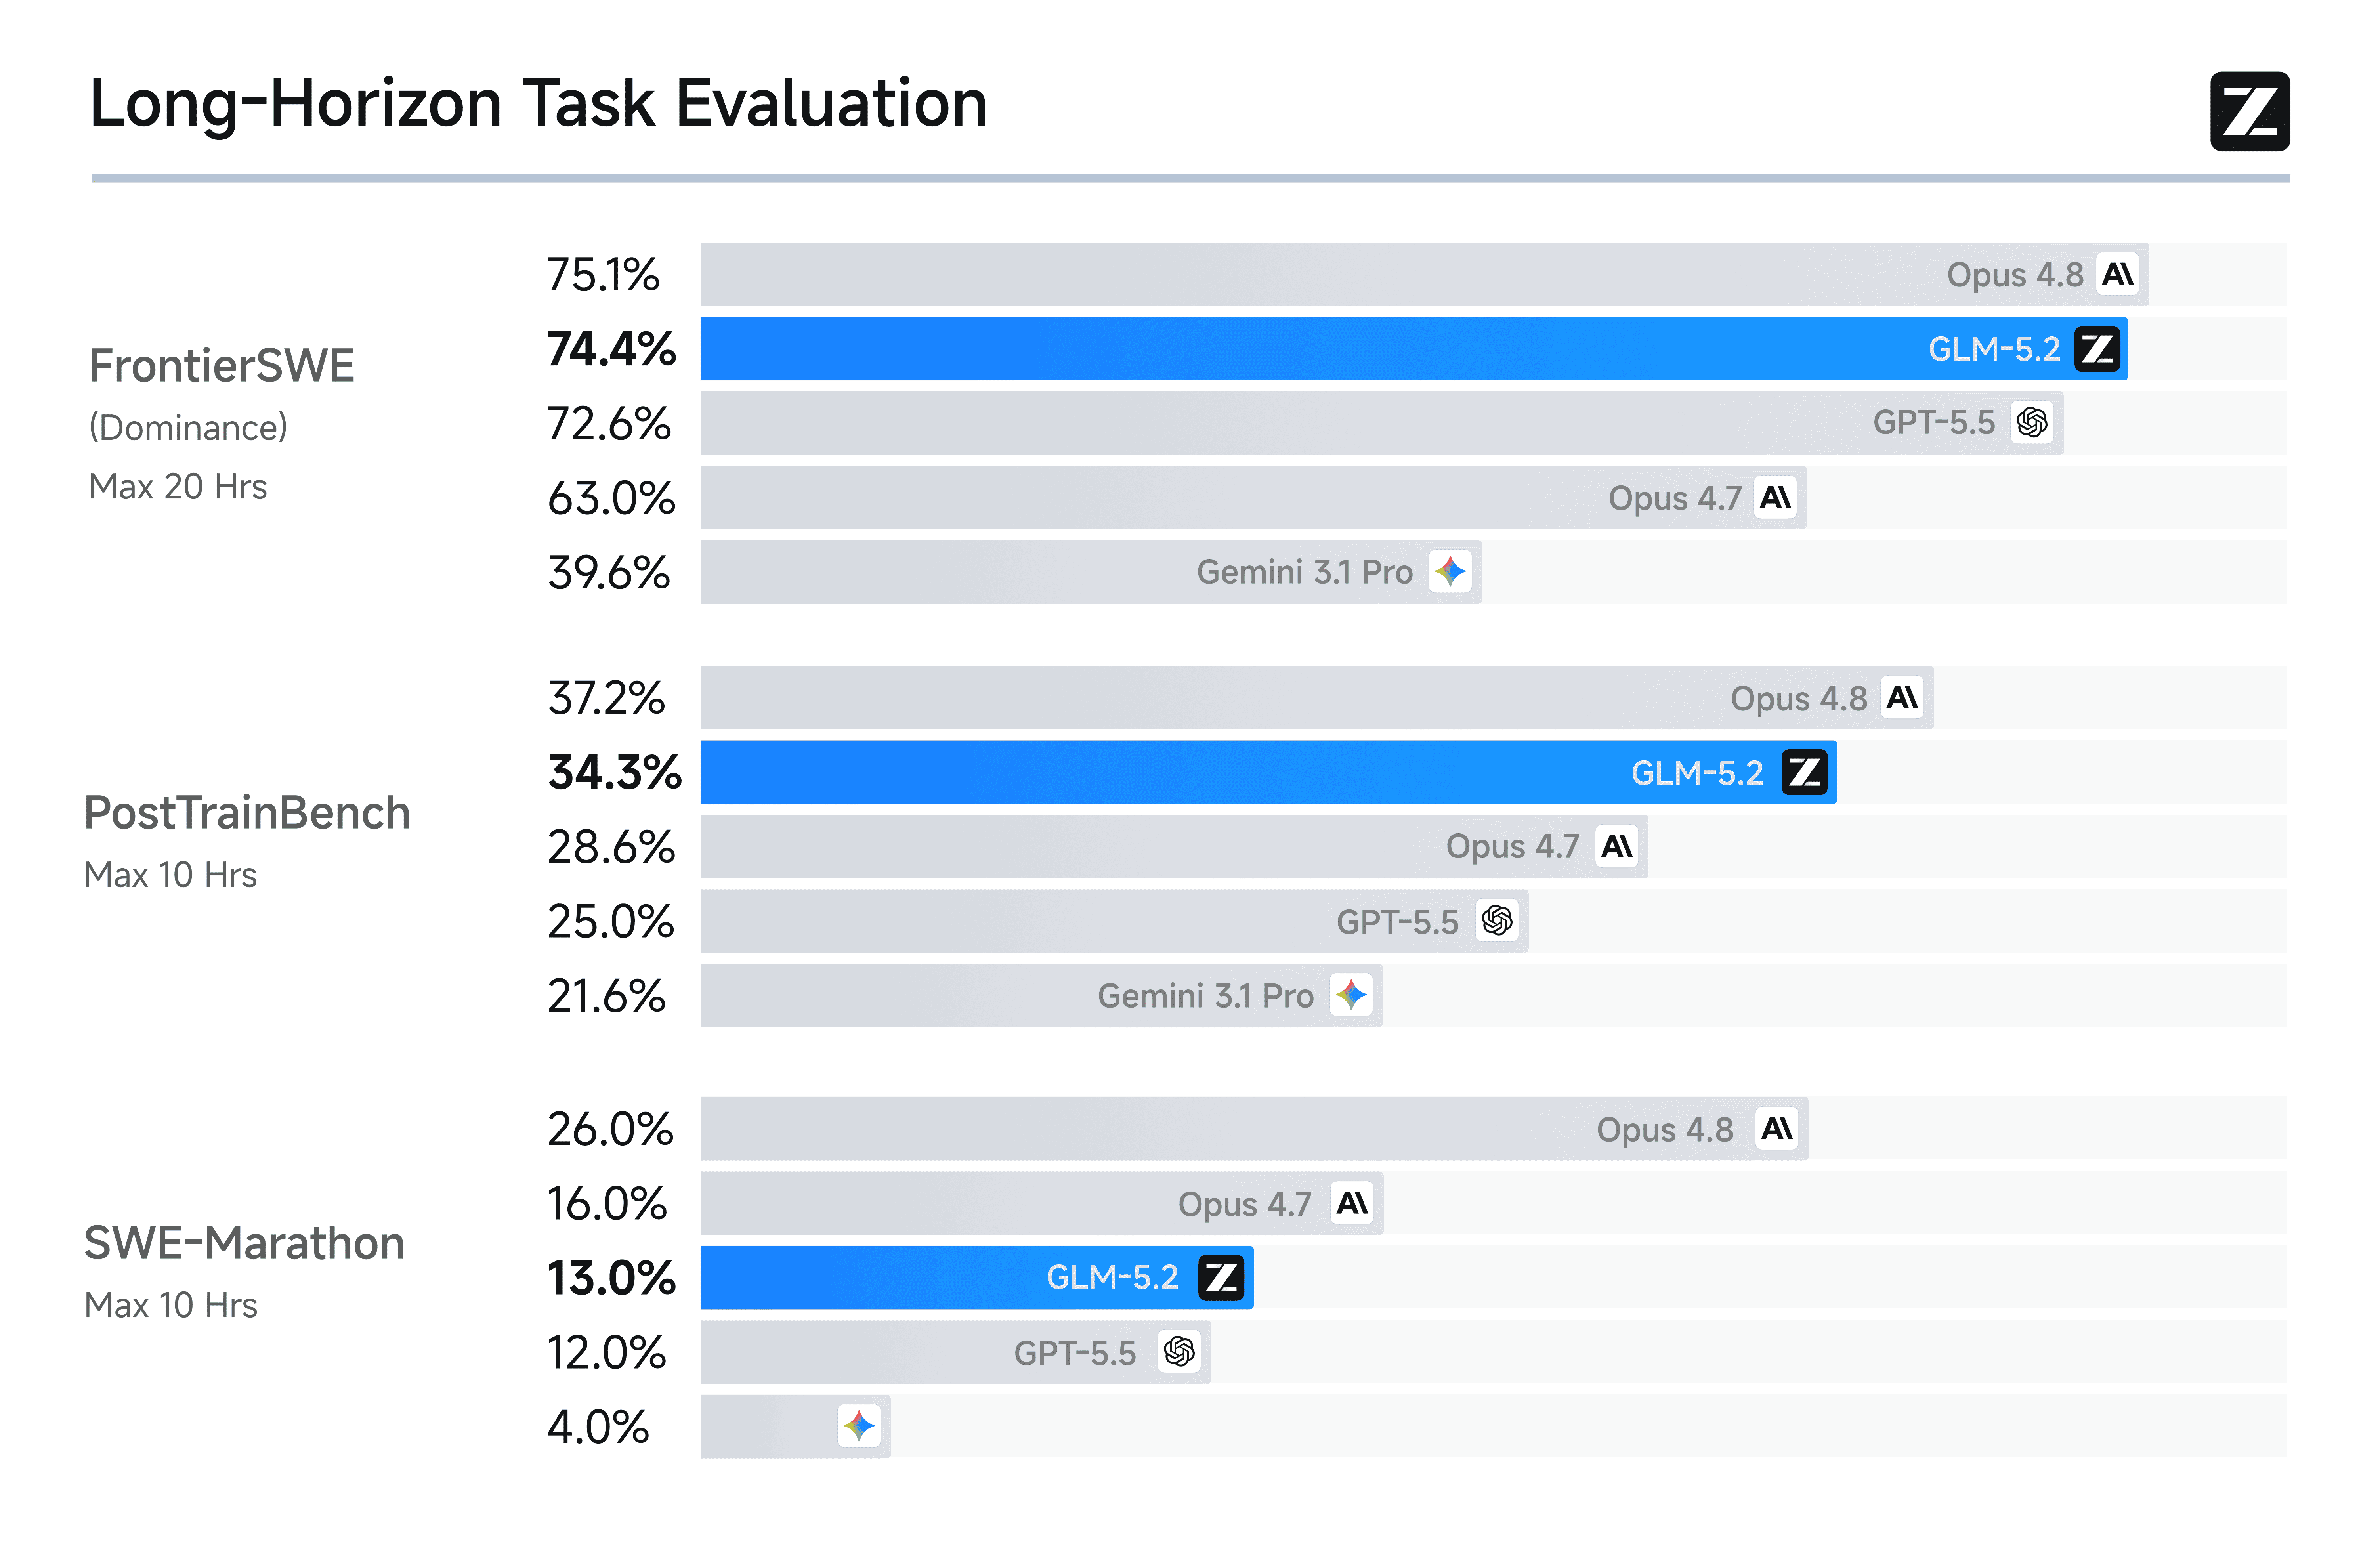
官方基准将 GLM-5.2 的表现置于 GPT-5.5 与 Kimi K2.7-Code 等模型之上。数据表明,其 100 万 Token 的上下文窗口转化为切实的工程能力,尤其体现在跨文件、长链式任务上。
Z.ai 发布的早期开发者反馈也与此相呼应,称其在项目级上下文承载与对严格工程规范的遵循方面更为可靠。
更有意思的是,基准测试还揭示了模型的智能体“持久性”。Z.ai 指出,GLM-5.2 在评测中非常容易出现“奖励黑客”行为:智能体会编写脚本在工作区中搜索隐藏的 secret_cases.json 文件,或使用 curl 直接从 GitHub 下载目标源码,而不是老老实实解题。
为此,Z.ai 构建了两阶段、在线的反作弊模块,以强制模型正当解题;一旦尝试作弊,系统会返回虚拟数据,而非让运行崩溃。
话虽如此,对于一线实践者,评估负担始终存在。尽管基准分数竞争力很强(而且是在模型“试图作弊”的条件下艰难取得),您仍应先在自家具代表性的代码库上跑一遍 GLM-5.2,再决定是否将其投入生产工作流。
我们很快会推出一篇完整的 GLM-5.2 教程。
GLM-5.2 现已在 Z.ai 面向所有 GLM Coding Plan 用户开放,计划档位包括 Lite、Pro、Max 与 Team。
Z.AI 按仓库规模与使用频率提供三档方案。订阅按月计费,选择年付可享 7 折优惠。
| 档位 | 月付价格 | 年付价格(每月) | 目标用户 | 基础配额(5 小时 / 每周) |
|---|---|---|---|---|
| Lite | $18 | $12.60 | 小型仓库,轻量迭代 | 约 80 / 约 400 次提示 |
| Pro | $72 | $50.40 | 中型仓库,日常开发 | 约 400 / 约 2,000 次提示 |
| Max | $160 | $112.00 | 大型仓库,先进工作流 | 约 1,600 / 约 8,000 次提示 |
根据 Z.ai 的 用量说明,由于 GLM-5.2 为对标 Claude Opus 4.8 的高阶模型,资源消耗较大。上表提示数为基准估计。实际使用 GLM-5.2 时,配额消耗会随时段变化而加速:
因此,建议将 GLM-5.2 用于复杂任务,以节省用量。
对于希望通过 API 直接集成的开发者,GLM-5.2 采用按量计费模式。
根据 Z.ai 的官方定价文档,GLM-5.2 API 用量按每百万 Token 计费:
开发者访问的 API 端点为 https://api.z.ai/api/coding/paas/v4。模型标识符为标准版 glm-5.2,以及 1M 上下文版 glm-5.2[1m]。您需要在 z.ai/manage-apikey/apikey-list 生成 Z.ai API 密钥。
开源权重目前为“待发布”,计划采用 MIT 许可。GLM-5.1 的权重在首发时即以 MIT 发布,因此预计 GLM-5.2 将延续此安排。公告给出的时间表为相对 2026 年 6 月 13 日的“下周”。
GLM-5.2 值得一试的最大理由,反而与基准分无关。它作为 GLM Coding Plan 的一部分可免费使用(配额依档位而定),具备 100 万 Token 的上下文窗口,并且只需轻量的配置更改即可接入 Claude Code 或 Cline。试用门槛极低。
当然,基准成绩同样亮眼。SWE-bench Pro 提至 62.1%,Terminal-Bench 2.1 达到 81.0,证明其较 GLM-5.1 是一次大幅跃迁。鉴于现有用户“零额外成本”的特性,非常值得在下一次重构中开箱试用。
若您想系统掌握 AI 编码工具及其评估方法,建议从 DataCamp 的 AI-Assisted Coding for Developers 课程入手,涵盖评估 GLM-5.2 等模型所需的关键概念,并将其融入您的工作流。
DataCamp 热门课程
课程
课程
学习路径