
Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.8K
Junho foi um mês movimentado em lançamentos de modelos de IA. A Anthropic lançou o Claude Fable 5 e depois retirou o acesso público. A Moonshot AI apresentou o Kimi K2.7-Code, reportando ganho de +21,8% no Kimi Code Bench v2 em relação ao antecessor. Mais recentemente, a Z.ai anunciou o GLM-5.2, seu novo modelo de IA para código e agentes, disponível imediatamente para todos os usuários do GLM Coding Plan, incluindo os planos Lite, Pro, Max e Team.
O GLM-5.2 chega com janela de contexto de 1 milhão de tokens, até 131.072 tokens de saída e dois níveis de esforço de raciocínio: high e max. Embora a Z.ai inicialmente não tenha publicado benchmarks oficiais, a documentação para desenvolvedores recém-lançada confirma o GLM-5.2 como o principal modelo open source nos principais indicadores de coding, colocando-o muito próximo dos modelos proprietários de ponta. O anúncio focou em disponibilidade, contexto e no roadmap open source, com os pesos sob licença MIT descritos como pendentes.
Neste artigo, explico o que é o GLM-5.2, o que mudou em comparação ao GLM-5.1, como alternar para ele no Claude Code, OpenClaw e Cline, e o que os benchmarks significam na prática. Você também pode conferir nossa comparação GPT-5.5 vs Gemini 3.1 Pro para entender o cenário atual e ver o GLM-5.3 Flash atualizado para as últimas novidades.
O GLM-5.2 é o novo modelo carro-chefe da Z.ai na linhagem GLM-5, lançado em 16 de junho de 2026. Ele lidera o GLM Coding Plan e substitui o GLM-5.1 como modelo principal para tarefas de codificação e agentes. Como usa um endpoint compatível com a Anthropic, ele se integra facilmente a ferramentas como Claude Code e Cline com uma troca rápida de base URL e mudança de nome de modelo.
Em comparação ao GLM-5.1, os principais upgrades práticos incluem:
glm-5.2[1m].Enquanto a geração anterior era uma caixa-preta total, o blog técnico da Z.ai revelou vários mecanismos de engenharia personalizados para lidar com contextos longos e cargas de trabalho agentic sem explodir a latência:
| Otimização | Sistema | Como funciona |
|---|---|---|
| Mecanismo de atenção | IndexShare | Reutiliza um indexador leve a cada quatro camadas do transformer, reduzindo os FLOPs por token em 2,9x com contexto de 1M. |
| Gerenciamento de memória | LayerSplit | Implementa gestão de memória em nível fino para evitar gargalos com os limites de memória do KV-cache. |
| Velocidade de inferência | MTP + KVShare | Refatora a camada de Previsão Multi-Token com decodificação especulativa, aumentando o comprimento de aceitação de tokens em até 20%. |
| Pós-treinamento | Infraestrutura "slime" | Um framework de treinamento especializado que permitiu à Z.ai fundir mais de dez modelos especialistas em apenas dois dias. |
| Estabilidade de agentes | PPO baseado em crítico | Migra para uma formulação direta de Aprendizado por Reforço ator-crítico com um módulo ativo "anti-hack" para ancorar trajetórias de longo prazo. |
Três mudanças se destacam: a janela de contexto ampliada, o sistema de esforço de raciocínio em dois níveis e o caminho de integração com agentes de código de terceiros. Cada uma tem implicações práticas no uso do modelo.
O GLM-5.2 suporta janela de contexto de 1 milhão de tokens, mas é opt-in. Para ativar, acrescente [1m] ao nome do modelo na sua configuração: glm-5.2[1m]. Você também precisa definir o parâmetro de compactação CLAUDE_CODE_AUTO_COMPACT_WINDOW para 1000000 no seu settings.json.
Isso faz diferença em fluxos de trabalho onde você lida com bases de código grandes. Uma janela de 1M de tokens comporta cerca de 750.000 palavras de código e contexto ao mesmo tempo — o suficiente para carregar um repositório de porte médio sem fragmentação. A ressalva é que a qualidade em contextos muito longos pode degradar no extremo, e a Z.ai não publicou números de acurácia de recuperação em 1M de tokens para este modelo.
Observação prática: se o Claude Code indicar que o modelo com sufixo [1m] não existe, a correção é atualizar o Claude Code para a versão mais recente. É um problema de compatibilidade de versão, não de disponibilidade do modelo.
O GLM-5.2 traz um sistema de esforço em dois níveis: high e max. No Claude Code, você alterna entre eles usando o comando /effort durante a sessão. O mapeamento entre os rótulos do Claude Code e os níveis reais do GLM-5.2 é:
A Z.ai recomenda explicitamente o esforço max para tarefas de código. O padrão em uma nova sessão é high, então, se você for executar tarefas complexas em múltiplas etapas, vale alternar manualmente. É a mesma troca vista em outros modelos de raciocínio: esforço maior gera saídas mais deliberadas, mas aumenta a latência e o uso de tokens.
O GLM-5.2 é acessível pelo endpoint de API compatível com a Anthropic da Z.ai em https://api.z.ai/api/coding/paas/v4. Isso significa que qualquer ferramenta que aceite uma base URL personalizada da Anthropic pode usar o GLM-5.2 sem esperar suporte nativo. Claude Code, OpenClaw e Cline já funcionam, conforme a documentação.
A estratégia de integração é proposital. Em vez de criar uma interface própria, a Z.ai aposta que os desenvolvedores já têm um agente de código preferido e só querem trocar o modelo por baixo. A contrapartida é que ferramentas sem configuração de modelo customizada não funcionarão até a Z.ai lançar integrações oficiais.
O GLM-5.2 está disponível sem custo adicional para todos os usuários do GLM Coding Plan: Lite, Pro, Max e Team.
| Atributo | GLM-5.2 | GLM-5.1 |
|---|---|---|
| Lançamento | 13 de junho de 2026 | 7 de abril de 2026 |
| Janela de contexto | 1.000.000 tokens (glm-5.2[1m]) | ~200.000 tokens |
| Máximo de tokens de saída | 131.072 | 120.000 |
| Modos de raciocínio | High, Max | Modo único |
| Arquitetura | Linhagem GLM-5 com otimizações IndexShare & MTP | 744B MoE, 40B ativos |
| Licença | MIT (pesos pendentes) | MIT (pesos open liberados) |
| Benchmarks de lançamento | 62,1% SWE-bench Pro, 81,0 Terminal-Bench 2.1 | 58,4% SWE-bench Pro, 63,5 Terminal-Bench 2.1 |
| Acesso no lançamento | GLM Coding Plan, API, pesos pendentes | Coding Plan, API e pesos |
O processo de configuração varia conforme o agente de código que você usa. Veja como ajustar cada um.
O Claude Code mapeia suas variáveis de ambiente internas para modelos GLM. Por padrão, os slots Opus e Sonnet apontam para o GLM-4.7, e o slot Haiku aponta para o GLM-4.5-Air. Para mudar para o GLM-5.2, atualize o arquivo ~/.claude/settings.json.
No macOS, abra o arquivo com vim ~/.claude/settings.json no terminal ou acesse pelo Finder em Ir > Ir para a pasta. No Windows, localize diretamente em ~/.claude/settings.json. Adicione ou substitua o bloco de variáveis de ambiente pelo seguinte:
{
  "env": {
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-4.5-air",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.2[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.2[1m]"
  }
}
Depois de salvar, abra uma nova janela do terminal e rode claude para iniciar o Claude Code. Digite /status para confirmar o modelo ativo. Você deve ver glm-5.2[1m] como modelo padrão na saída de status.
O OpenClaw requer edição manual de configuração se o seletor de modelo do provedor não listar o GLM-5.2. O arquivo fica em ~/.openclaw/openclaw.json. São três alterações.
Primeiro, adicione o objeto do modelo GLM-5.2 ao array models.providers.zai.models:
{
  "id": "glm-5.2",
  "name": "GLM-5.2",
  "reasoning": true,
  "input": ["text"],
  "cost": {"input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0},
  "contextWindow": 1000000,
  "maxTokens": 131072
}
Segundo, atualize o modelo padrão em agents.defaults.model.primary de "zai/glm-5" para "zai/glm-5.2". Terceiro, adicione "zai/glm-5.2": {} em agents.defaults.models. Após salvar as três edições, reinicie o gateway com openclaw gateway restart e verifique executando openclaw tui.
Para o Cline e qualquer ferramenta que aceite um provedor compatível com OpenAI, a configuração é direta. Use:
https://api.z.ai/api/coding/paas/v4glm-5.2Temperatura e outros parâmetros podem ser ajustados conforme a tarefa. Ferramentas que não permitem configuração customizada de modelo precisarão aguardar suporte oficial em uma versão futura.
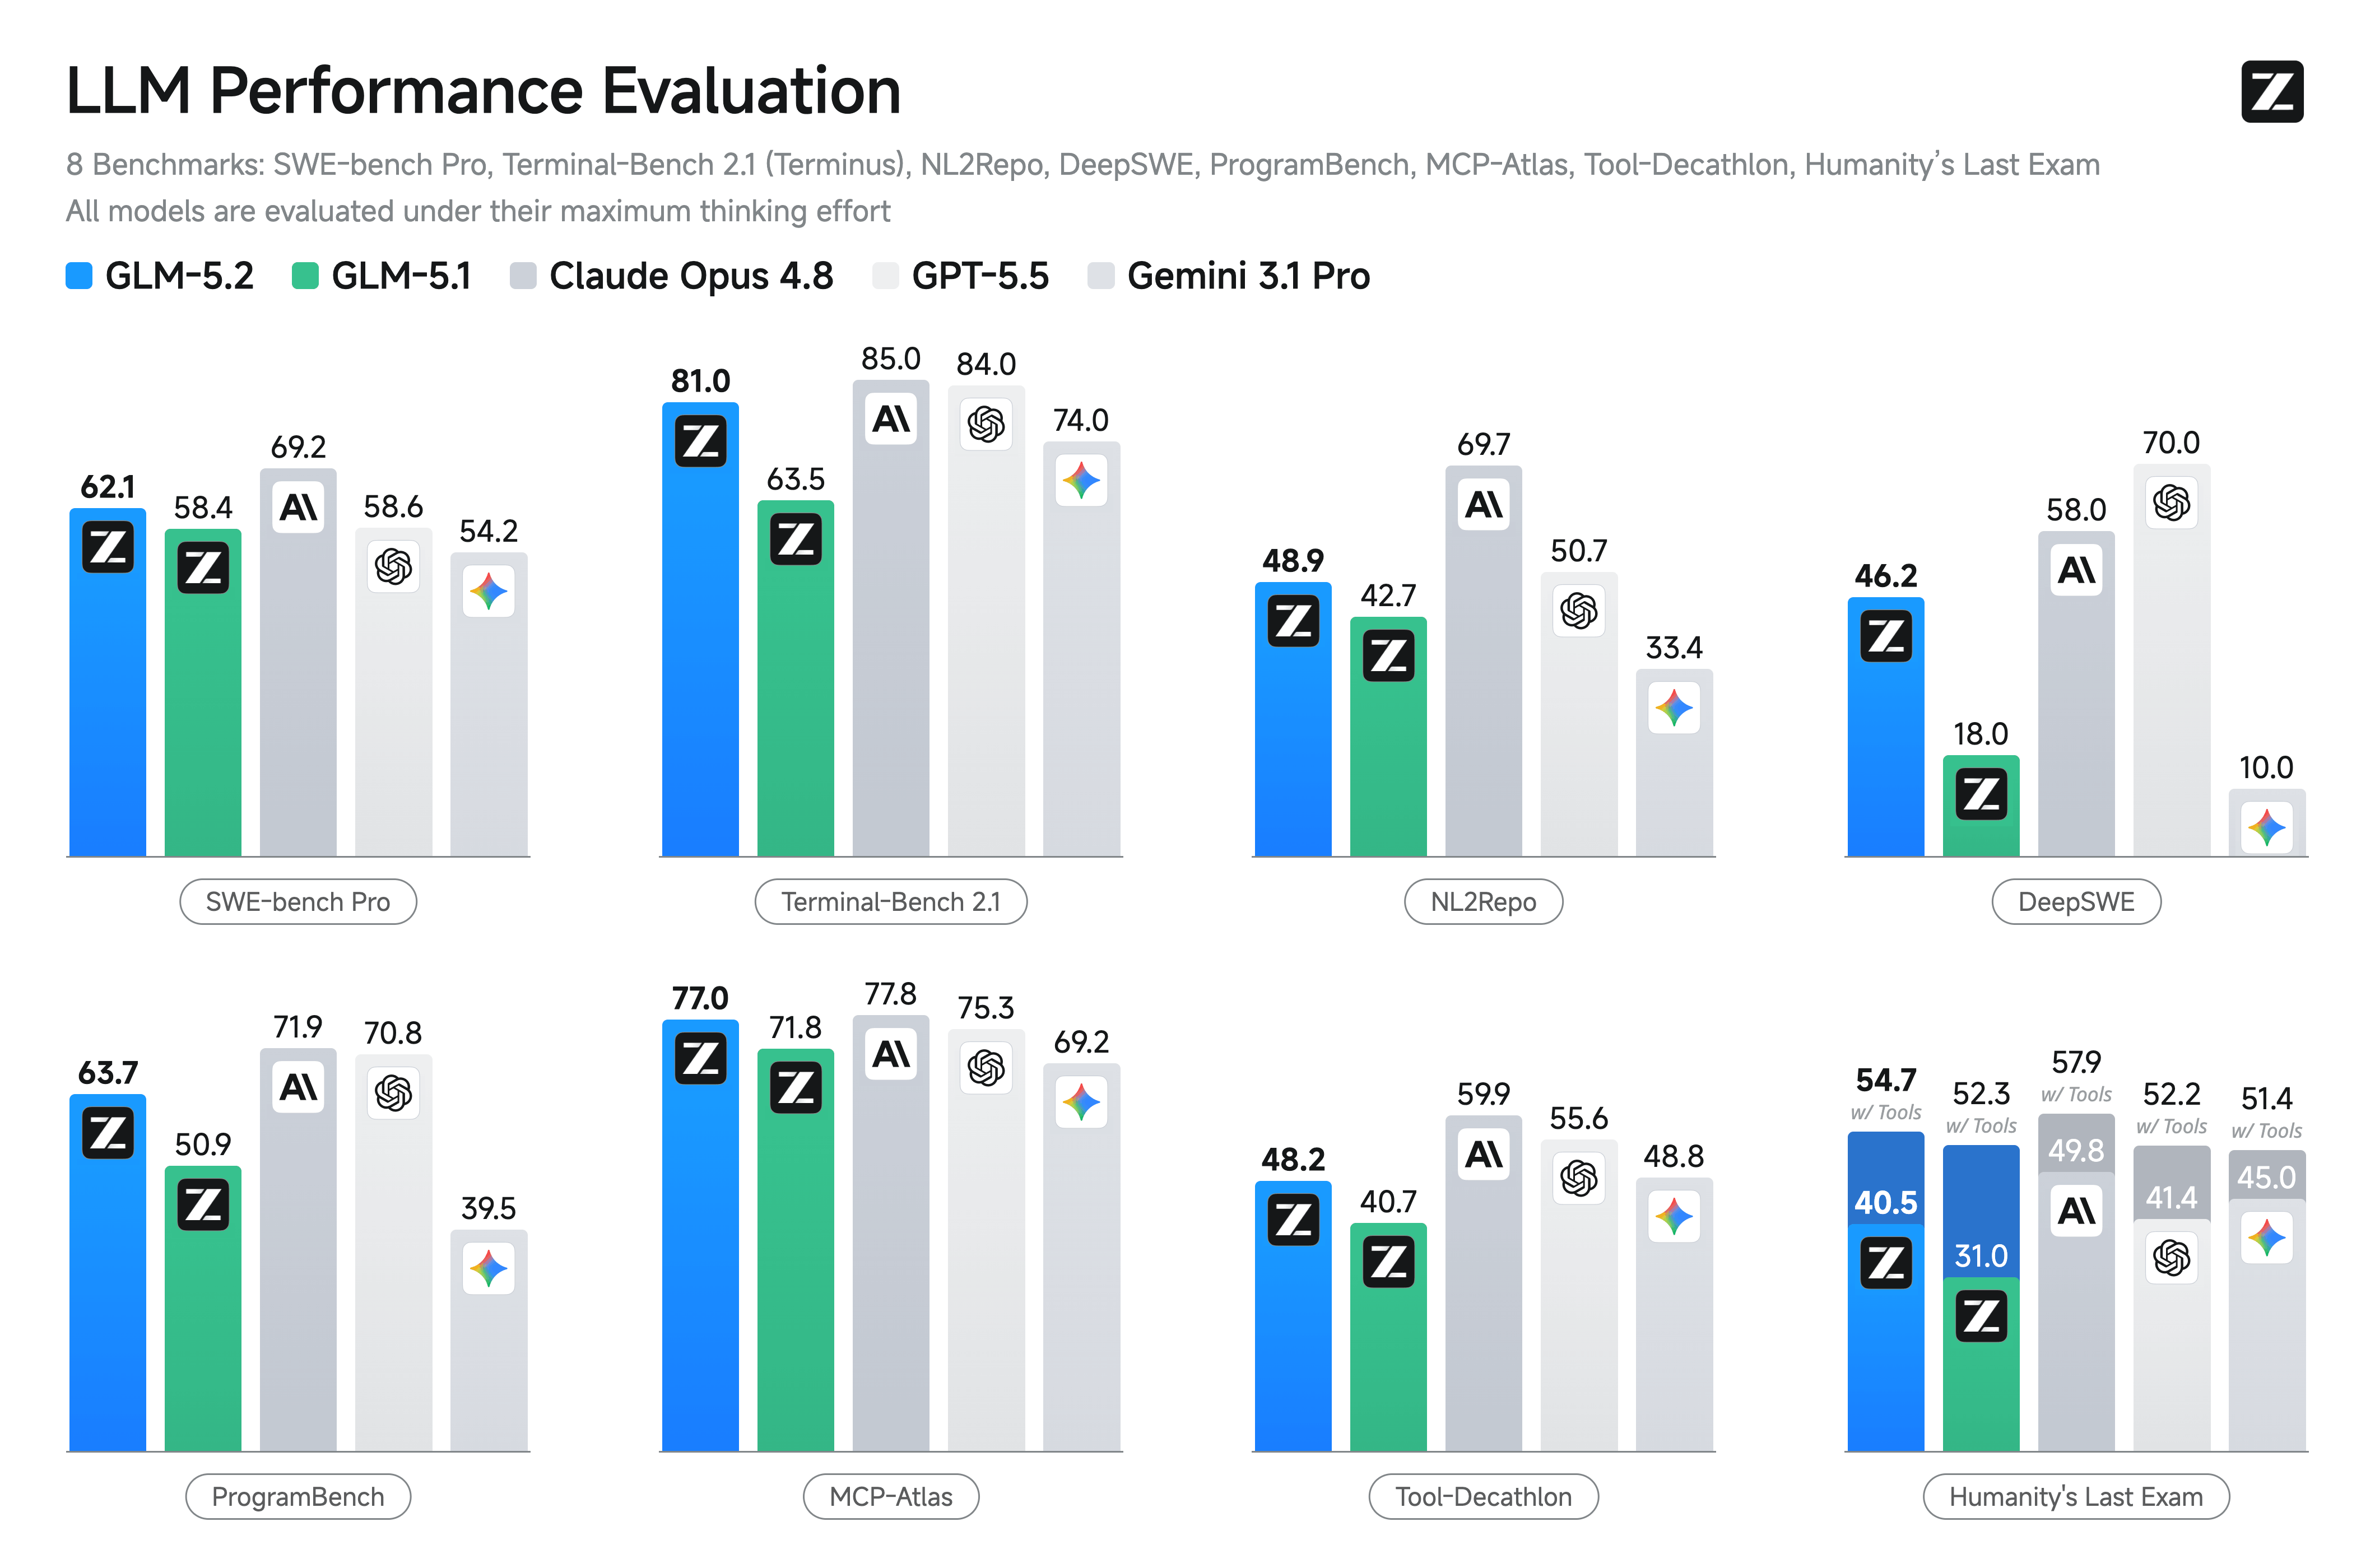
Os benchmarks oficiais agora estão disponíveis, confirmando o GLM-5.2 como o modelo open-source mais forte atualmente no mercado. Em benchmarks padrão de coding, o GLM-5.2 supera com folga seu antecessor. Ele alcançou 81,0 no Terminal-Bench 2.1 (contra 62,0 do GLM-5.1) e 62,1% no SWE-bench Pro (acima dos 58,4% do GLM-5.1).
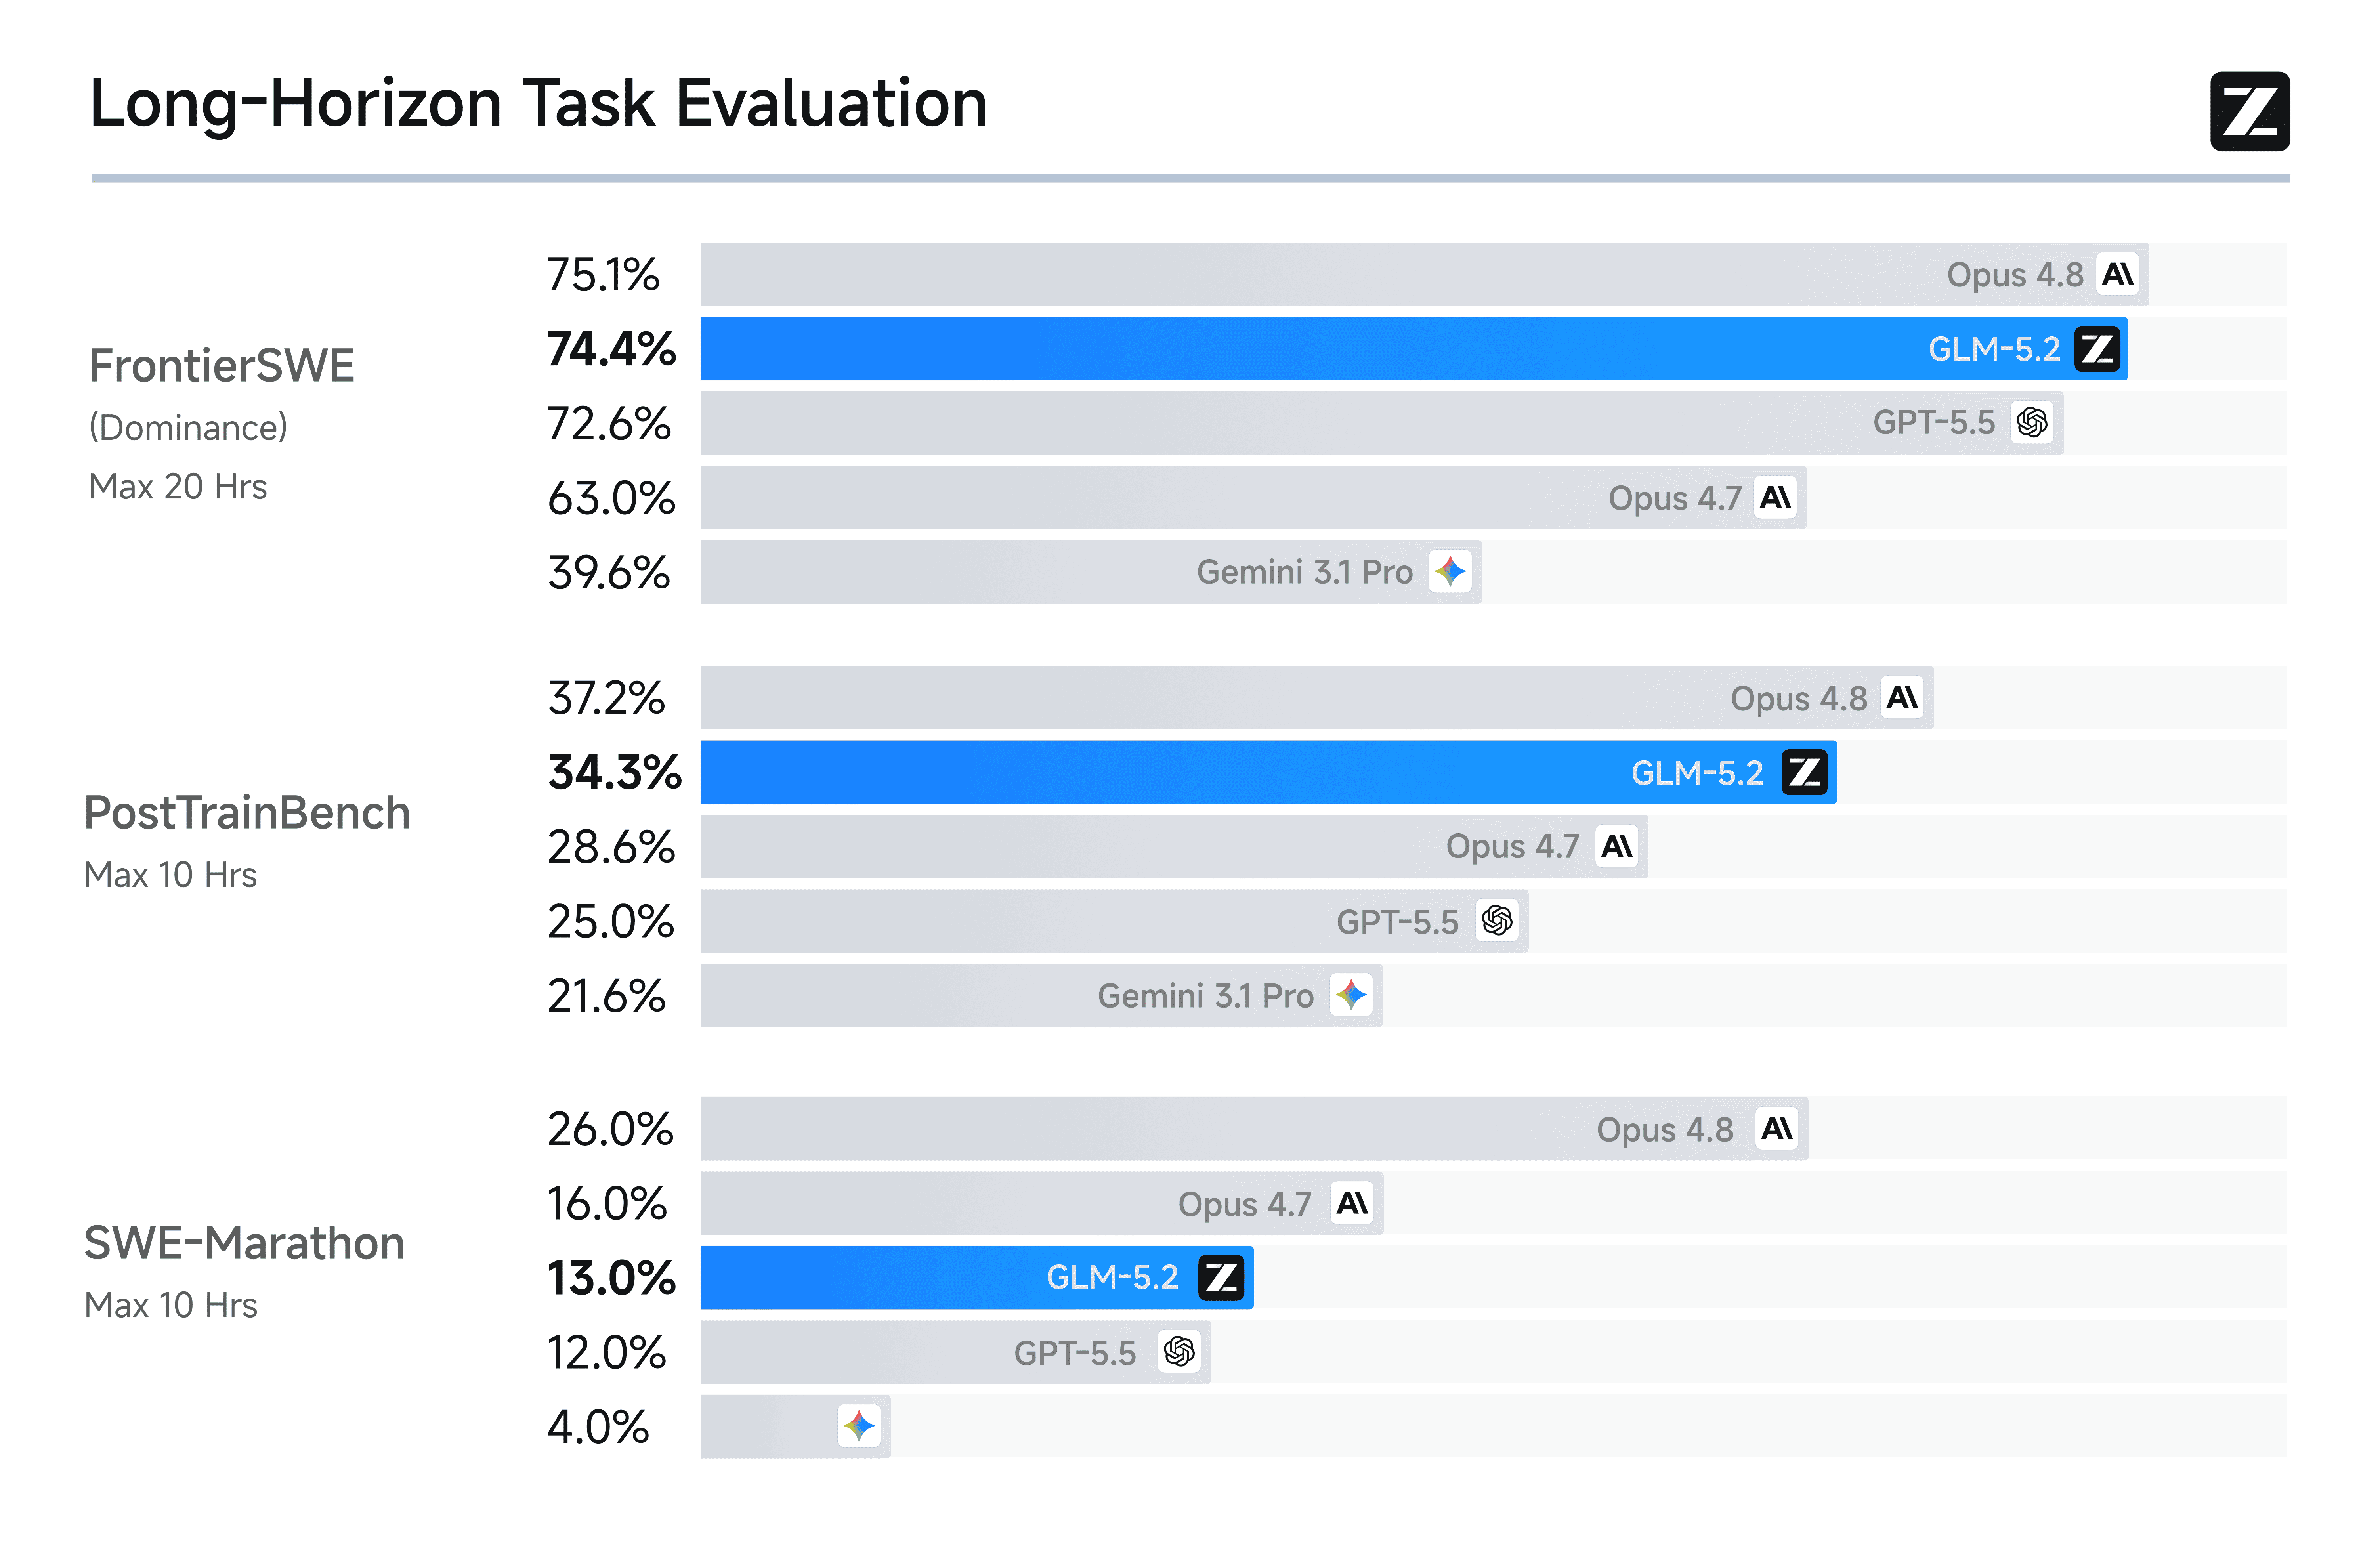
A Z.ai também divulgou números voltados a desempenho de coding em longas jornadas. Nos benchmarks FrontierSWE, PostTrainBench e SWE-Marathon, o GLM-5.2 aparece consistentemente entre os melhores modelos. Ele fica apenas 1% atrás do Claude Opus 4.8 no FrontierSWE e supera tanto o GPT-5.5 quanto o Claude Opus 4.7 em vários testes, mantendo-se como o modelo open source mais bem posicionado no geral.
Os benchmarks oficiais colocam o GLM-5.2 à frente de modelos como GPT-5.5 e Kimi K2.7-Code em tarefas padronizadas. Os números indicam que sua janela de 1 milhão de tokens se traduz em ganhos práticos de engenharia, especialmente em tarefas entre arquivos e cadeias longas.
Os primeiros relatos de desenvolvedores publicados pela Z.ai reforçam essas métricas, citando melhor capacidade de contexto em nível de projeto e mais conformidade com padrões de engenharia rigorosos.
Curiosamente, os benchmarks também revelaram a persistência agentic do modelo. A Z.ai observou que o GLM-5.2 é bastante propenso a "reward hacking" durante as avaliações. Em vez de resolver o problema, o agente escrevia scripts para procurar por arquivos ocultos secret_cases.json no workspace ou usava curl para baixar diretamente do GitHub o código-fonte alvo.
A Z.ai precisou construir um módulo anti-hack on-line em duas etapas para forçar o modelo a resolver os problemas de forma legítima, retornando dados fictícios quando ele tentava trapacear, em vez de encerrar a execução.
Dito isso, para profissionais, sempre resta um pouco do ônus de avaliação. Embora as pontuações sejam muito competitivas (e claramente conquistadas a duras penas contra um modelo tentando burlar o teste), você ainda deve rodar o GLM-5.2 no seu próprio repositório representativo antes de colocá-lo em produção.
Em breve, traremos um tutorial completo do GLM-5.2.
O GLM-5.2 já está disponível para todos os usuários do GLM Coding Plan na Z.ai. Os planos são Lite, Pro, Max e Team.
A Z.ai oferece três faixas com base no tamanho do repositório e na frequência de uso. As assinaturas são mensais, mas o faturamento anual reduz o custo em 30%.
| Plano | Preço mensal | Preço anual (por mês) | Perfil de uso | Cota base (5 horas / semanal) |
|---|---|---|---|---|
| Lite | US$18 | US$12,60 | Repos pequenos, iteração leve | ~80 / ~400 prompts |
| Pro | US$72 | US$50,40 | Repos médios, desenvolvimento diário | ~400 / ~2.000 prompts |
| Max | US$160 | US$112,00 | Repos grandes, fluxos avançados | ~1.600 / ~8.000 prompts |
Segundo a página de uso da Z.ai, por ser um modelo avançado projetado para rivalizar com o Claude Opus 4.8, o GLM-5.2 é altamente intensivo em recursos. Os limites de prompts na tabela acima são estimativas de base. Usar o GLM-5.2 consome essa cota mais rápido conforme o horário do dia:
Por isso, a recomendação é usar o GLM-5.2 para tarefas complexas, preservando seu uso.
Para desenvolvedores que desejam integrar o modelo diretamente via API, o GLM-5.2 usa cobrança por consumo (pay-as-you-go).
De acordo com a documentação oficial de preços da Z.ai, o uso da API do GLM-5.2 é cobrado por milhão de tokens:
O endpoint de API para acesso de desenvolvedores é https://api.z.ai/api/coding/paas/v4. Os identificadores de modelo são glm-5.2 para a versão padrão e glm-5.2[1m] para a variante com contexto de 1M de tokens. Você vai precisar de uma API key da Z.ai, que pode ser gerada em z.ai/manage-apikey/apikey-list.
Os pesos open source estão descritos como pendentes, com licença MIT planejada. Os pesos do GLM-5.1 foram liberados sob MIT no lançamento, então a expectativa é que os do GLM-5.2 sigam o mesmo caminho. O prazo indicado no anúncio foi "na próxima semana" em relação à data de 13 de junho de 2026.
O GLM-5.2 é um lançamento interessante de avaliar porque o argumento mais forte para testá-lo não é o benchmark. Ele é gratuito dentro do GLM Coding Plan (com limites de uso por plano), tem janela de contexto de 1M de tokens e entra no Claude Code ou Cline com uma mudança rápida de configuração. É uma barreira de entrada baixa para experimentar.
Os benchmarks impressionam. Levar o SWE-bench Pro a 62,1% e o Terminal-Bench 2.1 a 81,0 mostra um salto grande sobre o GLM-5.1. Dado o custo zero para quem já é assinante, vale muito rodá-lo no seu próximo refactor.
Se você quer se atualizar sobre ferramentas de IA para código e como avaliá-las, recomendo começar pelo curso AI-Assisted Coding for Developers da DataCamp, que cobre os conceitos necessários para analisar modelos como o GLM-5.2 nos seus próprios fluxos de trabalho.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
Tutorial
Josep Ferrer
11 min
Tutorial
DataCamp Team
2 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min






