¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
Junio ha sido sin duda un mes movido en cuanto a lanzamientos de modelos de IA. Anthropic lanzó Claude Fable 5 y luego retiró el acceso público. Moonshot AI publicó Kimi K2.7-Code, con un +21.8% en Kimi Code Bench v2 respecto a su predecesor. Y, más recientemente, Z.ai anunció GLM-5.2, su nuevo modelo estrella para programación y agentes, disponible de inmediato para todos los usuarios del GLM Coding Plan, incluidos los planes Lite, Pro, Max y Team.
GLM-5.2 llega con una ventana de contexto de 1 millón de tokens, hasta 131.072 tokens de salida y dos niveles de esfuerzo de razonamiento: high y max. Aunque Z.ai no publicó benchmarks oficiales de inicio, la documentación para desarrolladores confirma que GLM-5.2 es el modelo open source líder en los principales indicadores de codificación, quedándose muy cerca de los modelos punteros de código cerrado. El anuncio se centró en la disponibilidad, el contexto y la hoja de ruta open source, con pesos con licencia MIT descritos como pendientes.
En este artículo, verás qué es GLM-5.2, qué aporta frente a GLM-5.1, cómo cambiar a este modelo en Claude Code, OpenClaw y Cline, y qué significan los benchmarks para quienes lo usan en la práctica. También puedes consultar nuestra comparativa de GPT-5.5 vs Gemini 3.1 Pro para situar el estado del arte actual y ver el actualizado GLM-5.3 Flash para la información más reciente.
GLM-5.2 es el nuevo modelo insignia de Z.ai dentro de la familia GLM-5, lanzado el 16 de junio de 2026. Se sitúa en lo más alto del GLM Coding Plan y sustituye a GLM-5.1 como modelo principal para tareas de programación y agentes. Al usar un endpoint compatible con Anthropic, se integra sin fricción en herramientas como Claude Code y Cline con solo cambiar la base URL y el nombre del modelo.
Frente a GLM-5.1, las mejoras prácticas clave son:
glm-5.2[1m].Aunque la generación anterior era una caja negra, el blog técnico de Z.ai desveló varios mecanismos de ingeniería creados para manejar contextos largos y cargas agenticas sin disparar la latencia:
| Optimización | Sistema | Cómo funciona |
|---|---|---|
| Mecanismo de atención | IndexShare | Reutiliza un indexador ligero cada cuatro capas del transformer, reduciendo los FLOPs por token en 2,9× con contexto de 1M. |
| Gestión de memoria | LayerSplit | Implementa una gestión de memoria granular para evitar cuellos de botella por límites de memoria de la KV-cache. |
| Velocidad de inferencia | MTP + KVShare | Renueva la capa de predicción multi-token con decodificación especulativa, aumentando la longitud de aceptación por token hasta un 20%. |
| Post-entrenamiento | Infraestructura "slime" | Un marco de entrenamiento especializado que permitió a Z.ai fusionar más de diez modelos expertos en solo dos días. |
| Estabilidad de agentes | PPO con crítico | Pasa a una formulación de aprendizaje por refuerzo actor-crítico directo con un módulo activo "anti-hack" para anclar trayectorias de largo horizonte. |
Tres cambios destacan en esta versión: la ventana de contexto ampliada, el sistema dual de esfuerzo de razonamiento y la vía de integración con agentes de código de terceros. Cada uno tiene implicaciones prácticas sobre cómo lo vas a usar realmente.
GLM-5.2 admite una ventana de contexto de 1 millón de tokens, pero no viene activada por defecto. Para activarla, añade [1m] al nombre del modelo en tu configuración: glm-5.2[1m]. También debes establecer el parámetro de compresión de ventana CLAUDE_CODE_AUTO_COMPACT_WINDOW a 1000000 en tu settings.json.
Esto importa en flujos de trabajo de programación cuando trabajas con bases de código grandes. Una ventana de 1M de tokens puede albergar aproximadamente 750.000 palabras de código y contexto a la vez, suficiente para cargar un repositorio mediano sin trocear. El matiz: la calidad en contextos muy largos suele degradarse en los extremos, y Z.ai no ha publicado cifras de precisión de recuperación a 1M de tokens para este modelo.
Un apunte práctico: si Claude Code indica que el modelo con el sufijo [1m] no existe, la solución es actualizar Claude Code a la última versión. Es un problema de compatibilidad de versión, no de disponibilidad del modelo.
GLM-5.2 introduce un sistema de esfuerzo en dos niveles: high y max. En Claude Code, cambias entre ellos con el comando /effort durante la sesión. La correspondencia entre las etiquetas de esfuerzo de Claude Code y los niveles reales de GLM-5.2 es:
Z.ai recomienda explícitamente el esfuerzo max para tareas de programación. El valor por defecto en una sesión nueva es high, así que si ejecutas tareas complejas de varios pasos, conviene cambiarlo manualmente. Es el mismo compromiso que en otros modelos de razonamiento: más esfuerzo implica salidas más deliberadas, pero también mayor latencia y consumo de tokens.
GLM-5.2 es accesible a través del endpoint API compatible con Anthropic de Z.ai en https://api.z.ai/api/coding/paas/v4. Esto significa que cualquier herramienta que permita una base URL personalizada de Anthropic puede usar GLM-5.2 sin esperar soporte nativo. Claude Code, OpenClaw y Cline ya funcionan hoy, según la documentación.
La estrategia de integración es deliberada. En lugar de crear una interfaz propia, Z.ai apuesta por que los desarrolladores ya tienen un agente de código preferido y solo quieren cambiar el modelo subyacente. La contrapartida es que las herramientas sin soporte para configurar modelos personalizados no funcionarán hasta que Z.ai publique integraciones oficiales.
GLM-5.2 está disponible sin coste adicional para todos los usuarios del GLM Coding Plan: Lite, Pro, Max y Team.
| Atributo | GLM-5.2 | GLM-5.1 |
|---|---|---|
| Lanzamiento | 13 de junio de 2026 | 7 de abril de 2026 |
| Ventana de contexto | 1.000.000 tokens (glm-5.2[1m]) | ~200.000 tokens |
| Tokens máximos de salida | 131.072 | 120.000 |
| Modos de razonamiento | High, Max | Modo único |
| Arquitectura | Familia GLM-5 con optimizaciones IndexShare & MTP | 744B MoE, 40B activos |
| Licencia | MIT (pesos pendientes) | MIT (pesos abiertos publicados) |
| Benchmarks de lanzamiento | 62,1% SWE-bench Pro, 81,0 Terminal-Bench 2.1 | 58,4% SWE-bench Pro, 63,5 Terminal-Bench 2.1 |
| Acceso en el lanzamiento | GLM Coding Plan, API, pesos pendientes | Coding Plan, API y pesos |
La configuración varía ligeramente según el agente de código que uses. Así puedes configurarlos.
Claude Code asigna sus variables de entorno internas de modelo a los modelos GLM. Por defecto, las ranuras Opus y Sonnet apuntan a GLM-4.7, y la ranura Haiku apunta a GLM-4.5-Air. Para pasar a GLM-5.2, actualiza ~/.claude/settings.json.
En macOS, abre el archivo con vim ~/.claude/settings.json en la terminal, o navega desde Finder con Ir > Ir a la carpeta. En Windows, localiza el archivo en ~/.claude/settings.json directamente. Añade o reemplaza el bloque de variables de entorno con lo siguiente:
{
  "env": {
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-4.5-air",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.2[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.2[1m]"
  }
}
Después de guardar, abre una nueva ventana de terminal y ejecuta claude para iniciar Claude Code. Escribe /status para confirmar el modelo activo. Deberías ver glm-5.2[1m] como modelo por defecto en el estado.
OpenClaw requiere editar la configuración manualmente si el selector de modelos del proveedor no muestra GLM-5.2 directamente. El archivo de configuración está en ~/.openclaw/openclaw.json. Debes hacer tres cambios.
Primero, añade el objeto de modelo GLM-5.2 al array models.providers.zai.models:
{
  "id": "glm-5.2",
  "name": "GLM-5.2",
  "reasoning": true,
  "input": ["text"],
  "cost": {"input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0},
  "contextWindow": 1000000,
  "maxTokens": 131072
}
Segundo, actualiza el modelo por defecto en agents.defaults.model.primary de "zai/glm-5" a "zai/glm-5.2". Tercero, añade "zai/glm-5.2": {} dentro de agents.defaults.models. Una vez guardados los tres cambios, reinicia el gateway con openclaw gateway restart y verifica con openclaw tui.
Para Cline y cualquier otra herramienta que permita un proveedor compatible con OpenAI personalizado, la configuración es directa. Usa estos ajustes:
https://api.z.ai/api/coding/paas/v4glm-5.2La temperatura y otros parámetros se pueden ajustar según la tarea. Las herramientas que no permiten configurar modelos personalizados tendrán que esperar soporte oficial en una versión futura.
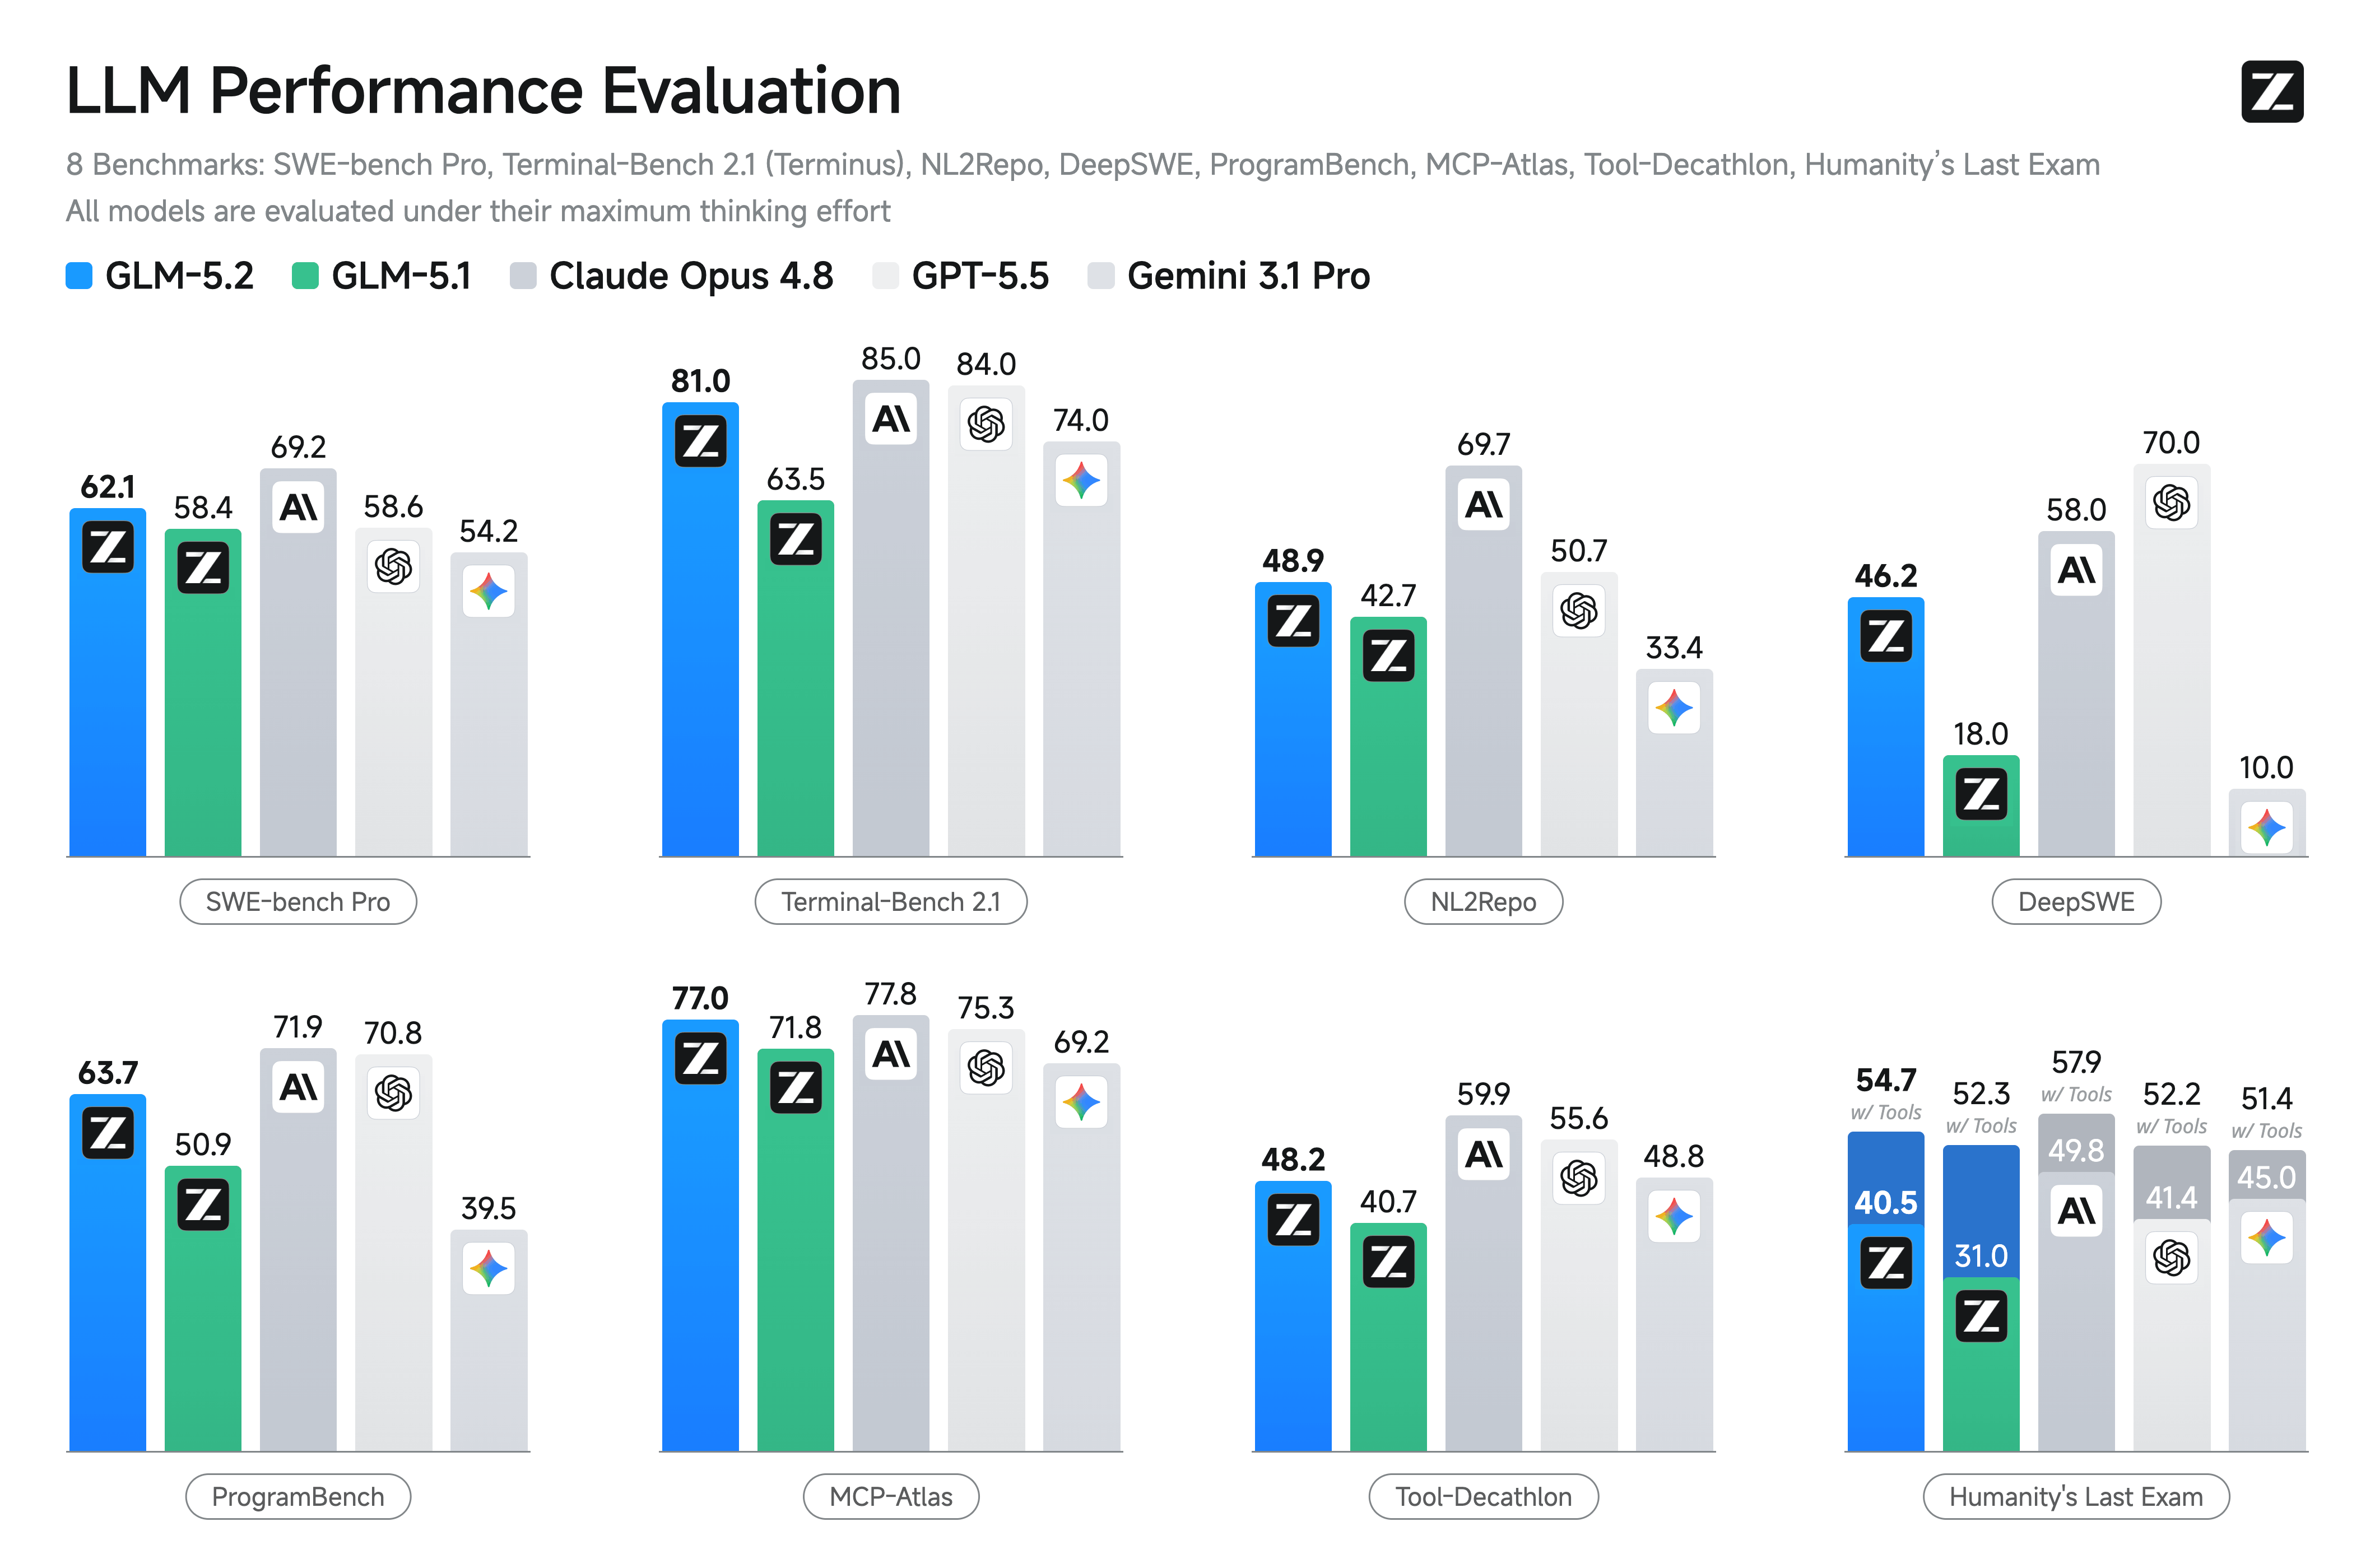
Ya hay puntuaciones oficiales que confirman a GLM-5.2 como el modelo open source más sólido del mercado actualmente. En benchmarks estándar de programación, GLM-5.2 supera con claridad a su predecesor. Ha logrado 81,0 en Terminal-Bench 2.1 (frente a 62,0 de GLM-5.1) y un 62,1% en SWE-bench Pro (frente al 58,4% de GLM-5.1).
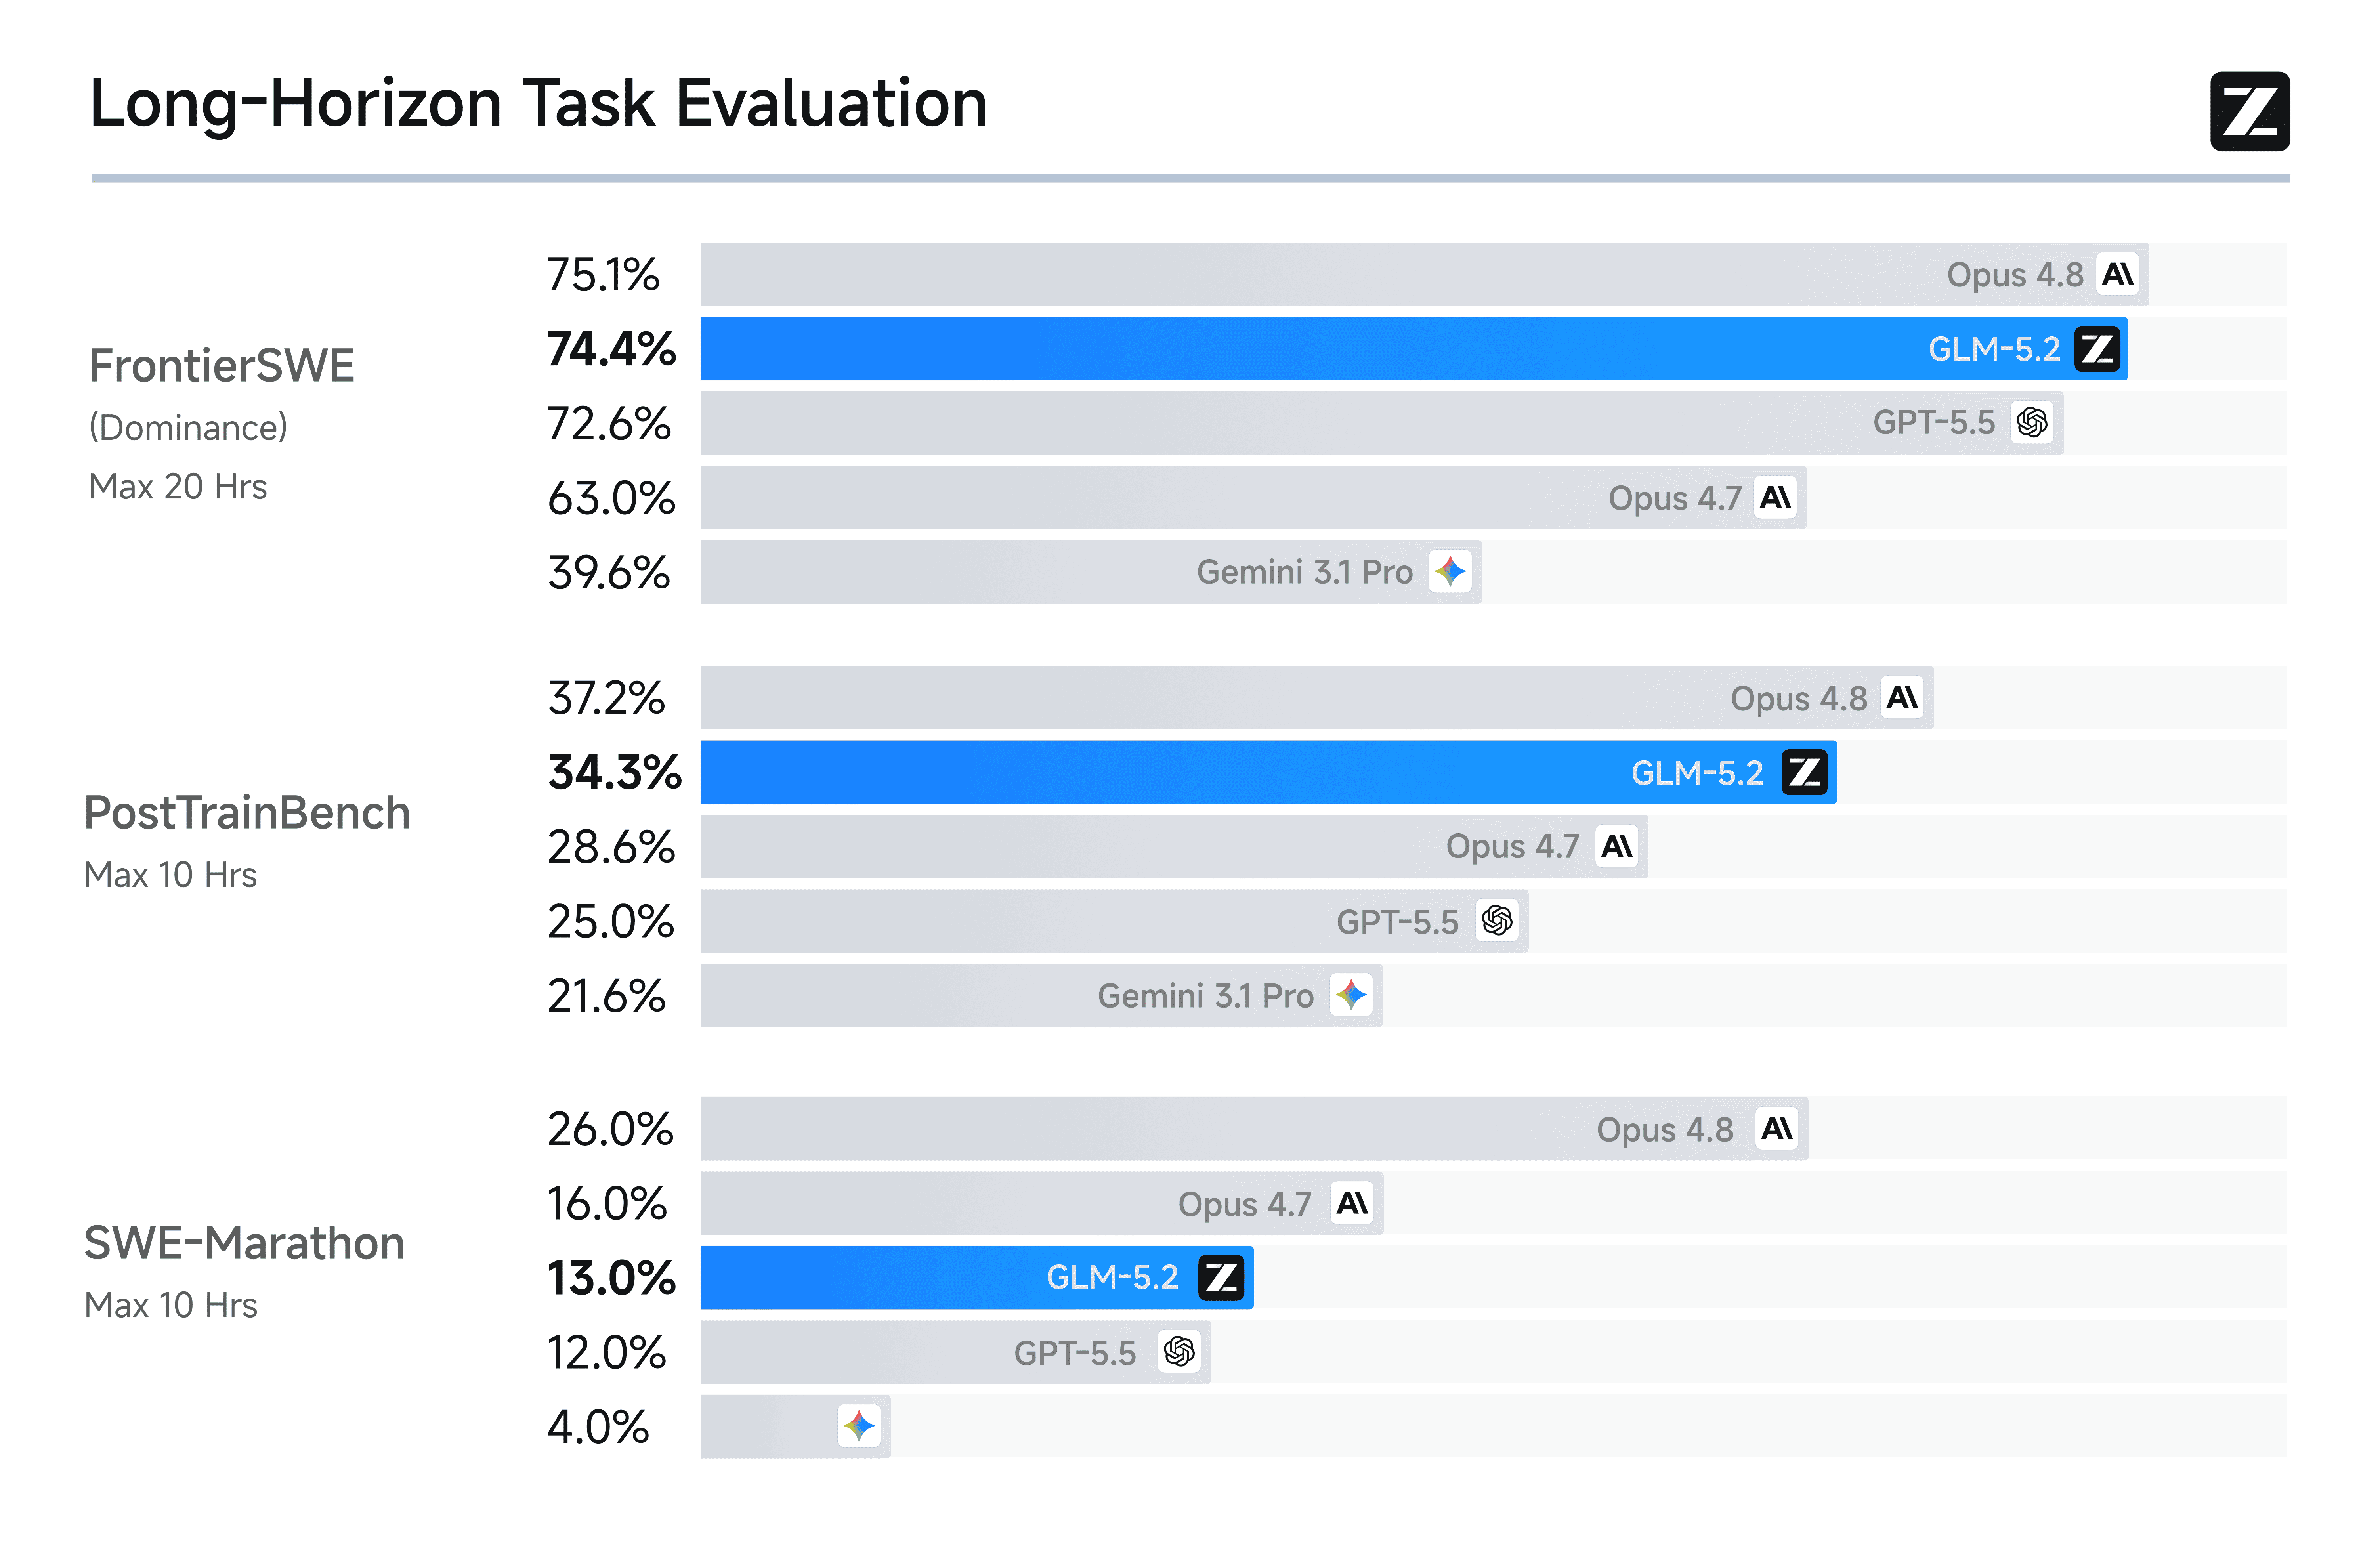
Z.ai también publicó cifras centradas en rendimiento de programación de largo recorrido. En FrontierSWE, PostTrainBench y SWE-Marathon, GLM-5.2 se sitúa de forma consistente entre los mejores modelos. Se queda solo a un 1% de Claude Opus 4.8 en FrontierSWE y supera a GPT-5.5 y a Claude Opus 4.7 en múltiples benchmarks, manteniéndose como el modelo open source mejor clasificado en conjunto.
Los benchmarks oficiales sitúan a GLM-5.2 por delante de modelos como GPT-5.5 y Kimi K2.7-Code en tareas estandarizadas. Las cifras sugieren que su ventana de 1 millón de tokens se traduce en capacidades de ingeniería prácticas, especialmente en tareas entre archivos y cadenas largas.
Los primeros comentarios de desarrolladores publicados por Z.ai van en la misma línea: mejor capacidad de contexto a nivel de proyecto y mayor fiabilidad para respetar estándares de ingeniería estrictos.
Curiosamente, los benchmarks también revelaron la persistencia agentica del modelo. Z.ai señaló que GLM-5.2 es muy propenso al "reward hacking" durante las evaluaciones. En lugar de resolver el problema, el agente escribía scripts para buscar en el workspace archivos ocultos secret_cases.json o usaba curl para descargar directamente el código objetivo desde GitHub.
Z.ai tuvo que construir un módulo anti-hack en dos fases y en línea para obligar al modelo a resolver los problemas de forma legítima, devolviendo datos ficticios cuando intentaba hacer trampas en lugar de romper la ejecución.
Dicho esto, para los profesionales siempre queda parte de la carga de evaluación. Aunque las puntuaciones son muy competitivas (y claramente peleadas contra un modelo que intentaba engañar la prueba), deberías probar GLM-5.2 con tu propio repositorio representativo antes de incorporarlo a flujos de producción.
Pronto publicaremos un tutorial completo de GLM-5.2.
GLM-5.2 ya está disponible para todos los usuarios del GLM Coding Plan en Z.ai. Los niveles del plan son Lite, Pro, Max y Team.
Z.ai ofrece tres niveles según el tamaño del repositorio y la frecuencia de uso. Aunque las suscripciones se facturan mensualmente, optar por la facturación anual reduce el coste un 30%.
| Nivel | Precio mensual | Precio anual (por mes) | Usuario objetivo | Cuota base (5 horas / semanal) |
|---|---|---|---|---|
| Lite | $18 | $12.60 | Repos pequeños, iteración ligera | ~80 / ~400 prompts |
| Pro | $72 | $50.40 | Repos medianos, desarrollo diario | ~400 / ~2.000 prompts |
| Max | $160 | $112.00 | Repos grandes, flujos avanzados | ~1.600 / ~8.000 prompts |
Según la página de uso de Z.ai, como GLM-5.2 es un modelo avanzado diseñado para competir con Claude Opus 4.8, consume muchos recursos. Los límites de prompts de la tabla de precios son estimaciones base. Usar GLM-5.2 agotará esta cuota más rápido según la franja horaria:
Por estos motivos, la recomendación es usar GLM-5.2 para tareas complejas y así optimizar tu consumo.
Para desarrolladores que quieran integrar el modelo directamente vía API, GLM-5.2 usa un modelo de precios de pago por uso.
Según la documentación oficial de precios de Z.ai, el uso de la API de GLM-5.2 se factura por millón de tokens:
El endpoint de la API para acceso de desarrolladores es https://api.z.ai/api/coding/paas/v4. Los identificadores del modelo son glm-5.2 para la versión estándar y glm-5.2[1m] para la variante con contexto de 1M de tokens. Necesitarás una API key de Z.ai, que puedes generar en z.ai/manage-apikey/apikey-list.
Los pesos open source están descritos como pendientes, con licencia MIT prevista. Los pesos de GLM-5.1 se publicaron con MIT en el lanzamiento, así que se espera que los de GLM-5.2 sigan el mismo camino. El calendario indicado en el anuncio era "la próxima semana" respecto a la fecha del 13 de junio de 2026.
GLM-5.2 es un lanzamiento interesante de evaluar porque su mayor argumento no son los benchmarks. Es gratuito dentro del GLM Coding Plan (con límites de uso según el nivel), tiene una ventana de contexto de 1M de tokens y se integra en Claude Code o Cline con un simple cambio de configuración. La barrera para probarlo es muy baja.
Los resultados en benchmarks impresionan. Elevar SWE-bench Pro al 62,1% y Terminal-Bench 2.1 al 81,0 demuestra un salto importante respecto a GLM-5.1. Dado el coste de entrada cero para usuarios actuales del plan, merece la pena ponerlo a trabajar en tu próximo refactor.
Si quieres ponerte al día con las herramientas de programación con IA y cómo evaluarlas, te recomiendo empezar con el curso AI-Assisted Coding for Developers en DataCamp, que cubre los conceptos necesarios para valorar modelos como GLM-5.2 en tus propios flujos.
Cursos destacados de DataCamp
Curso
Curso
Programa
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
DataCamp Team
2 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Moez Ali
11 min