
Last chance! 50% off DataCamp Premium
Sale ends in
更新(2026 年 7 月 1 日): Claude Fable 5 的访问已恢复,现在可在 Claude Platform、Claude.ai、Claude Code 与 Claude Cowork 全球使用,先前的出口管制令已解除。Mythos 5 仍仅限经过审核的 Project Glasswing 合作伙伴使用。
更新(2026 年 9 月 2 日): Anthropic 已发布该模型的后续版本。请参阅我们的 Claude Fable 5.1 指南 和 Claude Fable 5.1 API 教程了解详情。
我们最早是在 4 月听到 Claude Mythos 的消息,当时我们撰文介绍了 Claude Opus 4.7 的发布。彼时我们了解到,尽管 Opus 4.7 本身已相当出色,但之所以是公开可用的最佳模型,仅仅因为 Mythos 级模型尚未面向大众发布。
如今,Anthropic 带来了 Claude Fable 5——一款可安全用于通用场景的 Mythos 级模型。它无疑在各项重要基准测试中领跑,包括知识型工作、软件工程与科学研究等。这对刚在八天前提交美国 IPO 申请的 Anthropic 来说,是一次重大胜利。
本文将深入解析 Claude Fable 5,比较它与市面上其他模型(如 GPT-5.5、Gemini 3.1 Pro)以及 Claude 自家模型(如 Opus 4.8)的差异。我们也会给出何时使用该模型的建议,因为它价格更高。如果您刚接触 Claude 并渴望上手,建议先阅读我们的Claude 学习指南。
Claude Fable 5 是 Anthropic 为其最新、最强模型命名的版本。它属于 Mythos 级模型,但在关键领域(尤其是网络安全)引入了重要的安全防护。
对用户而言,这意味着某些问题会由下一档模型 Claude Opus 4.8 回答。Anthropic 估计此类重路由发生在少于 5% 的查询中,而且这一估计偏保守。考虑到涉及网络安全,这样安排也更妥当。当然,这一比例会因您的具体工作类型而差异很大。
我们对 Claude Fable 5 格外期待。该模型的能力已拓展到新的实用领域:网络安全防御者可用它来加固关键系统,生命科学研究者可用它改进新疗法,天体物理学家可用它绘制星系地图,等等。
如果您阅读了发布信息,可能也听到过 Claude Mythos 5。若您在想:Claude Mythos 5 是相同的底层模型,但放宽了部分安全防护。它并非面向公众使用:该模型以 Project Glasswing 项目的一部分部署,与美国政府合作,实质上取代了 Claude Mythos Preview。我们对 Claude Mythos 5 了解不多,但知道它拥有目前全球最强的网络安全能力。Anthropic 与美国政府的合作本身就是证据。
Fable 5 在安全性、透明度、记忆与数据处理方面带来了多项显著升级。
Fable 5 最大的结构性新增是一套两阶段分类器系统,旨在防止模型最危险能力的滥用。一个探针会在所有流量中监测模型的内部激活;任何被标记的请求都会升级到一个单独训练的 LLM 分类器,由其做最终裁定。被拦截的请求不会被直接拒绝,而是重路由至 Opus 4.8,以便用户仍能获得有用回复。
这一点与上文相似。当 Fable 5 的分类器将查询重路由到 Opus 4.8 时,会通知用户是哪一个模型处理了他们的请求。这是一项新的透明度机制,用户无需再猜测为何回复手感不同。
Fable 5 能在任务中途将笔记写入文件,并在后续回溯引用,这不同于仅拥有超长上下文窗口。这是一种主动工作记忆行为。Anthropic 自身测试显示,这一能力带来的性能提升明显高于 Opus 4.8。
Anthropic 为所有 Fable 5 流量引入了新的数据保留策略。数据将保留 30 天,用于检测新型越狱并减少误报。Anthropic 表示这些数据不会用于模型训练,人类访问会被记录在案。
Claude Fable 5 在我们重点关注的所有基准测试中全面胜出。在 SWE-Bench Pro 上得分 80.3%,领先于 Opus 4.8 的 69.2%。在带有工具的 Humanity's Last Exam 上得分64.5%,而 Opus 4.8 为 57.9%,GPT-5.5 为 52.2%。
| Category | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentic coding | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| Agentic coding | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Knowledge work | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Knowledge work vision | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Spatial reasoning | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Tool use | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Computer use | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Legal | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Multidisciplinary reasoning | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Multidisciplinary reasoning | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biology | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biology | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentic coding | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersecurity | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Health | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
我提到了 FrontierCode 基准,但尚未展开。FrontierCode 不仅测试模型能否通过编码测试(这本身已很难),还检验其是否能达到高质量生产级代码库的更高、更通用标准,例如代码在大规模下的性能、是否符合惯用风格、是否为长期可维护性而良好组织等。
Claude Fable 5 在不使用 high 或 xhigh 努力参数的情况下,就在 FrontierCode 测试中取得了所有模型中最高的分数。
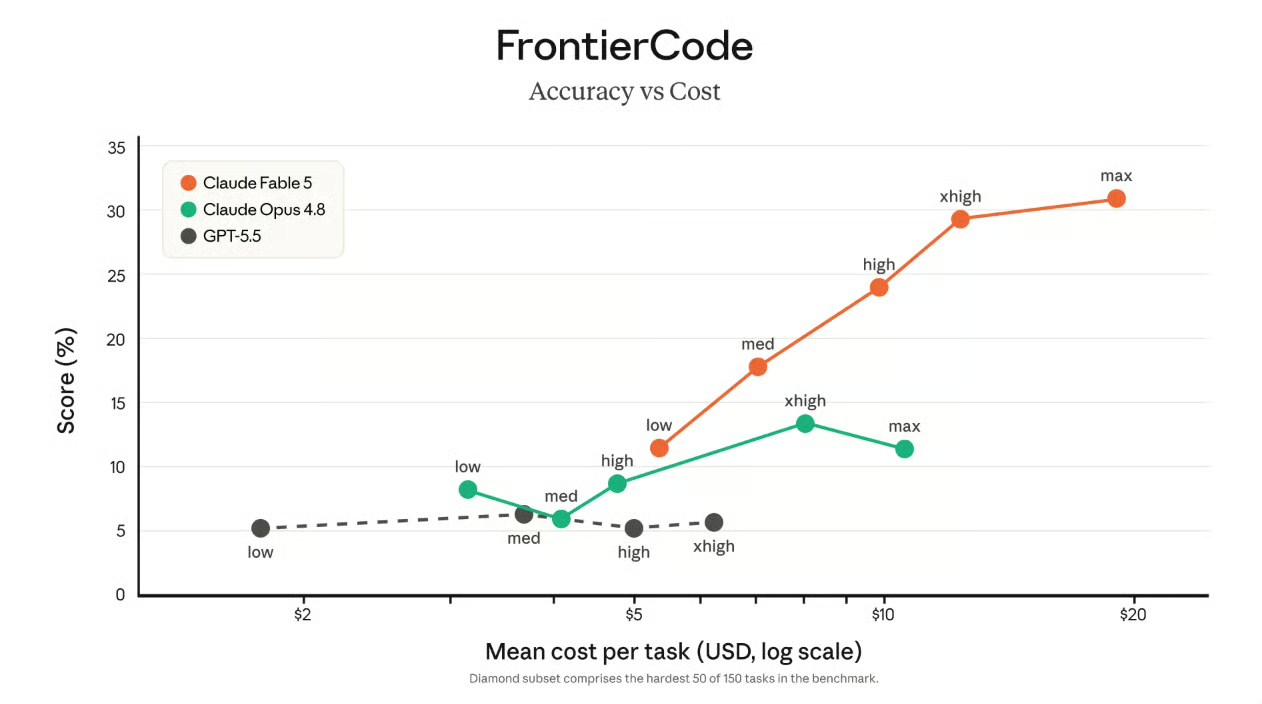
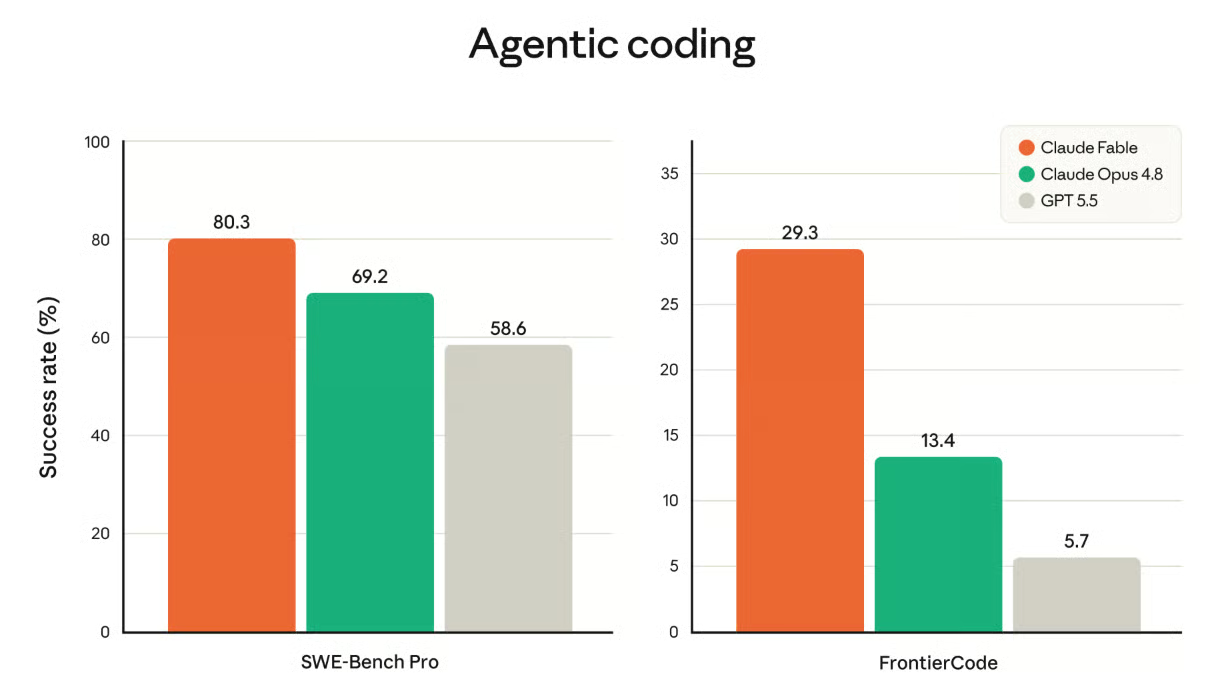
Claude Fable 5 是新的视觉任务最佳模型。在 Anthropic 的测试中,Fable 5 仅凭截图、无需脚手架就能重建 Web 应用的源代码。这一能力也体现在其 CharXiv Reasoning(带工具)93.2% 的得分中。
Fable 5 还在一个更常见的问题上表现出色:它能从复杂的科学图表中精确提取数值,错误极少。
今年我们频繁讨论 AI 模型的记忆与长上下文能力。Fable 5 让我们有了新的话题。
首先,Fable 5 能在数百万标记的长度上保持专注。如果您对此不熟悉:当任务很长时,AI 模型可能会“遗忘”或丢失早期上下文;但 Fable 5 即使在超长任务中也更能保持连贯一致的行为。到底多长算很长?作个参照,一百万标记大约相当于 700 页的长篇小说。
Anthropic 还提到一个有趣点:Fable 5 会用自己的笔记来改进输出。也就是说,模型可在任务中途把内容写下来(比如写入文件),之后再回看引用,类似人类在解题时随手记笔记。这不同于拥有长记忆,模型是将外部存储当作思考工具在用。
上表已显示 Fable 5 在各项中皆领先。但更有用的问题是领先的“形状”:哪里差距悬殊,哪里各半开,以及原因何在。
GPT-5.5 是最接近的竞争对手,在多数任务上两者几乎打成平手。Blueprint-Bench 2 的空间推理,GPT-5.5 为 36.2,Fable 5 为 38.6。即便在长链式具身任务中,只要模型在执行过程中能获得反馈,二者依旧接近。在 Terminal-Bench 2.1 上,终端会立刻标注错误,分数分别为 83.4 与 88.0。
有一种情形会打破这一模式:只在最终评分的长任务。此时模型无法自行纠错,错误会积累,能力更强的模型就会拉开差距。SWE-Bench Pro 最明显:GPT-5.5 为 58.6,Fable 5 为 80.3。
想看详细对比,请阅读我们的文章:Claude Fable 5 vs GPT-5.5:基准、定价与如何选择。
Gemini 3.1 Pro 在所有方面都落后于 Fable 5,且在最重要的工作上差距更大。在 GDPval-AA 知识型工作上,Gemini 得分 1314,而 Fable 5 为 1932。在 Terminal-Bench 2.1 上,二者分别为 70.7 与 88.0。较短、封闭式任务上的差距较小——空间推理为 26.5 比 38.6——但从未弥合。这一模式指向一个能妥善处理短问题、但在 Fable 5 擅长的长链、重工具流程中容易丢线的模型。
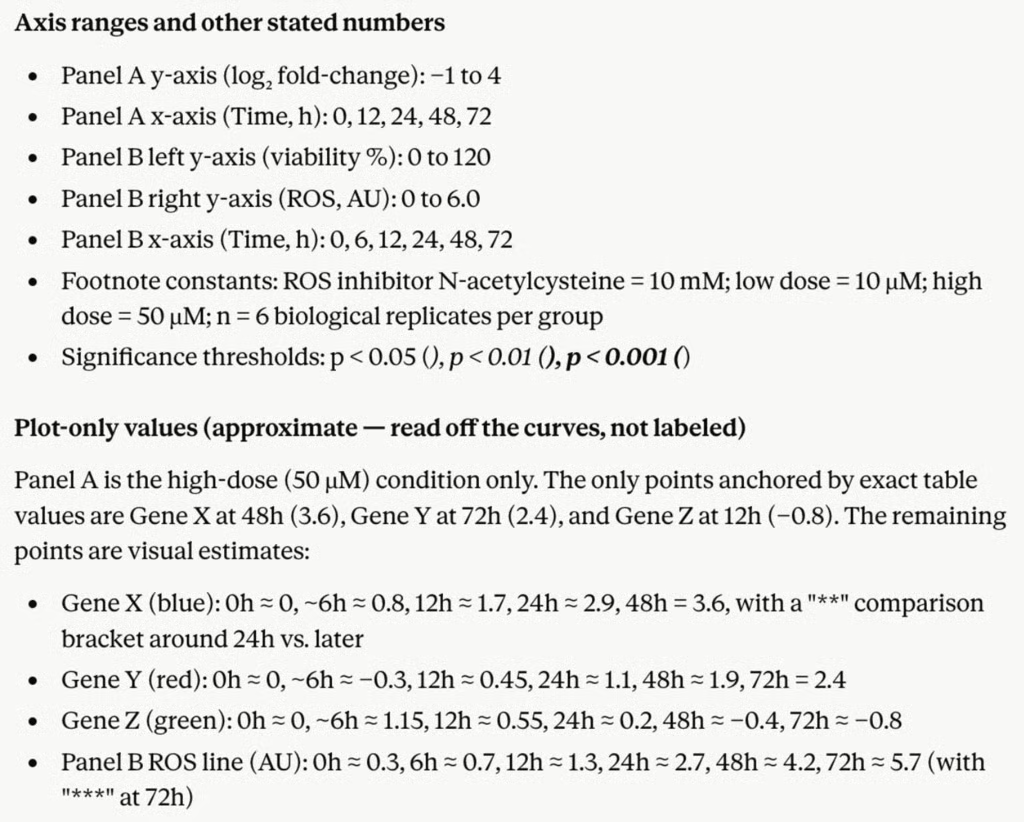
Anthropic 在发布信息中的一个具体声明是:Fable 5 能从复杂科学图表中精确提取数值,错误极少。
为检验这一点,我们构造了一个由两块面板组成的科学图,模拟细胞生物学论文中的典型输出:对数₂坐标轴上的重叠基因表达时间序列、以百分比与任意单位其他测量配对的双 y 轴面板等。
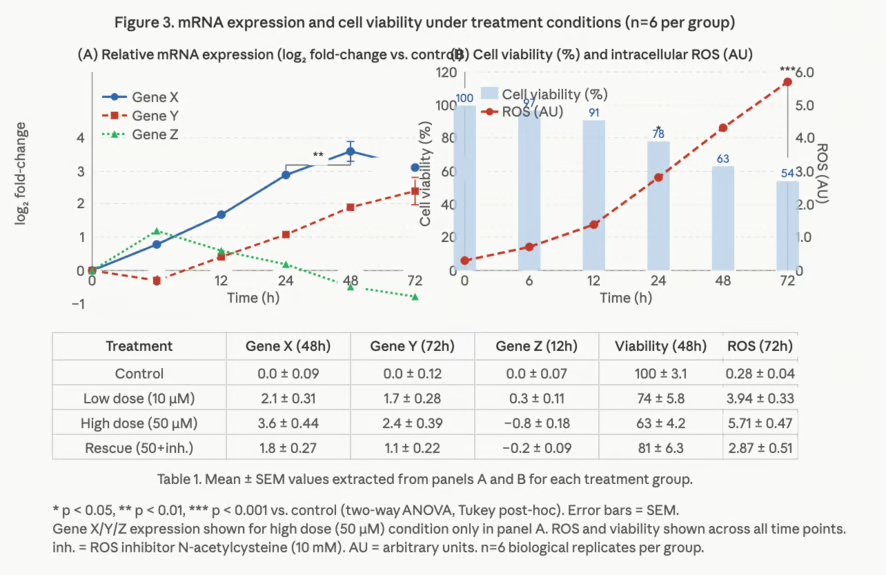
我们以为这会很棘手。面板 B 的双 y 轴使用不同刻度与不同单位。基因 Z 在某些位置进入负的对数₂区间。
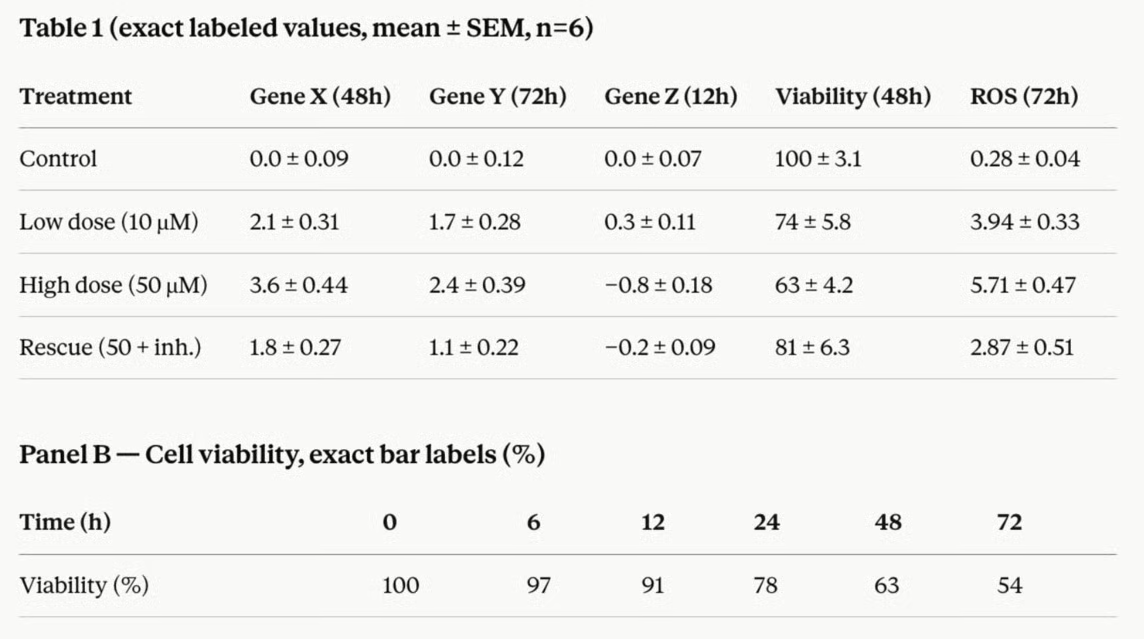
我们让 Fable 5 从两个面板和表格中提取所有数值。
please extract all numeric values结果几乎完美。我用于绘图的自制表格中,基因 Z 在 48 小时时的值为 -0.05。Fable 5 告诉我是 -0.04,而不是 -0.05。
在发布信息中,Anthropic 展示了来自客户或合作伙伴(如 GitHub、Figma)的早期访问反馈/产品证言。他们都给出了正面评价,但这在每次 Anthropic 模型发布中都属常见。
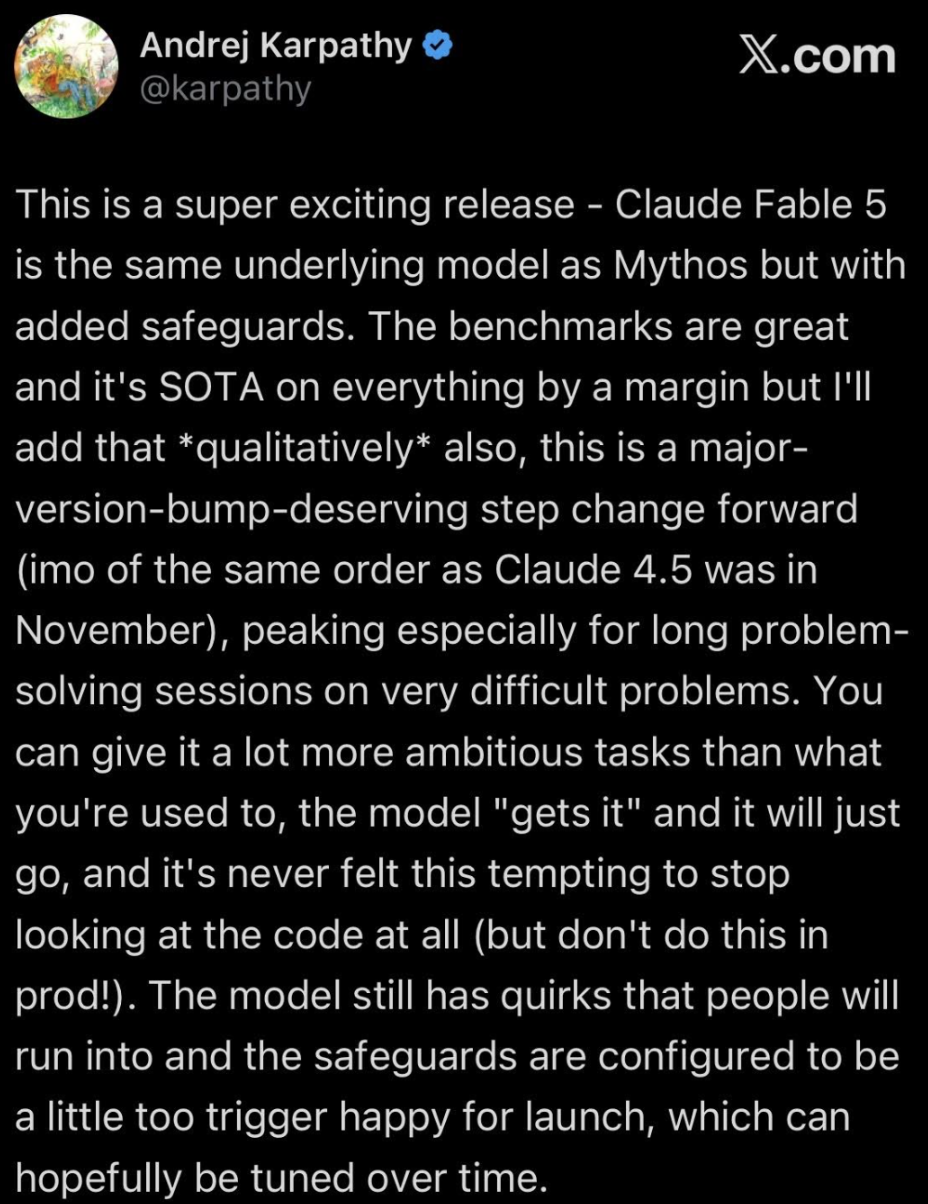
X 上的观点更少修饰。最抢眼的是,Andrej Karpathy 给出了几乎溢美的评价,认为 Fable 5 在所有相关基准上都是最先进的,并称其为一次类似 Opus 4.5(去年 11 月)那样的跃迁式进步。在帖子的其余部分,他还给出了许多可用 Fable 5 实现的点子,例如:
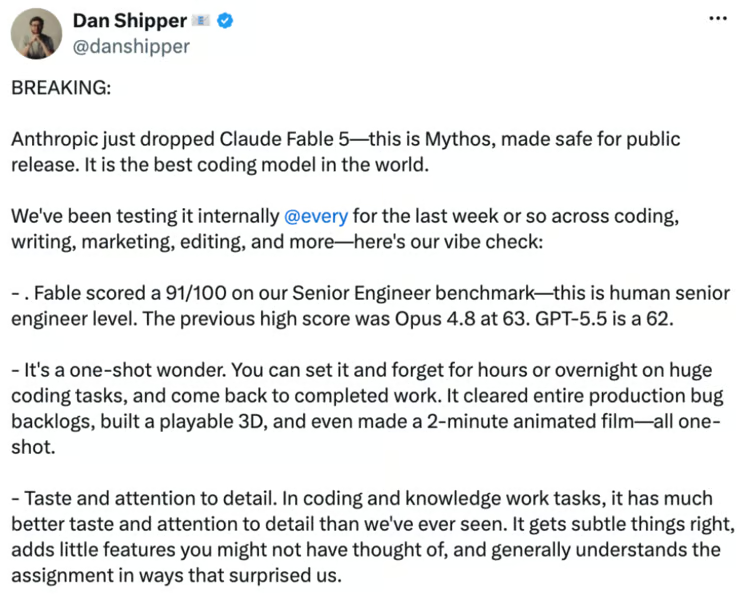
Every 的 CEO Dan Shipper 也表达了类似观点,他认为 Fable 5 在基准测试上表现惊人,同时还是“单发奇迹”——您可以把一个大项目交给它,第二天早上回来就能看到完成的成果。(他之所以知道,是因为拿到了早期访问。)
也有一些平衡性的批评:他指出该模型较慢且“吃标记”,换言之成本较高。他称其价格是 Opus 的两倍。因此他也很聪明地提醒,只有在确有必要时才使用该模型。
我提过:Claude Fable 5 本质上是 Claude Mythos 5,但加上了安全防护。这意味着,如果不加限制,Fable 5 的强大能力可能在网络安全、生物学等领域为不良行为者提供实质性帮助——这就是基本判断。
护栏的大体工作原理如下。这是一套两阶段分类器系统:
分类器主要覆盖三个领域。
请看一张图中的前后对比。粉色柱代表未加护栏的 Claude Mythos 5——原始底层模型。它在四个基准上的能力都极强:Firefox 漏洞开发 88.4%、CyberGym 漏洞复现 83.8% 等等。
橙色柱代表启用分类器的 Claude Fable 5,在所有基准上都是 0.0%。护栏将这些能力压平到零,这是好事——他们追求的正是“零”。
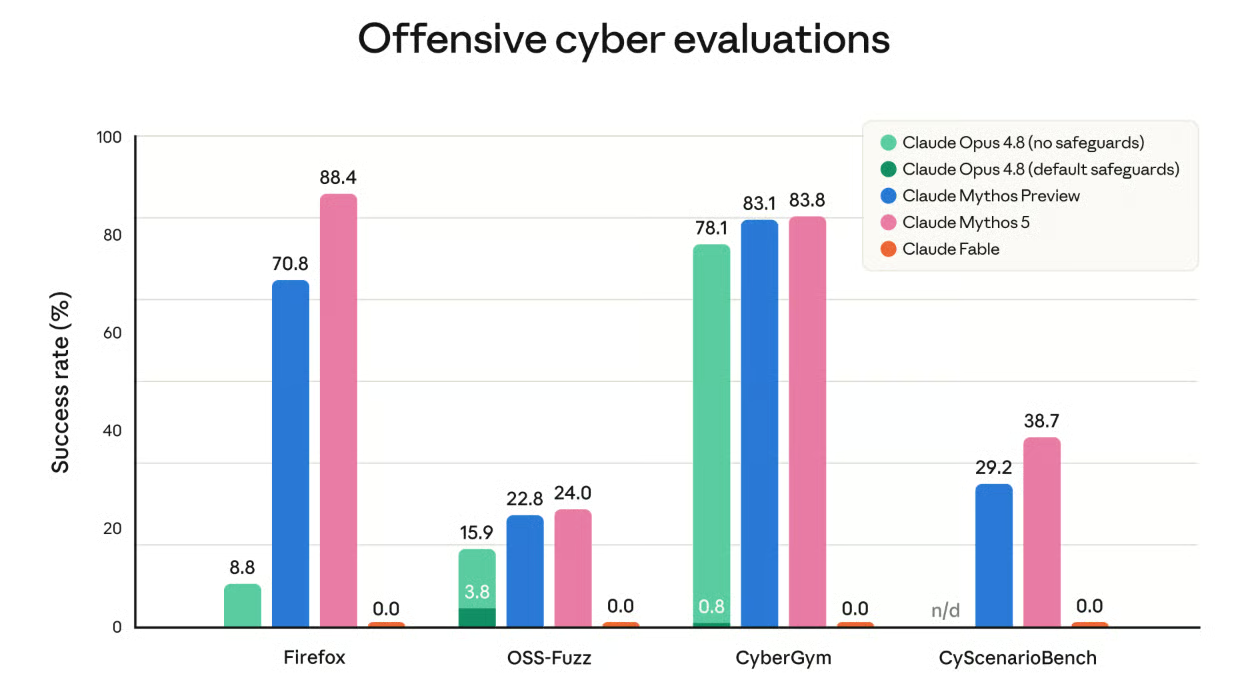
我喜欢这张图,因为它将 Opus 4.8 放入了上下文中。即使不加护栏,Opus 4.8 的分数也远低于 Mythos 5。这也说明了为何必须引入分类器。Opus 与 Mythos 之间的能力跃迁,正是让广泛发布变得有风险并被推迟的原因。
如果您是 Pro、Max、Team 或 Enterprise 计划用户,现在即可免费使用 Fable 5——但仅限至 6 月 22 日。
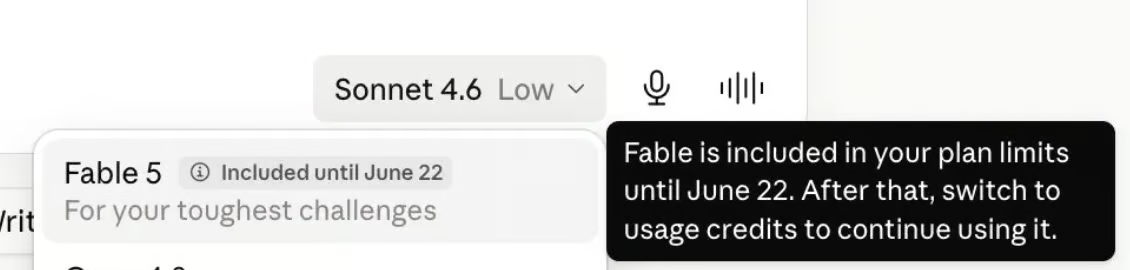
6 月 22 日后,将需要使用用量点数,亦即 Anthropic 在您现有订阅之上提供的按量付费体系。Dan Shipper 对成本的提醒,很可能部分源于此。
对使用 API 的开发者而言,更为简单:
若与 Opus 4.8 的标准定价(输入 5 美元/百万标记,输出 25 美元/百万标记)相比,Fable 5 的确贵一倍,如 Dan 所言。但若您已在用 Opus 4.8 的快速模式,Fable 5 的价格与之相同,同时能力更强。
重要提示:如同我之前好奇的一样,当查询因安全分类器而回退到 Opus 4.8 时,将按 Opus 4.8 的费率计费,而非 Fable 5 的费率。
不带护栏的 Mythos 版本 Claude Mythos 5 不向公众开放,仅限 Project Glasswing 合作伙伴使用。
Anthropic 以 Project Glasswing 与耐人寻味的 Mythos 模型吊足了大家的胃口。但数月以来,这个“全球最佳”的模型——它确实是全球最佳——始终被锁在政府合作之中。
这一切在 Anthropic 提交美国 IPO 申请后一周发生了变化。现在,Mythos 级模型可在 Pro 计划中使用。(访问还基于用量点数。详情见上一节。)
现状:Anthropic 的模型已强大到若不加限制就可能造成严重危害。我们知道这不是营销文案,因为公司为此专门构建了一套并行分类器系统来添加护栏。
未来走向:能力上限不断抬升,基准测试持续被更难的版本取代,模型发布节奏也越来越快。与此同时,安全护栏的基础设施也愈发复杂,以作补偿。随着 IPO 可能在今年推进,关于竞争压力与安全问题之间如何权衡的讨论将会很多。
与 DataCamp 一起学习
课程
课程
课程
