
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
10.7K
Z.ai 发布了 GLM-5.3-Flash,这是其旗舰 GLM-5.3 的成本优化版本,先以匿名预览代号亮相,后公开为“Ox Alpha”。同日,Qwen3.8-Flash-Next 也宣布推出,预算档 LLM 赛道迅速热闹起来。
如果您一直在关注中国开源权重实验室与西方前沿之间的竞速,这一款值得一看。
核心主张很直接:以极低成本实现接近前沿的编码与智能体性能。
GLM-5.3-Flash 在 Terminal-Bench 2.1 上得分 84.3,已经逼近 Claude Opus 4.8(85.0)与 GPT-5.6 Terra(87.4)。
它采用专家混合(MoE)架构,配置为 320B-A18B(总参数 320B,每个 token 激活 18B),支持 100 万 token 上下文窗口,并原生多模态。
本文将概览 GLM-5.3-Flash 的新变化,介绍其功能并解读基准表现。想看模型实战,请查看我们的 GLM-5.3-Flash 教程,我们借助 CrewAI 构建了一个多智能体财务分析团队。
若想与同日发布的另一款预算档模型对比,请参阅我们的 Qwen3.8-Flash-Next 指南;若想了解我们本地运行过的类似 MoE 模型,请查看 运行 DeepSeek-V4-Flash-0731 的教程。
GLM-5.3-Flash 是 GLM-5.3 家族中的成本优化型号,能力低于完整版旗舰 GLM-5.3,但价格也大幅降低。
Artificial Analysis 给予其智能指数 57 分,而 GLM-5.3 为 60 分。
取舍体现在速度与成本:Flash 的服务价格约为 GLM-5.2 的十分之一,或约为 GLM-5.3 综合价的九分之一,且每 token 运行速度更慢。
该模型先以匿名预览形式推出,后定名,社区很快为其贴上了“Ox Alpha”的代号。
公开检查点在 Hugging Face 的 zai-org/GLM-5.3-Flash,支持长上下文(约 100 万 token),并通过相关生态提供工具调用与多模态能力。
此处最重要的基准是 Terminal-Bench 2.1,GLM-5.3-Flash 得分 84.3。该成绩高于我们测得的 DeepSeek-V4-Flash-0731 的 82.7,且仅落后 Claude Opus 4.8 的 0.7 分。对于一款综合用量加权价估算约每 100 万 tokens 0.10 美元的模型来说,这就是本次发布的核心看点。
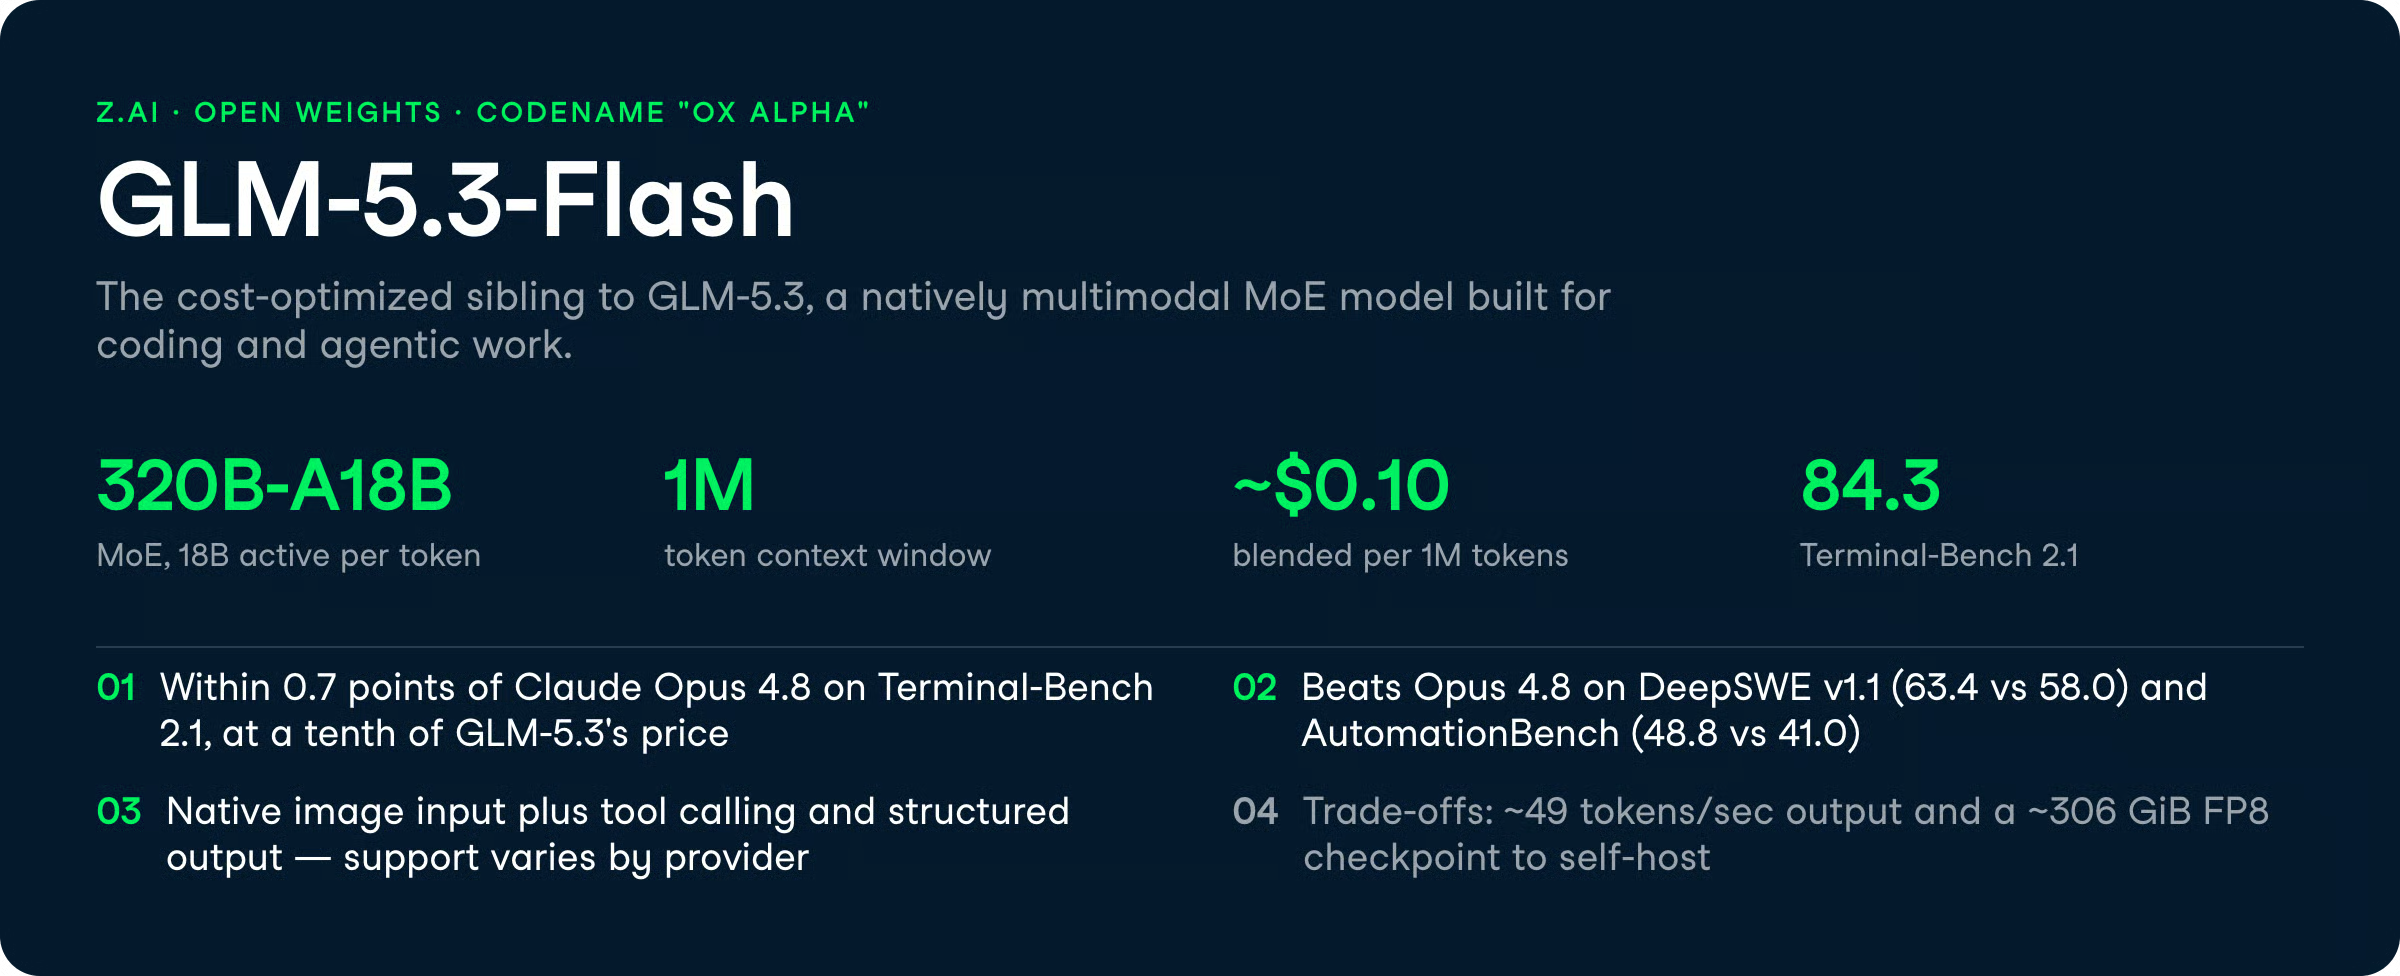
GLM-5.3-Flash 面向希望以非旗舰价格获得优秀智能体与编码性能的开发者。
以下是实务工作中最重要的能力。
您可以以可承受的价格运行编码智能体与自动化流程,使高频使用成为现实。
GLM-5.3-Flash 在 Terminal-Bench 2.1 上得分 84.3,在 DeepSWE v1.1 上得分 63.4,相比 GLM-5.2 在同一 DeepSWE 评测中的 46.2 有大幅提升。
对从业者而言,吸引力在于以远低于 Opus 级模型的成本运行编码任务。
有的对比将 Flash 定位为在编码与自动化智能体方面“强劲”,且成本显著低于 GLM-5.3;而 DeepSWE 相比 GLM-5.2 的跃升也表明,这些编码提升并非仅限于某个基准。
您可以在一次请求中输入整个代码库、长文档,或多文件的智能体追踪。
GLM-5.3-Flash 支持 100 万 token 的上下文窗口,与 GLM-5.3、GPT-5.6 Terra 及 Claude Sonnet 5 的 100 万窗口相当。
不过,社区有反馈称在超过约 70 万 token 的极端长度下会出现注意力“漂移”,这在多数大上下文窗口模型中都较为常见。
据报道,在几十万 token 范围内回忆表现良好,但不要指望在窗口最远端仍能做到完美检索。
您可以通过函数调用和严格的 JSON 架构将 GLM-5.3-Flash 接入智能体框架。该模型在 Toolathlon 上得分 78.4,在 AutomationBench 上得分 48.8,后者较 GLM-5.2 的 26.2 大幅提升。
需要留意的一点:不同服务商的支持情况不一。
有些网关标注不支持结构化输出,且不同托管服务商的系统提示处理方式也不同,因此您可能需要为不同端点调整工具架构与 JSON 模式。
您可以将图像与文本一同输入,用于读图、文档分析与视觉推理。
GLM-5.3-Flash 在 CharXiv-R 上得分 89.4%,在 MMVU 上得分 80.5,在 Chartography 上得分 78.0,显示其在图表与视觉文档处理上的扎实表现。
多模态是原生支持;不过与工具调用类似,具体能力呈现取决于您使用的服务商。仅通过 Hugging Face 拉取的裸接口,未必能暴露与托管 API 相同的全部功能面。
在 Artificial Analysis Intelligence Index v4.1.1 上,GLM-5.3-Flash 得分 57,按折扣计每个任务成本 0.045 美元。Z.ai 表示此前达到这一智能水平的成本大致高出十倍。
下方六项基准评测将 Flash 与 GLM-5.2、DeepSeek-V4-Vision-Exp、Claude Opus 4.8、GPT-5.6 Terra、Gemini 3.7 Flash 进行比较。
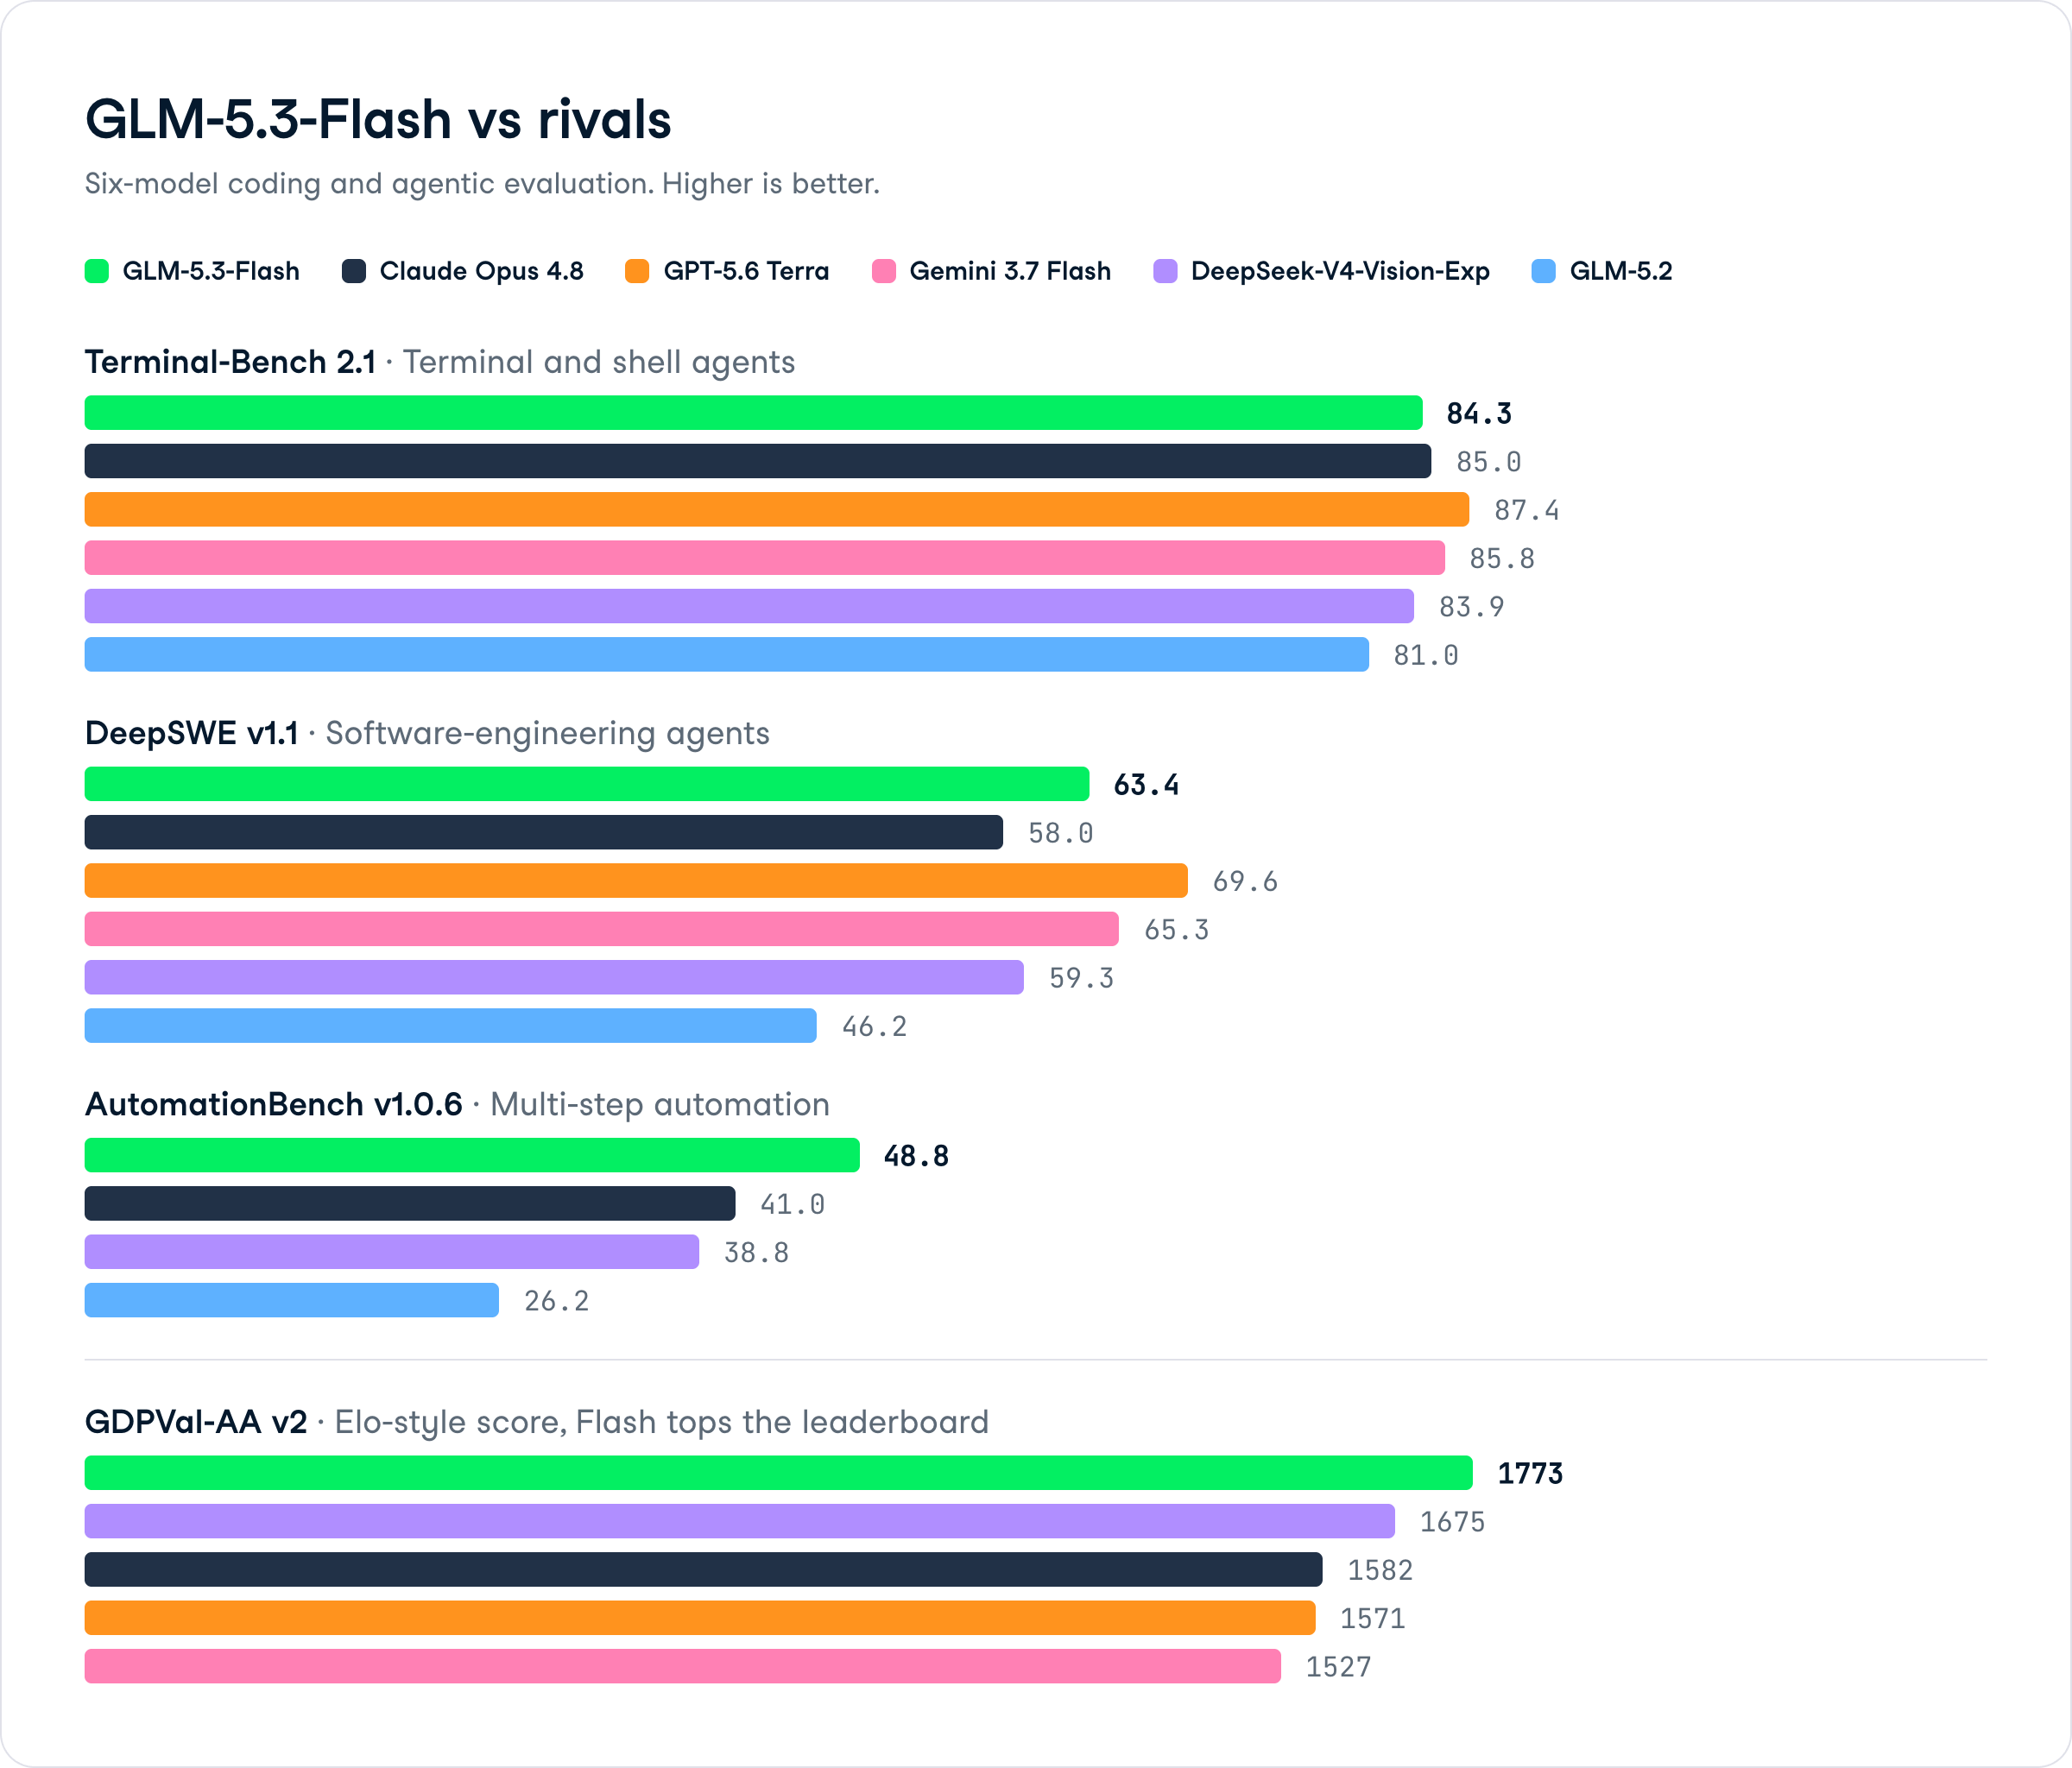
在该软件工程智能体基准上,GLM-5.3-Flash 得分 63.4,领先 Claude Opus 4.8(58.0)与 DeepSeek-V4-Vision-Exp(59.3),并较 GLM-5.2 的 46.2 有显著提升。
它落后于 GPT-5.6 Terra(69.6)与 Gemini 3.7 Flash(65.3),但以 Flash 成本击败 Claude 是这里的实用看点。
GLM-5.3-Flash 在多步自动化流程上得分 48.8,这是其相较 Claude Opus 4.8(41.0)与 DeepSeek-V4-Vision-Exp(38.8)优势最大的一个基准。
GLM-5.2 得分为 26.2,因此这也是代际提升最为明显的一项。
在该通用开发与编程评测中,Flash 以 1773 位居榜首,领先 DeepSeek-V4-Vision-Exp(1675)、Claude Opus 4.8(1582)、GPT-5.6 Terra(1571)与 Gemini 3.7 Flash(1527)。
Flash 在终端与 shell 智能体任务上得分 84.3,略低于 Claude Opus 4.8(85.0)与 Gemini 3.7 Flash(85.8),落后 GPT-5.6 Terra(87.4)。但略胜 GLM-5.2(81.0)与 DeepSeek-V4-Vision-Exp(83.9)。竞争力强,但并非统治级。
GLM-5.3-Flash 可通过 Z.ai 的 API 使用,也可经由多家第三方网关接入,包括 Baseten、Deep Infra、Venice AI 与 Requesty。
公开检查点 zai-org/GLM-5.3-Flash 已在 Hugging Face 上,便于自托管。
Z.ai 官方基准价与限时促销如下:
Apidog 报告的综合、用量加权价格约为每 100 万 tokens 0.10 美元,而 GLM-5.3 约为 0.90 美元。
第三方网关定价各异:EmpirioLabs 为输入 0.07 美元 / 输出 0.25 美元,Venice AI 为 0.09 / 0.31,美金,Requesty 为 0.14 / 0.45 美元,并注明至 2026 年 9 月 9 日的 55% 折扣促销。
限制在于吞吐与硬件。
Flash 的服务速度约为 49 tokens/秒,而 GLM-5.3 约为 86;Artificial Analysis 在速度上给出 2/4 评分。
自托管也并不轻量:仅 FP8 检查点的权重就约 306 GiB,还未计入 KV 缓存与运行时,因此需要多块大显存 GPU(如 >4×80 GiB 等级),而非单卡即可。
两者间的选择主要取决于成本、智能指数与吞吐之间的权衡。下表概括了取舍点。
| 属性 | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| 智能指数(Artificial Analysis) | 57 | 60 |
| 综合价格 / 100 万 tokens | ~$0.10 | ~$0.90 |
| 输出速度 | ~49 tokens/sec | ~86 tokens/sec |
| 首 token 延迟 | ~1.52 s | ~1.57 s |
| Terminal-Bench 2.1 | 84.3 | 注记中未提供 |
| 上下文窗口 | 1M | 1M |
当每 token 成本是硬约束,且工作以编码或智能体为主时,选 Flash。当您需要更高的智能指数与约两倍吞吐时,选 GLM-5.3。
两者均于 2026 年 8 月 26 日发布,瞄准相同的预算智能体档位。GLM-5.3-Flash 在两者直接共享的一项基准(DeepSWE v1.1:63.4 vs 58.7)上略占上风,但两款模型的设计差异较大,选择更取决于您的具体工作负载,而非单一分数。
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| 架构 | 总 320B / 激活 18B | 总 125B / 激活 6B |
| 原生上下文 | 100 万 tokens | 262K(配合 YaRN 可到 100 万) |
| DeepSWE v1.1 | 63.4 | 58.7 |
| 输入价格 | ~$0.075/100 万(促销) | $0.16/100 万 |
| 多模态 | 是(原生) | 是(原生) |
GLM-5.3-Flash 每个 token 激活的参数量是对方的三倍,这可能解释了其在 DeepSWE 与 Terminal-Bench 2.1(84.3)上的领先。
Qwen3.8-Flash-Next 则在 SWE-bench Pro(62.5)以及 CoWorkBench(73.9)、JobBench(55.7)等办公与智能体基准上有更强的报告成绩,而 GLM 未公布可比数据。
在价格上,GLM 在促销期更便宜;在参数效率上,Qwen 以更小的激活规模取得更高效率;在自托管上,Qwen 的更小检查点显著更容易本地运行。
若您优先关注编码智能体与原始智能体吞吐,GLM-5.3-Flash 在可直接对比的项目上数据更强。若您的工作流偏重办公、多模态,或需要更小的本地自托管检查点,建议优先测试 Qwen3.8-Flash-Next。
完整解读请参阅我们的 Qwen3.8-Flash-Next 全面指南。
GLM-5.3-Flash 体现了 Z.ai 对预算智能体市场的明确押注:在编码评测上逼近 Opus 4.8 与 GPT-5.6 Terra,一举在价格上以数量级优势压制。
在 Terminal-Bench 2.1 拿到 84.3 分,综合每 100 万 tokens 约 0.10 美元,是其核心卖点;对于高频编码与自动化,这个组合很有吸引力。
限制主要在速度与基础设施。
约 49 tokens/秒的速度并不适合对时延敏感的流式场景;约 306 GiB 的 FP8 检查点也不利于随手本地部署。r/opencodeCLI 的早期预览用户曾反映高负载下的排队与冷启动偏慢,不过正式 GA 后很可能已有改进。
我的看法是:若每 token 成本是您的刚性约束,且工作以编码或智能体为主,在做出决定前,值得将 GLM-5.3-Flash 与 GPT-5.6 Terra、Claude Opus 4.8 并行测试。
若您需要额外 3 分的智能指数与更高吞吐,完整体的 GLM-5.3 自有其价值。同日还有 Qwen3.8-Flash-Next 上线,当前的预算档确实值得多做对比。
若您想更熟练地使用此类模型,建议先学习我们的 AI Fundamentals 技能路径 夯实基础,再参考 本地运行 MoE Flash 模型 的教程进行动手实践。
热门 DataCamp 课程
课程
课程
课程