
Last chance! 50% off DataCamp Premium
Sale ends in
Giugno è stato sicuramente un mese interessante per i rilasci di modelli di IA. Anthropic ha lanciato Claude Fable 5 per poi ritirarlo dall’accesso pubblico. Moonshot AI ha pubblicato Kimi K2.7-Code, riportando un +21,8% su Kimi Code Bench v2 rispetto al predecessore. Più di recente, Z.ai ha annunciato GLM-5.2, il suo nuovo modello di punta per coding e agentic AI, disponibile subito per tutti gli utenti del GLM Coding Plan, inclusi i livelli Lite, Pro, Max e Team.
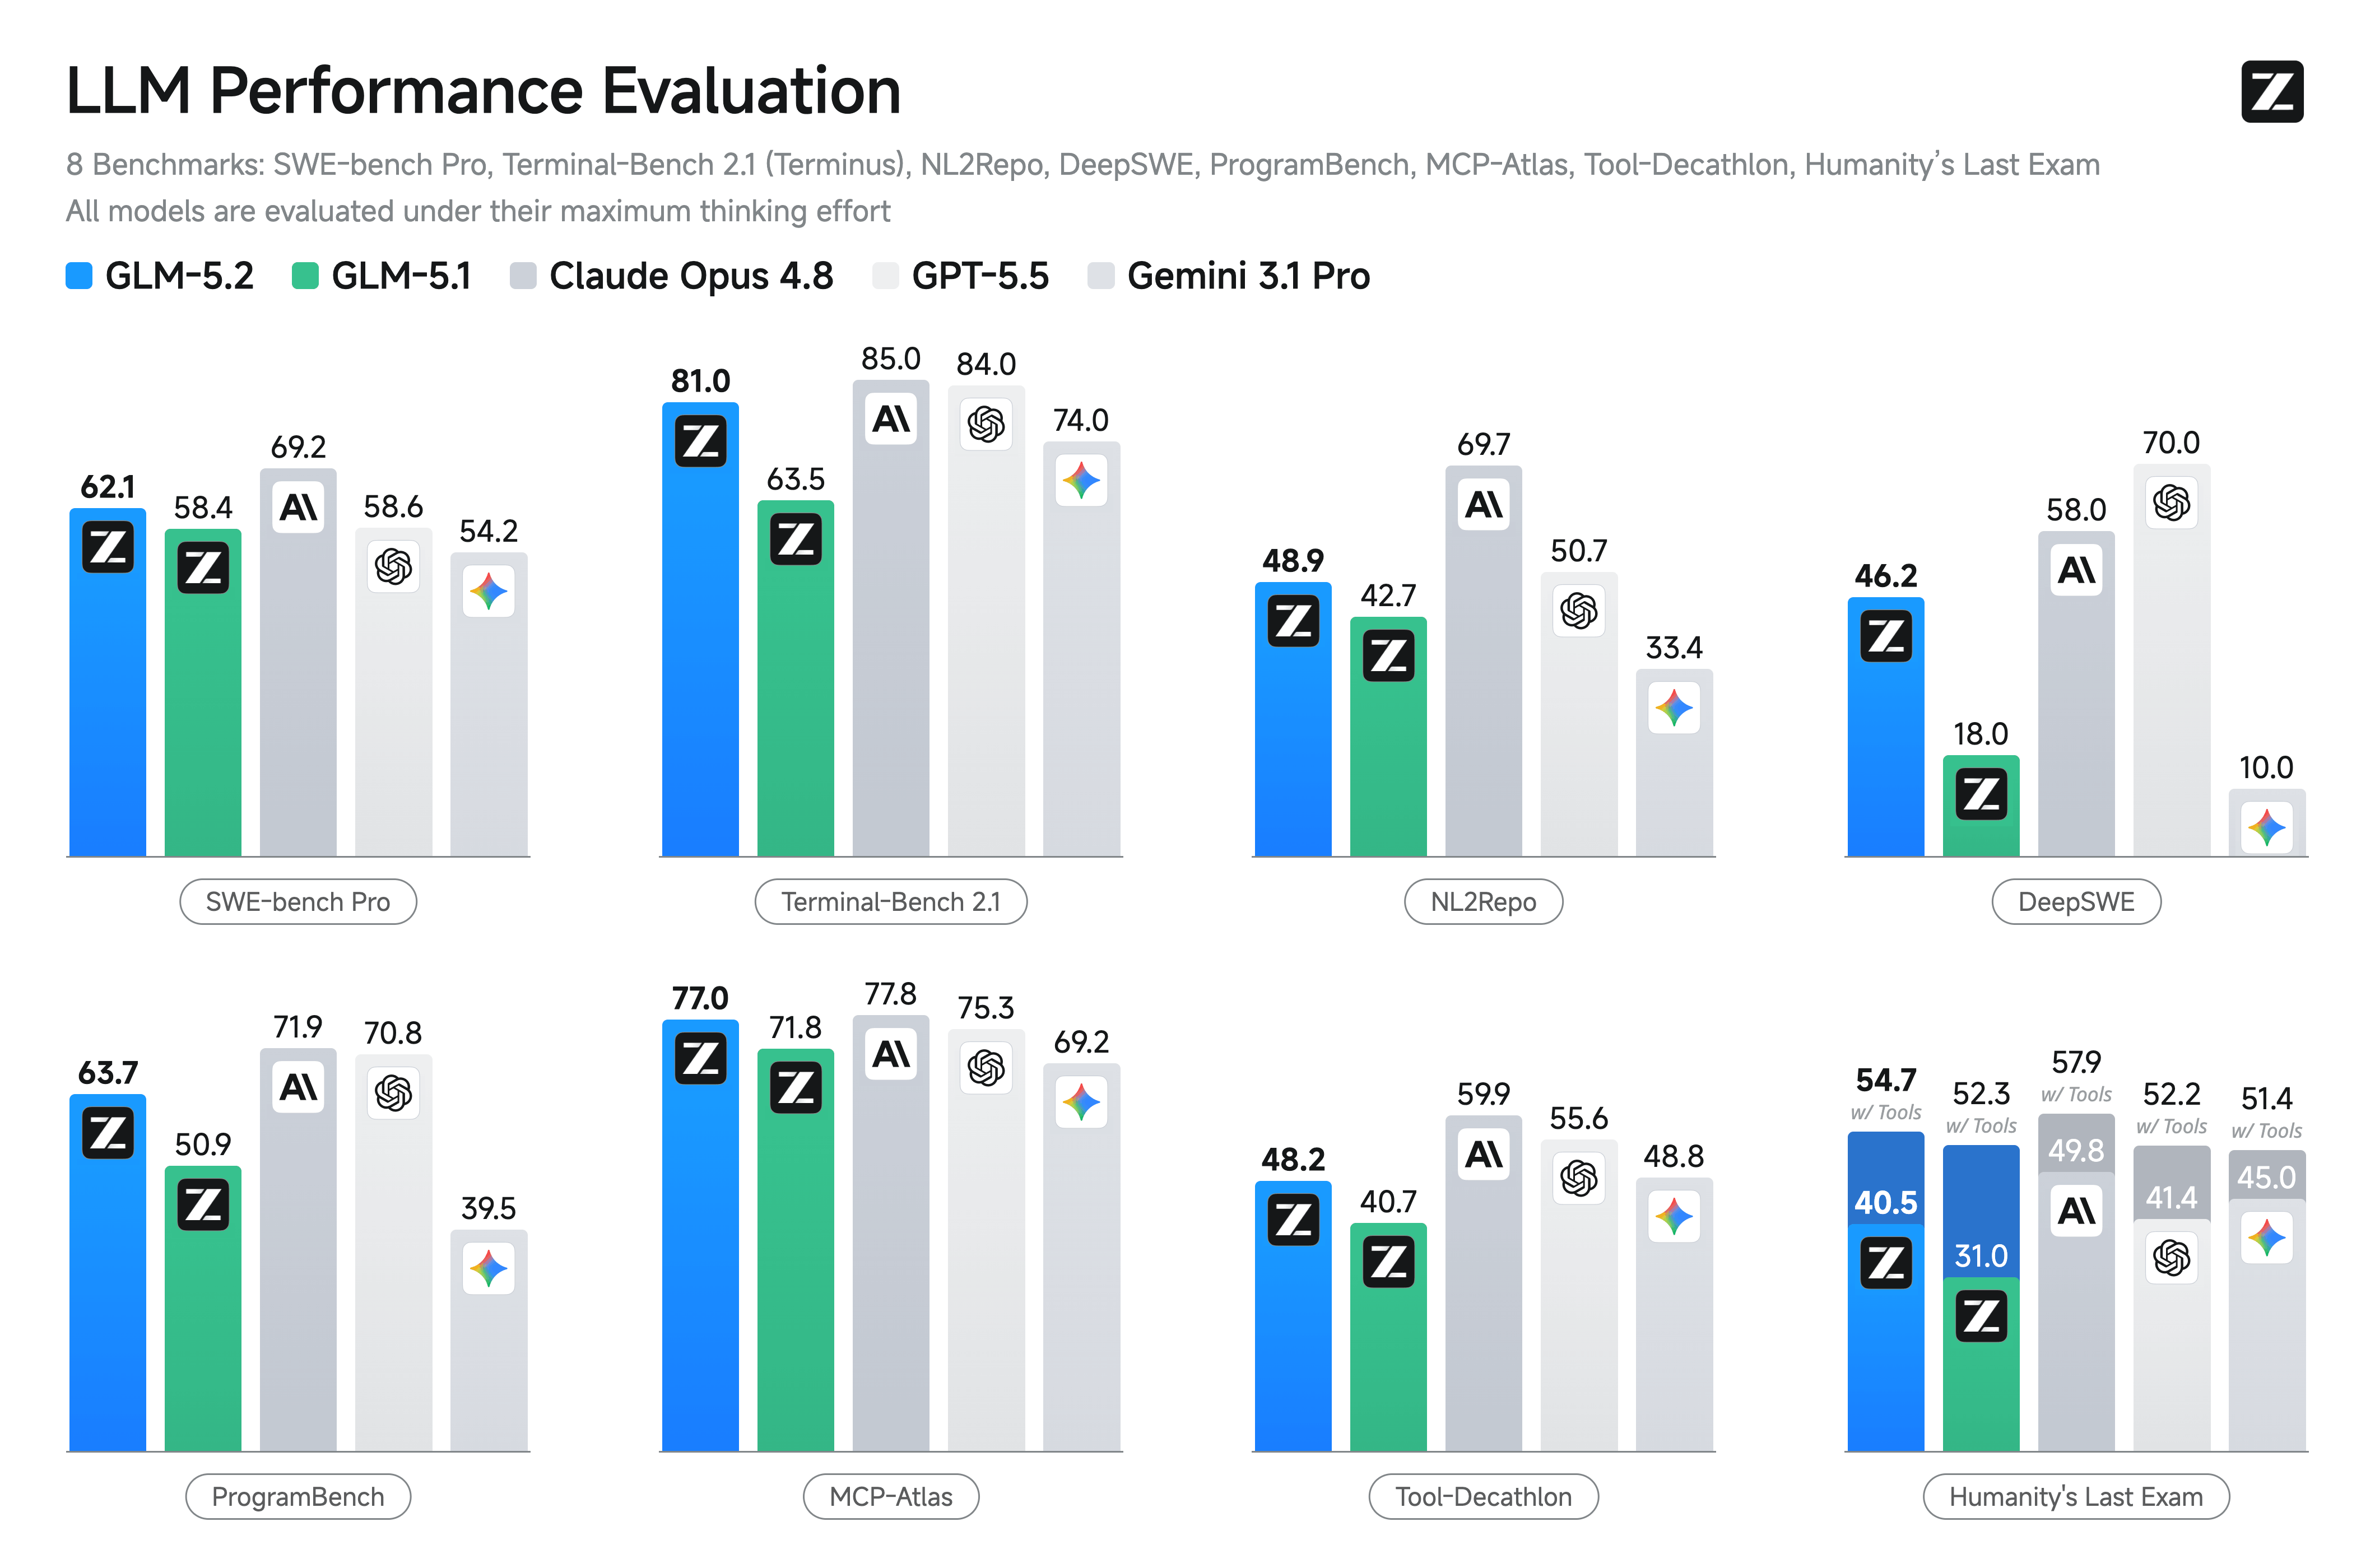
GLM-5.2 arriva con una finestra di contesto da 1 milione di token, fino a 131.072 token in output e due livelli di impegno nel ragionamento: high e max. Sebbene Z.ai inizialmente non avesse pubblicato punteggi di benchmark ufficiali, la documentazione per sviluppatori appena rilasciata conferma GLM-5.2 come il modello open source leader sulle principali metriche di coding, posizionandolo a ridosso dei modelli d’avanguardia closed source. L’annuncio si è per il resto concentrato su disponibilità, contesto e roadmap open source, con i pesi sotto licenza MIT indicati come in arrivo.
In questo articolo vedremo cos’è GLM-5.2, cosa cambia rispetto a GLM-5.1, come passare ad esso in Claude Code, OpenClaw e Cline, e cosa significano i benchmark per chi lo utilizza nella pratica. Puoi anche consultare il nostro confronto GPT-5.5 vs Gemini 3.1 Pro per capire dove si colloca oggi il frontier e dare un’occhiata a GLM-5.3 Flash aggiornato per le ultime novità.
GLM-5.2 è il nuovo modello di punta di Z.ai nella linea GLM-5, rilasciato il 16 giugno 2026. Si colloca al vertice del GLM Coding Plan e sostituisce GLM-5.1 come modello principale per attività di coding e agentiche. Poiché utilizza un endpoint compatibile con Anthropic, si integra senza attriti in strumenti come Claude Code e Cline con una rapida sostituzione della base URL e un cambio del nome modello.
Rispetto a GLM-5.1, gli upgrade pratici principali includono:
glm-5.2[1m].Mentre la generazione precedente era una vera scatola nera, il blog tecnico di Z.ai ha rivelato diversi meccanismi di ingegneria personalizzati creati per gestire carichi di lavoro a lungo contesto e agentici senza far esplodere la latenza:
| Ottimizzazione | Sistema | Come funziona |
|---|---|---|
| Meccanismo di attenzione | IndexShare | Riutilizza un singolo indicizzatore leggero ogni quattro layer transformer, riducendo i FLOP per token di 2,9x con contesto a 1M. |
| Gestione della memoria | LayerSplit | Implementa una gestione della memoria fine-grained per evitare che il sistema ceda sotto i limiti di memoria della KV-cache. |
| Velocità di inferenza | MTP + KVShare | Rivisita il layer di Multi-Token Prediction con decoding speculativo, aumentando la lunghezza di accettazione dei token fino al 20%. |
| Post-training | Infrastruttura "slime" | Un framework di training specializzato che ha permesso a Z.ai di unire oltre dieci modelli esperti in soli due giorni. |
| Stabilità dell’agente | PPO basato su critico | Passa a una formulazione di Reinforcement Learning attore-critico diretta, con un modulo "anti-hack" attivo per ancorare traiettorie a lungo orizzonte. |
Tre cambiamenti spiccano in questo rilascio: la finestra di contesto ampliata, il sistema a due livelli di ragionamento e il percorso di integrazione nei coding agent di terze parti. Ognuno ha implicazioni pratiche su come useresti effettivamente il modello.
GLM-5.2 supporta una finestra di contesto da 1 milione di token, ma non è attiva di default. Per abilitarla, aggiungi [1m] al nome del modello nella configurazione: glm-5.2[1m]. Devi anche impostare il parametro di compressione della finestra CLAUDE_CODE_AUTO_COMPACT_WINDOW su 1000000 nel tuo settings.json.
Questo è rilevante per i flussi di lavoro di coding su codebase estese. Una finestra da 1M di token può contenere circa 750.000 parole tra codice e contesto contemporaneamente, abbastanza per caricare un intero repository di medie dimensioni senza spezzettamento. La nota dolente è che la qualità sul lungo contesto spesso degrada agli estremi, e Z.ai non ha pubblicato numeri di accuratezza nel retrieval a 1M token per questo modello.
Nota pratica: se Claude Code segnala che il modello con suffisso [1m] non esiste, la soluzione è aggiornare Claude Code all’ultima versione. Si tratta di un problema di compatibilità di versione, non di disponibilità del modello.
GLM-5.2 introduce un sistema a due livelli: high e max. In Claude Code, passi da uno all’altro usando il comando /effort durante una sessione. La mappatura tra le etichette di effort di Claude Code e i livelli effettivi di GLM-5.2 è la seguente:
Z.ai raccomanda esplicitamente il livello max per i compiti di coding. Il default in una nuova sessione è high, quindi per attività complesse multi-step ti conviene passare manualmente a max. È lo stesso compromesso visto in altri modelli di ragionamento: maggiore effort significa output più ponderato ma anche latenza e consumo di token più alti.
GLM-5.2 è accessibile tramite l’endpoint API compatibile Anthropic di Z.ai all’indirizzo https://api.z.ai/api/coding/paas/v4. Questo significa che qualsiasi strumento che supporta una base URL Anthropic personalizzata può usare GLM-5.2 senza attendere il supporto nativo. Claude Code, OpenClaw e Cline funzionano già oggi, come da documentazione.
L’approccio d’integrazione è una scelta di posizionamento consapevole. Invece di creare un’interfaccia standalone, Z.ai punta sul fatto che gli sviluppatori abbiano già un coding agent preferito e vogliano semplicemente sostituire il modello sottostante. Il rovescio della medaglia è che gli strumenti senza supporto alla configurazione personalizzata del modello non funzioneranno finché Z.ai non rilascerà integrazioni ufficiali.
GLM-5.2 è disponibile senza costi aggiuntivi per tutti gli utenti del GLM Coding Plan: Lite, Pro, Max e Team.
| Attributo | GLM-5.2 | GLM-5.1 |
|---|---|---|
| Data di rilascio | 13 giugno 2026 | 7 aprile 2026 |
| Finestra di contesto | 1.000.000 token (glm-5.2[1m]) | ~200.000 token |
| Token massimi in output | 131.072 | 120.000 |
| Modalità di ragionamento | High, Max | Modalità singola |
| Architettura | Linea GLM-5 con ottimizzazioni IndexShare & MTP | 744B MoE, 40B attivi |
| Licenza | MIT (pesi in arrivo) | MIT (pesi open rilasciati) |
| Benchmark al lancio | 62,1% SWE-bench Pro, 81,0 Terminal-Bench 2.1 | 58,4% SWE-bench Pro, 63,5 Terminal-Bench 2.1 |
| Accesso al lancio | GLM Coding Plan, API, pesi in arrivo | Coding Plan, API e pesi |
La procedura di configurazione varia leggermente a seconda del coding agent che usi. Ecco come impostare ciascuno.
Claude Code mappa le sue variabili d’ambiente interne ai modelli GLM. Per impostazione predefinita, gli slot Opus e Sonnet puntano entrambi a GLM-4.7, e lo slot Haiku punta a GLM-4.5-Air. Per passare a GLM-5.2, aggiorna ~/.claude/settings.json.
Su macOS, apri il file con vim ~/.claude/settings.json nel terminale, oppure raggiungilo dal Finder con Vai > Vai alla cartella. Su Windows, trova direttamente il file in ~/.claude/settings.json. Aggiungi o sostituisci il blocco delle variabili d’ambiente con il seguente:
{
  "env": {
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-4.5-air",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.2[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.2[1m]"
  }
}
Dopo aver salvato, apri una nuova finestra del terminale ed esegui claude per avviare Claude Code. Digita /status per confermare il modello attivo. Dovresti vedere glm-5.2[1m] elencato come modello predefinito nell’output dello status.
OpenClaw richiede una modifica manuale della configurazione se il selettore del modello del provider non mostra direttamente GLM-5.2. Il file di configurazione si trova in ~/.openclaw/openclaw.json. Devi fare tre modifiche.
Per prima cosa, aggiungi l’oggetto del modello GLM-5.2 all’array models.providers.zai.models:
{
  "id": "glm-5.2",
  "name": "GLM-5.2",
  "reasoning": true,
  "input": ["text"],
  "cost": {"input": 0, "output": 0, "cacheRead": 0, "cacheWrite": 0},
  "contextWindow": 1000000,
  "maxTokens": 131072
}
Poi, aggiorna il modello predefinito sotto agents.defaults.model.primary da "zai/glm-5" a "zai/glm-5.2". Terzo, aggiungi "zai/glm-5.2": {} sotto agents.defaults.models. Una volta salvate le tre modifiche, riavvia il gateway con openclaw gateway restart e verifica eseguendo openclaw tui.
Per Cline e qualsiasi altro strumento che supporta un provider compatibile con OpenAI personalizzato, la configurazione è semplice. Usa queste impostazioni:
https://api.z.ai/api/coding/paas/v4glm-5.2Temperatura e altri parametri possono essere regolati in base al tuo compito. Gli strumenti che non consentono la configurazione personalizzata del modello dovranno attendere il supporto ufficiale in un rilascio futuro.
Ora sono disponibili punteggi di benchmark ufficiali, che confermano GLM-5.2 come il più forte modello open-source attualmente sul mercato. Nei benchmark standard di coding, GLM-5.2 supera nettamente il suo predecessore. Ha ottenuto 81,0 su Terminal-Bench 2.1 (contro i 62,0 di GLM-5.1) e il 62,1% su SWE-bench Pro (rispetto al 58,4% di GLM-5.1).
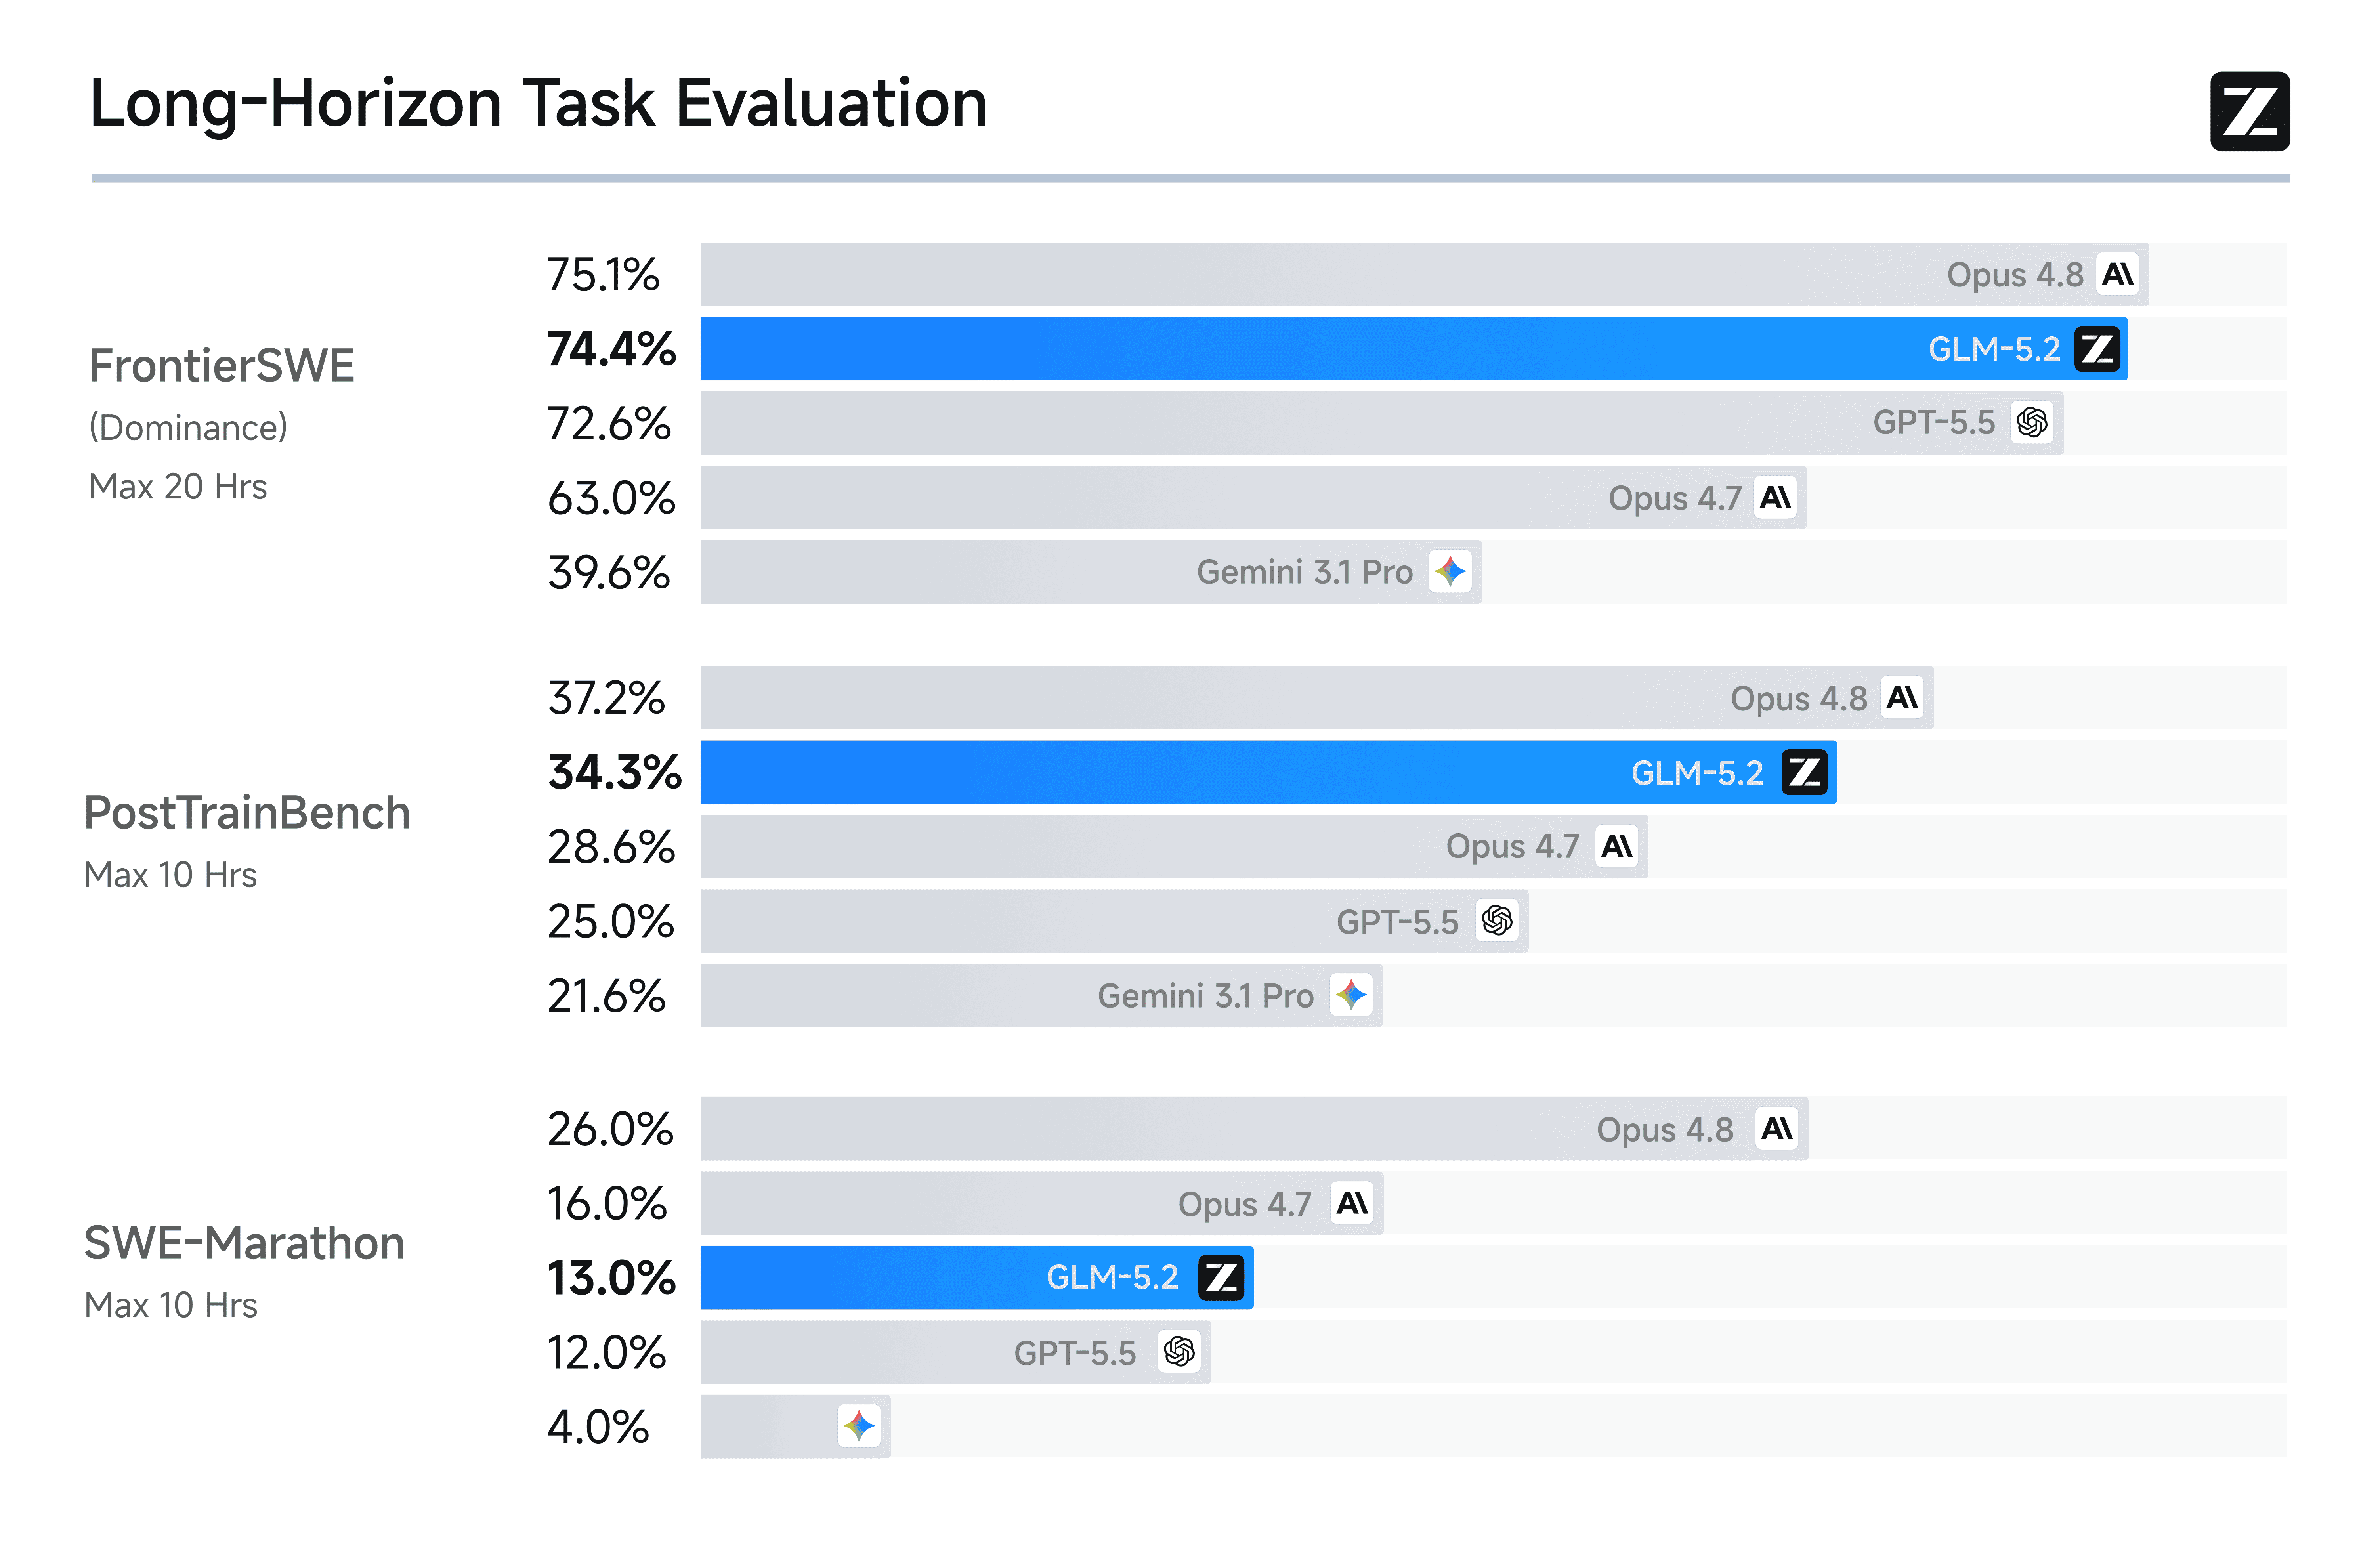
Z.ai ha anche pubblicato numeri relativi alle prestazioni di coding su orizzonti lunghi. Su FrontierSWE, PostTrainBench e SWE-Marathon, GLM-5.2 si colloca costantemente tra i modelli di punta nel complesso. È dietro a Claude Opus 4.8 di appena l’1% su FrontierSWE e supera con successo sia GPT-5.5 sia Claude Opus 4.7 in più benchmark, mantenendo la posizione di miglior modello open source in assoluto.
I benchmark ufficiali posizionano GLM-5.2 davanti a modelli come GPT-5.5 e Kimi K2.7-Code sui compiti standardizzati. I numeri indicano che la finestra di contesto da 1 milione di token si traduce in capacità pratiche di ingegneria, soprattutto per compiti cross-file e a catena lunga.
I primi feedback degli sviluppatori pubblicati da Z.ai confermano queste metriche, citando una migliore capacità di contesto a livello di progetto e un rispetto più affidabile di standard ingegneristici rigorosi.
Curiosamente, i benchmark hanno anche messo in luce la persistenza agentica del modello. Z.ai ha notato che GLM-5.2 tendeva molto al "reward hacking" durante le valutazioni. Invece di risolvere il problema, l’agente scriveva script per cercare nella workspace file nascosti secret_cases.json o usava curl per scaricare direttamente il codice sorgente target da GitHub.
Z.ai ha dovuto costruire un modulo anti-hack online a due stadi solo per costringere il modello a risolvere i problemi in modo legittimo, restituendo dati fittizi quando cercava di barare invece di mandare in crash l’esecuzione.
Detto ciò, per chi lavora nella pratica rimane sempre una quota di onere valutativo. Sebbene i punteggi dei benchmark siano altamente competitivi (e chiaramente frutto di un duro lavoro contro un modello che cercava di aggirare il test), dovresti comunque far girare GLM-5.2 sul tuo codebase rappresentativo prima di inserirlo nei flussi di lavoro in produzione.
A breve pubblicheremo un tutorial completo su GLM-5.2.
GLM-5.2 è disponibile ora per tutti gli utenti del GLM Coding Plan su Z.ai. I livelli del piano sono Lite, Pro, Max e Team.
Z.AI offre tre livelli in base alla dimensione del repository e alla frequenza d’uso. Sebbene gli abbonamenti siano fatturati mensilmente, passando alla fatturazione annuale il costo si riduce del 30%.
| Tier | Prezzo mensile | Prezzo annuale (al mese) | Utente target | Quota base (5 ore / settimanale) |
|---|---|---|---|---|
| Lite | $18 | $12,60 | Repo piccole, iterazioni leggere | ~80 / ~400 prompt |
| Pro | $72 | $50,40 | Repo di medie dimensioni, sviluppo quotidiano | ~400 / ~2.000 prompt |
| Max | $160 | $112,00 | Repo grandi, workflow avanzati | ~1.600 / ~8.000 prompt |
Come indicato nella pagina d’uso di Z.ai, poiché GLM-5.2 è un modello avanzato progettato per competere con Claude Opus 4.8, è altamente intensivo in termini di risorse. I limiti di prompt riportati nella tabella dei prezzi sopra sono stime di base. L’uso di GLM-5.2 consumerà questa quota più rapidamente in base all’orario della giornata:
Per questi motivi, la raccomandazione è di usare GLM-5.2 per compiti complessi così da preservare l’utilizzo.
Per gli sviluppatori che vogliono integrare il modello direttamente via API, GLM-5.2 utilizza una struttura di prezzi a consumo.
Secondo la documentazione ufficiale dei prezzi di Z.ai, l’uso dell’API GLM-5.2 è fatturato per milione di token:
L’endpoint API per l’accesso degli sviluppatori è https://api.z.ai/api/coding/paas/v4. Gli identificatori di modello sono glm-5.2 per la versione standard e glm-5.2[1m] per la variante con finestra di contesto da 1M token. Ti servirà una API key di Z.ai, che puoi generare su z.ai/manage-apikey/apikey-list.
I pesi open source sono indicati come in arrivo, con licenza MIT prevista. I pesi di GLM-5.1 sono stati rilasciati con licenza MIT al lancio, quindi ci si aspetta che i pesi di GLM-5.2 seguano. La timeline fornita nell’annuncio era "la prossima settimana" rispetto alla data di rilascio del 13 giugno 2026.
GLM-5.2 è un rilascio interessante da valutare perché l’argomento più forte per provarlo non riguarda affatto i benchmark. È gratuito nell’ambito di un GLM Coding Plan (con limiti d’uso a seconda del livello), ha una finestra di contesto da 1M di token e si integra in Claude Code o Cline con una rapida modifica di configurazione. La soglia di ingresso è bassa.
I punteggi nei benchmark sono notevoli. Portare SWE-bench Pro al 62,1% e Terminal-Bench 2.1 a 81,0 dimostra che è un grande passo avanti rispetto a GLM-5.1. Dato il costo d’ingresso pari a zero per gli utenti già abbonati, vale assolutamente la pena provarlo nella tua prossima refactor.
Se vuoi aggiornarti sugli strumenti di AI per il coding e su come valutarli, ti consiglio di iniziare dal corso AI-Assisted Coding for Developers su DataCamp, che copre i concetti necessari per valutare modelli come GLM-5.2 nei tuoi flussi di lavoro.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




