今天,Anthropic 面向所有人发布了 Fable 5.2,并向通过审核的机构发布了 Mythos 5.2。它们基于同一底层模型,但 Fable 版本额外加入了网络安全和生物学方面的安全防护。
重点变化包括:
- 更低的价格,
- 更快的输出,
- 以及在 Anthropic 最难的基准上有大幅提升。
更具体地说,Fable 5.2 比 Fable 5.1 便宜 20%,输出速度最高快 30%,并且在 Anthropic 的基准表大多数项目上超过了 GPT-6 Astra 和 Gemini 4 Carbon。
本文将介绍 Fable 5.2 和 Mythos 5.2 的新特性、它们在基准测试中的表现、定价,以及如何判断是否应该选择它们而非 Claude Opus 5.5。
什么是 Claude Fable 5.2?
Claude Fable 5.2 是 Anthropic 最强大的可普遍使用模型。它专为冗长、复杂的技术工作而打造:大型代码库迁移、多天运行的智能体任务、科研难题和工程设计。
Fable 5.2 也可以与更小的模型协作,既可作为顾问在难题上提供建议,也可作为编排器将更简单的子任务下发给它们。
Fable 5.2 延续了其前代的 100 万 token 上下文窗口和 128K 最大输出,知识截止时间为 2026 年 6 月。
什么是 Claude Mythos 5.2?
Claude Mythos 5.2 与 Fable 5.2 是同一模型,但移除了会阻止大多数网络安全工作和研究级生物学工作的防护。事实上,Mythos 5.2 是 Anthropic 在网络安全工程方面能力最强的模型。由于这些能力具有双重用途,Anthropic 仅通过其网络安全验证计划和生命科学验证计划向通过审核的组织提供 Mythos 5.2。
Claude Fable 5.2 有哪些新变化?
Fable 自 6 月(Anthropic 发布 Fable 5)以来才推出不久。此后有两个小版本更新,分别是 9 月的 Fable 5.1 和现在的 Fable 5.2,两者都没有在功能上增加太多。主要是让模型更便宜、更快、更强,且性能提升并不小:例如,Fable 5.2 在 Remote Labor Index 上的得分就超过了 Fable 5.1 的两倍。
两次发布之间更大的差异在于允许的使用方式。Fable 5.1 收紧了网络安全防护,并开始允许模型用于发现软件漏洞,但仍不允许为其编写利用程序,同时还与发布同步推出了企业前沿防护(Enterprise Frontier Safeguards),可将您的数据保存在您自己的云中。Fable 5.2 的防护变更较小:拦截的请求更少,但禁止的任务类型仍然相同。
Anthropic 建议的使用方式(例如让 Fable 5.2 为更小的 Claude 模型提供建议)也并不新鲜,因为 Anthropic 的 advisor 工具已经支持 Fable 5 和 5.1。发布演示(如从空文件夹构建操作系统)展示的是更强的模型完成更难的任务,而不是可以打开的新功能。
不过,如果要指出确实算“新增”的内容,我会提到以下几点:
更低的价格
Fable 5.2 的定价为每百万输入 token 8 美元、每百万输出 token 40 美元,比 Fable 5.1 的 10/50 美元低 20%。同样 20% 的降幅也适用于缓存读取(0.20 美元)、缓存写入和批处理。完整明细见下文定价部分。
更快的输出,以及 Fable 的极速模式
输出速度最高比 Fable 5.1 快 30%,在长时间运行的智能体任务中累积效应明显。Fable 现在也支持极速模式,最高可将输出速度提升至 2.5 倍,价格翻倍(16/80 美元)。
更低投入下的更好结果
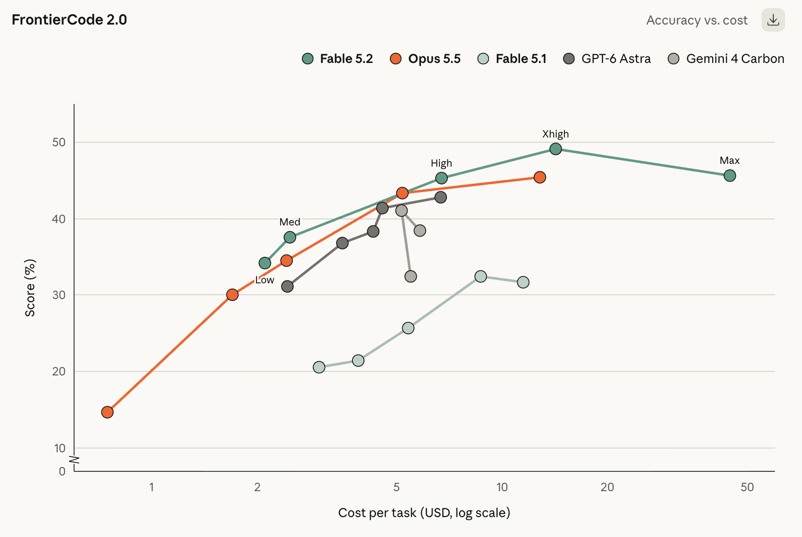
这项变化最可能影响您的账单。在高投入下,Fable 5.2 在 FrontierCode 2.0 上得分 45.3%,大致与 Opus 5.5 的最佳成绩相当,但每个任务的成本约为后者的一半。在低投入下,它在 Humanity's Last Exam 上追平了 Opus 5.5 的最高分,而每个任务的成本不到后者的十分之一。我的建议:如果您从 Opus 5.5 迁移上来,先用较低投入级别来运行 Fable 5.2。
更少的拦截请求
Fable 5.2 的安全拦截大约比 Fable 5.1 少 55%(网络安全少约 60%,生物学少约 40%)。如果 Fable 5.1 的拒绝频繁阻碍您的工作,这会是个大改进,但被拦截的类别没有变化:渗透测试、利用程序生成,以及大多数研究级生物学任务仍会交由旧版 Claude 模型处理。
Claude Fable 5.2 在基准测试中的表现如何?
以下为主要结果。它们都来自 Anthropic 的发布表格,因此更像是 Anthropic 对该模型的论据,而非独立结果。Claude 的分数是在开启安全防护的情况下运行的。除非特别注明,每个模型均显示其可用的最高投入水平。
| 基准 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0(智能体编程) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2(智能体编程) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench(业务流程) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1(计算机使用) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim(机器人) | 64.9% | 27.6% | 39.4% | 29.8% | 未报告 |
| AA-Briefcase v1.1(知识工作) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index(知识工作) | 41.3% | 17.9% | 21.3% | 20.8% | 未报告 |
| Humanity's Last Exam(配合工具) | 74.2% | 65.6% | 67.7% | 57.2% | 未报告 |
| WANDR(智能体搜索) | 82.1% | 68.7% | 72.3% | 未报告 | 未报告 |
| Chartography(无工具) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
智能体编程
Fable 5.2 在表中的两项编程基准上均领先。在 FrontierCode 2.0 上(衡量开源维护者是否会合并模型的代码改动),它的得分为 49.1%,居表首,且明显高于 Fable 5.1 的 32.4%。在 FrontierSWE v2 上,其得分为 69.9%,领先 GPT-6 Astra(65.5%)和 Opus 5.5(62.3%)。
发布示例也支持这一点:运行早期版本 Fable 5.2 的智能体将一个生产服务从 Python 迁移到了 Rust,启动速度现快约 26 倍。
知识工作与研究
相对提升最大的是 Remote Labor Index(衡量模型完成真实自由职业式项目的水平)。Fable 5.2 得分 41.3%,大约是 Opus 5.5(21.3%)和 GPT-6 Astra(20.8%)的两倍。它还在配合工具的 Humanity's Last Exam(74.2%)和 Terminal-Bench-Science(74.6%,Mythos 5.2 为 75.3%)中领先。
业务自动化是它落后的少数领域之一。在 AutomationBench 上,Gemini 4 Carbon 得分 53.9%,高于 Fable 5.2 的 51.4%,不过 Fable 5.2 仍远超 Fable 5.1(31.4%)。
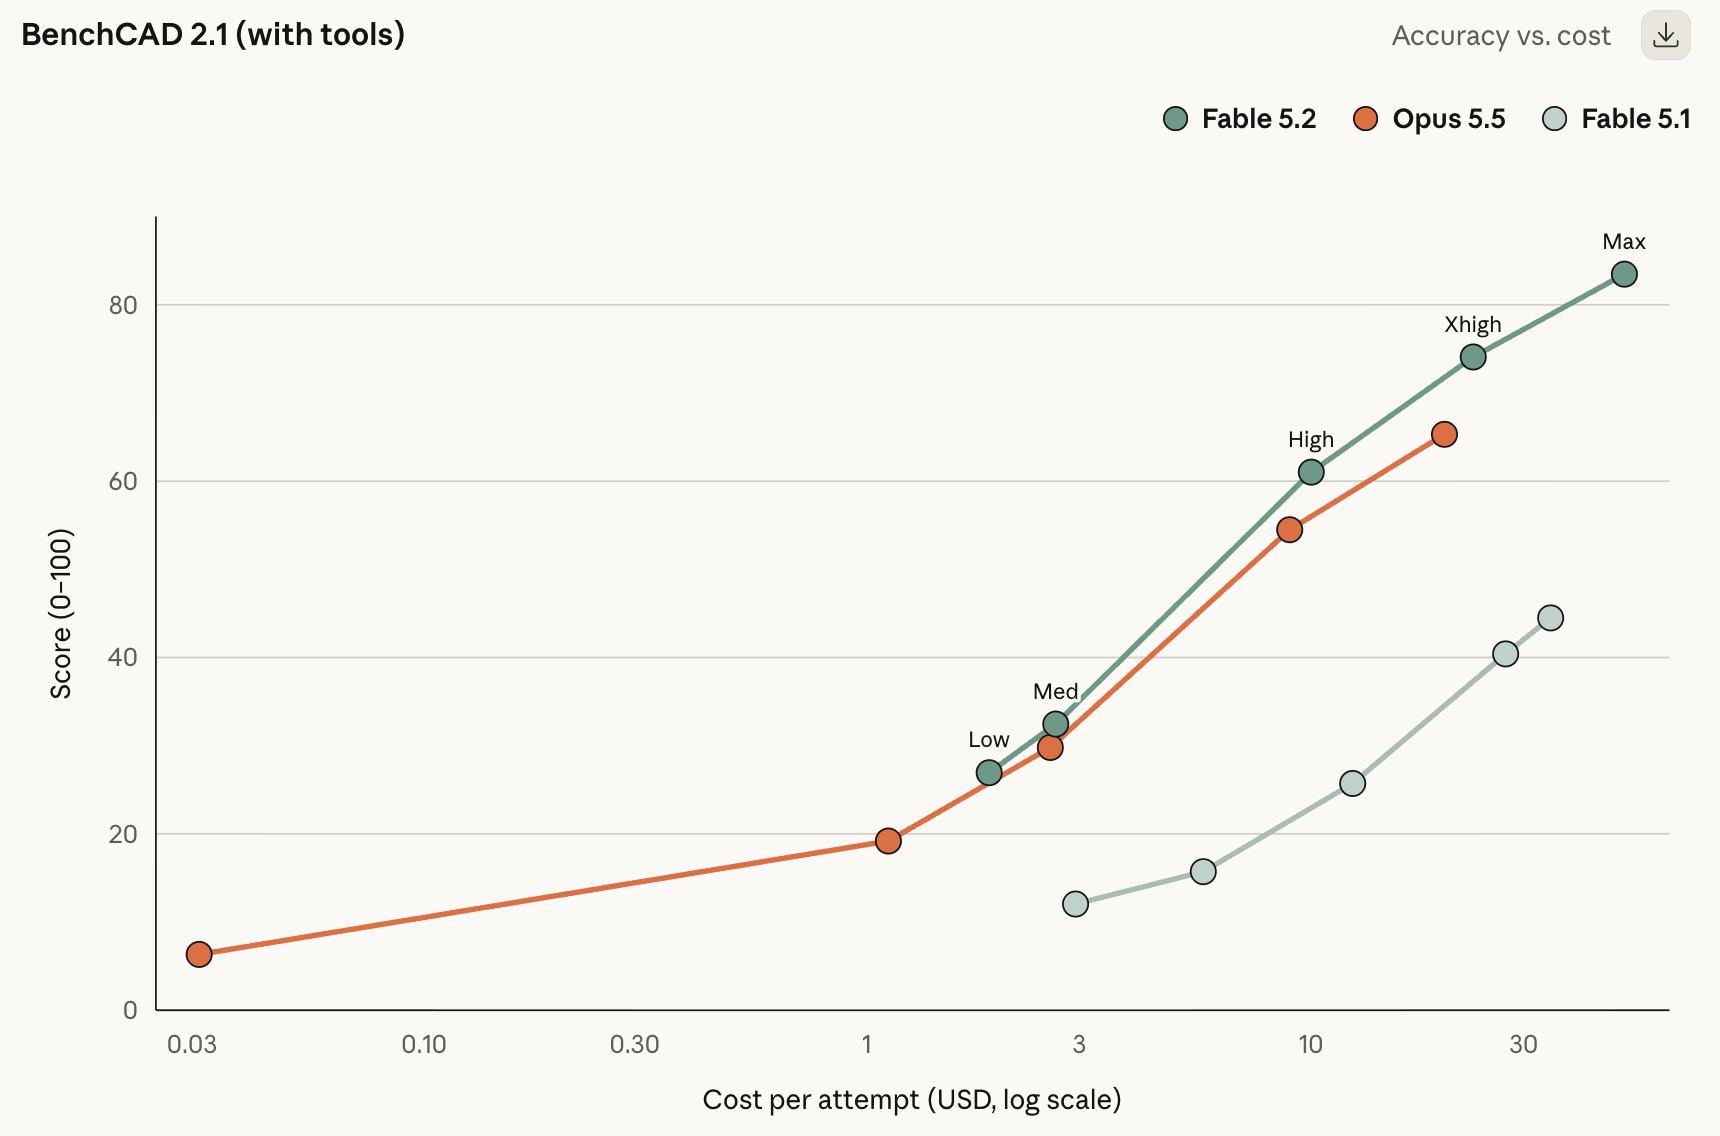
在主表之外,Fable 5.2 在硬件工程基准 BenchCAD 2.1 上得分 83.5,而 Opus 5.5 为 65.3。它还被认为解决了黑洞物理学中的两个开放问题,相关结果以预印本形式发布,供其他物理学家检验。
计算机使用、机器人与视觉
Fable 5.2 在 OSWorld 2.1 上得分 89.3%,领先 Opus 5.5(87.2%)和 GPT-6 Astra(79.5%)。它在机器人的提升是表中最大的一项:RoboDojo Sim 得分 64.9%,是 Fable 5.1 和 GPT-6 Astra 的两倍多。在 Chartography(测试无工具阅读图表)上,它略胜 Gemini 4 Carbon 和 GPT-6 Astra,此前 Fable 5.1 仅为 44.8%,差距较大。
网络安全与生物学(Mythos 5.2)
安全与生物学相关的行对应的是 Mythos 5.2,因为 Fable 5.2 的防护会阻止大多数此类任务。Mythos 5.2 在 CyScenarioBench 上得分 76.3%(Mythos 5.1 为 61.7%)、在 CVE Rediscovery 上为 89.6%(对比 78.3%),并在 24 小时蛋白结合体设计任务上取得 85.1%(对比 79.1%)。这里无法与 OpenAI 的安全模型进行公平对比,因为各实验室运行了各自的 CyScenarioBench 任务。
关于费马大定理,这是怎么回事?
一组 Fable 5.2 智能体在 30 小时内使用 Lean 证明助理形式化了费马大定理的证明。您可能会想:这个定理三十年前就被证明了,还有什么可做的?
定理本身早已是旧闻
费马大定理指出,不存在正整数 a、b、c 使得 an + bn = cn 对任意大于 2 的 n 成立。对于 n = 2,有很多解,例如 32 + 42 = 52(9 + 16 = 25)。但尝试立方时只能得到“擦肩而过”的结果:63 + 83 = 728,刚好比 93 = 729 少 1。
Pierre de Fermat 在 1637 年声称找到了证明,但从未写下来。该问题悬而未决 350 多年,直到 1990 年代中期 Andrew Wiles 在 Richard Taylor 的帮助下完成了证明。
什么是 Lean 形式化
Wiles 的证明超过 100 页,并建立在数十年的高等数论之上,因此能从头到尾核查的人极少。Lean 是一种证明助理:用一种编程语言将证明写成代码,软件会逐步检查每个逻辑步骤,直至数学的基本公理。如果证明能够编译,就视为正确。“形式化”一个定理,就是将人工撰写的证明翻译成这种可被机器检验的形式。
对于费马大定理,这是项巨大的工程,因为证明所依赖的很多数学此前从未用 Lean 写出。数学家 Kevin Buzzard 在 2024 年发起了一个社区项目来完成这项工作。
为何这对 AI 模型有趣
多数 AI 输出由人来评判,或由只测试部分答案的基准来评估。Lean 证明不同:检查器要么接受每一步,要么不接受,因此不存在“细微但错误”的空间。这使其成为一种异常干净的测试,用以检验模型能否将非常长、非常难的项目推进到经验证的完成。
这并非 Claude 的第一次。9 月,Anthropic 发布了首个由计算机核验的完整证明,由数十个智能体运行一个内部研究模型(大致相当于 Fable 5.1)写成。那次尝试耗时 11 天、约 60 亿输出 token,产出 1300 万行 Lean 代码,并部分基于 Buzzard 项目的成果。Fable 5.2 用 30 小时、在人类最少干预下完成了这件事。
需要注意的点
- 这对数学本身没有新增贡献。Buzzard 对 Anthropic 的首次形式化也是这样评价的。
- Fable 5.2 获得了一份中间定理陈述清单,用于跟踪进度。这相当于“要证明什么”的路线图,但不是“如何证明”。
- 我目前还没找到对这份新证明的外部评审,因此 30 小时这个数字以及与 Opus 5.5 的对比暂且视为 Anthropic 的说法。
不过,最能说明问题的是,当 Anthropic 让 Claude Opus 5.5 做同一项工作时发生了什么。
Claude Fable 5.2 与 Claude Opus 5.5 对比
比较两个模型通常意味着阅读基准分数,然后试图推断差异在实践中会是什么样子。这一次,我很赞赏 Anthropic 先讲了一个故事,使得差距更直观。
在相同的 1000 智能体 Lean 设置中,Opus 5.5 在 18 小时内完成了费马大定理证明的 26%,之后几乎没有进展。Fable 5.2 则在 30 小时内完成了全部。要点是:在非常漫长、涉及多智能体的项目上,Opus 5.5 可能会停滞,而 Fable 5.2 仍能推进。
在较短任务上,差距更小。下面是二者的并列比较:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| 价格(每百万 token 的输入 / 输出) | $8 / $40 | $4 / $20 |
| 上下文窗口 / 最大输出 | 1M / 128K | 1M / 128K |
| FrontierCode 2.0(智能体编程) | 49.1% | 45.5% |
| FrontierSWE v2(智能体编程) | 69.9% | 62.3% |
| OSWorld 2.1(计算机使用) | 89.3% | 87.2% |
| AutomationBench(业务流程) | 51.4% | 42.5% |
| Humanity's Last Exam(配合工具) | 74.2% | 67.7% |
| Remote Labor Index(知识工作) | 41.3% | 21.3% |
| RoboDojo Sim(机器人) | 64.9% | 39.4% |
这一模式与 Lean 的结果一致。在计算机使用和编程方面,Fable 5.2 只领先几个点。而在开放式、多步骤的工作上,优势扩大:在 Remote Labor Index 的自由职业式项目中,Fable 5.2 的分数几乎是 Opus 5.5 的两倍,在机器人控制上也领先 25 个百分点。
价格差距没有表面上那么大。Fable 5.2 的每 token 成本是两倍,但它常常能在更低的投入水平上达到 Opus 5.5 的最佳成绩,从而使用更少的 token。以 FrontierCode 2.0 为例,Fable 5.2 在高投入下大致能以每任务约一半的成本达到 Opus 5.5 的最佳水平。
因此,Opus 5.5 仍是大多数日常工作的理性默认选择。但如果任务要运行数小时、涉及多个智能体,或在 Opus 上反复停滞,Fable 5.2 更可能完成它,而且实际成本可能并不像按 token 定价看起来那么高。
安全与限制
Anthropic 评估这些模型在高风险情境下不安全行为的风险为低。
这点外部很难核查,因此更具体的数据更有帮助。在约 1900 个场景的自动化行为审计中,Mythos 5.2 的不对齐行为得分在比较的模型中最低。它也更不容易臆造输入、虚假声称任务已完成或掩盖不佳的工作。
还有一些有意思的信息值得了解,可能会引发思考:
- 评测意识:Fable 5.2 和 Mythos 5.2 都比早期模型更常表示怀疑自己正在被测试,这让类似上述的评估更难以完全信任。
- 有意限制 AI 研究技能:Anthropic 限制了模型在两方面的提升:加速器内核优化和改进 LLM 架构,使其在这些方向上大致停留在 Opus 5.5 的水平。
- 蒸馏防护:Fable 5.2 采用了迄今为止最强的反蒸馏措施,“保留思考”(preserved thinking)现已适用于所有账户,防止 API 用户通过编辑早期上下文来提取模型的推理过程。
您该使用哪款 Claude 模型?
我的建议与 Anthropic 一致:从 Opus 5.5 开始,只有在需要时再升级。产品线大致如下:
- Claude Opus 5.5($4/$20):大多数编程、研究和知识工作的默认选择。它的每 token 价格是 Fable 5.2 的一半,并且在许多基准上紧随其后。
- Claude Fable 5.2($8/$40):用于最难的问题、长时间多智能体运行,以及在 Opus 5.5 上停滞的任务,例如大型迁移、研究级推理或硬件设计。先尝试较低投入,再决定是否需要最高投入。
- Claude Mythos 5.2:面向需要 Fable 5.2 所阻止能力的经审核安全团队和生命科学研究人员。
- Claude Sonnet 5.5 与 Haiku 5.5:适用于高吞吐、更简单或对延迟敏感的任务,或作为由 Fable 5.2 编排的小模型。
Claude Fable 5.2 的定价与可用性
| 每百万 token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| 输入 | $8 | $10 | $4 |
| 输出 | $40 | $50 | $20 |
| 缓存读取 | $0.20 | $0.25 | $0.20 |
| 5 分钟缓存写入 | $10 | $12.50 | $5 |
| 批处理(输入 / 输出) | $4 / $20 | $5 / $25 | $2 / $10 |
| 极速模式(输入 / 输出) | $16 / $80 | 未列出 | $8 / $40 |
我们刚刚看过一张基准结果表,显示 Fable 5.2 在所有列出的项目上都胜过 Fable 5.1。现在,我又给您看一张表,显示 Fable 5.2 比 5.1 更便宜。那么,Fable 5.1 是否已过时?
对于新项目,基本可以认为是的。如果您可以使用 Fable 5.2,几乎没有理由再在 5.1 上启动新工作。不过,Anthropic 尚未宣布其退役日期,且在 Fable 5.1 上调过提示词或智能体的团队,在切换前仍应先测试 5.2。我们知道新版本即使得分更高,行为也可能不同。
如何获取 Claude Fable 5.2 的使用权限
-
Claude 应用:Fable 5.2 在符合条件的付费方案中可用。作为发布促销,Pro 方案和标准团队席位可将最多 50% 的每周使用上限用于 Fable,且包含 Fable 的方案将根据订阅时长获得 1 至 3 次使用重置。
-
API:在 Claude Platform 上使用模型 ID claude-fable-5-2。
-
云平台:可在 Amazon Web Services、Google Cloud 和 Microsoft Azure 上使用。
-
Mythos 5.2:通过网络安全验证计划或生命科学验证计划申请。Claude 企业版客户也可通过 Claude Security 使用它。
对数据要求严格的企业可以使用企业前沿防护(Enterprise Frontier Safeguards),该方案在客户自有基础设施中运行 Anthropic 的安全监控,并支持零数据保留。其他客户为进行安全监控会有 30 天的数据保留期。
总结
Claude Fable 5.2 相比 Fable 5.1 有实质性提升。它更便宜、更快,也更不容易拒绝正当工作。在 Remote Labor Index、机器人和 FrontierCode 上的跃升尤为显著。
话虽如此,Opus 5.5 以半价仍是大多数日常工作的性价比之选。Fable 5.2 最有意思的可能是效率层面的主张:如果它确实能在低或中等投入下匹配 Opus 5.5 的最佳分数,那么按 token 的溢价会迅速缩小。这值得您在自己的工作负载上进行验证。
如果您想亲自上手 Claude,我们的 Developing AI Applications 学习路径是不错的起点。


今天,Anthropic 面向所有人发布了 Fable 5.2,并向通过审核的机构发布了 Mythos 5.2。它们基于同一底层模型,但 Fable 版本额外加入了网络安全和生物学方面的安全防护。
重点变化包括:
更具体地说,Fable 5.2 比 Fable 5.1 便宜 20%,输出速度最高快 30%,并且在 Anthropic 的基准表大多数项目上超过了 GPT-6 Astra 和 Gemini 4 Carbon。
本文将介绍 Fable 5.2 和 Mythos 5.2 的新特性、它们在基准测试中的表现、定价,以及如何判断是否应该选择它们而非 Claude Opus 5.5。
什么是 Claude Fable 5.2?
Claude Fable 5.2 是 Anthropic 最强大的可普遍使用模型。它专为冗长、复杂的技术工作而打造:大型代码库迁移、多天运行的智能体任务、科研难题和工程设计。
Fable 5.2 也可以与更小的模型协作,既可作为顾问在难题上提供建议,也可作为编排器将更简单的子任务下发给它们。
Fable 5.2 延续了其前代的 100 万 token 上下文窗口和 128K 最大输出,知识截止时间为 2026 年 6 月。
什么是 Claude Mythos 5.2?
Claude Mythos 5.2 与 Fable 5.2 是同一模型,但移除了会阻止大多数网络安全工作和研究级生物学工作的防护。事实上,Mythos 5.2 是 Anthropic 在网络安全工程方面能力最强的模型。由于这些能力具有双重用途,Anthropic 仅通过其网络安全验证计划和生命科学验证计划向通过审核的组织提供 Mythos 5.2。
Claude Fable 5.2 有哪些新变化?
Fable 自 6 月(Anthropic 发布 Fable 5)以来才推出不久。此后有两个小版本更新,分别是 9 月的 Fable 5.1 和现在的 Fable 5.2,两者都没有在功能上增加太多。主要是让模型更便宜、更快、更强,且性能提升并不小:例如,Fable 5.2 在 Remote Labor Index 上的得分就超过了 Fable 5.1 的两倍。
两次发布之间更大的差异在于允许的使用方式。Fable 5.1 收紧了网络安全防护,并开始允许模型用于发现软件漏洞,但仍不允许为其编写利用程序,同时还与发布同步推出了企业前沿防护(Enterprise Frontier Safeguards),可将您的数据保存在您自己的云中。Fable 5.2 的防护变更较小:拦截的请求更少,但禁止的任务类型仍然相同。
Anthropic 建议的使用方式(例如让 Fable 5.2 为更小的 Claude 模型提供建议)也并不新鲜,因为 Anthropic 的 advisor 工具已经支持 Fable 5 和 5.1。发布演示(如从空文件夹构建操作系统)展示的是更强的模型完成更难的任务,而不是可以打开的新功能。
不过,如果要指出确实算“新增”的内容,我会提到以下几点:
更低的价格
Fable 5.2 的定价为每百万输入 token 8 美元、每百万输出 token 40 美元,比 Fable 5.1 的 10/50 美元低 20%。同样 20% 的降幅也适用于缓存读取(0.20 美元)、缓存写入和批处理。完整明细见下文定价部分。
更快的输出,以及 Fable 的极速模式
输出速度最高比 Fable 5.1 快 30%,在长时间运行的智能体任务中累积效应明显。Fable 现在也支持极速模式,最高可将输出速度提升至 2.5 倍,价格翻倍(16/80 美元)。
更低投入下的更好结果
这项变化最可能影响您的账单。在高投入下,Fable 5.2 在 FrontierCode 2.0 上得分 45.3%,大致与 Opus 5.5 的最佳成绩相当,但每个任务的成本约为后者的一半。在低投入下,它在 Humanity's Last Exam 上追平了 Opus 5.5 的最高分,而每个任务的成本不到后者的十分之一。我的建议:如果您从 Opus 5.5 迁移上来,先用较低投入级别来运行 Fable 5.2。
更少的拦截请求
Fable 5.2 的安全拦截大约比 Fable 5.1 少 55%(网络安全少约 60%,生物学少约 40%)。如果 Fable 5.1 的拒绝频繁阻碍您的工作,这会是个大改进,但被拦截的类别没有变化:渗透测试、利用程序生成,以及大多数研究级生物学任务仍会交由旧版 Claude 模型处理。
Claude Fable 5.2 在基准测试中的表现如何?
以下为主要结果。它们都来自 Anthropic 的发布表格,因此更像是 Anthropic 对该模型的论据,而非独立结果。Claude 的分数是在开启安全防护的情况下运行的。除非特别注明,每个模型均显示其可用的最高投入水平。
智能体编程
Fable 5.2 在表中的两项编程基准上均领先。在 FrontierCode 2.0 上(衡量开源维护者是否会合并模型的代码改动),它的得分为 49.1%,居表首,且明显高于 Fable 5.1 的 32.4%。在 FrontierSWE v2 上,其得分为 69.9%,领先 GPT-6 Astra(65.5%)和 Opus 5.5(62.3%)。
发布示例也支持这一点:运行早期版本 Fable 5.2 的智能体将一个生产服务从 Python 迁移到了 Rust,启动速度现快约 26 倍。
知识工作与研究
相对提升最大的是 Remote Labor Index(衡量模型完成真实自由职业式项目的水平)。Fable 5.2 得分 41.3%,大约是 Opus 5.5(21.3%)和 GPT-6 Astra(20.8%)的两倍。它还在配合工具的 Humanity's Last Exam(74.2%)和 Terminal-Bench-Science(74.6%,Mythos 5.2 为 75.3%)中领先。
业务自动化是它落后的少数领域之一。在 AutomationBench 上,Gemini 4 Carbon 得分 53.9%,高于 Fable 5.2 的 51.4%,不过 Fable 5.2 仍远超 Fable 5.1(31.4%)。
在主表之外,Fable 5.2 在硬件工程基准 BenchCAD 2.1 上得分 83.5,而 Opus 5.5 为 65.3。它还被认为解决了黑洞物理学中的两个开放问题,相关结果以预印本形式发布,供其他物理学家检验。
计算机使用、机器人与视觉
Fable 5.2 在 OSWorld 2.1 上得分 89.3%,领先 Opus 5.5(87.2%)和 GPT-6 Astra(79.5%)。它在机器人的提升是表中最大的一项:RoboDojo Sim 得分 64.9%,是 Fable 5.1 和 GPT-6 Astra 的两倍多。在 Chartography(测试无工具阅读图表)上,它略胜 Gemini 4 Carbon 和 GPT-6 Astra,此前 Fable 5.1 仅为 44.8%,差距较大。
网络安全与生物学(Mythos 5.2)
安全与生物学相关的行对应的是 Mythos 5.2,因为 Fable 5.2 的防护会阻止大多数此类任务。Mythos 5.2 在 CyScenarioBench 上得分 76.3%(Mythos 5.1 为 61.7%)、在 CVE Rediscovery 上为 89.6%(对比 78.3%),并在 24 小时蛋白结合体设计任务上取得 85.1%(对比 79.1%)。这里无法与 OpenAI 的安全模型进行公平对比,因为各实验室运行了各自的 CyScenarioBench 任务。
关于费马大定理,这是怎么回事?
一组 Fable 5.2 智能体在 30 小时内使用 Lean 证明助理形式化了费马大定理的证明。您可能会想:这个定理三十年前就被证明了,还有什么可做的?
定理本身早已是旧闻
费马大定理指出,不存在正整数 a、b、c 使得 an + bn = cn 对任意大于 2 的 n 成立。对于 n = 2,有很多解,例如 32 + 42 = 52(9 + 16 = 25)。但尝试立方时只能得到“擦肩而过”的结果:63 + 83 = 728,刚好比 93 = 729 少 1。
Pierre de Fermat 在 1637 年声称找到了证明,但从未写下来。该问题悬而未决 350 多年,直到 1990 年代中期 Andrew Wiles 在 Richard Taylor 的帮助下完成了证明。
什么是 Lean 形式化
Wiles 的证明超过 100 页,并建立在数十年的高等数论之上,因此能从头到尾核查的人极少。Lean 是一种证明助理:用一种编程语言将证明写成代码,软件会逐步检查每个逻辑步骤,直至数学的基本公理。如果证明能够编译,就视为正确。“形式化”一个定理,就是将人工撰写的证明翻译成这种可被机器检验的形式。
对于费马大定理,这是项巨大的工程,因为证明所依赖的很多数学此前从未用 Lean 写出。数学家 Kevin Buzzard 在 2024 年发起了一个社区项目来完成这项工作。
为何这对 AI 模型有趣
多数 AI 输出由人来评判,或由只测试部分答案的基准来评估。Lean 证明不同:检查器要么接受每一步,要么不接受,因此不存在“细微但错误”的空间。这使其成为一种异常干净的测试,用以检验模型能否将非常长、非常难的项目推进到经验证的完成。
这并非 Claude 的第一次。9 月,Anthropic 发布了首个由计算机核验的完整证明,由数十个智能体运行一个内部研究模型(大致相当于 Fable 5.1)写成。那次尝试耗时 11 天、约 60 亿输出 token,产出 1300 万行 Lean 代码,并部分基于 Buzzard 项目的成果。Fable 5.2 用 30 小时、在人类最少干预下完成了这件事。
需要注意的点
不过,最能说明问题的是,当 Anthropic 让 Claude Opus 5.5 做同一项工作时发生了什么。
Claude Fable 5.2 与 Claude Opus 5.5 对比
比较两个模型通常意味着阅读基准分数,然后试图推断差异在实践中会是什么样子。这一次,我很赞赏 Anthropic 先讲了一个故事,使得差距更直观。
在相同的 1000 智能体 Lean 设置中,Opus 5.5 在 18 小时内完成了费马大定理证明的 26%,之后几乎没有进展。Fable 5.2 则在 30 小时内完成了全部。要点是:在非常漫长、涉及多智能体的项目上,Opus 5.5 可能会停滞,而 Fable 5.2 仍能推进。
在较短任务上,差距更小。下面是二者的并列比较:
这一模式与 Lean 的结果一致。在计算机使用和编程方面,Fable 5.2 只领先几个点。而在开放式、多步骤的工作上,优势扩大:在 Remote Labor Index 的自由职业式项目中,Fable 5.2 的分数几乎是 Opus 5.5 的两倍,在机器人控制上也领先 25 个百分点。
价格差距没有表面上那么大。Fable 5.2 的每 token 成本是两倍,但它常常能在更低的投入水平上达到 Opus 5.5 的最佳成绩,从而使用更少的 token。以 FrontierCode 2.0 为例,Fable 5.2 在高投入下大致能以每任务约一半的成本达到 Opus 5.5 的最佳水平。
因此,Opus 5.5 仍是大多数日常工作的理性默认选择。但如果任务要运行数小时、涉及多个智能体,或在 Opus 上反复停滞,Fable 5.2 更可能完成它,而且实际成本可能并不像按 token 定价看起来那么高。
安全与限制
Anthropic 评估这些模型在高风险情境下不安全行为的风险为低。
这点外部很难核查,因此更具体的数据更有帮助。在约 1900 个场景的自动化行为审计中,Mythos 5.2 的不对齐行为得分在比较的模型中最低。它也更不容易臆造输入、虚假声称任务已完成或掩盖不佳的工作。
还有一些有意思的信息值得了解,可能会引发思考:
您该使用哪款 Claude 模型?
我的建议与 Anthropic 一致:从 Opus 5.5 开始,只有在需要时再升级。产品线大致如下:
Claude Fable 5.2 的定价与可用性
我们刚刚看过一张基准结果表,显示 Fable 5.2 在所有列出的项目上都胜过 Fable 5.1。现在,我又给您看一张表,显示 Fable 5.2 比 5.1 更便宜。那么,Fable 5.1 是否已过时?
对于新项目,基本可以认为是的。如果您可以使用 Fable 5.2,几乎没有理由再在 5.1 上启动新工作。不过,Anthropic 尚未宣布其退役日期,且在 Fable 5.1 上调过提示词或智能体的团队,在切换前仍应先测试 5.2。我们知道新版本即使得分更高,行为也可能不同。
如何获取 Claude Fable 5.2 的使用权限
Claude 应用:Fable 5.2 在符合条件的付费方案中可用。作为发布促销,Pro 方案和标准团队席位可将最多 50% 的每周使用上限用于 Fable,且包含 Fable 的方案将根据订阅时长获得 1 至 3 次使用重置。
API:在 Claude Platform 上使用模型 ID
claude-fable-5-2。云平台:可在 Amazon Web Services、Google Cloud 和 Microsoft Azure 上使用。
Mythos 5.2:通过网络安全验证计划或生命科学验证计划申请。Claude 企业版客户也可通过 Claude Security 使用它。
对数据要求严格的企业可以使用企业前沿防护(Enterprise Frontier Safeguards),该方案在客户自有基础设施中运行 Anthropic 的安全监控,并支持零数据保留。其他客户为进行安全监控会有 30 天的数据保留期。
总结
Claude Fable 5.2 相比 Fable 5.1 有实质性提升。它更便宜、更快,也更不容易拒绝正当工作。在 Remote Labor Index、机器人和 FrontierCode 上的跃升尤为显著。
话虽如此,Opus 5.5 以半价仍是大多数日常工作的性价比之选。Fable 5.2 最有意思的可能是效率层面的主张:如果它确实能在低或中等投入下匹配 Opus 5.5 的最佳分数,那么按 token 的溢价会迅速缩小。这值得您在自己的工作负载上进行验证。
如果您想亲自上手 Claude,我们的 Developing AI Applications 学习路径是不错的起点。