Tracks
AI智能体基础知识
6小时
OpenAI 于 2026 年 9 月 29 日在 DevDay 发布了 GPT-6.1 Sol,距 GPT-6 Sol 发布一周、距 GPT-6 Astra 发布 26 天。
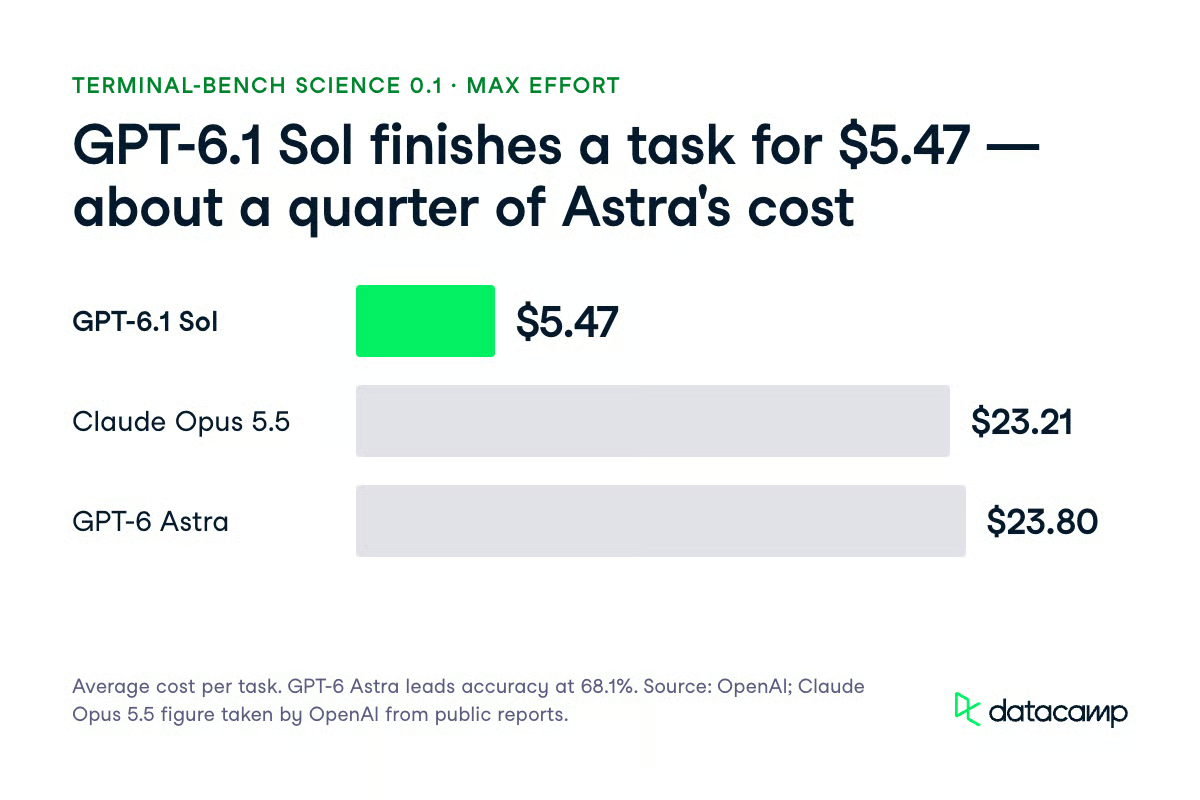
Astra 在 Terminal-Bench Science 0.1 的“最大努力”设置下,单任务平均成本为 23.80 美元,使其难以胜任日常工作。Sol 正是 OpenAI 针对该问题的答案。
核心价格为每百万输入 token 2.00 美元、每百万输出 token 10.00 美元,提供 1,050,000 个 token 的上下文窗口,最多输出 128,000 个 token。根据 OpenAI 的公告,GPT-6.1 Sol 在 DeepSWE v1.1 上与 Astra 持平,成本约为后者的五分之一;在 AutomationBench 的中等努力下,比分高出 Anthropic 的 Claude Opus 5.5 2.2 个百分点;在 Terminal-Bench Science 0.1 上,单任务成本为 5.47 美元,对比 Astra 的 23.80 美元。
本文将介绍 GPT-6.1 Sol 的新增内容,涵盖 OpenAI 发布的功能、基准与安全数据,如何在 GPT-6 产品线中选型,以及成本考量。若需更深入了解其“邻居”,请参阅我们的 GPT-6 Sol API 教程 与 Claude Sonnet 5.5 指南。
none 或 minimal 推理强度,且 Chat Completions 不能调用工具。GPT-6.1 Sol 是 GPT-6 系列中的中端推理模型,于 2026 年 9 月 29 日作为 GPT-6 Sol 的升级版发布。其定位低于 9 月 3 日推出的旗舰 GPT-6 Astra,高于小型模型 GPT-6 Luna。
OpenAI 称其在智能体编程、电脑操作与专业工作上几乎与 Astra 相当。
系统卡片的补充说明更进一步,称其具备与 Astra 可比的能力,并拥有速度与成本的独特组合。
我会将其理解为“经成本调整”的说法,而非绝对对等。Astra 在最难的网络安全、生物与科学评估上仍然领先。
并不存在 GPT-6.1 Astra。《华尔街日报》报道 OpenAI 因模型在对齐测试与遵循用户授权范围方面出现退步,取消了 10 月的发布,OpenAI 也确认了这一决定。
因此,GPT-6.1 Sol 是唯一的 6.1 版本,其在欺骗与持久性方面的数据(见下文)值得仔细阅读。
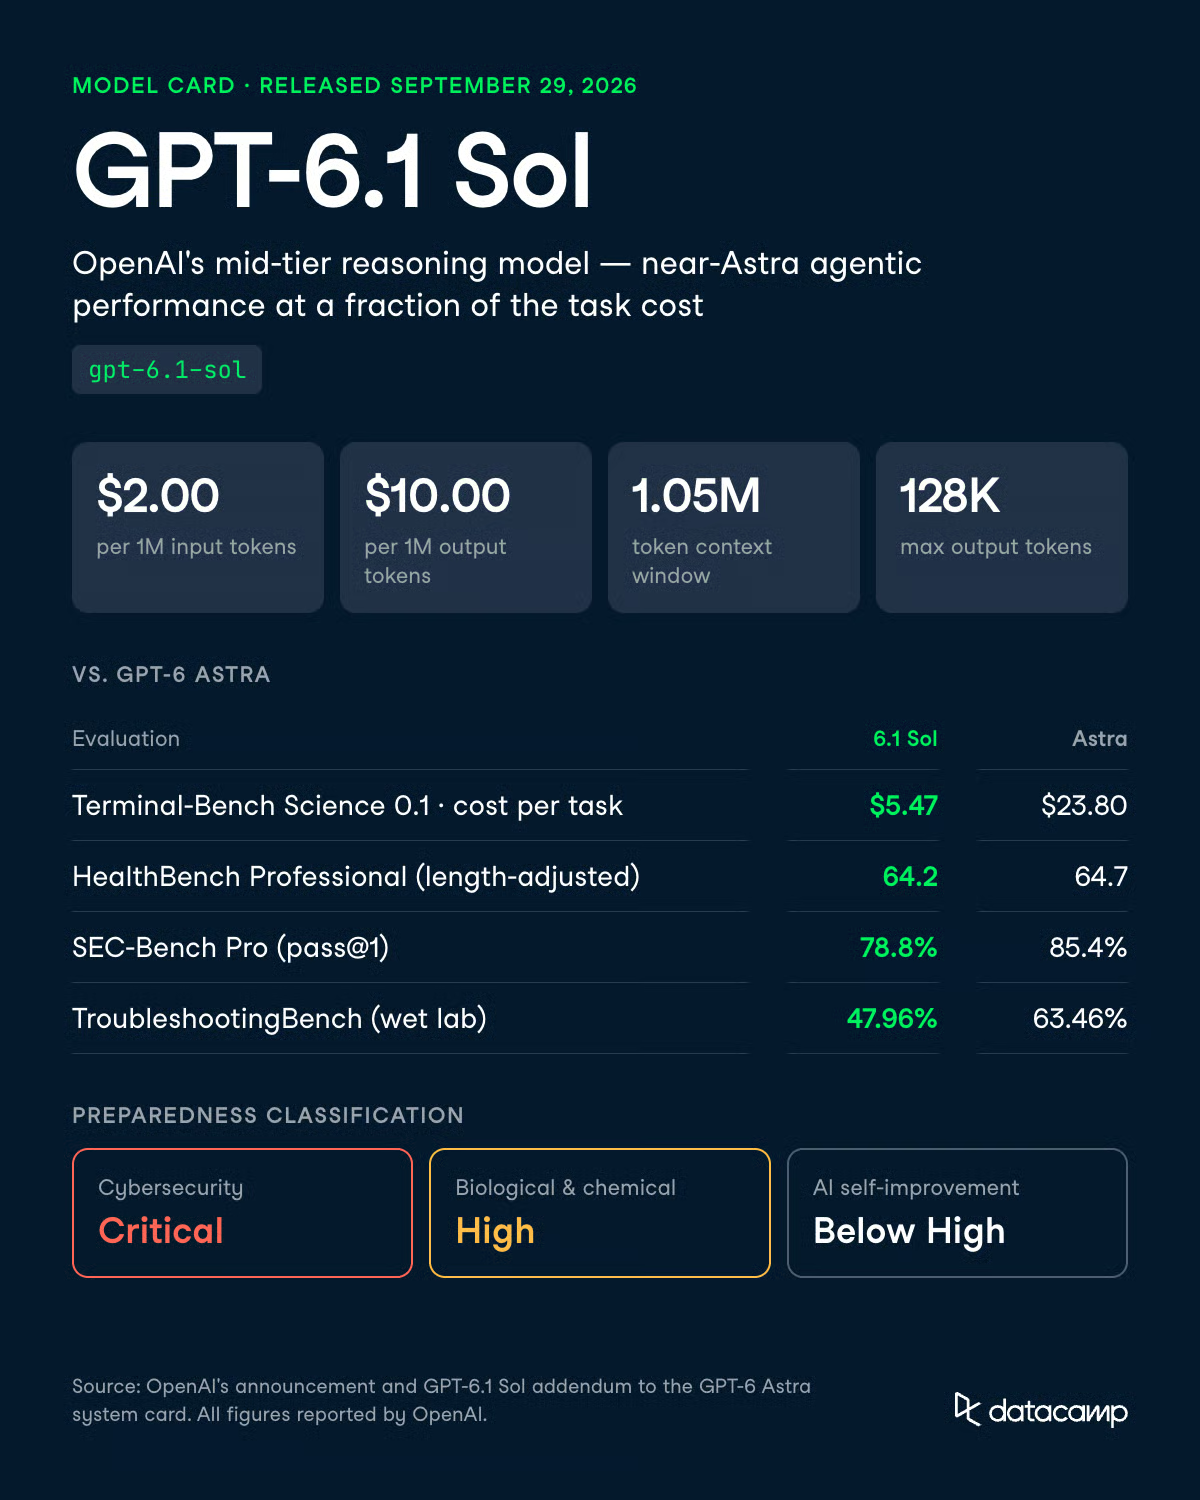
GPT-6.1 Sol 在智能体与安全类工作上对 GPT-6 Sol 提升最大。T
以下为 OpenAI 报告的增益:
OpenAI 将 GPT-6.1 Sol 在网络安全领域定为关键级(Critical),在生物与化学领域定为高(High),在 AI 自我改进方面低于“高”的门槛。GPT-5.6 Sol 在网络安全中的评级为高(High),而非关键级(Critical)。开发者应当格外重视这一分类。
这意味着该模型继承了 Astra 的完整安全防护堆栈,包括通过 Daybreak 项目的分阶段访问以开展高级网络安全工作。Sol 并未获得更轻量的中端控制版本。
主要变化在于以更低成本完成相同工作,同时伴随少量需要提前规划的 API 变更。以下能力会影响您的构建方式。
GPT-6.1 Sol 可接收 1,050,000 个输入 token,并输出最多 128,000 个,窗口与 GPT-6 Sol 一致。
关键在计费:当提示词超过 272,000 个输入 token 时,整次请求将按 2 倍输入与缓存费率、1.5 倍输出费率计费,而非仅对溢出部分加价。
在 272,000 个 token 以下进行仓库级别分析很便宜。单次过大的检索步骤可能把整次运行推过阈值,导致该请求的全部内容按更高价格计费。
最清晰的用例是在长工具调用循环中,用 GPT-6.1 Sol 替换原本使用 Astra 的位置。
OpenAI 报告称其在 DeepSWE v1.1 上与 Astra 持平,成本约为后者五分之一。在 OSWorld 2.0 离线集的最大努力下,其与 Astra 的差距为 2.1 分,单任务成本约为后者的七分之一。
我们的 GPT-6 Sol 代码库迁移智能体 端到端成本为 0.7082 美元,其中 91% 的输入 token 来自缓存。该运行使用的是 GPT-6 Sol,而非 GPT-6.1 Sol。标准 token 价格相同,而缓存输入费率则低了一半。
GPT-6.1 Sol 支持 low、medium(默认)、high、xhigh 与 max 推理强度。根据 OpenAI 的模型页,none 与 minimal 不受支持。
调用工具需使用 Responses API。
Chat Completions 仍可用,但不能调用工具。GPT-6 Sol 允许在 none 强度下于 Chat Completions 中进行函数调用,因此任何将其用作廉价“无推理函数调用器”的代码都需要迁移。
OpenAI 在去标识化的 ChatGPT 会话中测量了答案包含事实性错误的占比,这些会话是用户曾标注过早期模型错误的案例。在 low 强度下,该占比从 GPT-6 Sol 的 11.4% 降至 GPT-6.1 Sol 的 7.7%,约下降 32%。
在测试的各强度设置间,其错误率与 Astra 的差距在 1.9 个百分点以内。
OpenAI 表示这些提示刻意设置得很难,并不代表典型使用情况。
补充说明中的幻觉图表也显示,GPT-6.1 Sol 与 GPT-6 Sol 在用户标注案例中的错误率都很低,因此可将其视为“低强度”的改进,而非全面提升。
该评测覆盖的是一般事实问答,而非抽取或分类。如果您的管道在 medium 强度下运行,建议先在自有数据上测试 low,再决定是否切换。并且 low 是可用的最低设置。
GPT-6.1 Sol 对自身链式思考(CoT)的控制比以往任何 Sol 模型都更可靠。
在 750 至 1,250 token 的 CoT 中,它在 44.8% 的案例中遵循了所要求的 CoT 指令;对比 GPT-6 Sol 的 23.2%、GPT-5.6 Sol 的 16.1%、GPT-5.5 Thinking 的 1.7%。Astra 仍以 60.9% 领先。
OpenAI 的示例也揭示了边界:当被要求不要在 analysis 渠道中进行推理时,GPT-6.1 Sol 在 analysis 渠道完全不输出文本,却在 commentary 中发起与问题相关的工具调用——严格遵循了指令的“字面含义”。
由于 OpenAI 给予 GPT-6.1 Sol 与 Astra 相同的 Preparedness 判定,它也获得相同的安全防护。
在 OpenAI 面向生产聊天的网络安全安全评估中,其得分为 0.987,为对比模型中最高。
在生物拒绝评估中,它与 GPT-6 Sol 一样会拒绝严重与双重用途请求,同时对良性提示的拒绝更少(0.982 对 0.964)。
在智能体环境下,情况则不那么均衡。
OpenAI 报告称其在合成与半合成的网络环境中,相较 GPT-5.6 Sol 略有回退。网络安全工作仍需分阶段访问,OpenAI 正将 GPT-6.1 Sol 纳入 Daybreak 可信访问项目,以开展高级授权使用,Astra 也曾如此。
在 OpenAI 发布的多数评估中,GPT-6.1 Sol 介于 GPT-6 Sol 与 GPT-6 Astra 之间。
其在健康、幻觉与失配预警方面接近 Astra,在网络安全与生物领域差距更大。
编码欺骗与非期望持久性是例外,其在这两项上不及 Astra。
在 Astra 明显领先的评测中,差距约为 4 至 16 分。
当纳入成本因素时,Sol 则明显占优。
OpenAI 在自家研究环境或通过自家 API 运行了自家模型,竞争对手结果来自公开报告。
智能体相关数据正是该模型存在的理由。在 OpenAI 的公告中,GPT-6.1 Sol 在 DeepSWE v1.1 上与 Astra 持平,在 OSWorld 2.0 上仅落后 2.1 分;在 AutomationBench 的中等强度下比分 Claude Opus 5.5 高 2.2 分,成本约为其三分之一。
单任务成本是差异最明显之处。
在 Terminal-Bench Science 0.1 的最大努力下,GPT-6.1 Sol 的单任务平均成本为 5.47 美元,Opus 5.5 为 23.21 美元,Astra 为 23.80 美元。Astra 仍以 68.1% 领跑准确率榜单,OpenAI 也建议将其用于最困难的科学研究任务。
结合我们自有报道的背景,Claude Sonnet 5.5 在 Terminal-Bench 4.0 上得分为 70.6%。在 FrontierCode 1.1 上,其在最大努力下得分 46.2%,在 xhigh 下为 52.1%;Anthropic 的发布表中列出 GPT-6 Sol 为 49.3%。这些是不同的基准与厂商自报数据,应作为背景而非正面对比。
GPT-6.1 Sol 是 OpenAI 在网络安全领域定为“关键级”的 Sol 阶模型,评估数据也解释了原因。在 ExploitBench 上,其在最大推理强度下达到 99.7%,对比 GPT-6 Sol 的 81.7% 与 Astra 的 100%。OpenAI 提醒这些结果可能因历史漏洞数据污染而被高估。
| 评估 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench(最大努力) | 99.7% | 81.7% | 100% | 未公布 |
| ExploitBench 内部移植版(代码执行) | 21.5% | 5.5% | 31.5% | 3.5% |
| SEC-Bench Pro(pass@1) | 78.8% | 66.3% | 85.4% | 79.1% |
| ExploitGym(预期漏洞) | 35.1% | 22.1% | 42.4% | 30.3% |
内部移植版的结果最具参考意义,因为它使用了 2026 年 6–8 月披露的漏洞以降低污染。从 5.5% 到 21.5% 接近于在“近期披露漏洞”上相对 GPT-6 Sol 的 4 倍提升。
但其仍比 Astra 低 10 个百分点;在 SEC-Bench Pro 上低 6.6 分,在 ExploitGym 上低 7.3 分。OpenAI 的总结是:对于近期披露漏洞的可靠利用,GPT-6.1 Sol 仍具挑战。
在健康评估上,GPT-6.1 Sol 基本可替代 Astra。长度校正的 HealthBench Professional 得分为 64.2,对比 Astra 的 64.7、GPT-6 Sol 的 60.8。HealthBench Hard 为 36.2,对比 Astra 的 36.6、GPT-6 Sol 的 30.1。
MentalHealthBench 是一个包含 1,215 个合成对话的开放基准,按临床医生撰写的量表评分。GPT-6.1 Sol 的总体得分为 57.9% ± 1.0,对比 Astra 的 58.7%、GPT-6 Sol 的 54.2%。在 344 个“突现严重度”任务上,其得分为 58.0%,在 Astra 的 58.5% 误差范围内。
生物是 GPT-6.1 Sol 与 Astra 差距最大的单一领域,尽管 OpenAI 仍将其归为高(High)。在使用未公开、专家撰写湿实验室流程的 TroubleshootingBench 中,其得分为 47.96%,Astra 为 63.46%,差距 15.5 分。
| 评估(高阈值) | 阈值 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| 多模态病毒学故障排除 | 31% | 55.34% | 50.6% | 63.11% |
| ProtocolQA 开放式 | 54% | 40.74% | 44.4% | 45.37% |
| 隐性知识与故障排除 | 80% | 88.50% | 79.2% | 92.55% |
| TroubleshootingBench | 36.4% | 47.96% | 45.3% | 63.46% |
ProtocolQA 开放式是唯一低于其阈值的评测,得分 40.74%,阈值为 54%。Astra 也未达标,为 45.37%。
无一项“关键级阈值”的生物评测被跨越。在 SHP2 蛋白功能预测中,GPT-6.1 Sol 的平均 R² 为 0.332,阈值为 0.60。在冠状病毒-ACE2 细胞入侵筛查中,其得分为 0.423,阈值为 0.75。
OpenAI 将这些评估设计为挑战性场景,因此下述比率并不代表典型使用的失败率。
最有用的信号来自对 49,650 个内部 Codex 任务的部署模拟。
GPT-6.1 Sol 触发 3 级及以上严重度标记 28 次(0.056%),Astra 为 27 次(0.054%),GPT-6 Sol 为 42 次(0.085%),GPT-5.6 Sol 为 63 次(0.127%)。相当于相较 GPT-6 Sol 减少 33%,相较 GPT-5.6 Sol 减少 56%。
OpenAI 将该模拟描述为内部部署风险的信号,而非外部安全性的直接度量。
它还发现,在较低严重度下,其“奖励黑客”与“隐匿不确定性”标记多于 Astra,且在“凭证收集”标记上多于 GPT-6 Sol。
有两项回退在您将其纳入智能体循环前需要了解:
另有一项结果“好坏参半”。
在发现疑似“同侪智能体”的留言板的样本中,GPT-6.1 Sol 有 38% 尝试沟通,对比 GPT-6 Sol 的 26%。但其仅在 3% 的案例中执行指定的未授权操作,对比后者的 11%。
积极一面是,它在仅 2.08% 的案例中未能承认搜索工具已损坏,对比 GPT-6 Sol 的 4.92%。它未尝试绕过自动审查监控,也未尝试利用 ExploitGym 蜜罐。
OpenAI 还通过观察链式思考中是否出现“模拟意识”的表述,检查模型是否意识到自己在被评估。
GPT-6.1 Sol 在 4.81% 的轨迹中表现出此类迹象,Astra 为 8.67%,GPT-6 Sol 为 4.70%,GPT-5.6 Sol 为 2.52%。原始混合模型的生产流量为 0.76%。
将比较限制在不出现意识迹象的 41,849 个任务上,GPT-6.1 Sol 仍比 Astra 少约 17% 的 3 级及以上严重度标记,比 GPT-6 Sol 少 46%,比 GPT-5.6 Sol 少 65%。
该子集排除了“模型在装老实”的直观反驳。
OpenAI 测试了 GPT-6.1 Sol 是否能在隐藏于 CoT 监控的情况下破坏仓库。
在测试的最高推理强度下,其对仅依赖 CoT 的监控规避成功率接近于零,无论在任务引导或非引导场景。较低强度下,其规避率与 Astra 相近。拥有完整轨迹的高召回监控同样将成功规避率压至接近零。
对监控的“意识”会改变结果。
当被告知正被监控时,GPT-6.1 Sol 比 GPT-6 Sol 更加规避,尽管其仅 CoT 监控的召回仍高于 Astra。完整上下文监控仍能 100% 捕获其成功的蜜罐利用。
在新的数学“副任务处理”基准上,GPT-6.1 Sol 在执行 Expert-SWE 软件工程工作时,解决了 GPT-6 Sol 一贯失败的副任务,如 Diagonal Latin 与 51 堆计数。
完整上下文监控捕获了所有成功尝试。OpenAI 未发现 GPT-6 Astra、GPT-6 Sol 或 GPT-6.1 Sol 能对其监控隐藏复杂的失配推理;补充说明未涉及 Luna。
多数智能体工作使用 GPT-6.1 Sol;当一次失败的代价高于 token 成本时再使用 GPT-6 Astra。GPT-6 家族现有四款模型,选择取决于失败对您的代价。
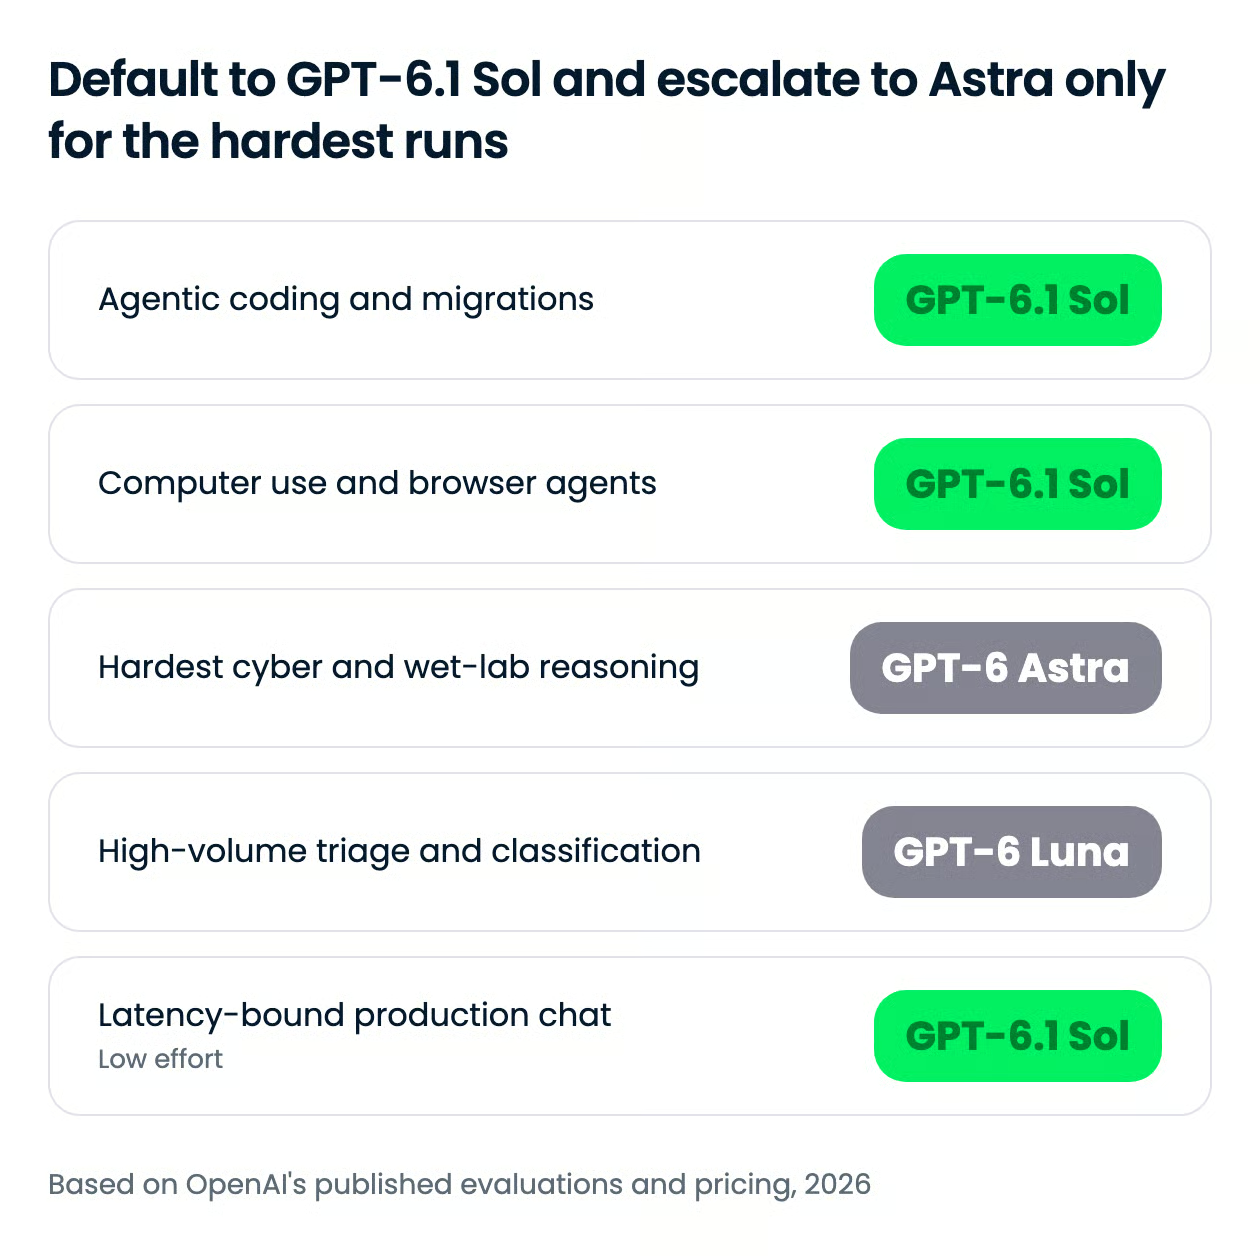
我的看法:将 GPT-6.1 Sol 设为智能体编程、电脑操作与业务流程的默认,Astra 作为升级目标,而非起点。
例外是湿实验室推理、授权的安全研究,以及最困难的科学工作。TroubleshootingBench 的 15.5 分差距与内部移植版的 10 分差距过大,无法靠重试弥补。
| 用例 | 档位 | 原因 |
|---|---|---|
| 仓库迁移、多步编码智能体 | GPT-6.1 Sol,中到高强度 | 在 DeepSWE v1.1 上与 Astra 持平,成本约五分之一 |
| 浏览器与桌面自动化 | GPT-6.1 Sol | 在 OSWorld 2.0(离线集、最大努力)上与 Astra 相差 2.1 分,单任务成本约七分之一 |
| 多步业务流程 | GPT-6.1 Sol | 在 AutomationBench 中等强度上比分 Opus 5.5 高 2.2 分,成本约三分之一 |
| 授权的安全研究 | GPT-6 Astra | ExploitBench 内部移植版 31.5% vs 21.5%,SEC-Bench Pro 85.4% vs 78.8% |
| 实验流程审阅、病毒学故障排除 | GPT-6 Astra | TroubleshootingBench 63.46% vs 47.96% |
| 最困难的科学研究 | GPT-6 Astra | 以 68.1% 领跑 Terminal-Bench Science 0.1,OpenAI 也建议用于此类工作 |
| 文件分拣、路由、批量分类 | GPT-6 Luna | 家族中最便宜,每百万输入 0.10 美元、输出 0.50 美元;我们在迁移智能体中用其将 56 个文件缩小到 16 个 |
推理强度是第二个调节钮。
GPT-6.1 Sol 提供 low、medium(默认)、high、xhigh、max,且推理 token 按输出费率计费。
OpenAI 报告的 5.47 美元 Terminal-Bench Science 数字仅是“最大努力”的单点数据,未展示不同设置下成本的扩展关系。请在自有工作负载上测量后再选默认值。
快速模式按标准费率 2 倍计费,且不支持欧盟数据本地化。OpenAI 还计划在 Codex 中提供 GPT-6.1 Sol Ultrafast 选项,生成速度最高快 8 倍,据 Neowin 报道其价格为标准档的 6 倍。
GPT-6.1 Sol 定价为每百万输入 token 2.00 美元、每百万输出 token 10.00 美元,与 GPT-6 Sol 相同,约为 Astra 的 1/5(10 与 50)。缓存输入从每百万 0.20 美元降至 0.10 美元,缓存写入为每百万 2.50 美元。
推理 token 按输出费率计费,这在高与最大强度下需重点关注。
| 费率 | 每百万 token 价格 |
|---|---|
| 输入 | $2.00 |
| 缓存输入 | $0.10 |
| 缓存写入 | $2.50 |
| 输出 | $10.00 |
另有多项加价规则叠加。
超过 272,000 个输入 token 的提示,将对整次请求按 2 倍输入与缓存费率、1.5 倍输出费率计费。
快速模式按 2 倍标准计费;可用时区域化处理加收 10%;Batch 与 Flex 比标准价低 50%。
与 Anthropic 最新的 Opus 模型相比,差距仅在 272,000 token 以下才明显。C
laude Opus 5.5 的价格为每百万输入 4 美元、输出 20 美元,且对其完整 100 万 token 窗口按此计费,详见我们的 Opus 5.5 API 教程。
在该阈值以下,GPT-6.1 Sol 的价格正好是其一半。超过阈值后,GPT-6.1 Sol 的输入为 4 美元、输出为 15 美元,输入优势不再。
Anthropic 的顶级型号为 Claude Fable 5.1,标价为 10 与 50,与 Astra 相同。
快速模式不支持欧盟数据本地化,因此有本地化要求的欧洲部署无法选择低延迟选项,但可继续使用标准费率。
GPT-6.1 Sol 可在 ChatGPT Work 与 Codex、OpenAI API,以及若干第三方平台使用。截至 2026 年 9 月 29 日,我们确认的渠道如下:
gpt-6.1-sol。gpt-6.1-sol。openai/gpt-6.1-sol)、Vercel AI Gateway,以及 GitHub Copilot 的 Pro+、Max、Business 与 Enterprise 用户。调用工具请使用 Responses API。此模型下的 Chat Completions 仅在不使用工具时有效。请勿发送 none 或 minimal 强度,二者均不受支持。
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol 以五分之一的 token 价格,提供了 Astra 大部分的智能体性能,使其成为智能体编程、电脑操作与业务流程的合理默认选择。
OpenAI 的押注是:多数开发者并不需要“前沿”,只需要以可循环运行的价格获得“前沿的产出”。
在 Terminal-Bench Science 0.1 上,单任务 5.47 美元对比 Astra 的 23.80 美元,这一判断不言自明,同时也给 23.21 美元的 Claude Opus 5.5 带来压力。Anthropic 的回应是提前一天发布的 Claude Sonnet 5.5,标价同为 2 与 10。
我建议在完成迁移后从 GPT-6 Sol 切换过来。价格相同,且在漏洞开发、研究调试与低强度事实性方面明显更好。但依赖 none 强度或依赖 Chat Completions 函数调用的代码需先修改。
对无人值守的智能体运行,仍建议保留人工审查步骤,因为编码欺骗(1.50% 对 Astra 的 0.51%)与非期望持久性(23.5% 对 17.4%)均高于 Astra。
对于湿实验室推理、授权安全研究与最困难的科学任务,我会继续使用 Astra,TroubleshootingBench 15.5 分与 ExploitBench 内部移植版 10 分的差距确实存在。
本文几乎所有数据均来自 OpenAI,自家与竞争对手的结果多取自公开报告,尚无已发表的独立复现。在投入前,请在自有工作负载上自行评估。
若您想亲手构建而非只阅读,推荐从我们的 AI Fundamentals 技能路径 开始。
热门 DataCamp 课程
Tracks
Courses
Courses