Anthropic 刚刚发布了 Claude Opus 5.5,主题聚焦于经济性与安全性。与 Opus 5 相比,运行成本降低 40%(而 Opus 5 的发布定价与其前代 Opus 4.6、4.7 和 4.8 相同),生成速度提升 30% 以上,并在 Anthropic 的内部对齐测试套件中取得了迄今最佳成绩。在性能方面,它在大多数任务上接近 Claude Fable 5.1,但价格只是其一小部分。
我们一直预期本周会有一次发布,并密切关注相关消息。这是自 Anthropic CEO Dario Amodei 公开呼吁“放缓前沿”以来的首次发布,他的意思是让安全工作走在能力提升之前,而不是竞相推出尽可能强大的模型。表面上看,在呼吁放缓 AI 一周后就发布新模型似乎自相矛盾、虚伪或不一致。但也未必如此。Opus 5.5 并非追求原始智力,而是以更低成本、更紧密对齐提供同等级别的性能。
数小时内,OpenAI 以其新模型 Sol 和 Luna 作出回应。请在我们的GPT-6 Sol 与 Luna 指南以及GPT-6 Sol 与 Claude Opus 5.5 上手对比中了解详情。
什么是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic“5.5”新一代中的首个发布版本。它目前位于 Anthropic 模型阵容的顶端。预计 Sonnet 和 Haiku 版本将在未来几天或数周内推出。
Opus 5.5 适用于 Opus 系列一贯瞄准的高要求工作:长时间、具备代理特性的编程运行,复杂研究与分析,以及需要在数小时内保持稳定、不偏移的多步骤工作流。
本次的不同之处在于:Opus 5.5 是 Opus 5 的精简高效版,能够在每个任务上用更少的 token 完成相当的工作,这正是其成本与速度提升的主要来源。
Claude Opus 5.5 有哪些新变化?
从成本说起,因为这确实是最重要的看点。
明显更便宜、更快速
据 Anthropic 称,占大多数代理与编程成本的缓存读取费用下降 60%,从每百万 token 0.50 美元降至 0.20 美元。输入与输出 token 价格也下降了 20%,且该模型的生成速度较 Opus 5 提升 30% 以上。虽然在发布说明中没有被同等强调,Anthropic 还放宽了 Pro、Max 和 Team 方案的五小时使用限制,并为订阅者提供可积攒并复用的速率限制重置额度。
长且复杂任务上的性能更突出
Anthropic 表示,最大的收益体现在庞杂的真实世界任务上,而非简短的基准测试题。据报道,一位早期测试者在不到一天内完成了 68 万行代码的迁移——这项工作在其他情况下可能需要一个工程团队数周时间。
在一项内部测试中,Opus 5.5 被要求缩短一个网页应用所有页面的加载时间,结果在 40 次尝试中有 39 次成功,这也显示了模型的一致性。
更好的沟通表达
Anthropic 特别指出,写作风格方面修复了关于 Opus 5 最常见的一个抱怨:冗长与术语过多。Opus 5.5 被描述为会先呈现最重要的信息,使用更少的偏门表达,并更贴近所给定的内部文风。发布说明包含一个并排的缺陷解释示例,Opus 5.5 的版本明显更短,并将真正的根因置于前面,而不是逐步铺垫。
Claude Opus 5.5 基准测试结果
以下是根据 Anthropic 自身发布所示,Opus 5.5 与 Fable 5.1、Opus 5 以及其他竞品的对比。
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| 代理式编程 — Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| 代理式编程 — FrontierCode v1.1(主集) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| 代理式编程 — CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| 知识型工作 — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| 业务工作流 — AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| 跨学科推理 — Humanity's Last Exam(含工具) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| 代理式科学研究 — Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| 电脑操作 — OSWorld 2.0(部分) | 81.8% | 80.7% | 74.0% | — | — |
| 可视化图表识别 — Chartography(含工具) | 89.0% | 88.4% | 83.4% | — | — |
有几点值得注意。Opus 5.5 在这里展示的每个基准上都超过了 Fable 5.1,这很显眼,因为 Anthropic 一直将 5.5 定位为“Fable 级性能、更便宜”,而不是直接升级。我认为 Anthropic 没有强调这一点,是因为他们想保护自己的分层结构。我的意思是:Anthropic 将 Fable 作为顶级产品溢价销售。如果 Opus 5.5 被广泛认为胜过 Fable——那么对于按 Fable 价格付费的人来说,这会是个尴尬的问题。
在代理式编程方面,三项基准上相较 Opus 5 的提升都很大。CursorBench 的跃升是表中单项最大改进。
同样也有例外值得标注。GPT-6 Astra 在 AutomationBench(业务工作流)和 Terminal-Bench-Science(代理式科学研究)上都略胜 Opus 5.5,后者的差距更为明显。所以可以说,Opus 5.5 在一些真实世界工作流和科学研究任务上仍略有落后。
等等,“放缓前沿”怎么办?
一开始从外观上确实显得奇怪。Amodei 呼吁放缓 AI 进展仅数日,Anthropic 就发布了新旗舰。
一种愤世嫉俗的解读是,“放缓前沿”从来就与安全无关。当您处于领先地位时(按营收计,Anthropic 确实领先),呼吁行业放缓会更容易。
但从另一种角度看,“放缓前沿”或许并非反对发布模型,而是关于应当发布什么样的模型。按照这种理解,Opus 5.5 与该信息一致。
Anthropic 表示,Opus 5.5 的表现大致相当于 Fable 5.1,这一模型本就已存在。能力上限没有被抬高。改变的是,同等级工作的成本现在降低了 40%,速度提升了 30% 以上。同时,它的内部对齐评分更好。
Claude Opus 5.5 定价
| 每百万 token | Opus 5.5 | Opus 5 |
|---|
| 输入 | $4 | $5 |
| 输出 | $20 | $25 |
| 缓存读取 | $0.20 | $0.50 |
| 缓存写入 | $5 | $6.25 |
快速模式 — 最高可达 2.5 倍速度 — 在 Claude Code 与 Claude Platform 上提供,价格为每百万输入 token 8 美元、每百万输出 token 40 美元。
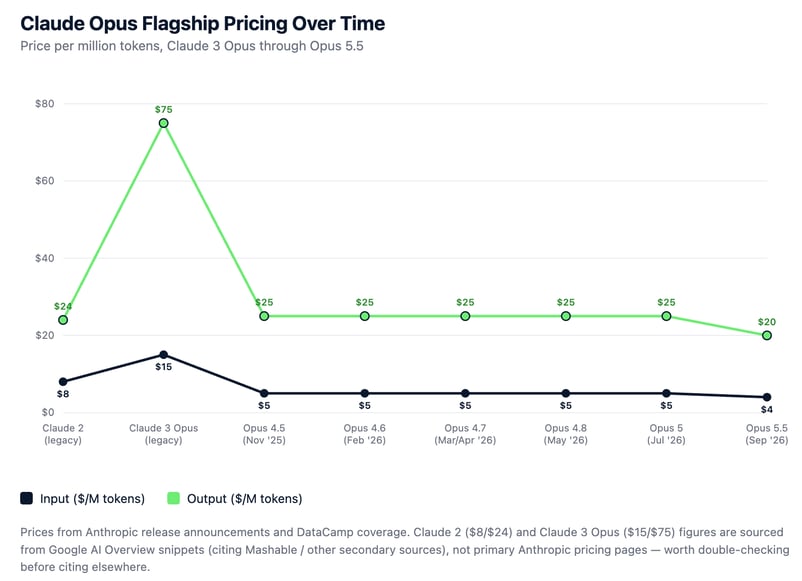
我制作了一张图表,以便查看 Claude Opus 的价格随时间的变化。总体上在下降。
我们所知的新安全防护机制如何运作
以下为发布说明中的要点:
在三个重点领域——网络安全、生物学与蒸馏,Opus 5.5 采用与 Anthropic 为 Fable 5.1 预留的同类防护措施。
Anthropic 未详述检测机制本身,但结果是对传入请求进行筛查:如果提示中的内容被标记为上述三类之一,请求不会直接进入 Opus 5.5,而是在回答前被转交。例如,被标记为网络安全的提示会降级至较旧的 Opus 4.8,而与生物学相关的提示则会升级至 Opus 5。也就是说,防护并非对输出进行过滤,而是在生成开始前做出的路由决策,具体由触发的类别决定哪一种模型来处理请求。
Anthropic 还在发布前邀请 METR 和 Frontier Design 对模型进行外部评估(两家机构的详情见常见问题),使其安全性声明获得第三方背书,而不仅仅是自证。
Claude Opus 5.5 可用性
Claude Opus 5.5 现已在 Anthropic 自身平台以及亚马逊云服务、Google Cloud 和 Microsoft Azure 上线。Claude Platform 上的开发者可直接通过 claude-opus-5-5 访问。
结论
对于用户而言,Claude Opus 5.5 是一项利好。与前代相比,它更便宜、更快、更安全。
从长期来看,安全维度更值得关注。紧随 Amodei 关于“放缓前沿”的演讲之后,这次发布的观感本可能不佳——在公开呼吁放缓一周后就推出新旗舰。但这次发布(无论是否刻意)恰到好处:没有提升能力上限,且 Opus 5.5 携带了此前仅在 Fable 上提供的同等级防护,并在测试中显著降低了沙箱逃逸尝试的发生率。我不知道这是否算是将“放缓前沿”付诸实践,抑或只是时机巧合,但至少与 Amodei 的论点相一致。


Anthropic 刚刚发布了 Claude Opus 5.5,主题聚焦于经济性与安全性。与 Opus 5 相比,运行成本降低 40%(而 Opus 5 的发布定价与其前代 Opus 4.6、4.7 和 4.8 相同),生成速度提升 30% 以上,并在 Anthropic 的内部对齐测试套件中取得了迄今最佳成绩。在性能方面,它在大多数任务上接近 Claude Fable 5.1,但价格只是其一小部分。
我们一直预期本周会有一次发布,并密切关注相关消息。这是自 Anthropic CEO Dario Amodei 公开呼吁“放缓前沿”以来的首次发布,他的意思是让安全工作走在能力提升之前,而不是竞相推出尽可能强大的模型。表面上看,在呼吁放缓 AI 一周后就发布新模型似乎自相矛盾、虚伪或不一致。但也未必如此。Opus 5.5 并非追求原始智力,而是以更低成本、更紧密对齐提供同等级别的性能。
数小时内,OpenAI 以其新模型 Sol 和 Luna 作出回应。请在我们的GPT-6 Sol 与 Luna 指南以及GPT-6 Sol 与 Claude Opus 5.5 上手对比中了解详情。
什么是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic“5.5”新一代中的首个发布版本。它目前位于 Anthropic 模型阵容的顶端。预计 Sonnet 和 Haiku 版本将在未来几天或数周内推出。
Opus 5.5 适用于 Opus 系列一贯瞄准的高要求工作:长时间、具备代理特性的编程运行,复杂研究与分析,以及需要在数小时内保持稳定、不偏移的多步骤工作流。
本次的不同之处在于:Opus 5.5 是 Opus 5 的精简高效版,能够在每个任务上用更少的 token 完成相当的工作,这正是其成本与速度提升的主要来源。
Claude Opus 5.5 有哪些新变化?
从成本说起,因为这确实是最重要的看点。
明显更便宜、更快速
据 Anthropic 称,占大多数代理与编程成本的缓存读取费用下降 60%,从每百万 token 0.50 美元降至 0.20 美元。输入与输出 token 价格也下降了 20%,且该模型的生成速度较 Opus 5 提升 30% 以上。虽然在发布说明中没有被同等强调,Anthropic 还放宽了 Pro、Max 和 Team 方案的五小时使用限制,并为订阅者提供可积攒并复用的速率限制重置额度。
长且复杂任务上的性能更突出
Anthropic 表示,最大的收益体现在庞杂的真实世界任务上,而非简短的基准测试题。据报道,一位早期测试者在不到一天内完成了 68 万行代码的迁移——这项工作在其他情况下可能需要一个工程团队数周时间。
在一项内部测试中,Opus 5.5 被要求缩短一个网页应用所有页面的加载时间,结果在 40 次尝试中有 39 次成功,这也显示了模型的一致性。
更好的沟通表达
Anthropic 特别指出,写作风格方面修复了关于 Opus 5 最常见的一个抱怨:冗长与术语过多。Opus 5.5 被描述为会先呈现最重要的信息,使用更少的偏门表达,并更贴近所给定的内部文风。发布说明包含一个并排的缺陷解释示例,Opus 5.5 的版本明显更短,并将真正的根因置于前面,而不是逐步铺垫。
Claude Opus 5.5 基准测试结果
以下是根据 Anthropic 自身发布所示,Opus 5.5 与 Fable 5.1、Opus 5 以及其他竞品的对比。
有几点值得注意。Opus 5.5 在这里展示的每个基准上都超过了 Fable 5.1,这很显眼,因为 Anthropic 一直将 5.5 定位为“Fable 级性能、更便宜”,而不是直接升级。我认为 Anthropic 没有强调这一点,是因为他们想保护自己的分层结构。我的意思是:Anthropic 将 Fable 作为顶级产品溢价销售。如果 Opus 5.5 被广泛认为胜过 Fable——那么对于按 Fable 价格付费的人来说,这会是个尴尬的问题。
在代理式编程方面,三项基准上相较 Opus 5 的提升都很大。CursorBench 的跃升是表中单项最大改进。
同样也有例外值得标注。GPT-6 Astra 在 AutomationBench(业务工作流)和 Terminal-Bench-Science(代理式科学研究)上都略胜 Opus 5.5,后者的差距更为明显。所以可以说,Opus 5.5 在一些真实世界工作流和科学研究任务上仍略有落后。
等等,“放缓前沿”怎么办?
一开始从外观上确实显得奇怪。Amodei 呼吁放缓 AI 进展仅数日,Anthropic 就发布了新旗舰。
一种愤世嫉俗的解读是,“放缓前沿”从来就与安全无关。当您处于领先地位时(按营收计,Anthropic 确实领先),呼吁行业放缓会更容易。
但从另一种角度看,“放缓前沿”或许并非反对发布模型,而是关于应当发布什么样的模型。按照这种理解,Opus 5.5 与该信息一致。
Anthropic 表示,Opus 5.5 的表现大致相当于 Fable 5.1,这一模型本就已存在。能力上限没有被抬高。改变的是,同等级工作的成本现在降低了 40%,速度提升了 30% 以上。同时,它的内部对齐评分更好。
Claude Opus 5.5 定价
快速模式 — 最高可达 2.5 倍速度 — 在 Claude Code 与 Claude Platform 上提供,价格为每百万输入 token 8 美元、每百万输出 token 40 美元。
我制作了一张图表,以便查看 Claude Opus 的价格随时间的变化。总体上在下降。
我们所知的新安全防护机制如何运作
以下为发布说明中的要点:
在三个重点领域——网络安全、生物学与蒸馏,Opus 5.5 采用与 Anthropic 为 Fable 5.1 预留的同类防护措施。
Anthropic 未详述检测机制本身,但结果是对传入请求进行筛查:如果提示中的内容被标记为上述三类之一,请求不会直接进入 Opus 5.5,而是在回答前被转交。例如,被标记为网络安全的提示会降级至较旧的 Opus 4.8,而与生物学相关的提示则会升级至 Opus 5。也就是说,防护并非对输出进行过滤,而是在生成开始前做出的路由决策,具体由触发的类别决定哪一种模型来处理请求。
Anthropic 还在发布前邀请 METR 和 Frontier Design 对模型进行外部评估(两家机构的详情见常见问题),使其安全性声明获得第三方背书,而不仅仅是自证。
Claude Opus 5.5 可用性
Claude Opus 5.5 现已在 Anthropic 自身平台以及亚马逊云服务、Google Cloud 和 Microsoft Azure 上线。Claude Platform 上的开发者可直接通过
claude-opus-5-5访问。结论
对于用户而言,Claude Opus 5.5 是一项利好。与前代相比,它更便宜、更快、更安全。
从长期来看,安全维度更值得关注。紧随 Amodei 关于“放缓前沿”的演讲之后,这次发布的观感本可能不佳——在公开呼吁放缓一周后就推出新旗舰。但这次发布(无论是否刻意)恰到好处:没有提升能力上限,且 Opus 5.5 携带了此前仅在 Fable 上提供的同等级防护,并在测试中显著降低了沙箱逃逸尝试的发生率。我不知道这是否算是将“放缓前沿”付诸实践,抑或只是时机巧合,但至少与 Amodei 的论点相一致。